FLUX 모델 구조 및 LoRA 파인튜닝
Flux Kontext 모델 구조
Text Encoder
- CLIPTextModel
- 모델:
openai/clip-vit-large-patch14 - 역할: 전체 문장을 하나의 embedding으로 변환
- 이미지와 텍스트 매칭을 위한 인코더
- Transformer에 사용
- 모델:
- TEnocderModel
- 모델:
google/t5-v1_1-xxl - 역할: 문장 단위가 아닌 단어 시퀀스로 embedding으로 변환
- 언어를 이해하기 위한 인코더 → 텍스트의 단어 자체를 더 이해하는데 집중되어 있음
- Transformer에 사용
- 모델:
→ text_features = Linear(concat(CLIP_features, T5_features))로 융합되어 Transformer에서 사용됨
VAE
- 이미지를 VAE를 통해 latent 압축 → 16채널 latent 공간을 만들어줌
- Transformer가 2D구조를 직접 다루지 못하므로 latent를 2X2로 묶어(patch) 하나의 벡터(토큰 시퀀스)로 만들어줌
- 2X2로 묶게 되면 4X16이므로 64차원 벡터로 flatten → 2X2 patch가 하나의 토큰이 되어 Transformer로 들어감
Transformer
- 모델:
FluxTransformer2DModel - fine tuning시 LoRA target이 되는 유일한 모듈 → FluxTransformer2DModel 내부 Attention Layers
- 파이프라인
- Input으로 VAE를 통해 2X2 묶인 패치 토큰 시퀀스가 들어감
- Local Self-Attention
VAE에서 만든 2X2 patch의 시퀀스끼리 참고하여 로컬 구조 생성
→ 모든 패치간에 보지 않고 근처 패치(local)만 보고 self attention 계산 진행
- Cross-Attention
text encoder 임베딩과 Local self attention 계산을 한 토큰 시퀀스간의 cross attention 진행
→ Transformer block안에서 self attention으로 이미지 패치끼리의 관계를 먼저 조정하고 이어서 Croass attention으로 텍스트 정보와 정렬시키는 과정을 반복 2X2 패치 토큰과 Prompt간의 alignment를 하는 과정 - Feed-Forward Network (FFN)
위 결과들은 FFN을 거쳐 각 토큰의 비선형성을 줌
Scheduler
- 이미지 생성 모델이지만 diffusion 스케줄러를 사용하지 않고 FlowMatchEulerDiscreteScheduler사용
- 따라서 노이즈 기반 학습 대신 데이터 분포를 ODE(ordinary differential equation)로 학습하는 방식
→ ODE(상미분방정식): 다음 상태가 현재 상태에서 얼마나 변하는지를 나타내는 식
→ latent가 목표 이미지로 도달하기 위해 어떤 방향으로 움직여야하는지를 학습하며 latent를 업데이트 시킴
LoRA 학습 로직
- 위에 정리해둔 Flux Kontext의 모델 구조에서 ‘LoRA가 어디에 꽂히는지’를 이해해야함
- Transformer 내부의 모든 Attention layer에 LoRA Layer을 주입해 Flow Matching Loss로 최소화 시키는 방식으로 학습 진행
-
Transformer에서 각 Local self attention과 Croass attention에 LoRA를 주입시켜줌
# unet->transformer 부분에만 LoRA 삽입
network.apply_to(
        pipe.text_encoder,
        pipe.transformer,
        apply_text_encoder=False,
        apply_unet=True
    )
W_eff = W + ΔW
ΔW = B @ A * (α / r)]→하이퍼파라미터: r: LoRA rank, α: scailing
-
LoRA parameter인 A와 B를 업데이트 시키는데, 이 때 A와 B를 rank를 기준으로 저차원 공간으로 만들어줌 → 저차원 행렬을 이용해 weight를 보정함
- rank가 작을 수록 가볍고 빠르지만 표현력이 부족할 수 있음
- rank가 클 수록 변화량이 커져 VRAM/속도 비용 증가
-
위에서 설명한 것 처럼 Flux는 이미지의 latent가 목표 이미지로 도달하기 위해 어떤 방향으로 움직이는지, 즉 latent의 변화량을 예측하고 학습한다.
-
따라서 예측과 실제 변화량간의 차이를 최소화할 수 있도록 loss를 설정하여 학습을 진행함
→ 즉, Traansformer의 forward때 LoRA를 주입한 것을 통해 변화량 예측을 진행하고 backward때 변화량간의 차이를 최소화하는 방향으로 A와 B의 update 진행
-
hyperparameter
-
LoRA 구조 파라미터
network: type: "lora" linear: 128 linear_alpha: 128- linear: rank
rank(r) 장점 단점 8~16 빠름, VRAM 적음 표현력 약함 32~64 다양한 문제에서 적절한 밸런스 VRAM 더 필요 128~256 정교한 조정에 강함 느림 - linear_alpha: scailing
- 변경할 필요 거의 없음
- linear: rank
-
이외
optimizer: "adamw8bit" lr: 1e-4 batch_size: 1 gradient_accumulation_steps: 1- Opmimizer: adamw8bit or adamw → 8bit이 VEAM 절약 + 안정적이고 adamW가 VRAM 충분하면 더 안정적이지만 크게 차이 없음
- Learning rate
- 기본값: 1e-4
- Steps
- 기본 추천: 500 - 4000
- batch_size
- gradient_accumulation_steps
- Opmimizer: adamw8bit or adamw → 8bit이 VEAM 절약 + 안정적이고 adamW가 VRAM 충분하면 더 안정적이지만 크게 차이 없음
FLUX.2
FLUX.2는 Black Forest Labs에서 출시한 이미지 생성 모델 시리즈로, 기존 FLUX.1 시리즈의 후속작임
Text Encoder
- Flux.1에서 두 개의 text encoder를 사용했던 것과 달리 FLUX.2는 Mistral Samll 3.1이라는 단일 text encoder를 사용함. 이를 통해 prompt embeddings를 계산 하는 과정이 대폭 간소화 됨.
- Mistral Samll 3.1
- 최대 시퀀스 길이: 이 모델을 사용하는 파이프라인은 최대 512의
max_sequence_length를 허용함 - Layer Stacking: 단일 레이어의 출력값만 사용하는 것이 아닌, intermediate layer들의 출력들을 stacking하여 활용함.
- 역할: 이미지 생성 시 사용자의 prompt를 해석하여 모델이 이해할 수 있는 형태의 벡터 형태로 변환함
- 최대 시퀀스 길이: 이 모델을 사용하는 파이프라인은 최대 512의
DiT (Diffusion Transformer)
-
DiT: diffusion model의 U-Net 대신에 Transformer를 사용
-
FLUX.2는 MM-DiT(Multimodel Diffusion Transformer)와 Parallel DiT 아키텍처를 결합하여 사용함
-
Double-stream (MM-DiT) 블록: 이미지 latents와 텍스트 컨디셔닝을 별도의 스트림으로 처리하다가, Attention 연산 시에만 두 정보를 결합함
-
Single-stream (Parallel) 블록: Double-stream에서 결합된 이미지와 텍스트 스트림을 하나의 병렬 블록에서 Attention연산과 MLP연산을 동시에 처리함
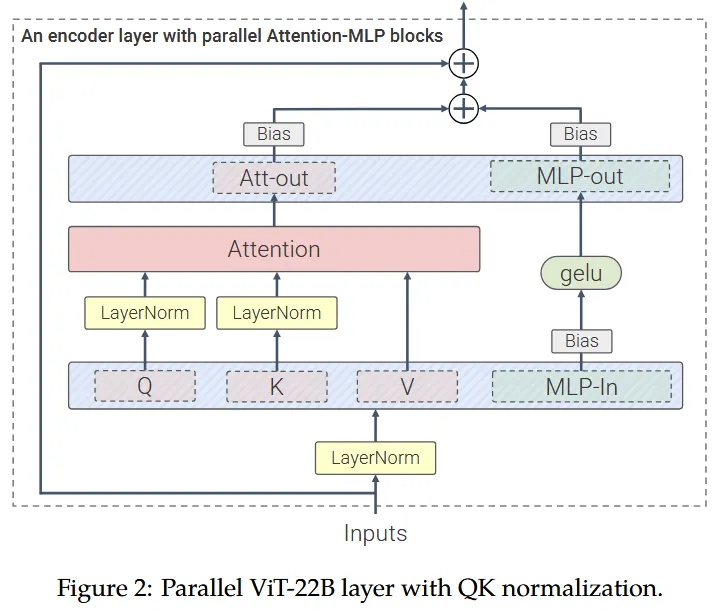
- attention 블록과 MLP 블록에 동일한 input이 들어가 parallel하게 연산을 진행함
→ 두 연산은 서로 기다리지 않고 독립적으로 업데이트를 작동함
- attention 블록과 MLP 블록에 동일한 input이 들어가 parallel하게 연산을 진행함
→ FLUX.2에서는 DiT를 완전히 병렬화하고 bias가 제거된 Transformer로 재정의함
-