Parameter-Efficient Fine-Tuning for Large Models
Han, Z., Gao, C., Liu, J., Zhang, J., & Zhang, S. Q. (2024). Parameter-efficient fine-tuning for large models: A comprehensive survey. arXiv preprint arXiv:2403.14608.
PEFT
- Full Finetuning 문제점
- 모델의 크기가 커짐에 따라(예: GPT-2의 1.5B에서 GPT-3의 175B로), 표준적인 full fine-tuning paradigm은 수천 개의 GPU work in parallel을 필요로 하며, 이는 매우 비효율적이고 지속 불가능
→ PEFT: downstream tasks에서 full tuning보다 더 나은 성능을 달성하기 위해 최소한의 parameters를 튜닝하는 것을 목표로 함
- 모델의 크기가 커짐에 따라(예: GPT-2의 1.5B에서 GPT-3의 175B로), 표준적인 full fine-tuning paradigm은 수천 개의 GPU work in parallel을 필요로 하며, 이는 매우 비효율적이고 지속 불가능
- PEFT 분류 (연산방식에 따라)
- additive: 새로운 trainable modules이나 parameters를 주입하여 model architecture를 수정
- selective: fine-tuning 동안 parameters의 일부를 trainable
- reparameterized: 학습을 위해 원본 model parameters의 (low-dimensional) reparameterization을 구축하고, 이후 inference를 위해 이를 동등하게 다시 변환하는
- hybrid fine-tuning: 서로 다른 PEFT methods의 장점들을 결합하여 통합된 PEFT model을 구축하는
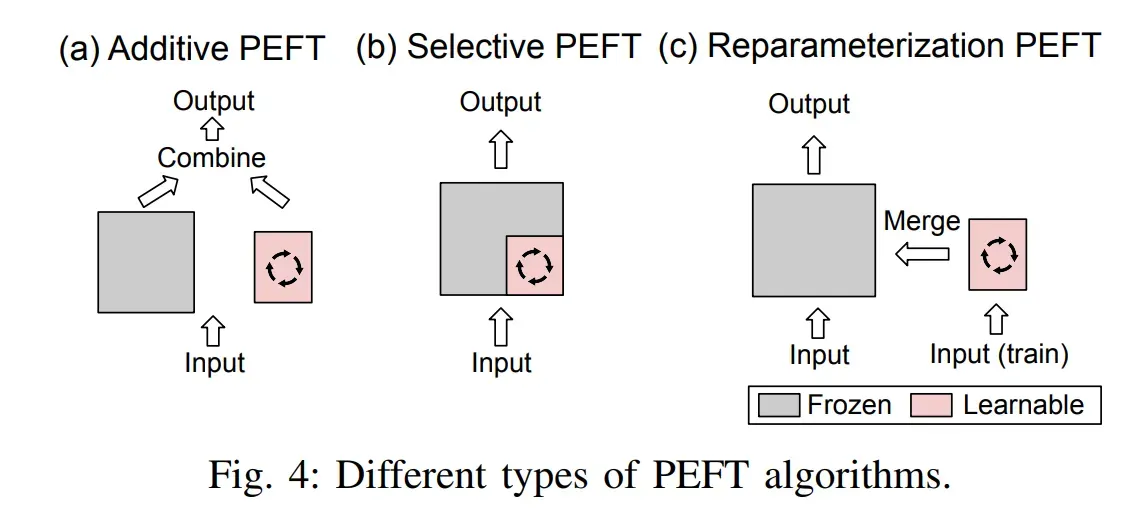
- additive PEFT: 새로운 weight parameters를 도입하거나 activations를 수정하는 알고리즘
- 기존 parameter는 건들지 않고(pre-trained backbone은 unchange) additional한 module or parameter만 update하며 training 진행
- selective PEFT: 기존 parameters의 fine-tuning만을 필요로 하는 알고리즘
- downstream tasks에 대한 model performance를 향상시키기 위해 기존 parameters의 subset을 fine-tunes함
↔ additive PEFT: 더 많은 parameters를 추가하여 model complexity를 증가시킴
- downstream tasks에 대한 model performance를 향상시키기 위해 기존 parameters의 subset을 fine-tunes함
- reparameterized PEFT
- 학습을 위해 원본 model parameters의 (low-dimensional) reparameterization을 구축하면서도 inference speed를 유지하기 위해 weights를 다시 변환함
Additive PEFT
- 표준적인 full fine-tuning은 상당한 computational expenses를 수반함
- 이 문제를 완화하기 위해 널리 사용되는 접근법은 pre-trained backbone을 변경하지 않고 유지하면서, model architecture 내에 전략적으로 배치된 최소한의 trainable parameters만을 도입
- 특정 downstream task를 위해 fine-tuning하는 동안, 이 추가적인 modules이나 parameters의 weights만이 업데이트되며, 이는 결과적으로 storage, memory, 그리고 computational resource requirements의 상당한 감소를 가져옴
Adaptors
Transformer blocks 내에 작은 adapter layers를 삽입하는 것

- Serial Adaptor: Adaptor가 처음 등장한 개념
- 각 Transformer block은 두 개의 adapter modules를 추가함으로써 향상되는데, 하나는 self-attention layer 뒤에, 다른 하나는 FFN layer 뒤에 각각 위치
- computational cost를 해결하여 수정된 프레임워크인 AdapterFusion은 computational efficiency를 높이기 위해 adapter layers가 FFN layer 다음의 'Add & Norm' 단계 뒤에만 삽입됨
- 이 접근법은 잠재적으로 모델의 parallelism을 감소시킬 수 있으며 inference efficiency와 accuracy 사이의 trade-off를 요구할 수 있음
- Parallel Adaptor
- 전통적으로 순차적인 adapter layers를 각 Transformer sublayer와 나란히 실행되는 parallel side-network로 재구성함
- CoDA
- parallel adapter design에 sparse activation mechanism을 채택
- CoDA는 각 레이어에서 k개의 중요한 tokens를 식별하는 soft top-k selection process를 사용
- 이것들은 모델의 정확도를 유지하기 위해 frozen pre-trained Transformer layer와 adapter branch 모두에 의해 처리됨
- 대조적으로, 중요하지 않은 tokens는 무거운 pre-trained layer를 건너뛰고 adapter branch에 의해서만 처리되므로, 전체적인 성능을 저하시키지 않으면서 inference efficiency를 최적화함
Soft Prompt
- soft prompts라 불리는 조정 가능한 벡터들을 input sequence의 시작 부분에 덧붙인 것
- In-context learning을 통해 이산적인(discrete) token representations를 최적화하는 대신, soft prompts의 연속적인 embedding space가 내재적으로 더 많은 정보를 포함하고 있다는 지배적인 믿음에서 영감 받음
- Prefix tuning
- 모든 Transformer layers에 걸쳐 keys 와 values 앞에 덧붙여지는 learnable vectors를 도입
- Optimization process 동안 안정성을 보장하기 위해, Prefix-tuning은 이 prefix vectors를 직접 최적화하는 대신 MLP layer를 사용하여 생성하는 reparameterization strategy를 채택함
- Fine-tuning 후에는, prefix vectors만이 inference를 위해 저장됨
- IDPG (Instance-Dependent Prompt Generation)
- 경량화된 prompt generator를 사용하여 각 입력 문장에 기반해 prompts를 생성함으로써 prompt tuning을 개선함
- 관련된 접근법: LPT (Late Prompt Tuning)
- instance-aware prompt를 얻기 위해 prompt generator를 활용함
- LPT는 초기나 모든 레이어가 아닌 intermediate layer 뒤에만 이 prompts를 추가
→ intermediate layer 아래의 gradient calculation을 제거하여, training speed를 상당히 가속화함. 동시에, LPT는 더 짧은 backpropagation path가 더 많은 task-related information을 보존하기 때문에 전반적인 성능을 향상시킬 수 있음
- 관련된 접근법: SPT (Selective Prompt Tuning)
- 이전 레이어로부터 전파된 prompt를 사용할지 아니면 새로 생성된 prompt를 주입할지를 결정하기 위해 각 레이어에 learnable probabilistic gate를 도입
- 관련된 접근법: APrompt
- 또 다른 prompt inserting strategy를 사용
- 각 Transformer layer에 대해 input sequence의 시작 부분에 삽입되는 input prompts 외에도, APrompt는 새로운 attention patterns를 학습하기 위해 self-attention blocks 내의 각각의 query, key, value matrices에 추가적인 learnable prompts를 덧붙임
Selective PEFT
Selective PEFT란?
- parameter = {, , ..., } 를 가진 모델이 주어졌을 때
(여기서 각 는 개별 model parameter를 나타내고 은 이 parameter의 총 개수를 나타냄) - selective PEFT는 이 parameter들에 binary mask = {, , ..., }을 적용하는 것으로 표현됨
- 내의 각 는 0 또는 1이며, 이는 대응하는 parameter 가 fine-tuning을 위해 선택되었는지(1) 선택되지 않았는지(0)를 나타냄
- Fine-tuning 후 업데이트된 parameter set 는 다음과 같이 주어짐
- 이 공식에서, 선택된 parameter(즉, )만이 backpropagation 동안 업데이트됨
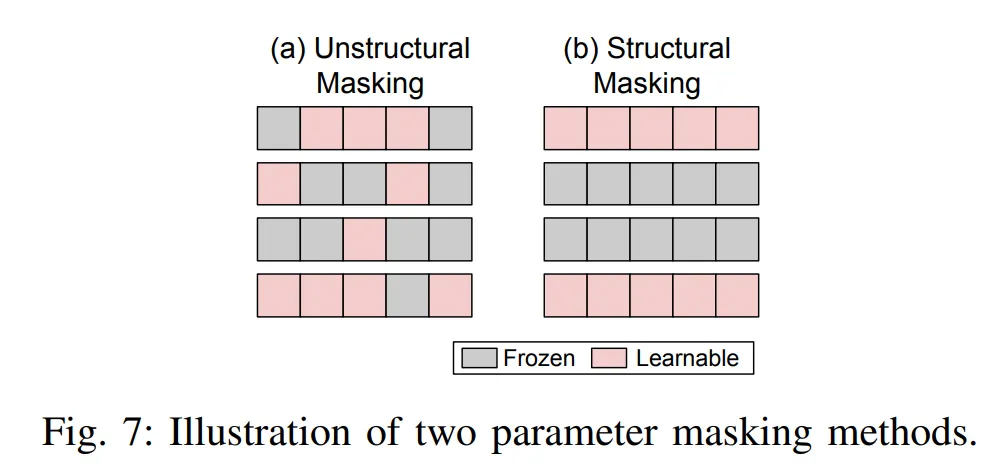
unstructured parameter masking
- 정의: 파라미터를 개별적으로 랜덤/중요도 기반 선택
- PaFi
- 단순히 가장 작은 absolute magnitude를 가진 model parameters를 trainable하게 선택함
- Fish-Dip
- FishMask와 유사하게 M을 계산하기 위해 Fisher information을 사용하지만, mask는 각 train period마다 동적으로 재계산(re-calculated)됨
- LT-SFT
- Lottery Ticket Hypothesis에서 영감을 받아 parameter importance를 결정하는 또 다른 기법을 도입했는데, 여기서는 초기 fine-tuning stage 동안 가장 많이 변하는 parameter의 부분집합이 mask M을 형성하도록 선택됨
- SAM
- 원래 문제를 해석적으로 풀 수 있는(analytically solvable) optimization function으로 근사하는 second-order approximation method를 제안하여 parameter mask를 결정하는 데 도움을 줌
- Child-tuning
- 각 training iteration 동안 child network를 선택하는 두 가지 접근법을 제안하며, 이 child network 내의 parameter만이 업데이트될 수 있음
structured parameter masking
- unstructured parameter masking은 non-zero mask의 불균형한 분포와 PEFT를 구현할 때 hardware efficiency 저하를 초래함
- structured mask는 무작위로 적용하는 unstructured 방식과 달리 parameter masking을 규칙적인 패턴으로 조직화하여, training 동안 computational 및 hardware efficiency를 향상시킴
- Diff pruning
- weight parameters를 local groups로 분할하고 이들을 함께 제거/학습함으로써 structured pruning strategy를 제안함
- FAR
- Transformer blocks 내의 FFN weights를 nodes로 그룹화한 다음, norm을 사용하여 learner nodes의 순위를 매기고 선택함으로써 BERT models를 fine-tuning함
- S-BitFit
- BitFit에 Neural Architechure Search (NAS)를 적용하는 방법을 제안함
- BitFit의 Structural nature를 유지하면서 NAS 알고리즘이 각 bias modules에 대해 인지 여부를 선택하도록 제한함
- SPT
- fine tuning시 loss reduction을 기준으로 sensitive parameters를 식별함
- 이 sensitive는 fine tuning 이전에 단 한번 수행되는 forward pass와 backward pass로부터 도출되며, first-order Taylor expansion을 이용해 계산됨
- 이후 sensitive parameters의 개수가 사전에 정의된 threshold를 초과하는 weight matrices를 탐색하고, 이들에 대해 LoRA나 Adapter같은 PEFT를 적용함으로써 structural tuning을 수행함
Optimal Hyperparameters
Ploner, M., & Akbik, A. (2024, March). Parameter-efficient fine-tuning: Is there an optimal subset of parameters to tune?. In Findings of the Association for Computational Linguistics: EACL 2024 (pp. 1743-1759).
-
learning rate
- 가장 핵심적인 파라미터
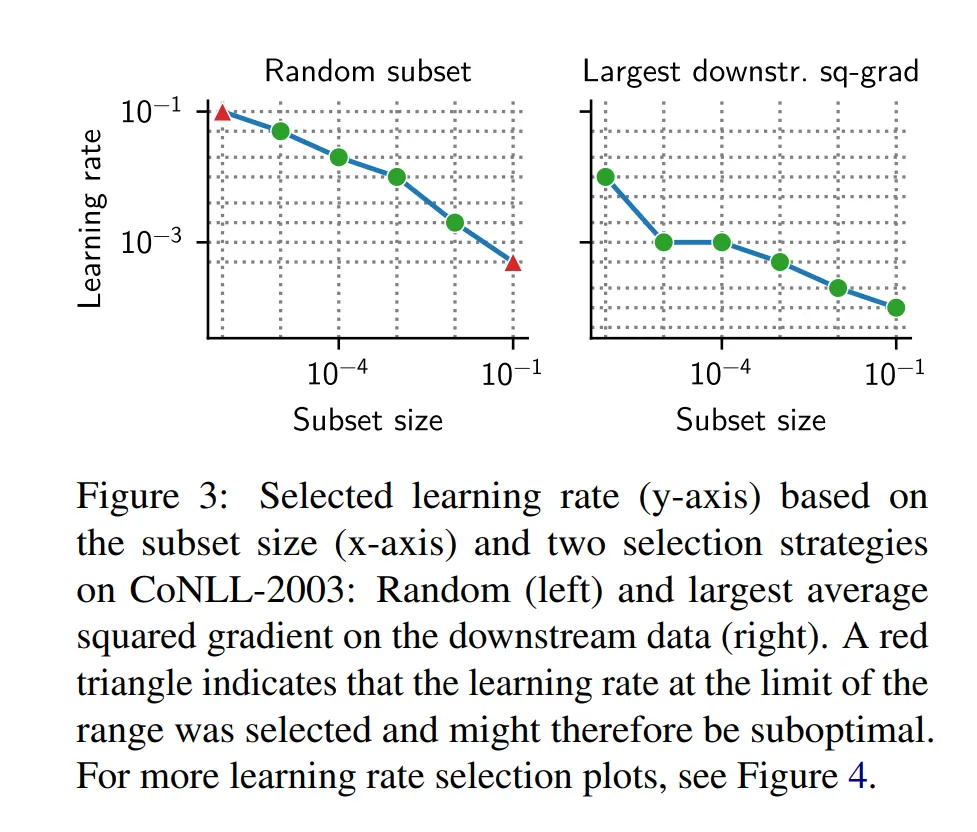
- 업데이트할 파라미터의 수(Subset Size)가 적어질수록, 더 높은 Learning Rate가 필요함. 이는 적은 파라미터로 네트워크의 기능을 충분히 변화시키기 위해 더 급격한 업데이트가 필요하기 때문
-
subset size (선택할 parameter 비율)
- subset size가 커질수록 성능은 Full Fine-tuning에 수렴하며 개선되지만 , 매우 작은 사이즈에서도 적절한 LR이 뒷받침된다면 Random Selection이 생각보다 강력한 성능을 낼 수 있음
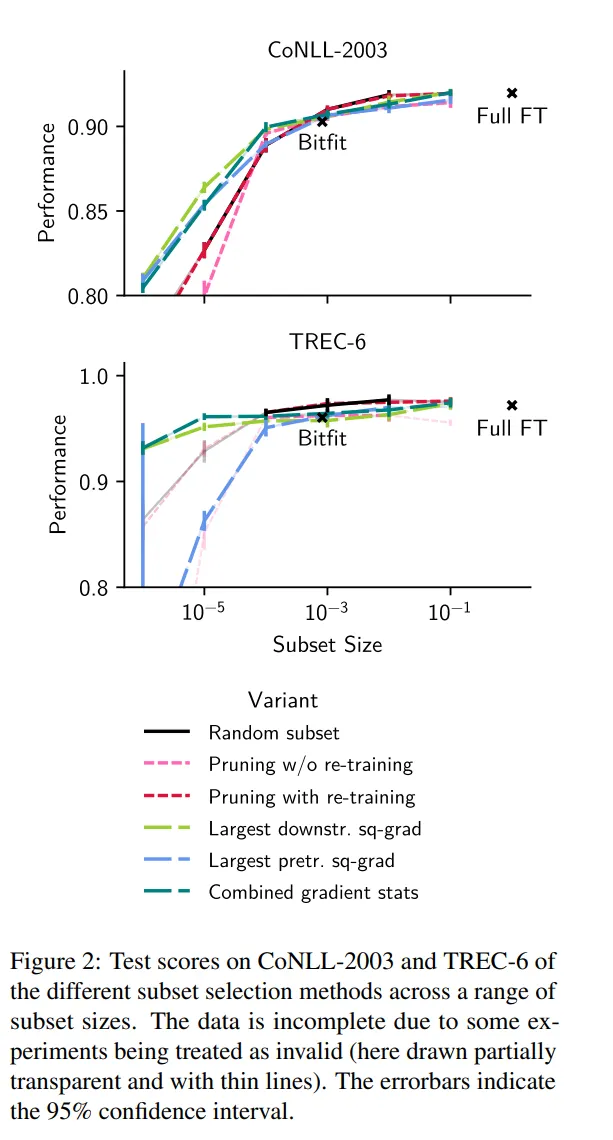
- subset size가 커질수록 성능은 Full Fine-tuning에 수렴하며 개선되지만 , 매우 작은 사이즈에서도 적절한 LR이 뒷받침된다면 Random Selection이 생각보다 강력한 성능을 낼 수 있음
-
결론
- Optimal Subset 위치를 정교하게 고르는 것보다, 선택된 집합의 특성(Gradient magnitudes 등)에 맞춰 Learning Rate를 개별적으로 튜닝하는 것이 성능에 훨씬 더 결정적인 영향을 미침
- Selective PEFT는 파라미터를 국소적이고 급격하게 변경하기 때문에, Generalizability는 Full Fine-tuning보다 떨어지는 경향이 있음
reparameterized PEFT
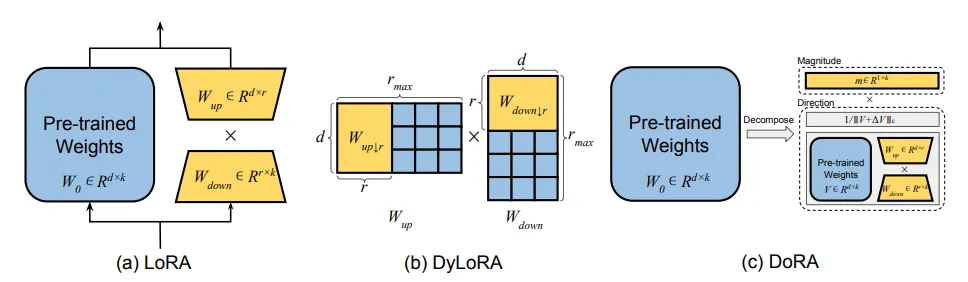
LoRA
- 두개의 trainable weight matrices를 사용함(, )
- 두 matrices의 차원을 조정할 rank 과 scale 값을 지정해야함
- 기존 weight는 인데(d: 입력차원, k: 출력차원), 이 때 가 학습 대상임
- 은 zero로 초기화 함
- 은 가우시안 분포에서 초기화 함
DyLoRA
- 기존 LoRA에서는 rank r이 고정된 값이였는데, DyLoRA에서는 rank r을 range 값으로 둠 → 각 iteration마다 range안에서 선택됨
- DyLoRA에서는 최대 rank 를 기준으로 큰 행렬 하나만 학습
- 각 iteration마다 를 값의 범위 안에서 선택을 하고 이에 따라 과 을 맞게 잘라서 사용함
- 이를 통해 기존 LoRA에 비해서 메모리 및 연산 효율이 높아지게 되면서 여러 rank를 학습할 수 있음 → 작은 rank인 는 큰 rank 의 부분공간 안에 속하므로 여러 rank를 학습하는 효과를 얻을 수 잇음
DoRA
- 를 magnitude()와 direction()으로 나눠줌 → 과 를 fine tuning 진행함
- 기존 weight를 magnitude와 direction으로 나눠줄 때, 실제 학습 대상은 direction만 해당됨 → 에 대해서만 LoRA 방식으로 업데이트를 진행하고 은 LoRA를 사용하지 않고 일반 파라미터처럼 업데이트 진행
- DoRA를 사용했을 때 LoRA보다 various tasks and models에서 outperforms임
PEFT for Diffusion Models
Additional Input Control
- GLIGEN
- 목적: 레이아웃, keypoints와 같은 추가적인 grounding input을 제어하기 위함
- 핵심 방식: 원래 모델의 weights는 고정(intact)한 채, 새로운 입력을 처리하는 학습 가능한 gated Transformer layers를 추가로 통합
- 특징: 고품질 이미지 생성이 가능하며, 학습 시 보지 못한 unseen 객체에 대해서도 우수한 일반화 성능을 보임
- ControlNet
- 목적: Canny edges, depth maps, human key points 등 다양한 외부 conditioning을 정밀하게 제어하기 위함
- 핵심 방식: Stable Diffusion의 encoding layers를 복제하여 학습 가능한 복사본을 만들고, 원래 모델은 고정(locking)함. 두 모델 사이를 zero convolution layers로 연결
- 특징: zero convolution을 통해 학습 초기 단계에서 발생하는 유해한 noise가 기존의 pre-trained features를 해치지 않도록 보호
- Concept Sliders
- 목적: 모델 내의 특정 개념(예: 나이, 미소 등)을 정밀하게 편집하기 위함
- 핵심 방식: 플러그 앤 플레이 방식의 LoRA adaptors를 활용
- 특징: 특정 속성을 슬라이더처럼 조절하듯 미세하게 조정할 수 있는 유연성을 제공
Customized Generation
- 목표: 모델이 최소한의 사용자 제공 이미지 세트로부터 새로운 개념을 파악할 수 있게 하는 것
- Textual Inversion
- 목적: 3~5장의 소수 이미지로부터 새로운 개념(custom concepts)을 모델이 학습
- 핵심 방식: 기존 모델은 전혀 건드리지 않고, textual embedding space에서 새로운 개념을 나타내는 pseudo-word ()를 찾아 최적화
- 특징: 학습된 pseudo-word를 일반 단어처럼 프롬프트에 섞어서 사용할 수 있음 (예: "a photo of on the beach.")
- Custom Diffusion
- 목적: 여러 개의 새로운 개념을 동시에 학습하는 compositional fine-tuning을 위함
- 핵심 방식: attention layers 내에서 텍스트를 latent features로 연결하는 mapping 파라미터만 파인튜닝함
- 특징: model forgetting을 방지하기 위해 실제 이미지 세트를 함께 활용하며, 다중 개념 학습 시 효과적임
- IP-Adapter
- 목적: 텍스트가 아닌 이미지를 조건(condition)으로 사용하여 콘텐츠를 제어하기 위함
- 핵심 방식: 기존의 cross-attention 방식이 텍스트와 이미지 정보를 섞어버려 정보가 손실되는 문제를 해결하기 위해, 이미지 특징만을 전담하는 별도의 decoupled cross-attention 레이어 추가함
- 특징: 이미지 전용 cross-attention layers만 학습시키며, 이미지 스타일뿐만 아니라 구체적인 콘텐츠 내용까지 충실하게 반영한 생성 가능