| 파트 | 주제 | 핵심 내용 |
|---|---|---|
| Part 1 | 핵심 정리 | 기술/추론통계 비교, 데이터 유형, 측정 척도, 시각화 가이드 |
| Part 2 | 데이터 유형 탐색 | Iris·Wine 데이터로 수치형/범주형 구분, dtypes, describe(), value_counts() |
| Part 3 | 범주 데이터 | 최빈값, 막대도표, 파이차트 |
| Part 4 | 중심 지표 (대표값) | 산술평균, 절사평균, 가중평균, 중앙값, 최빈값 + 이상치 영향 비교 |
| Part 5 | 산포도 | 편차, 분산, 표준편차, 범위, IQR, 이상치 판별 + 베셀 보정(N-1) |
단변량 분석 (단일 변수 시각화)
| 데이터 유형 | 시각화 | 목적 | 용도 | 언제 쓰나? |
|---|---|---|---|---|
| 수치형 (연속) | 히스토그램 | 분포 | 분포 형태 확인 (어디에 몰려 있나) | 데이터 분포를 처음 파악할 때 |
| KDE (밀도그림) | 분포 | 부드러운 분포 곡선 | 여러 그룹의 분포를 겹쳐 비교할 때 | |
| 박스플롯 | 분포 | 5요약(Q1,중앙값,Q3,최소,최대) + 이상치 | 중심·퍼짐·이상치를 한눈에 파악할 때 | |
| 바이올린 도표 | 분포 | 분포 형태 + 요약 통계 | 박스플롯 + 밀도를 동시에 보고 싶을 때 | |
| 수치형 (이산) | 막대그래프 | 비교 | 각 정수 값의 빈도 | 값이 정수인 경우 (평점 1~5, 자녀 수 등) |
| 범주형 (명목) | 막대그래프 | 비교 | 카테고리별 빈도 비교 | 남/여, 혈액형, 탑승항 등 그룹 크기 비교 |
| 파이차트 | 구성 | 전체 대비 비율 강조 | 항목이 적고(5개 이하) 비율 강조할 때 | |
| 도넛 차트 | 구성 | 파이차트 변형, 중앙에 정보 표시 | 핵심 수치를 중앙에 강조할 때 | |
| 와플 차트 | 구성 | 비율을 격자로 직관 표현 | 파이차트 대안, 퍼센트 강조할 때 | |
| 범주형 (순서) | 막대그래프 (순서 유지) | 비교 | 순서 + 빈도 확인 | 학점, 만족도, 등급 등 순서가 있는 범주 |
이변량 분석 (두 변수 조합 시각화)
| 데이터 조합 | 시각화 | 목적 | 용도 | 언제 쓰나? |
|---|---|---|---|---|
| 수치 × 수치 | 산점도 (Scatter) | 관계 | 두 변수의 관계 확인 | 상관관계, 군집, 이상치 패턴 확인 |
| 히트맵 (상관행렬) | 관계 | 여러 변수 상관관계 한눈에 | 변수가 많을 때 전체 관계를 색깔로 파악 | |
| 수치 × 범주 | 그룹별 박스플롯 | 비교/분포 | 그룹 간 분포 비교 | 남녀별 키, 등급별 요금 등 |
| 그룹별 바이올린 | 비교/분포 | 그룹 간 분포 + 형태 비교 | 분포 형태까지 세밀하게 비교할 때 | |
| 그룹별 히스토그램 | 비교/분포 | 그룹 분포 겹쳐 비교 | 분포의 겹침/분리 정도 확인 | |
| 시간 × 수치 | 선 그래프 (Line) | 비교 | 시간에 따른 변화 추세 | 매출 추이, 기온 변화, 주가 등 |
| 영역 그래프 (Area) | 비교/구성 | 추세 + 누적 크기 강조 | 카테고리별 매출 누적 추이 | |
| 다중 축 차트 (Multi-Axis) | 비교 | 스케일이 다른 변수를 겹쳐 비교 | 매출(억) vs 고객수(명) 동시 비교 | |
| 범주 × 범주 | 누적 막대그래프 | 구성 | 교차 빈도/비율 | 성별×생존, 등급×탑승항 등 |
| 모자이크 플롯 | 구성 | 교차 비율 (면적) | 두 범주 변수의 관계를 면적으로 표현 |
데이터 유형 탐색
숫자를 문자 라벨로 변환
map의 역할
값 치환(dictionary 기반 매핑)
iris_df['species_name'] = iris_df['species'].map({
    0 : 'setosa', 1 : 'versicolor', 2 : 'virginica'
})
예시:
0 → setosa
1 → versicolor
2 → virginicainfo() 출력 해석
iris_df.info()- 데이터의 행,열 개수
- 범주형/수치형 타입 구분
## 결과 ##
<class 'pandas.DataFrame'>
RangeIndex: 150 entries, 0 to 149
Data columns (total 6 columns):
 #   Column             Non-Null Count  Dtype
---  ------             --------------  -----
 0   sepal length (cm)  150 non-null    float64
 1   sepal width (cm)   150 non-null    float64
 2   petal length (cm)  150 non-null    float64
 3   petal width (cm)   150 non-null    float64
 4   species            150 non-null    int64
 5   species_name       150 non-null    str
dtypes: float64(4), int64(1), str(1)
memory usage: 7.2 KB
float = 연속형 || int = 범주형(숫자라벨) || str = 범주형(문자라벨)
기술통계
df.describe(include = [...])
# 소수점지정까지 하고 싶으면 df.describe(include = [...].round(2))
include에는 어떤 dtype(자료형)을 대상으로 기술통계를 낼지를 지정
- 들어갈 수 있는 값 = pandas가 인식하는 자료형(dtype)
① 'number' (또는 np.number) : 수치형 (int, float 모두 포함) - 출력 : count, mean, std, min, 25%, 50%, 75%, max
② 'object' : 문자열 범주형 - 출력 : count, unique, top, freq
③ 'category' : 범주형 - object와 동일한 형태 출력
④ 'bool' : 불리언 True/False 컬럼 - count, unique, top, freq
⑤ 'datetime' 또는 'datetime64[ns]' : 날짜/시간 컬럼 - count, mean, min, max 등
⑥ df.describe() : 모든 타입 (타입별로 가능한 통계만 표시)
df.describe(include=['object','category','bool'])범주형 데이터 빈도 확인
display(iris_df['species_name'].value_counts())
display(iris_df['species_name'].value_counts(normalize=True).round(2))
.value_counts(normalize=True) : 빈도 수를 비율로 변환(전체에서 차지하는 비율)
기술통계 - 범주 데이터
| 시각화 | 용도 | 언제 쓰나? |
|---|---|---|
| 막대그래프 | 카테고리별 빈도/크기 비교 | 항목 간 크기를 직접 비교할 때 |
| 파이차트 | 전체 대비 비율 강조 | 항목이 적고(5개 이하) 비율을 강조할 때 |
선택 기준: 비교가 목적이면 막대그래프, 비율 강조가 목적이면 파이차트
기술통계 - 중심지표 (대표값)
분포 형태에 따른 평균·중앙값·최빈값의 위치 관계
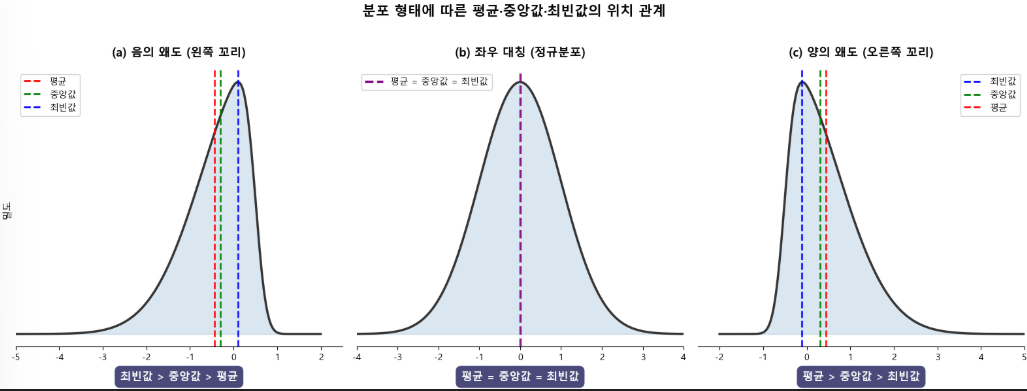
| 분포 형태 | 위치 관계 | 실제 예시 |
|---|---|---|
| 음의 왜도 (왼쪽 꼬리) | 최빈값 > 중앙값 > 평균 | 쉬운 시험 점수 (대부분 고득점, 일부 저득점) |
| 대칭 분포 | 평균 = 중앙값 = 최빈값 | 키, 몸무게 등 자연현상 |
| 양의 왜도 (오른쪽 꼬리) | 평균 > 중앙값 > 최빈값 | 연봉, 집값 (대부분 중간, 일부 매우 높음) |
실전 원칙
- 히스토그램을 먼저 그려라 → 분포 형태, 이상치, 봉우리 개수 확인
- 이상치가 있거나 분포가 치우쳐 있으면 → 중앙값(Median)을 함께 제시
/평균과 중앙값의 차이가 크면 → 비대칭(왜도)이 크다는 신호 - 봉우리가 2개 이상이면(다봉 분포) → 평균·중앙값 모두 무의미! 그룹을 나눠서 각각 분석