💻 오늘 배운 것
- 회귀분석의 개념과 종류
- 회귀분석 모델 평가방법
- 회귀분석 모델 in Python
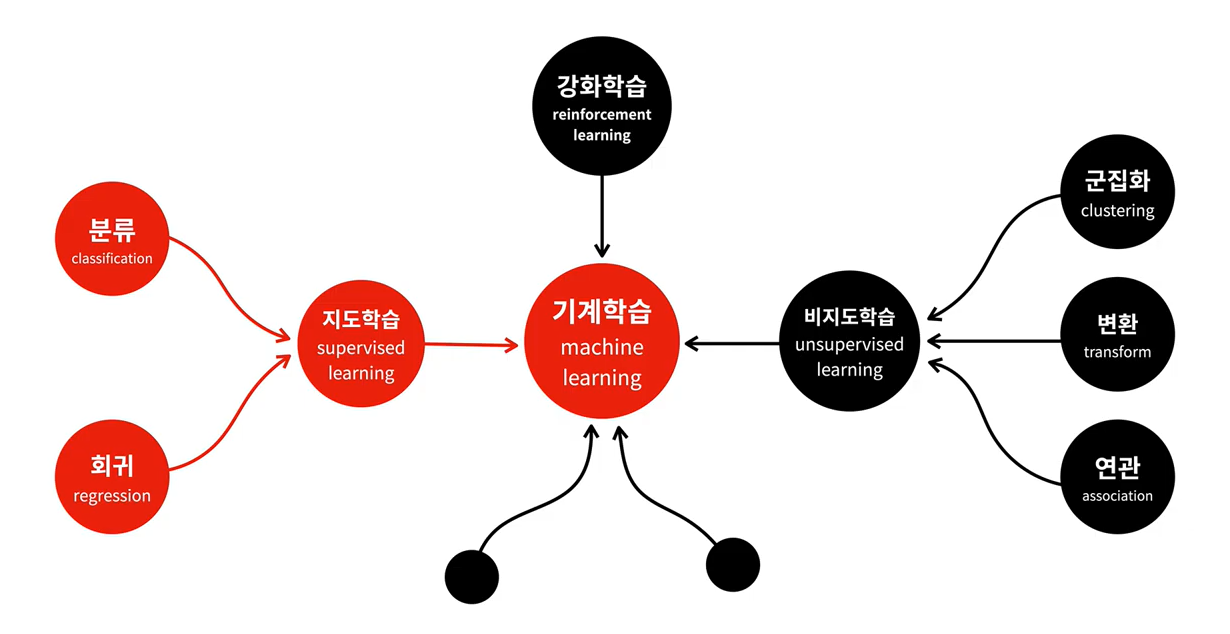
지도학습 Supervised Learning
지도학습은 우리가 문제집을 통해 문제를 풀고 답을 찾아보며 문제 풀이에 익숙해지고 오답을 점차 줄여나가는 과정과 비슷함. 컴퓨터에게 지도학습을 시키기 위해서는 충분히 많은 데이터가 수집되어있어야 함. 또한 데이터는 원인인 독립변수와 결과인 종속변수로 이루어져 있어야 함. 이것을 지도학습으로 훈련시키면 컴퓨터는 모델을 만듦.
회귀분석 Regression
지도학습 중에서도 회귀분석은 변수들 사이의 관계를 모델링하는 통계기법 중 하나로 종속변수(목표)와 하나 이상의 독립변수간의 미래 사건을 예측하는 방법. 또한 우리가 예측하고 싶은 종속변수가 보통 숫자일 때 사용함.
변수 표기
- 변수(variable) : 변경될 수 있는 양이나 조건으로 데이터 과학해서는 열(column)을 의미.
- N : 데이터의 개수
- X (Input data, Feature, 독립변수) : 원인이 되는 열. 원인은 결과와 상관없이 일어나는 일로 결과의 영향을 받지 않는 독립적인 사건
- Y (Output data, 해답/응답, 종속변수) : 원인으로 인해서 결과가 되는 열. 원인에 종속되어 발생한 사건
- (, ) : i번째 데이터
선형 회귀분석 Linear Regression
이 중 데이터를 가장 잘 설명하는 직선을 찾는 것이 선형 회귀분석. 이 때 하나의 독립변수에 대한 선형회귀분석은 단순 선형회귀 분석, 여러개의 독립 변수에 대한 선형회귀 분석은 다중 선형회귀 분석이라고 함.
선형 회귀 분석의 예시를 보면 원인이 되는 독립변수가 있고 결과가 되는 종속변수가 있음. 그리고 예시에 따라 학습시킬 수 있는 데이터를 만드는 방법들이 존재함.
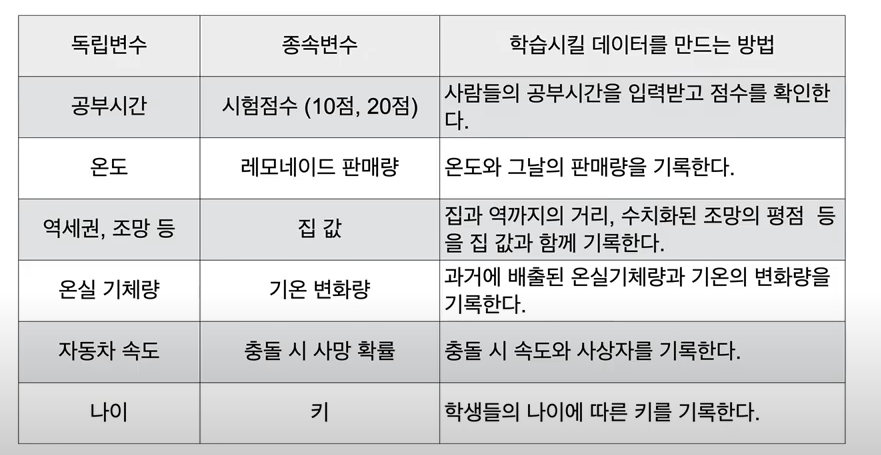
❓ 서로 상관있는 특성(열, column)은 어떻게 알아볼 수 있을까?
한 쪽의 값이 바뀌었을 때 다른 쪽의 값도 바뀐다면 2개의 특성은 서로 관련이 있다고 추측할 수 있음. 또한 두 특성 사이에 다른 영향을 줄 만한 다른 특성이 발견되지 않는다면 이 때 두개의 특성을 서로 상관이 있다, 상관관계라고 함.
❓ 그렇다면 인과관계와 상관관계의 관계는?
인과관계는 상관관계를 포함함. 특성들 사이의 관계를 파악하는 것은 매우 어렵고 조심스럽게 접근해야 하는 작업. 때문에 적은 수의 데이터를 가지고 상관관계가 있다고 단정하면 안되며 단지 서로 상관관계를 맺고 있을 뿐인데 인과관계라고 단정해서도 안됨.
단순 선형 회귀분석 Simple Linear Regression
앞서 하나의 독립변수에 대한 선형회귀분석은 단순 선형회귀분석이라고 함. 단순 선형 회귀분석 수식은 다음과 같음.
+
- 여기서 은 기울기, 은 절편을 의미.
문제 정의를 변수 표기로 함께 살펴보기
데이터 : N개의 FB 광고 예산(X)과 판매량(Y)
목표 : 광고에 얼마를 투자했을 때 얼마나 팔릴까?
가정 : TV 광고 예산과 판매량은 선형적 관계를 가진다.
+
문제 : 어떤 , 이 좋은 것인가?
=> 단순 선형회귀 분석의 목표는 우리가 가진 데이터를 가장 잘 표현할 수 있는 (기울기)와 (절편)을 구하는 것.
따라서 해당 문제 정의를 통해 우리는 데이터를 가장 잘 설명하는 (기울기), (절편) 을 구하는 모델을 만드는 것이 목표. 이를 위해 우리는 컴퓨터에게 어떤 , 이 좋은지 알려줘야함. 완벽한 예측은 불가능하지만 뭐가 좋은건지는 알려줘야 함. (, )의 실제값과 모델이 예측하는 값을 최소한으로 하는 것. 우리가 구한 선과 실제 값들 사이의 차이를 최소화하면 됨.
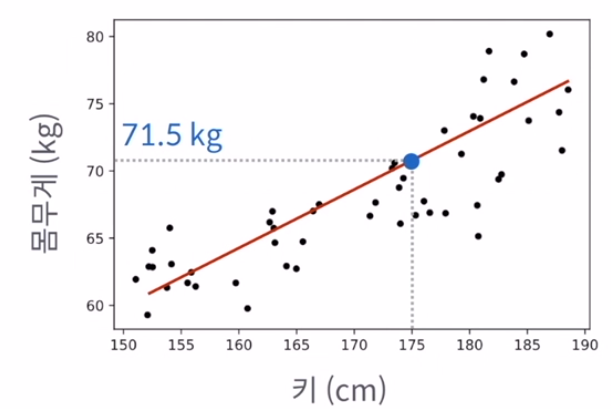
예시) 해당 자료는 대학 운동부 학생들의 신체검사 자료이다. 운동부에 키가 175cm인 신입생 A가 들어왔을 때 예상 몸무게는 얼마일까?
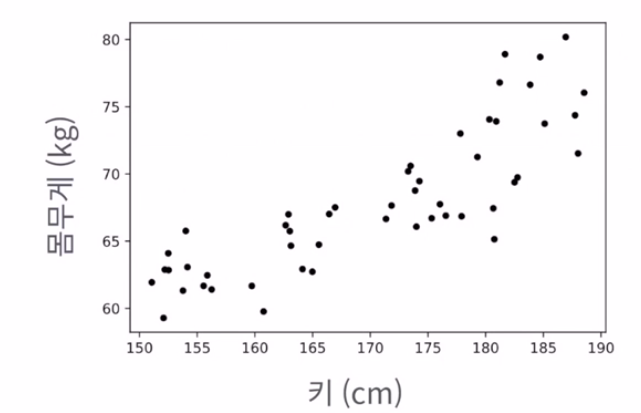
기존 데이터를 통해 가장 잘 맞는 하나의 선을 찾아 값을 예측해 볼 수 있음.
손실 함수 Loss Function
정답과 예측한 값이 얼마만큼의 손실(차이)이 발생하는지 구하는 수식. 정답과 예측 사이의 차이가 작을수록 손실율은 0에 가까워지고 이 손실이 줄어드는 방향으로 모델을 학습해야 함. 그것이 목표이기 때문. 이 때 만약 우리가 구한 선을 통해 전체모델의 차이를 다 더해버리면 양수의 차이와 음수의 차이들이 덧셈을 통해 0에 가까워질 수 있음. 따라서 실제 값에서 예측한 값의 차이를 다 뺀 후 제곱을 해서 차이를 구함. 이것을 오차 제곱 합 SSE 라고 함. 이렇게 Loss를 통해 오차가 최소가 되는 (기울기), (절편)를 구하는 것이 목표.
SSE
- +
SSE in Python
import numpy as np
from sklearn.linear_model import LinearRegression

def loss(x, y, beta_0, beta_1):
    N = len(x)
    loss_sum = 0
    for i in range(N) :
        loss_sum += (y[i] - (beta_0 * x[i] + beta_1)) ** 2

    return loss_sum

X = [8.70153760, 3.90825773, 1.89362433,
     3.28730045, 7.39333004, 2.98984649, 2.25757240,
     9.84450732, 9.94589513, 5.48321616]
Y = [5.64413093, 3.75876583, 3.87233310,
     4.40990425, 6.43845020, 4.02827829, 2.26105955,
     7.15768995, 6.29097441, 5.19692852]

train_X = np.array(X).reshape(-1, 1)
train_Y = np.array(Y).reshape(-1, 1)

# 모델 트레이닝
lrmodel = LinearRegression()
lrmodel.fit(train_X, train_Y)

'''
loss가 최소가 되는 직선의 기울기와 절편을 계산
'''
beta_0 = lrmodel.coef_[0]   # lrmodel로 구한 직선의 기울기
beta_1 = lrmodel.intercept_ # lrmodel로 구한 직선의 y절편

print("beta_0: %f" % beta_0)
print("beta_1: %f" % beta_1)
print("Loss: %f" % loss(X, Y, beta_0, beta_1))
❓reshape를 사용하는 이유는?
sklearn에서는 벡터와 행렬을 나타내는 방법으로 numpy 배열을 표준으로 사용하고 있음. 따라서 X와 Y를 각각 np.array로 변환해야 함. 하나의 속성(feature)에 여러가지 값(sample)을 가지는 경우, reshape(-1, 1)을 적용하여 열벡터로 만들어야 함. X는 하나의 종속변수 Y에 대한 여러 값을 가지므로 reshape(-1, 1)을 적용함.
❓reshape를 하는데 앞 행 부분에 -1이 들어간다?
행의 길이를 가변적으로 변한다는것. 예를 들어 총 30개의 원소가 들어있는 배열 x에 대해서 x.reshape(-1, 정수)를 해주면 '열(column)' 차원에 '정수'에 따라서 30개의 원소가 빠짐없이 배치될 수 있도록 '-1'이 들어가 있는 행(row)의 개수가 가변적으로 정해지는 것.
하지만 실제로 머신러닝에서 더 많이 사용하는 것은 제곱 오차의 평균을 구한 평균 제곱 오차 MSE임. 왜냐하면 SSE는 관측치 수에 따라 그 값이 천차만별로 변함. 또한 우리는 다량의 행렬(데이터셋)을 input으로 넣어줌. 이 때 마지막 레이어를 통과한 예측값은 처음 들어간 input의 개수 x 1이 될 것이고 그렇다면 각각의 행렬에 따른 오차율 또한 모두 다를 것. 그래서 각각의 오차율을 모두 더하고 총 개수인 input의 개수(n)으로 나눠 오차율의 평균을 구하는 MSE를 더 자주 사용.
MSE
- +
다중 선형 회귀분석 Multiple Linear Regression
문제 정의를 변수 표기로 함께 살펴보기
데이터 : N개의 FB(), TV(), 신문() 광고 예산과 판매량(Y)
목표 : FB, TV, 신문에 각각 얼마씩을 투자했을 때 얼마나 팔릴까?
가정 : 판매량은 FB, TV, 신문 광고료와 선형적 관계를 가진다.
+ + +
문제 : 어떤 , , , 이 좋은 것인가?
푸는 방법은 단순 선형 회귀분석과 동일.
SSE
- + + +
MSE
- + + +
실제 판매량 예측 in Python
import numpy as np
from sklearn.linear_model import LinearRegression
from sklearn.metrics import r2_score

'''
./data/Advertising.csv 에서 데이터를 읽어, X와 Y를 만듭니다.

X는 (200, 3) 의 shape을 가진 2차원 np.array,
Y는 (200,) 의 shape을 가진 1차원 np.array여야 합니다.

X는 FB, TV, Newspaper column 에 해당하는 데이터를 저장해야 합니다.
Y는 Sales column 에 해당하는 데이터를 저장해야 합니다.
'''

import csv
csvreader = csv.reader(open("data/Advertising.csv"))

x = []
y = []

next(csvreader) # 첫 줄은 넘어간다는 뜻
for line in csvreader :
    x_i = [float(line[1]), float(line[2]), float(line[3])]
    y_i = float(line[4])
    x.append(x_i)
    y.append(y_i)

X = np.array(x)
Y = np.array(y)

lrmodel = LinearRegression()
lrmodel.fit(X, Y)

beta_0 = lrmodel.coef_[0] # 0번째 변수에 대한 계수 (페이스북)
beta_1 = lrmodel.coef_[1] # 1번째 변수에 대한 계수 (TV)
beta_2 = lrmodel.coef_[2] # 2번째 변수에 대한 계수 (신문)
beta_3 = lrmodel.intercept_ # y절편 (기본 판매량)

print("beta_0: %f" % beta_0)
print("beta_1: %f" % beta_1)
print("beta_2: %f" % beta_2)
print("beta_3: %f" % beta_3)

def expected_sales(fb, tv, newspaper, beta_0, beta_1, beta_2, beta_3):
    '''
    FB에 fb만큼, TV에 tv만큼, Newspaper에 newspaper 만큼의 광고비를 사용했고,
    트레이닝된 모델의 weight 들이 beta_0, beta_1, beta_2, beta_3 일 때
    예상되는 Sales 의 양을 출력합니다.
    '''
    sales = fb * beta_0 + tv * beta_1 + newspaper * beta_2 + beta_3


    return sales

print("예상 판매량: %f" % expected_sales(10, 12, 3, beta_0, beta_1,
	  beta_2, beta_3))

""" 결과
beta_0: 0.045765
beta_1: 0.188530
beta_2: -0.001037
beta_3: 2.938889
예상 판매량: 5.655784
"""
다항식 회귀분석 Polynomial Regression
단순한 선을 그어보았을 때 데이터를 잘 설명할 수 없을 것 같을 때. 예측이 직선이 아닌 곡선 형태일 것 같을 때 사용.
+ +
이 때 , 로 치환하면 와 동일해진다.
다항식 회귀 분석은 다중 선형 회귀 분석과 원리는 같음. 다만 데이터에 전처리를 함으로써 새로운 변수간의 조합을 만들어낸 뒤 회귀 분석을 진행한다는 것이 차이.
import numpy as np
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_squared_error
from sklearn.model_selection import train_test_split

'''
./data/Advertising.csv 에서 데이터를 읽어, X와 Y를 만듭니다.

X는 (200, 3) 의 shape을 가진 2차원 np.array,
Y는 (200,) 의 shape을 가진 1차원 np.array여야 합니다.

X는 FB, TV, Newspaper column 에 해당하는 데이터를 저장해야 합니다.
Y는 Sales column 에 해당하는 데이터를 저장해야 합니다.
'''
import csv
csvreader = csv.reader(open("data/Advertising.csv"))

x = []
y = []

next(csvreader) # 첫 줄은 넘어간다는 뜻
for line in csvreader :
    x_i = [float(line[1]), float(line[2]), float(line[3])]
    y_i = float(line[4])
    x.append(x_i)
    y.append(y_i)

X = np.array(x)
Y = np.array(y)

# 다항식 회귀분석을 진행하기 위해 변수들을 조합합니다.
X_poly = []
for x_i in X:
    X_poly.append([
        x_i[0] ** 2, # X_1^2
        x_i[0] * x_i[1], # X_1 * X_2
        x_i[1] * x_i[2], # X_2 * X_3
        x_i[2] * x_i[0]# X_3 * X_1
    ])

# X, Y를 80:20으로 나눕니다. 80%는 트레이닝 데이터, 20%는 테스트 데이터입니다.
x_train, x_test, y_train, y_test = train_test_split(X_poly, Y, test_size=0.2,
								   random_state=2)

# x_train, y_train에 대해 다항식 회귀분석을 진행합니다.
lrmodel = LinearRegression()
lrmodel.fit(x_train, y_train)

#x_train에 대해, 만든 회귀모델의 예측값을 구하고, 이 값과 y_train 의 차이를 이용해 MSE를 구합니다.
predicted_y_train = lrmodel.predict(x_train)
mse_train = mean_squared_error(y_train, predicted_y_train)
print("MSE on train data: {}".format(mse_train))

# x_test에 대해, 만든 회귀모델의 예측값을 구하고, 이 값과 y_test 의 차이를 이용해 MSE를 구합니다. 이 값이 1 미만이 되도록 모델을 구성해 봅니다.
predicted_y_test = lrmodel.predict(x_test)
mse_test = mean_squared_error(y_test, predicted_y_test)
print("MSE on test data: {}".format(mse_test))❓교차 검증이란?
모델이 결과를 잘 예측하는지 알아보기 위해 전체 데이터를 학습용(training) 세트와 테스트(test) 세트로 나누어 모델에 넣고 성능을 평가하는 방법. 학습용 데이터는 모델을 학습시킬 때 사용되고, 테스트 데이터는 학습된 모델을 검증할 때 사용됨.
학습용 데이터와 테스트용 데이터를 분리하기 위해 sklearn.model_selection의 train_test_split 을 사용할 수 있음.
train_test_split 은 순차적으로 학습용 피쳐 데이터, 테스트용 피쳐 데이터, 학습용 레이블 데이터, 테스트용 레이블 데이터로 만들어줌. 따라서 앞의 변수를 x_train, x_test, y_train, y_test 순서대로 넣어줌. test_size 파라미터(매개변수)는 전체 데이터 중 몇퍼센트를 테스트용 데이터로 만들지 정함. 0.2는 20%의 테스트용 데이터와 80% 학습용 데이터로 분리. random_state 는 무작위로 수행할 때마다 다른 학습용 데이터와 테스트용 데이터를 만들지 않도록 임의의 수를 지정해주는 것. 계속 동일한 난수를 만들게 하는 np.random.seed()와 비슷하며 안의 숫자가 변경되면 값도 변경됨.
train_test_split in Python
sklearn.model_selection import train_test_split

x_train, x_test, y_train, y_test =
train_test_split(X, Y, test_size=0.2, random_state=0)
🚀 오늘 공부를 마치며
프론트엔드 수업 때 들었던 이고잉 코치님의 생활코딩으로 머신러닝을 다시 복습했다. 재미있는 이야기가 있어서 조금 적어보려고 한다.
해결하고자 하는 문제가 없다면 지식은 목적 없는 수단에 불과하다. 습관을 고치는데 머신러닝을 사용해볼까? 예를 들어 내가 손톱을 물어뜯으면 경고를 주는 그런 어플을 머신러닝을 활용해 만들어본다고 가정해볼수있다. (나는 손톱 물어뜯는 습관은 없다) 하지만 다들 작심삼일을 경험해보았든 의지만으로는 습관을 이기기 힘들다. 습관을 바꾸기 위해서는 지속적인 영향을 주는 환경이 바뀌면 습관은 서서히 변할 것이다. 그런데 그 환경을 바꾸는 것은 나의 의지가 된다! 놀라운 삼각관계.
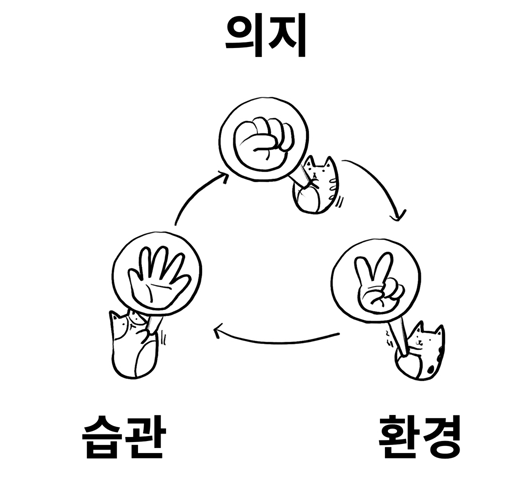
습관은 의지를 이기고, 의지는 환경을 이기고, 환경은 습관을 이긴다. 그러니 의지로 환경을 조정해 환경이 습관을 손봐주는 우회전략을 구사해보자. 의지가 강해도 환경을 바꾸는 것은 어려울 것이다. 이런 환경을 만드는데 앞서 말한 머신러닝 같은 걸 한 스푼 집어넣어 습관을 없애는데 도움이 될 만한 환경에 지속해서 노출되면 천천히 습관을 새로고침 할 수 있을지 모른다! 한계를 경험하고 나면 더 나아가고 싶은 욕구가 생긴다. 그 욕구를 단순히 꿈만 꾸는 몽상가가 아니라 실제로 이루어내는 혁명가가 되고 싶다.
머신러닝의 개념도 잘 이해가 되는 말이었지만 생활에서도 많이 도움이 될 것 같아 길지만 한 번 적어봤다. 목적의식 없는 공부는 나를 지치게만 하니까.
그리고 또! 벨로그를 이쁘게 꾸미려다 보니 수식도 직접 쓰고 내용도 더 첨언하느라 여러가지 블로그, 깃허브를 방문하고 있는데 시간은 오래 걸리지만 그만큼 지식이 깊어지는 것 같고 결과물도 마음에 든다. 계속 이렇게 꾸준하게.. 하고싶다 : )
--
upload : 2022.02.04
1st update : 2022.02.14 🍫
썸네일 제작 : 미리캔버스
내용 참조 : 엘리스
이미지 및 내용 참조 : 생활코딩
reshape(-1, 정수) 관련 내용의 출처 : R, Python 분석과 프로그래밍의 친구 (by R Friend)
train_test_split 의 관련 내용의 출처 : 몽총이의 몽총몽총해 블로그