[논문리뷰] REVECA: Adaptive Planning and Trajectory-based Validation in Cooperative Language Agents using Information Relevance and Relative Proximity
HAI

- paper link
- 너무 익숙해서 뭔가 했는데 이전 제목은'LLM-Based Cooperative Agents using Information Relevance and Plan Validation이다.
- REVECA 논문을 읽고 난 다음에는 다른 모델들도 확인해보면 좋을듯!
- AgentGym, MEMWALKER, VOYAGER, DEPS
한마디로 동적으로 변화하는 환경에서 메모리를 중요도에 따라 나눠서 효율성을 챙기기도 하고, 환경이 변화하는 것을 실시간으로 인식해서 세부 목표도 최적의 상태로 변화하는 것을 만들었다.
무엇을 해결하려고?
복잡한 관찰 환경에서 다중 에이전트가 서로 협력해서 공동 목표를 달성하도록 만드는 효율적이고 적응적인 AI 시스템을 개발하자!
그럼 지금 문제는 뭔데?
1. 기존에는 관찰된 정보를 효율적으로 관리하지 못함!!
2. 협력 에이전트의 '행동 변화'를 반영하지 않아서 잘못된 계획이 생성됨 (후술하겠지만 이미 다른 사람이 우유를 가져갔는데 그걸 모르고 또 가지러 간다던가)
3. 공간 데이터를 의사결정 과정에 제대로 통합하지 못해 비효율적인 경로 생성
모든 걸 해결했어?
아님! 에이전트 간의 통신 비용도 절감해야 하고 동적 환경에서 불필요한 객체(노이즈)를 관리해야 함
어떻게 했어?
정보 중요도를 평가하고, 계획을 검증하고, 공간 정볼르 통합하고, 모듈을 설계!
실험 결과는?
협업 적합성, 유용성, 효율성, 신뢰도에서 가장 높은 점수를 받음!
개요는 이러하고... 원래 해결법 부분만 보려고 했는데 요즘 논문을 써보려고 하다 보니 문제 정의가 상당히 중요하다는 것을 깨달았다.... 문제 정의부터 한 번 보자!
Problem Definition
분산 부분 관찰 마르코프 결정 프로세스가 무엇인가! 에이전트가 환경의 상태를 완전하게 관찰할 수 없는 상황에서 의사결정을 내리는 모델이다. 요 논문에서는 이걸 확장해서 이러한 '비가시성' 문제를 해결하려고 하는 것!
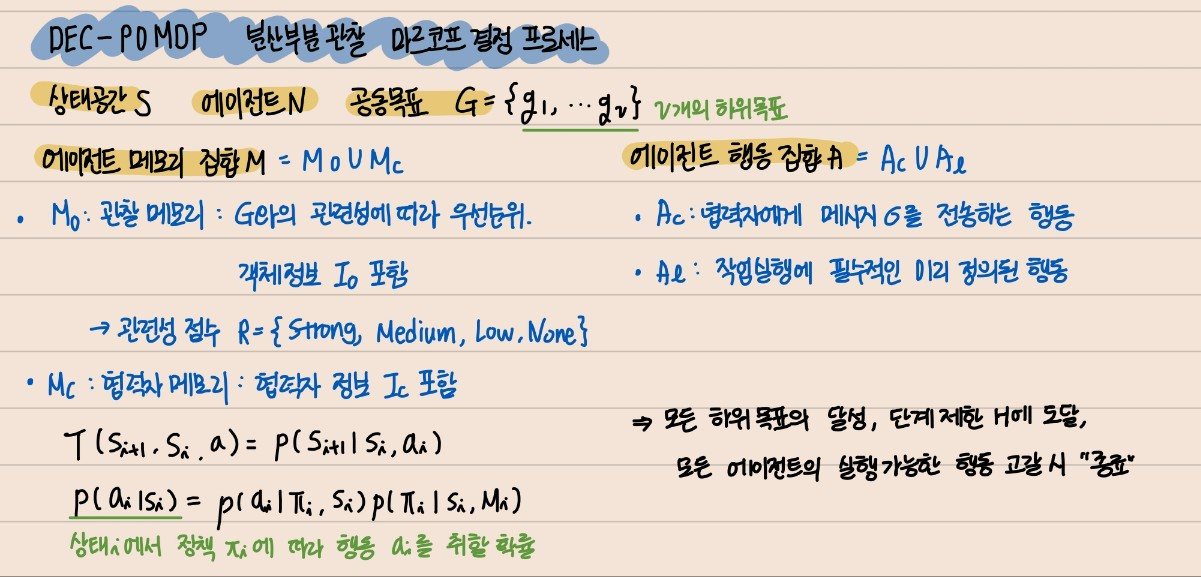
-> 요 프로세스 대로 REVECA framework가 진행됨!
조금 헷갈려서 'D-POMDP'와 이 논문에서 제시한 'REVECA'가 어느 지점에서 다른 것인지 정리를 해보았다.
| D-POMDP | REVECA(확장된 모델) | |
|---|---|---|
| 에이전트 구조 | 각 에이전트는 환경을 개별적으로 관찰하고, 다른 에이전트의 상태와 행동을 완전히 알지 못함 | 자신의 관찰 정보 뿐만 아니라 협력자의 과거 행동과 대화 이력을 바탕으로 의사 결정을 내림 |
| 메모리 구조 | 관찰 메모리 + 의사결정 메모리 | 관찰 메모리와 협력자 메모리를 사용해 환경 정보를 넓게 수집하고 협력자의 행동을 예측 |
| 정보 공유 | 최소한 공유 | 효과적인 정보 공유를 위해 자연어 기반의 커뮤니케이션 모듈 활성화됨. 에이전트는 상대방의 행동과 현재 상태를 추적하기 위해 메시지를 교환하며, 이를 통해 공동의 목표를 달성하는 데 필요한 정보를 실시간으로 업데이트할 수 있움 |
| 행동결정방식 | 자신의 관찰 정보에 기반해서 개별적으로 행동을 결정하기 떄문에 협력적 기여 최적화보다는 각 에이전트의 보상 극대화에 초점을 두고 있음 | 상호작용을 고려하여 협력적으로 접근 |
그러니까 결국 협력하는 에이전트를 만들겠다는 것!
REVECA FRAMEWORK
크게 6가지의 모듈로 구성!
- 통신 모듈 : LLM을 이용하여 에이전트 간의 자연 언어를 통한 정보 공유를 촉진
- 관찰 모듈 : 에이전트가 현재 위치에서 관찰할 수 있는 내용을 기반으로 환경 데이터를 수집하고 네 가지 관련성 수준으로 분류
- 메모리 모듈 : 공통 목표, 관찰 메모리, 협업자 메모리, 저수준 행동 기술서의 네 가지 구성 요소로 이루어짐
-> 에이전트의 의사 결정 과정에 중요한 데이터를 저장, 업데이트 및 관리 - 계획 모듈 : 에서 K 정보를 검색하고 관련성 점수와 상대 근접성을 사용하여 적응형 계획 를 생성
- 검증 모듈 : 협업자가 주어진 작업 목표를 이미 수행했을 가능성을 추정해 협업자의 궤적을 예측. 만약 계획 모듈이 생성한 계획이 협업자가 수행할 가능성이 높은 작업 목표를 포함할 경우, 해당 계획은 무효 계획으로 식별되어 재구성이 요구됨
-> 우유 잡으러 가다가 스탑! 한 것 - 실행 모듈 : 미리 정의된 저수준 행동 기술서를 사용하여 검증된 계획 실행.
-> 기술서는 벤치마크 프레임워크에 의해 제공된다고 함
1. Observation Time
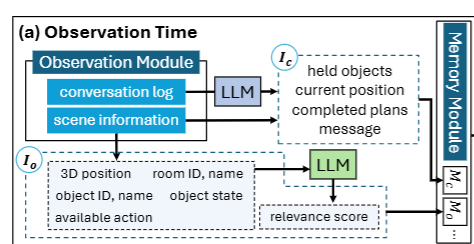
- 관찰 시간 동안 관찰 모듈은 원시 장면 정보를 수정하고 이를 (객체정보)에 담는다.
->사진에서 볼 수 있듯이 3d positions, object IDs 등등 - 는 LLMs에 의해서 공동목표 G를 바탕으로 관련성 점수 R에 할당되는데 이런
관련성 기반 우선 순위 설정은 메모리 항목의 참조를 피하고 가장 관련성 높은 정보에 집중! - (협력자 정보)는 직접 관찰하거나 다른 에이전트와의 대화(로그)를 통해 수집한 것!
- 와 는 각각 와 로 메모리 모듈 내에 저장됨!
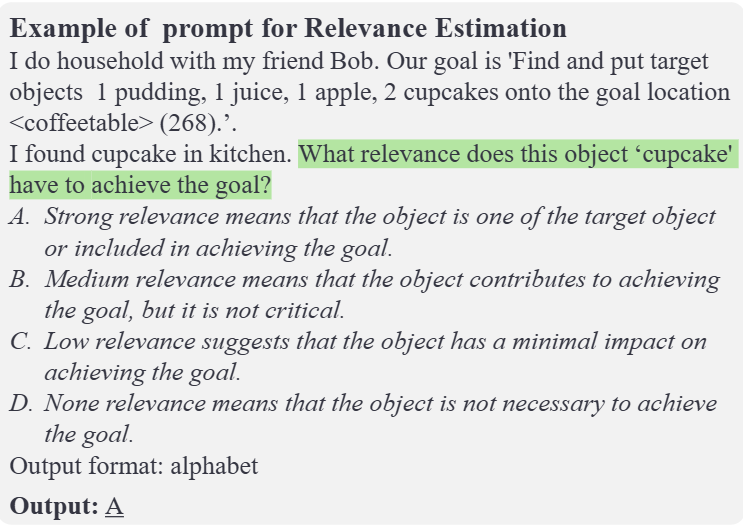
위 그림이 바로 관련성 평가를 어떻게 하는지를 보여줌
2. Planning Time
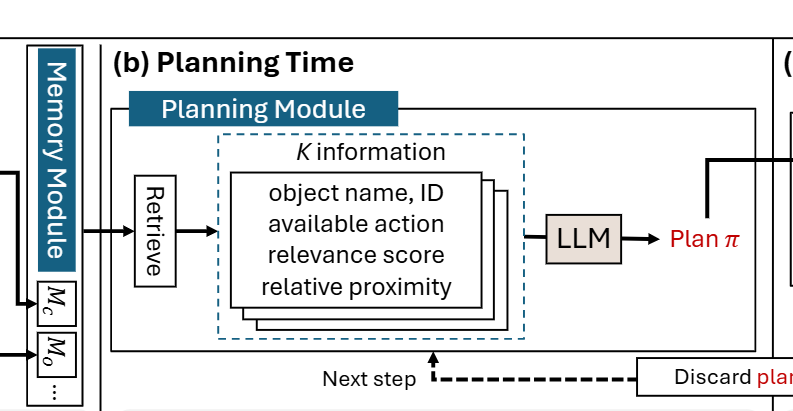
- 먼저 관련성 기반으로 에서 K개의 정보를 검색(Retrieve)
- 관련성 점수 R에 따라 내림차순으로 정렬되는데, 동일한 관련성 점수를 가진 정보 항목에 대해서는 추가로 상대 근접성 P를 계산해 우선 순위를 정함!
-> 숫자 거리를 해당하는 자연어 설명이 있으면 성능이 현저하게 향상되었다고 함!
-> ex. Bob 보다 가깝다 - LLM은 CoT를 통해, 의 k 개의 조각, 관련성 점수, 입력 프롬프트에 대한 상대 근접성을 포함해
계획를 생성!
3. Validation Time
검증 시간이 필요한 이유!
아무리 계획을 잘 세웠다고 해도 관찰과 계획 사이의 간격에서 협업자들로 인한 환경 변화로 인해 무효가 될 수 있기 떄문!
-> 그래서 객체의 위치를 다시 방문하거나, 모든 협업자들에게 상호작용에 대해 질문할 순 있지만...
-> 너무 비효율적이다!
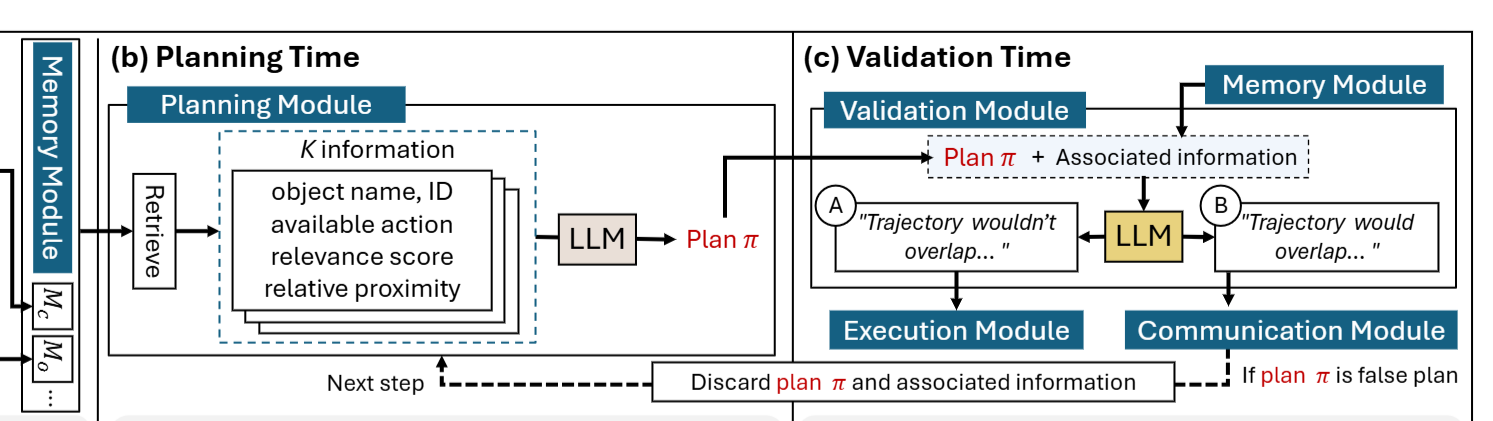
- 일단 planning 모듈에서 만든 계획 를 검증하고 싶다면, 에이전트는 각 협업자들의 과거 궤적 를 예측한다.
- 이를 위해 에서 찾은 협력자 에 대한 모든 관련된 정보, 에서 찾은 관련성 정보와 를 찾는다.
- 그런데! 에이전트가 정보를 수집하는 시점과 다음 행동을 계획하는 시점 사이에 시간 간격이 존재할 수 있음!
- 이 경우
Communication Module을 이용해서 가장 높은 상호작용 확률을 가진 협력자에게 메시지를 보내 예측을 확인 - 이런 정보를 보완하기 위해 LLM의 추론 능력을 활용해서 협력자 의 경로 를 구성 == 협력자가 시간 a부터 b까지 어떻게 이동했는지 추적
- 현재의 계획이 잘못된 거면 폐기!!
- 만약 모든 협력자가 상호작용을 거부한다면 해당 계획은 그대로 진행!
Experiment
실험 환경
세 가지 유형의 실내 다중 방 시뮬레이션 환경에서 수행
- C-WAH (Communicative Watch-And-Help)
- TDW-MAT (ThreeDWorld Multi-Agent Transport)
- Noisy-C-WAH (잡음이 있는 C-WAH)
실험 절차
각 환경에서 에이전트는 주어진 목표를 달성하기 위해 다양한 작업을 수행하도록 프로그래밍
성과 평가
성공률, 효율성, 강인성 등의 측면에서 평가
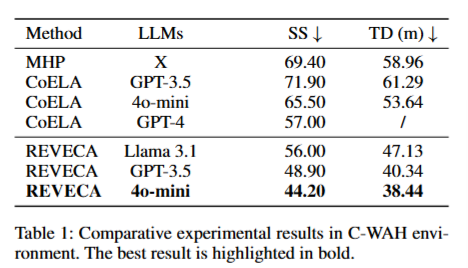
대부분의 실험에서 유효한 결과를 보였다고 함!
Appendices
사실 내가 이 논문을 보고 우와! 했던 이유는 시뮬레이션이 3D라는 점...