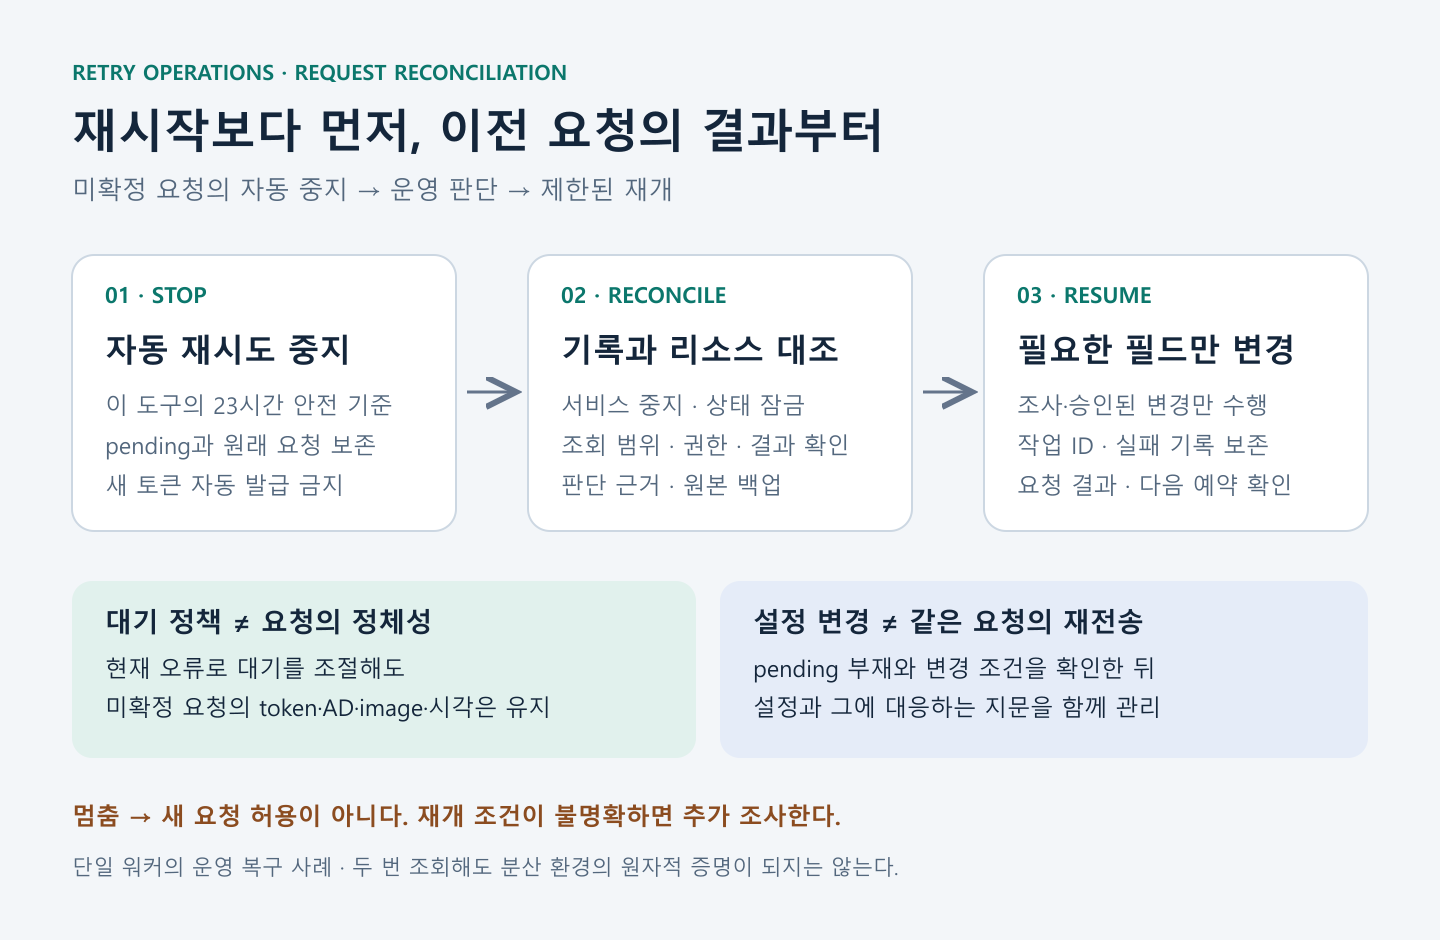
9월 21일 새벽, OCI 인스턴스 생성 재시도기가 멈췄다. 재시작 명령부터 실행할 상황은 아니었다. 이전 생성 요청의 결과를 확정하지 못한 채, 도구에 설정해 둔 23시간 중단 기준에 도달했기 때문이다.
서비스를 다시 켜는 일보다 먼저 답해야 할 질문이 있었다.
이전 요청이 이미 인스턴스를 만들었다면, 지금 새 요청을 보내도 될까?
이전 글에서는 요청 전에 작업 기록을 남기고 같은 토큰으로 이어 가는 구현을 다뤘다. 이번 글은 그 이후의 운영 기록이다. 미확정 요청을 보존하면서 대기 정책을 고치고, 만료된 기록을 확인한 뒤 재개하고, 신청 사양을 바꾼 과정을 정리한다.
확인 범위: 2026년 9월 20~22일의 변경 기록과 코드가 중심이다. 9월 27일에는 관련 로컬 회귀 테스트 2개를 다시 실행했다. 인스턴스 확보 성공 후기가 아니며, 복구 당시의 실제 재신청도 용량 부족으로 끝났다. 계정 식별자·토큰·IP·원본 운영 로그는 제외했다.
한눈에 보는 이번 변경
| 상황 | 바꾼 것 | 유지한 것 |
|---|---|---|
| 미확정 요청 뒤 용량 부족 응답 | 현재 오류에 맞는 대기 시간 | 원래 토큰·AD·이미지·최초 요청 시각 |
| 미확정 요청의 안전 기한 경과 | 확인 후 pending과 다음 예약 | 작업 ID·설정 지문·누적 실패 횟수 |
| 신청 사양 축소 | CPU·메모리 설정과 설정 지문 | 작업 ID·기존 예약·실패 기록 |
공통 기준은 하나였다. 다시 시도할 시점, 같은 요청인지 여부, 설정을 바꿔도 되는지를 별개의 판단으로 다룬다.
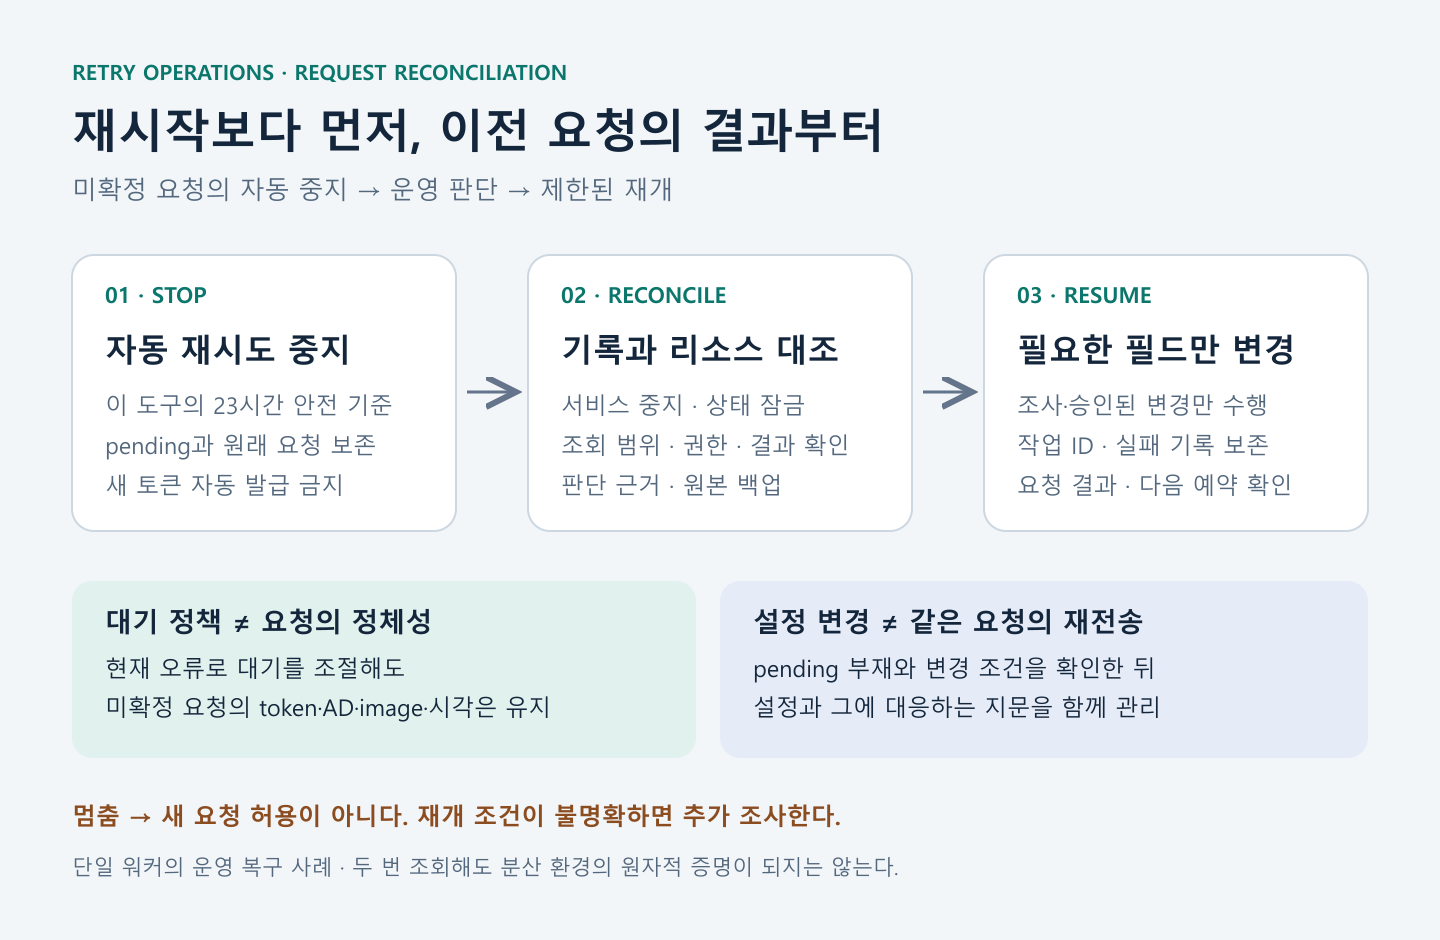
단일 워커의 복구 절차를 요약한 설명용 도식이다. 재개 조건이 불명확하면 추가 조사한다.
1. 대기 시간과 요청의 정체성을 분리했다
9월 20일 점검에서 이상한 대기를 발견했다. 앞선 서버 오류로 생성 결과가 불명확해져 pending을 보존한 뒤, 다음 응답이 용량 부족이어도 대기가 약 50~60분까지 늘어나고 있었다. 이 도구의 용량 부족 재시도 설정은 4~6분이었다.
문제는 두 판단이 섞여 있다는 점이었다.
- 얼마나 기다릴까? 지금 받은 오류에 따라 결정한다.
- 어떤 요청을 보낼까? 이전 결과가 불명확하면 원래 요청을 유지한다.
그래서 현재 오류로 대기 종류를 정하되, 이미 pending이 있었다면 그것을 지우지 않도록 정리했다. 다음은 실제 오류 처리 부분의 발췌다. was_pending은 이번 호출 전에 미확정 요청이 있었는지를 뜻한다.
kind = classify_oci_error(
    exc.status, exc.code, exc.message
)
self.last_retry_kind = kind

if kind == "fatal":
    raise FatalOCIError(
        "non-retryable OCI error"
    )

if kind == "transient" or was_pending:
    return None  # 원래 pending을 유지한다
독립 실행 코드가 아니라 launch_cycle()의 예외 처리 흐름이며, 오류 메시지는 설명을 위해 줄였다. 이후 스케줄 계산이 last_retry_kind를 사용한다. 현재 설정에서는 용량 부족에 4~6분, 429·통신·일시 서버 오류에는 별도의 10~60분 백오프를 적용한다. 이 수치는 도구의 운영 정책이지 Oracle이 보장하거나 권장한 확보 주기는 아니다.
여기서 중요한 반례가 있다. 나중에 용량 부족 응답을 받았다고, 앞서 응답을 잃은 요청도 실패했다고 소급해 결론 내릴 수는 없다. 대기를 줄이는 변경이 새 토큰 발급으로 이어지면 안 된다. 토큰뿐 아니라 원래 AD(가용성 영역), 이미지, 최초 요청 시각도 유지했다.
2. 23시간이 지나면 왜 자동 재시도를 멈출까?
OCI의 opc-retry-token은 타임아웃이나 서버 오류 뒤 같은 작업을 재요청할 때 사용한다. 문서상 토큰은 24시간 후 만료되며, 충돌하는 작업으로 그 전에 무효화될 수도 있다. Oracle REST API 문서
이 도구는 토큰 유효성을 끝까지 가정하지 않도록, 로컬에서 기록한 최초 요청 시각으로부터 23시간 이상 지나면 미확정 요청의 자동 재전송을 멈춘다. 23시간은 자체 중단 기준이지, 그때까지 토큰이 유효하다는 보장은 아니다.
request_age = time.time() - pending["created_at"]
if request_age >= 23 * 3600:
    raise FatalOCIError(
        "Inspect the unresolved request before resuming"
    )
실제 조건을 가독성 위주로 옮긴 발췌다. 상태 파일을 지우거나 새 토큰을 발급하는 코드는 아니다. 또한 time.time()에 의존하므로 시스템 시계 변경까지 방어한 구현으로 설명해서는 안 된다.
9월 21일 03:15 KST에 이 중단 조건이 작동했다. 프로세스가 계속 살아 있는 것보다 결과를 모르는 요청을 새 작업으로 바꾸지 않는 것이 우선이었다.
3. 만료됐다는 사실만으로 기록을 지우지 않았다
재개 작업 당시 원래 요청은 약 33.5시간 전의 요청이었다. 시간만 보고 초기화하지 않고, 실행 중인 프로그램과 작업 기록, OCI에 실제로 보이는 리소스를 대조했다.
진행 순서는 다음과 같았다.
- 예상한 프로그램 버전과 서비스 중지 상태인지 확인한다.
- 상태 파일을 잠그고, 조사했던 작업·요청 기록이 그대로인지 대조한다.
- 토큰의 경과 시간을 확인하고, 관련 구획의 비종료 인스턴스를 조회한다.
- 인증·리전·사용량 사전 점검을 수행하고 리소스를 다시 조회한다.
- 원본 프로그램·설정·상태와 확인 내용을 백업한다.
- 승인된 범위에서
pending과 다음 예약만 변경한다. - 상태를 다시 읽어 대조하고, 잠금을 해제한 뒤 서비스를 시작한다.
조회 결과에는 기존 워커인 Micro 인스턴스 한 개만 있었다. 복구 스크립트는 미리 확인한 실행 파일 해시, 작업 ID, 실패 횟수와 요청 내용 등이 하나라도 다르면 중단하도록 만들었다. 다른 장애에 그대로 재사용하는 범용 초기화 도구가 아니라 조사한 한 건을 위한 일회성 복구 도구였다.
조회도 범위가 중요하다. 권한이 없어 읽지 못한 결과를 빈 목록으로 해석하면 안 되고, 페이지네이션을 끝까지 따라가야 한다. OCI 문서는 다음 페이지가 남아 있어도 현재 페이지가 비어 있을 수 있다고 설명한다. Oracle 목록 페이지네이션
두 번 조회했다고 원자적인 증명이 되지는 않는다.
이 복구는 단일 워커를 멈추고, 조사한 요청과 조회 가능한 리소스를 대조한 운영 판단이었다. 다른 생성 주체의 동시 작업이나 조회 반영 지연까지 제거하는 분산 트랜잭션이 아니다. 리소스 존재 여부에 모순이 있거나 조회를 신뢰할 수 없다면 재개하지 않고 추가 조사해야 한다.
백업에 남긴 핵심은 단순한 “재시작 완료” 문장이 아니었다. 조회 시각, 조회 범위, 관찰한 리소스, 사전 점검 결과, 변경한 필드를 남겼다. 그래야 나중에 왜 새 시도를 허용했는지 되짚을 수 있다.
4. 설정 변경도 같은 요청의 재시도는 아니다
다음 날에는 신청 사양을 2 OCPU·12GB에서 1 OCPU·6GB로 줄였다. 작은 사양으로 먼저 확보해 보자는 선택이었다. 사양을 줄이면 확보된다는 보장은 없으며, 실제 첫 신청도 용량 부족으로 끝났다.
여기서 설정 파일의 숫자만 바꾸면 문제가 생긴다. 도구는 CPU·메모리·네트워크 등 생성 요청의 주요 설정을 해시로 묶은 config_fingerprint를 상태에 저장한다. 현재 설정과 지문이 다르면 기존 작업을 그대로 재개하지 않는다.
이 지문은 인증 토큰도, 설정 변경을 허가하는 수단도 아니다. 이전 요청과 다른 내용으로 실행하려 한다는 것을 감지하는 장치다. 오류가 난다는 이유로 지문만 새 값으로 덮어쓰면 보호 조건을 우회하게 된다.
실제 변경 때에는 먼저 서비스를 멈추고 상태 파일을 잠갔다. pending, instance_id, completed_at이 모두 없는지 확인하고, 새 사양의 사전 점검과 생성 요청 본문도 확인했다. 그 뒤 설정의 두 필드와 대응하는 지문을 함께 변경했다.
| 필드 | 이번 사양 변경에서의 처리 |
|---|---|
| CPU·메모리 | 승인된 작은 사양으로 변경 |
| config_fingerprint | 새 설정으로 런타임이 계산한 값 반영 |
| job_id | 작업 추적을 위해 보존 |
| next_attempt_at | 기존 예약 유지 |
| 실패 횟수·백오프 기록 | 보존 |
| pending | 없는 상태를 전제하며, 변경을 위해 강제로 지우지 않음 |
서비스를 다시 시작하자 기존 예약 시각까지 기다린 뒤 새 사양의 요청이 실행됐다. 이 변경 도구 자체가 생성 API를 호출한 것은 아니다.
설정과 상태는 각각 임시 파일에 쓰고 동기화한 뒤 교체했다. 쓰기 중 예외가 나면 서비스가 멈춘 동안 원본 두 파일을 복원하는 경로도 두었다. 다만 파일 두 개의 개별 원자적 교체가 둘을 묶은 하나의 원자적 트랜잭션은 아니다. 프로세스 강제 종료나 전원 장애가 두 교체 사이에 발생하는 경우까지 완전하게 복구한다고 주장할 수는 없다.
5. 실행 확인과 확보 성공을 분리했다
운영 기록에서 확인한 결과는 다음과 같다. 시간은 모두 KST다.
| 시점 | 확인한 결과 | 뜻하지 않는 것 |
|---|---|---|
| 9월 20일 15:33 | 기존 pending을 보존한 채 재신청, 용량 부족 뒤 약 4분 대기 | 새 인스턴스 생성 성공 |
| 9월 21일 03:15 | 23시간 기준으로 자동 재시도 중단 | 과거 요청이 반드시 실패했다는 판정 |
| 9월 21일 13:44 | 조사·백업·제한된 변경 후 재신청, 용량 부족 응답 | 모든 장애에서의 복구 보장 |
| 9월 22일 22:34 | 1 OCPU·6GB 요청 실행, 기존 예약 보존 확인 | 작은 사양의 확보 가능성 보장 |
글을 정리한 9월 27일에는 다음 두 회귀 테스트를 프로젝트 가상환경에서 다시 실행해 통과를 확인했다.
- 미확정 요청을 유지한 재시작 뒤 용량 부족·429·일반 서버 오류를 차례로 받더라도, 원래 토큰·AD·이미지·생성 시각을 유지하면서 대기 시간을 구분하는 테스트
- 23시간이 지난 미확정 요청에 대해 생성 API를 호출하지 않는 테스트
Ran 2 tests in 1.068s
OK
이 테스트는 mock과 임시 상태 파일을 사용한다. 실제 OCI 생성 요청을 보내지 않았으며, 이번 글 준비 중 운영 서버를 재시작하거나 복구 스크립트를 다시 실행하지도 않았다. 테스트 성공, 과거의 운영 복구 확인, 실제 인스턴스 확보는 서로 다른 결과다.
다시 켜기 전 체크리스트
- 마지막 요청이 실패로 확정됐는가, 아직 결과 불명인가?
- 대기 정책을 바꾸는가, 요청 내용 자체를 바꾸는가?
- 최초 요청 시각과 토큰을 새 값으로 덮어쓰고 있지 않은가?
- 리소스 조회의 권한·범위·페이지네이션을 확인했는가?
- 다른 워커나 외부 작업이 동시에 생성할 가능성이 있는가?
- 원본 상태와 판단 근거를 백업했는가?
- 바꿀 필드와 보존할 필드를 구분했는가?
- 프로세스 실행뿐 아니라 실제 요청 결과와 다음 예약을 확인했는가?
마치며
재시도기를 운영하며 배운 것은 “계속 다시 보내기”보다 “어떤 조건에서는 멈추기”였다. 응답을 잃은 요청을 기억하고, 그 기억을 버릴 때에도 근거를 남겨야 했다.
대기는 현재 오류에 맞게 조절하되 요청의 정체성은 유지한다. 설정이 바뀌면 같은 재시도라고 가정하지 않는다. 그리고 서비스가 살아 있다는 사실을 자원 확보에 성공했다는 말로 바꾸지 않는다.
다음 운영 글에서는 중단 상태를 놓치지 않도록 마지막 시도·다음 예약·결과 불명·수동 확인 필요 상태를 어떻게 관찰하고 알릴지를 다뤄 보려 한다. 그 관찰·알림 체계까지 완성했다는 뜻은 아니다.
