7주차
Tue. 18. 4.
수강한 분량: 06. 시계열 분석(이론/실습) 01 - 10.
학습한 핵심 내용:
-Forecast(시계열 분석)

ㄴ시간의 흐름에 대해 특정 패턴/주기성 등 같은 정보를 가지고 있는 데이터
ㄴ머신러닝에서는 시간이 특성으로 잡히는 경우가 별로 없어 잘 안 다루기는 함
ㄴ딥러닝에서 RNN 계열의 네트워크까지 가야 다룸
ㄴ통계학에서 시계열 데이터라는 것만으로 많은 학습량
- Seasonal Time Series: 주기성을 가지고 있는 데이터를 다루는 경우
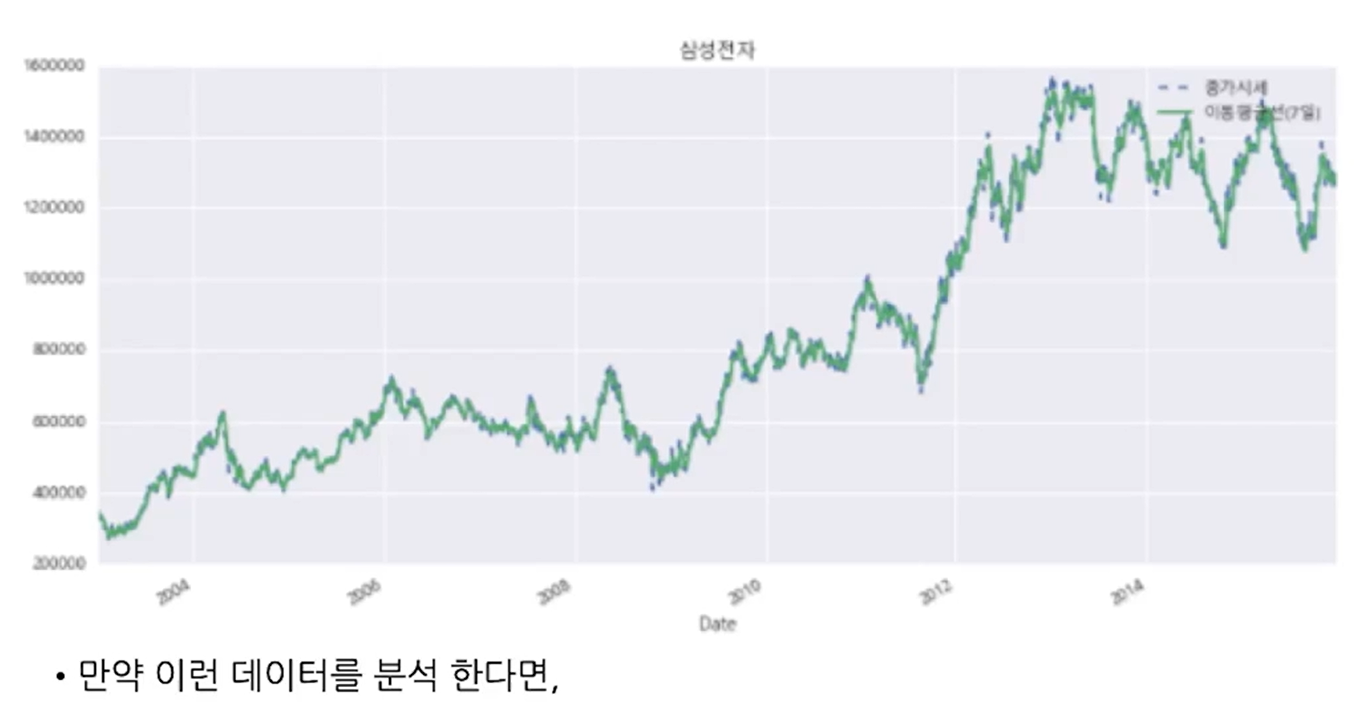
ㄴ주가 데이터
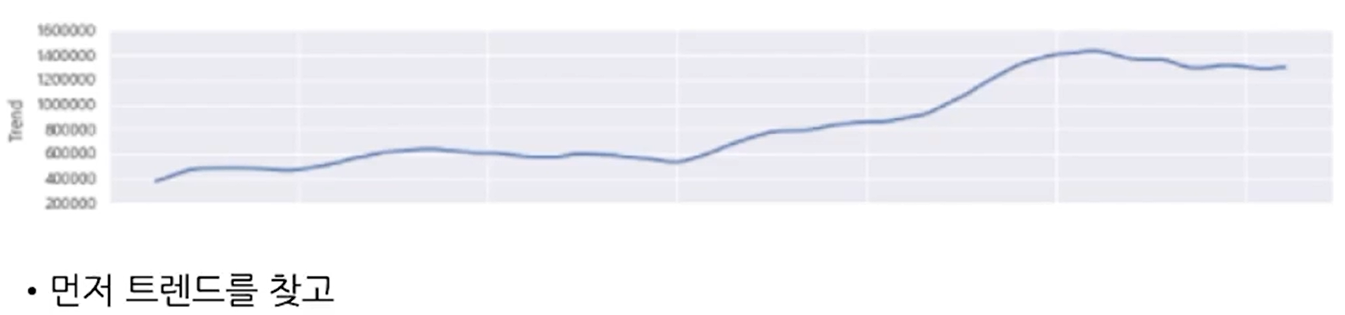
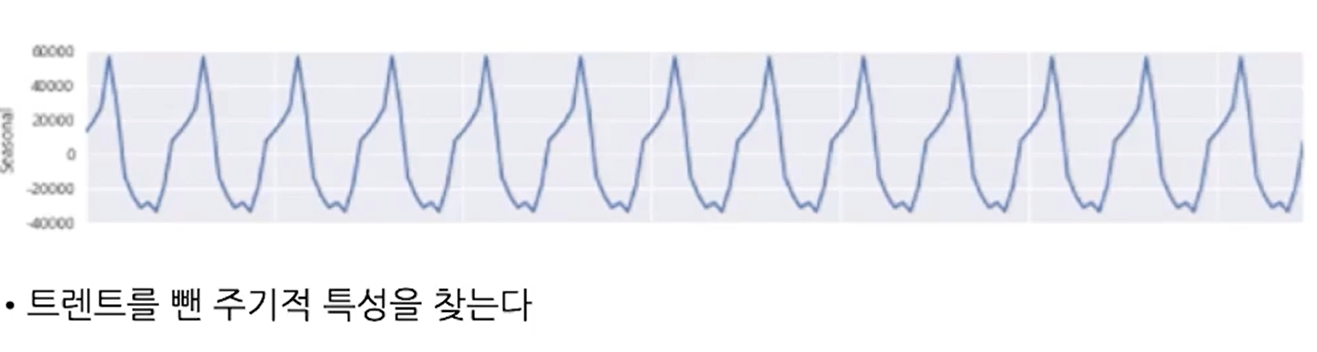
- fb-Prophet: Seasonal Time Series에 대한 모듈
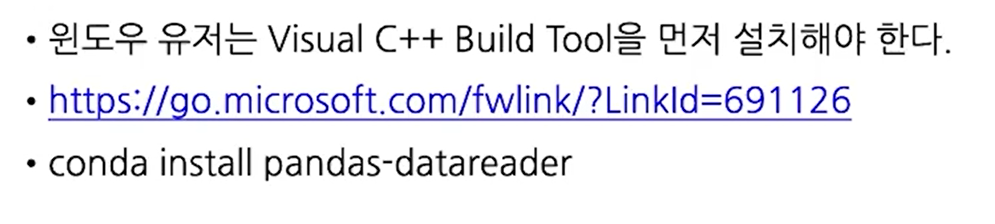
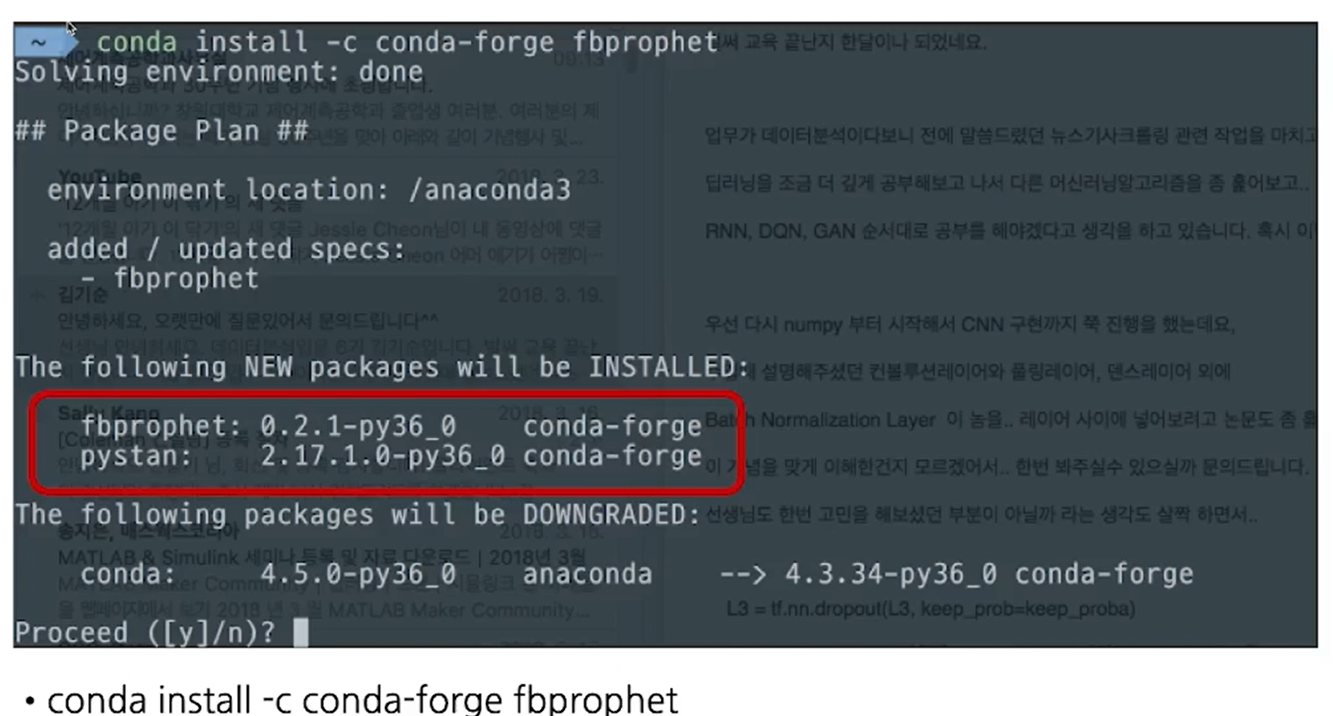
ㄴ 설치
-함수 선언
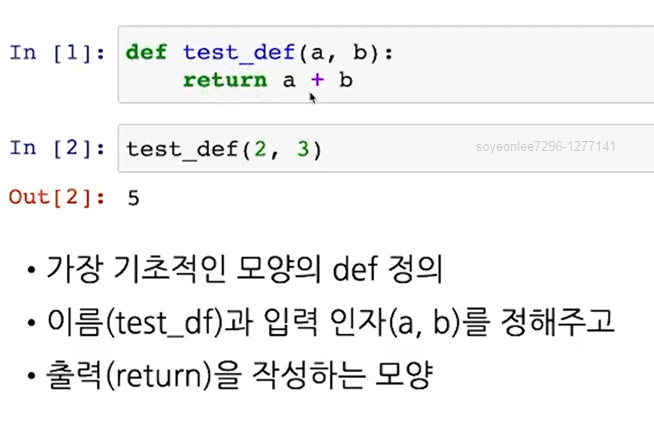
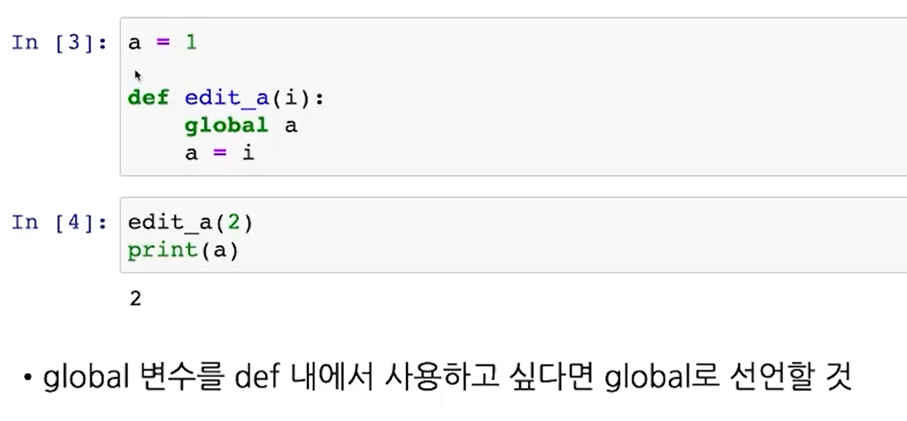
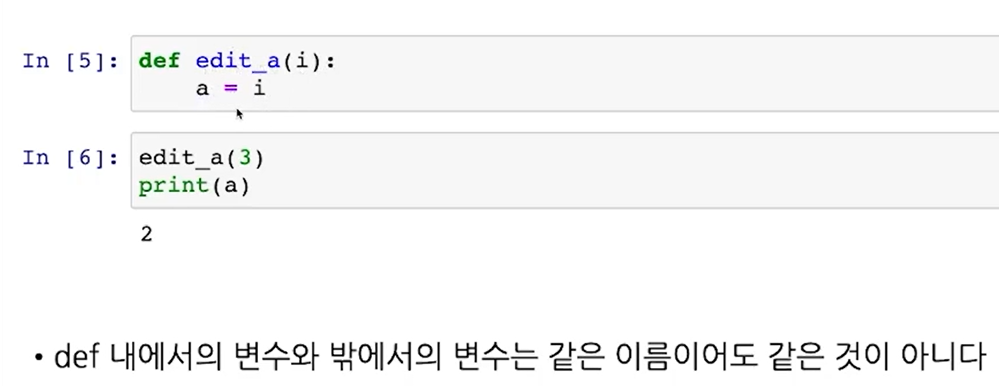
- 전역 변수
- 삼각함수의 표준형
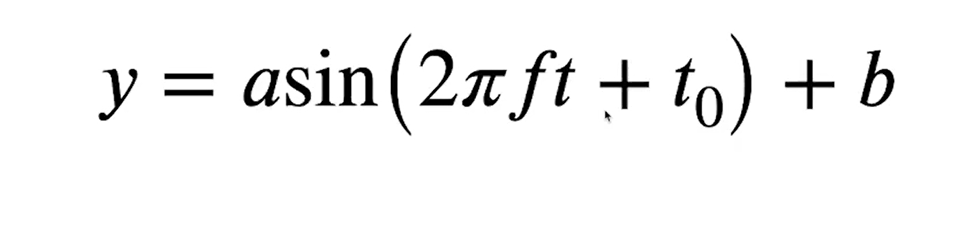
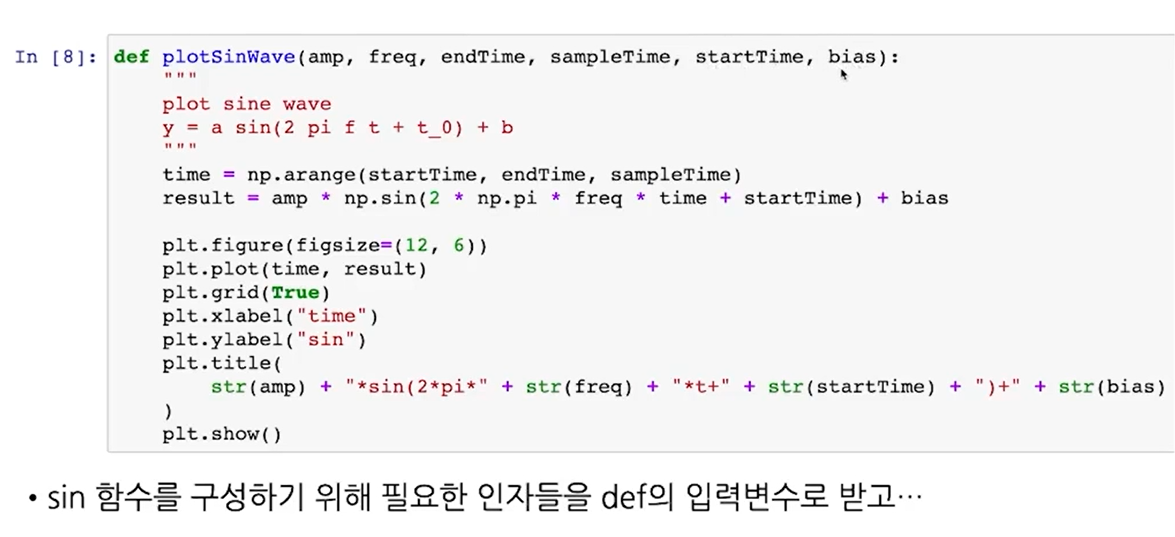
ㄴendTime: (x축을) 어디까지 그릴 것이냐, sampleTime: 얼마나 잘게 나눌 것이냐, startTime: 언제부터 시작할 것이냐
ㄴ""" 따옴표 3개 앞뒤로 함수 밑에 붙여서 작성하면: 함수의 설명을 호출(shift+tab)할 때 표현되는 내용이 됨
ㄴtime(데이터, startTime부터 endTime까지 sampleTime 간격으로 생성된 데이터)이 10개라면 result도 10개 나오게 된다.
ㄴfreq: Hz
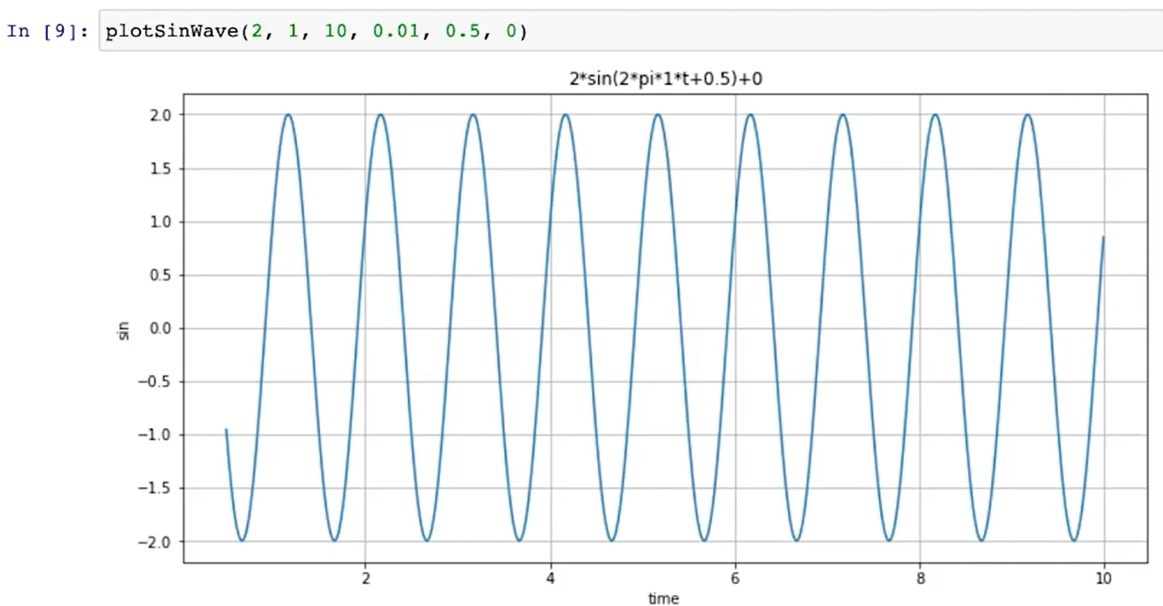
ㄴ인자의 이름, 순서 등이 복잡하여 불편하다.
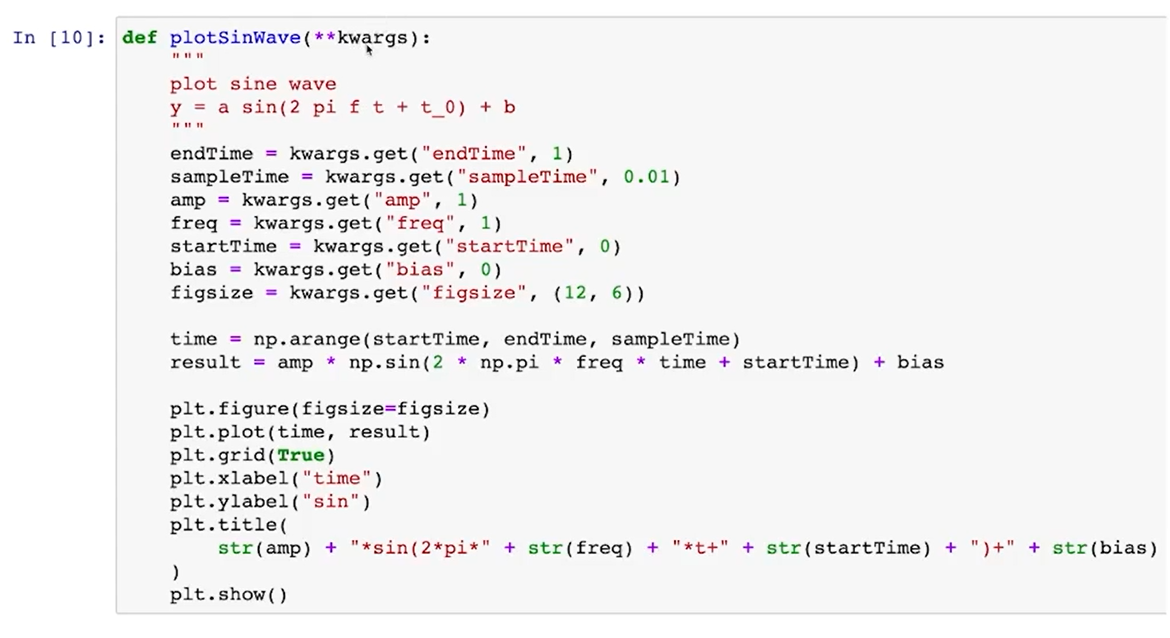
ㄴasterisk 2개를 사용한다. kwargs는 keyworded arguments인데 흔히 사용되는 변수명.
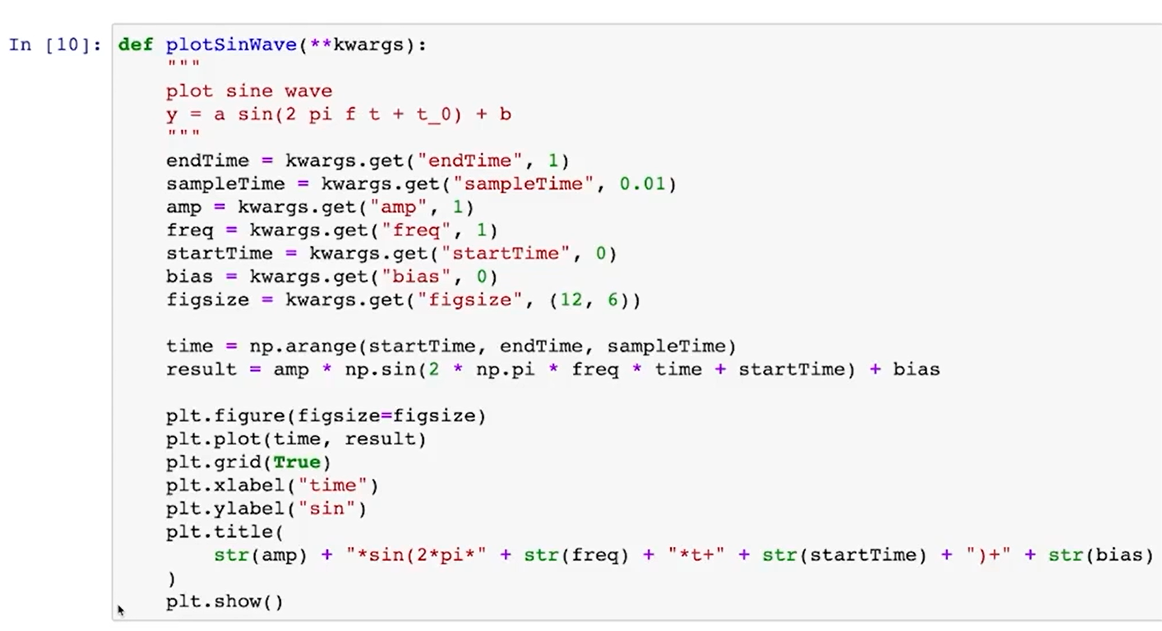
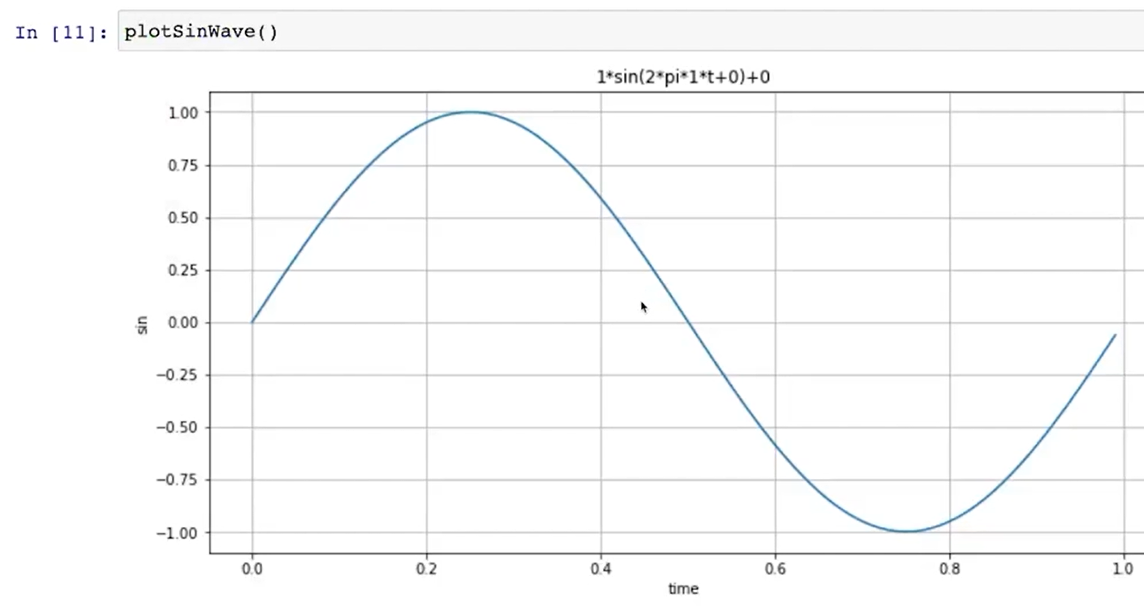
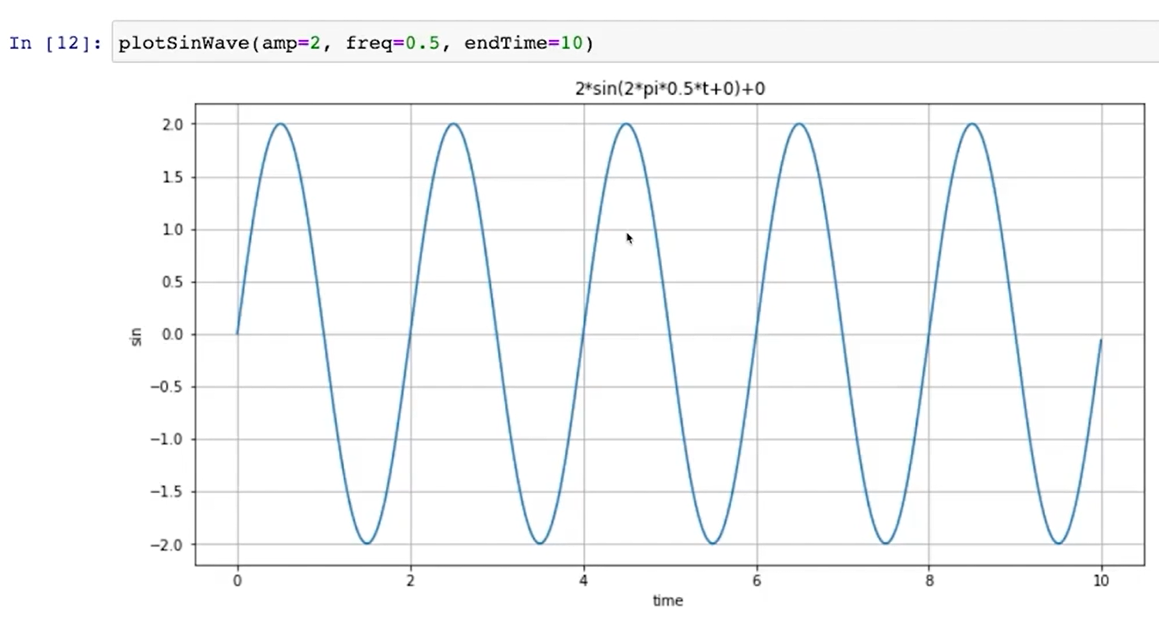
ㄴ사용자가 인자를 입력을 하면 그걸 쓰고 아니면 기본값이 입력되도록 설정한 것임.
-내가 만든 함수를 module로 만들어서 import하여 사용할 수 있게 하기
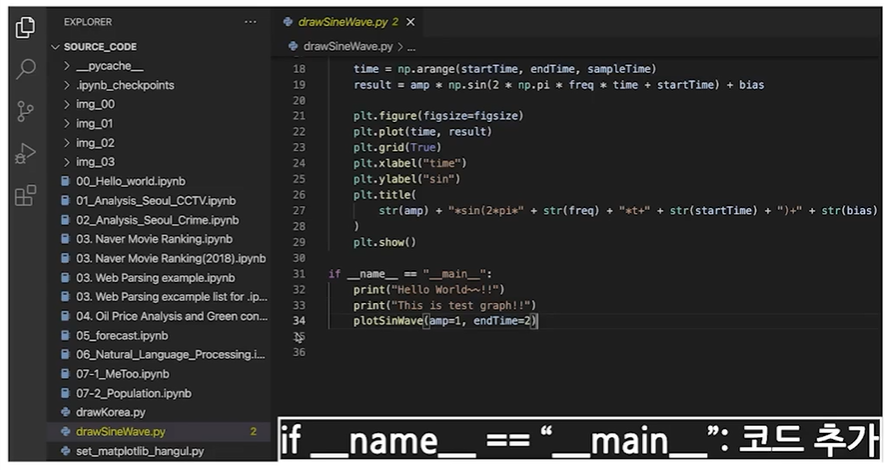
ㄴ.py 파일을 만들어야 함
ㄴ어떤 에디터든 사용해야 함(예: vscode)
ㄴimport 하면 함수 실행, python 명령으로 직접 실행 시 ifname(예약어) == "main" 코드 실행
-Fbprophet 기초(알고리즘이 탑재된 모듈)
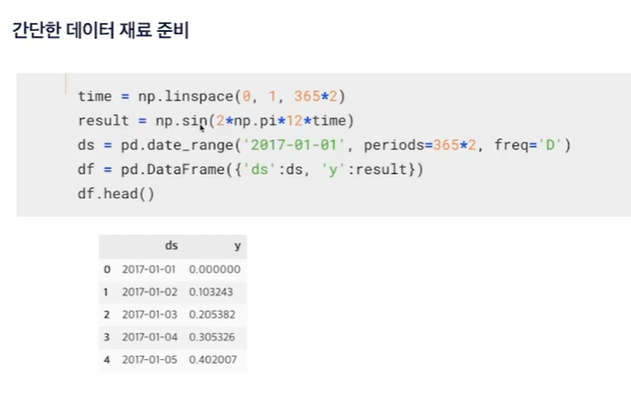
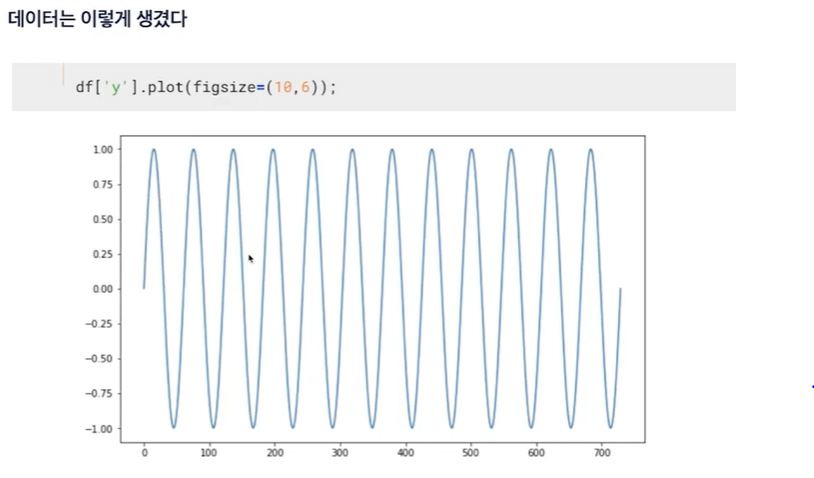
ㄴ2년간의 데이터
- 예측
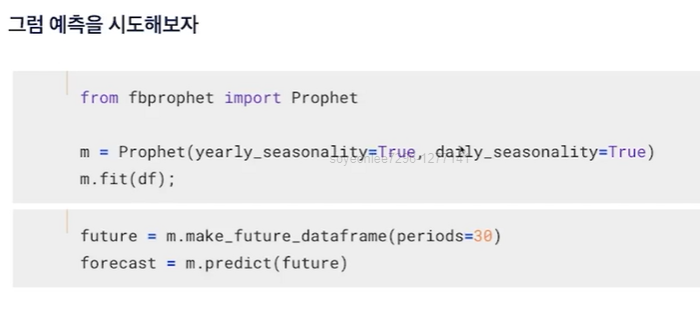
ㄴ연주기성, 일주기성(추적)
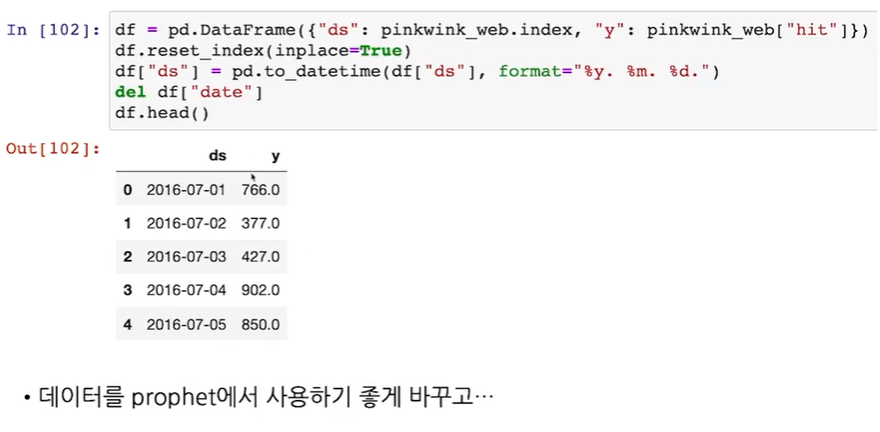
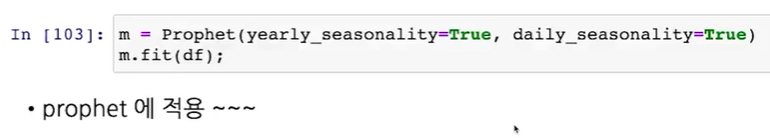
ㄴdf를 m(prophet)에 의해서 fit시키기
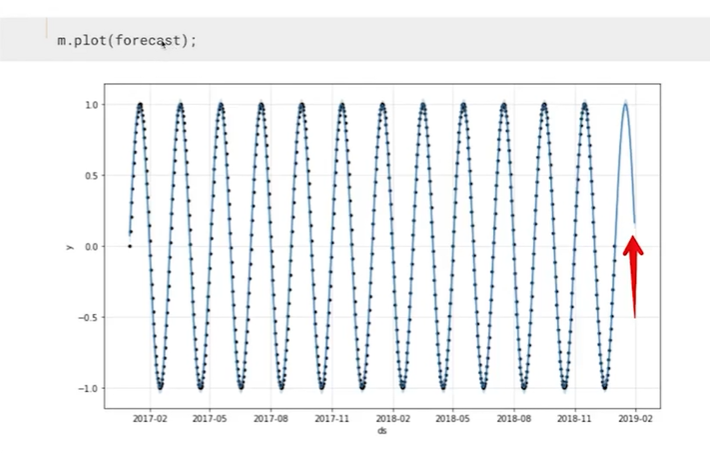
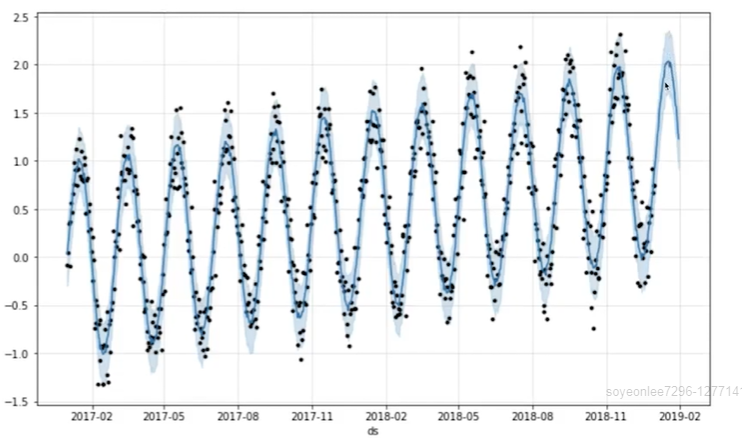
ㄴ점은 실제 데이터, 이후 파란 선이 예측 데이터(prophet한 것)
- 편항성 가진 데이터
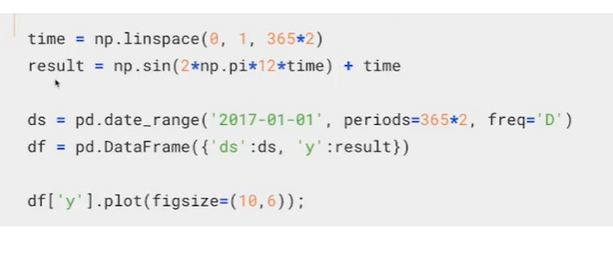
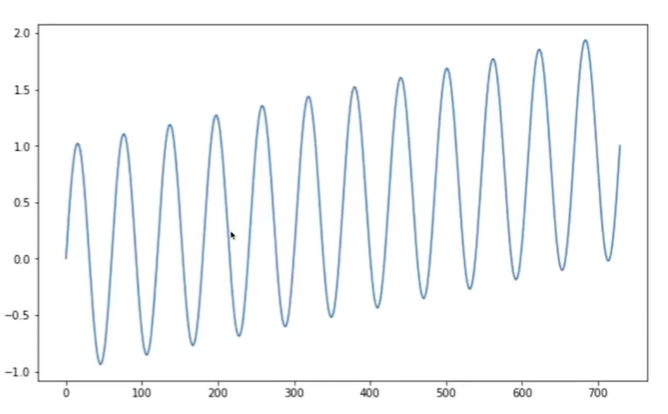
ㄴresult 데이터 값을 단순 sin 아니라 편향성 가지도록 bais 값 넣어줌(time)
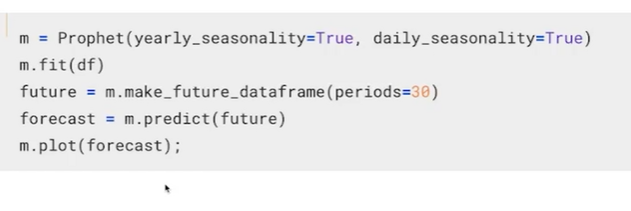
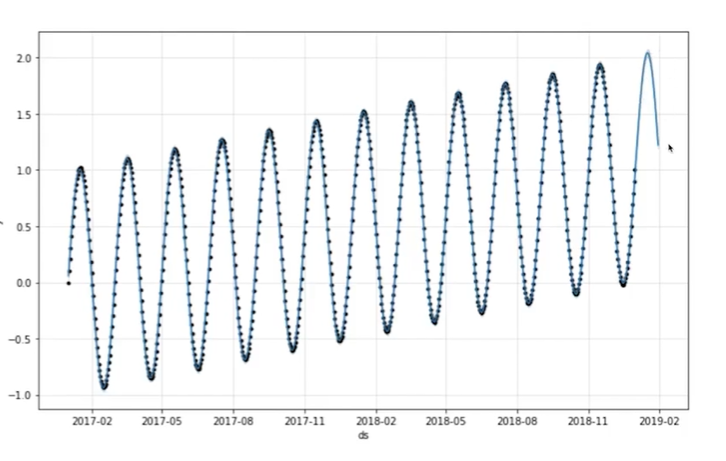
ㄴ30일 간의 데이터 예측
ㄴ더 정확하게는 수치를 뽑아서 에러를 계산하고 에러의 평균값을 제시하는 등 해야 함.
- 노이즈 싣기
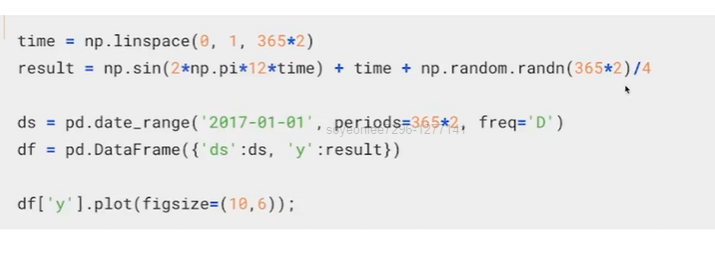
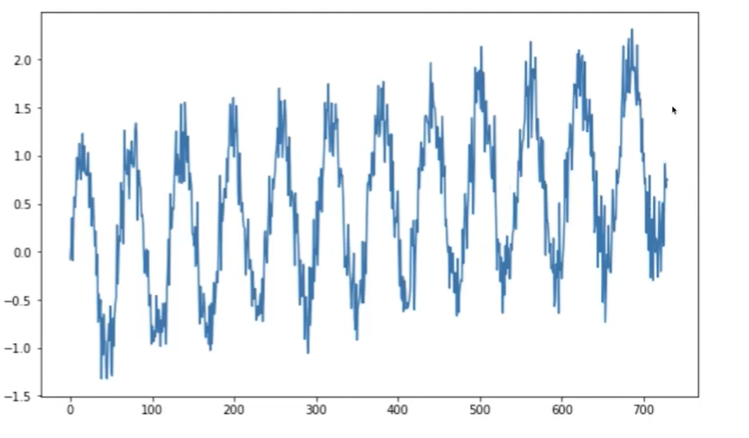
ㄴraw 데이터
- 예측
-시계열 데이터 실전 이용(블로그 데이터 forecast)
- numpy를 이용한 trend 파악
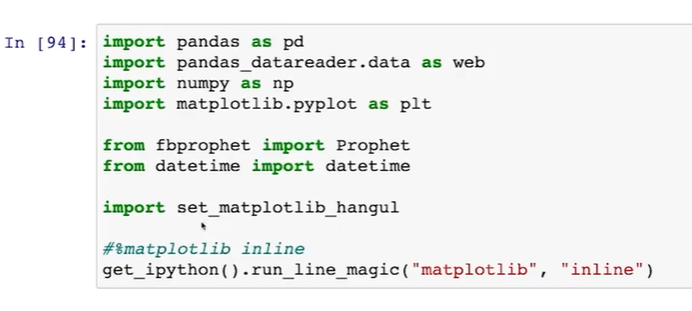
ㄴmatplotlib의 한글 대응을 별도의 .py 파일로 만들어두고 import해서 쓸 수 있다.
-
방문객 수 데이터
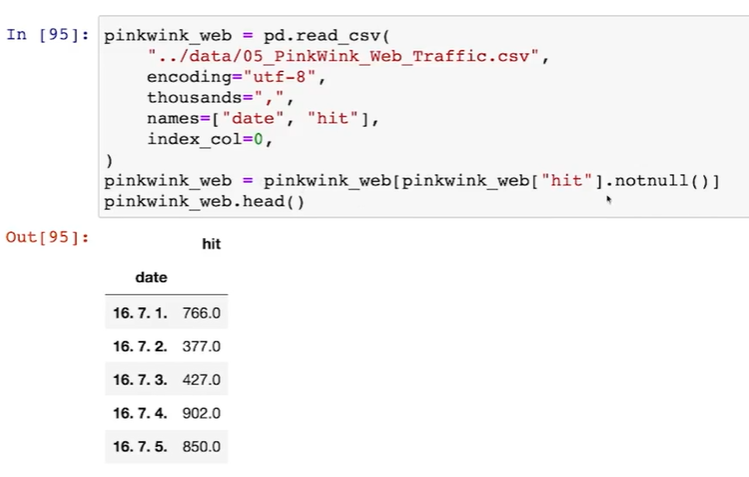
-
자연 현상에 있는 데이터는 주기가 여러 개일 수 있다.
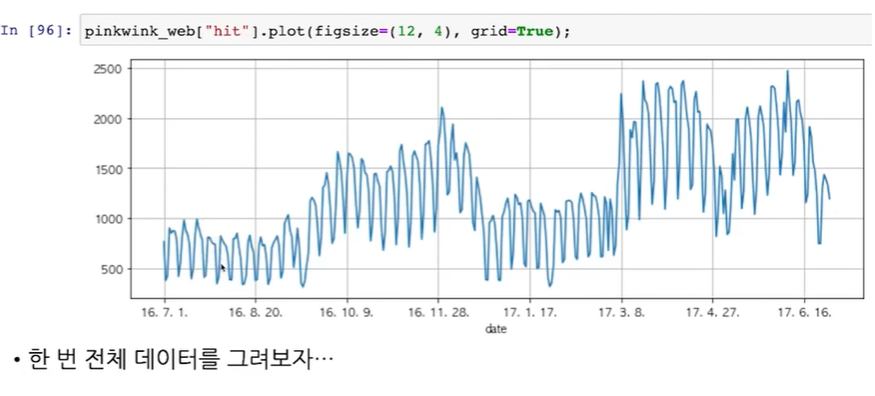
-
trend 분석
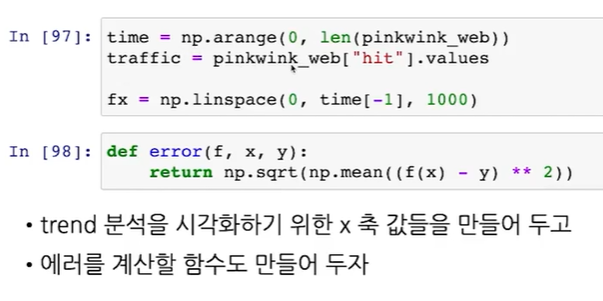
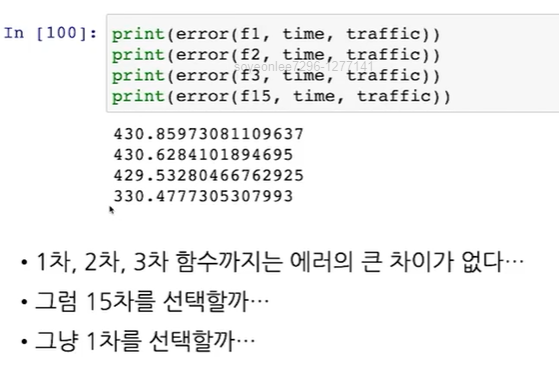
ㄴerror: 만든 trend가 얼마나 원데이터를 잘 반영하는지에 대한 정량적 평가 지표
ㄴf(x)는 예측값, y는 참값. f(x)-y=error
ㄴerror의 제곱의 평균의 루트: rmse
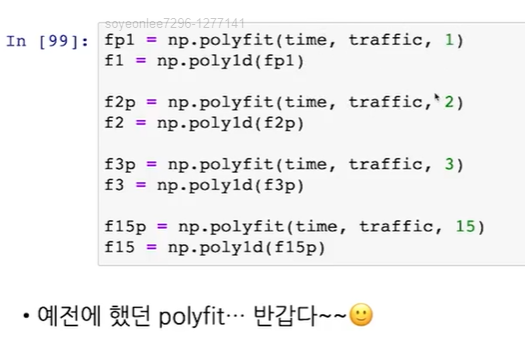
ㄴtime, traffic으로 n차 함수 만들기.
ㄴpolyfit을 통과하고 나면 각 차수별 계수가 나온다.
ㄴ이를 poly1d에 통과시키면 함수가 됨.
- trend
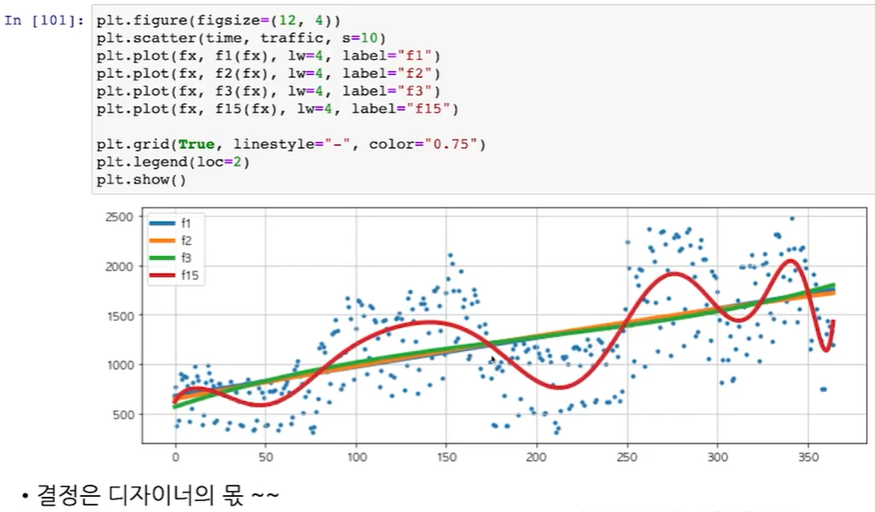
ㄴ몇 차식을 이 데이터의 트렌드로 볼 것이가는 디자이너의 몫
ㄴ1~3은 비슷, 계수가 많은 3차식보단 1차식이 간단
- 예측
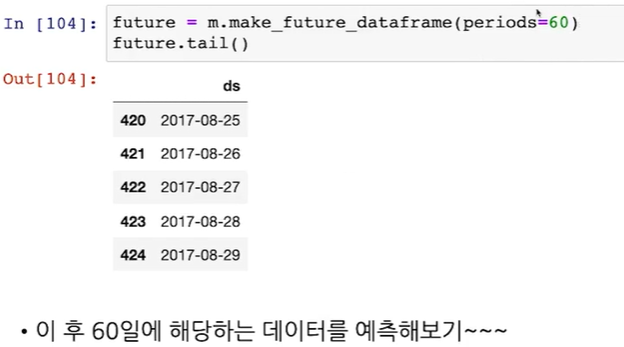
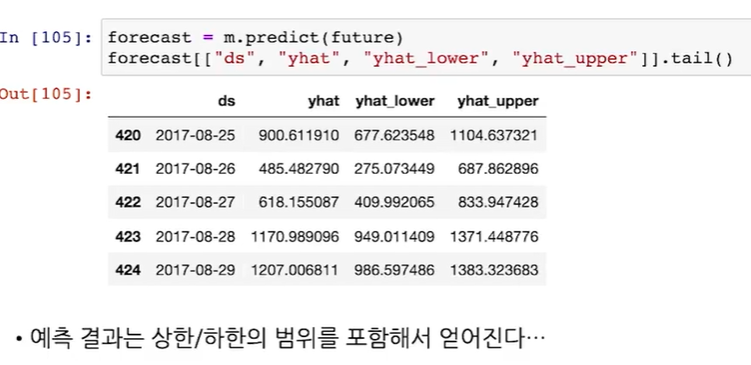
ㄴlower와 upper
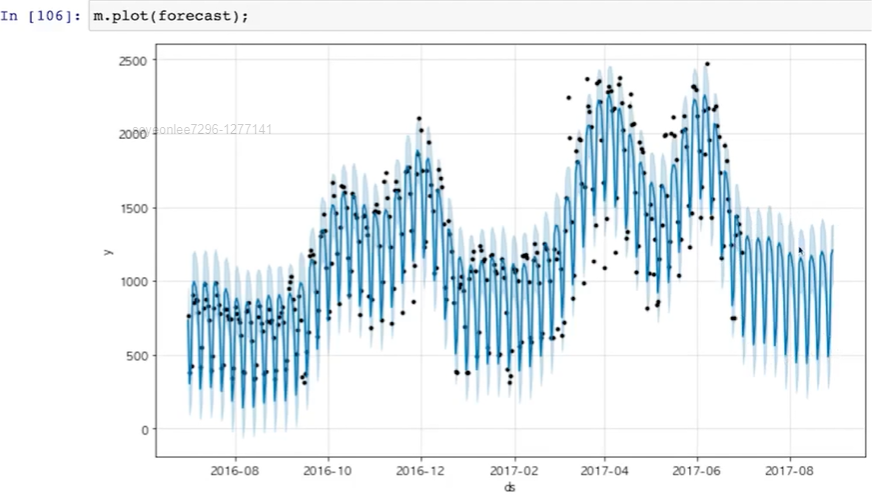
ㄴ주기성이 좋을수록 예측 결과가 정확해진다.
-트렌드 분석: plot_components
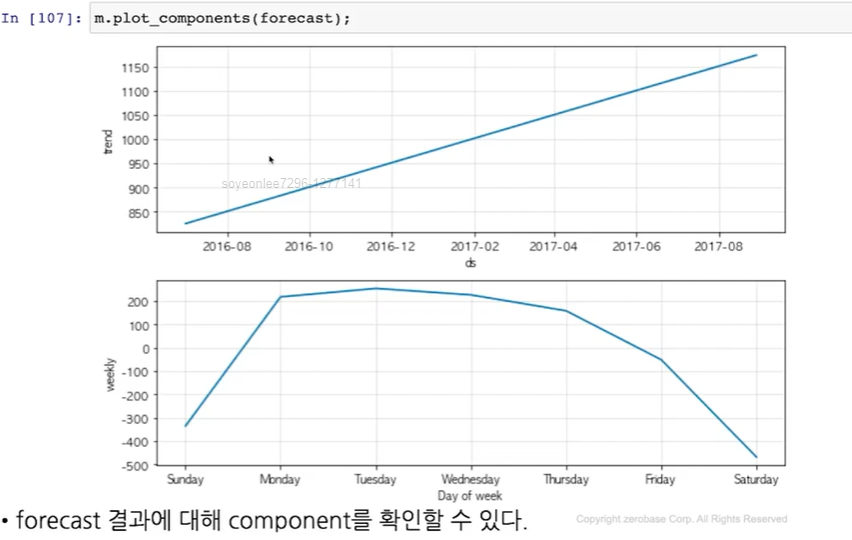
ㄴ트렌드 대비: 트렌드를 빼고 눕혀놓은 것
ㄴ블로그 방문객 유입자 수 데이터
- 트렌드 대비 연간 데이터
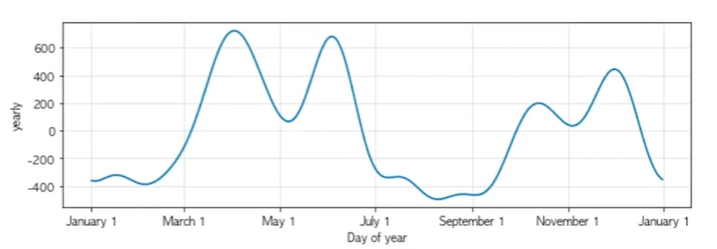
ㄴ이유에 대한 분석이 수월해짐.
이 글은 제로 베이스 데이터 취업 스쿨 강의 자료 일부를 발췌하거나 참고하여 작성되었습니다.
