🔎 4주차 학습 목표 및 개요
이번 주는 회귀분석의 이론을 학습한 뒤 회귀모델을 활용한 실습을 하였습니다. 추가로 릿지와 라쏘 같은 규제 선형모델 및 군집분석을 배워 적용해 보았으며 데이터 플랫폼에 대한 이론을 공부하였습니다.
[회귀 분석과 규제 모델을 직접 실습해보며 예측 모델링의 기본기를 다지고, 군집 분석을 통해 데이터 분류 감각을 키우는 것 , 데이터 플랫폼 개념을 이해해 분석 시스템의 구조를 파악하는 것] 을 목표로 삼았습니다
📚 주요 학습 및 진행 내용 정리
1. 회귀분석
결정계수, 오차 합 계산 방식 등 기본적인 개념과 용어들을 학습하였으며 회귀분석의 종류 및 선형 회귀모델을 위한 데이터 변환 방법들에 대해 배웠습니다.
- 선형회귀: 실제 값과 예측값의 차이를 최소화 하는 직선형 회귀선을 찾는 알고리즘으로 독립변수가 하나인 단순 선형 회귀와 독립변수가 여러 개인 다중 선형 회귀가 있다.
- 다항 회귀: 독립 변수와 종속 변수 간의 곡선(비선형) 관계를 모델링하는 회귀 방법 (각각의 독립 변수들에 한해서 적용된 계수들이 선형방식을 따르기에 선형 회귀의 일종임)
- 랜덤 포레스트 회귀: 여러 개의 결정 트리를 학습시키고 그 평균값을 예측값으로 사용하는 회귀 모델
- XGBoost 회귀: 각 트리가 이전 트리의 오차를 보완하면서 학습하는 방식의 모델
2. 규제 선형 모델
규제에 대한 이해를 바탕으로 라쏘, 릿지, 엘라스틱넷을 사용해보고 비교해 보았습니다.
- Lasso: 전체 입력변수 계수 중 일부를 0으로 만들어 입력 변수를 선택하는 방법으로 일부 특성 만으로 분석하는 것이 유리할 경우 채택한다
- Lidge: 기존 선형 회귀모델에서 전체 계수의 크기를 최대한 작게 만들어 분산을 줄이는 방법이다
- Elasticnet: 라쏘의 규제와 릿지의 규제를 모두 적용하는 방법
3. 군집분석
비지도 학습을 통한 데이터 분류 방법으로 K-means와 같은 대표 알고리즘을 학습하고 고차원 데이터를 저차원으로 줄이는 PCA에 대해 배웠습니다
- K-means: 집단의 중심을 기준으로 거리가 가장 가까운 집단으로 데이터를 분류하는 알고리즘
- PCA: 고차원 데이터를 저차원으로 줄이면서도 정보 손실을 최소화하는 차원 축소 기법으로 서로 비슷한 유형의 변수를 묶어 축소된 변수만 남기는 방법
→ 더 단순하고 빠른 모델을 위함 - DBSCAN: 데이터의 밀도를 기반으로 군집을 형성하고 밀도에서 멀리 떨어진 데이터는 이상치로 처리하는 알고리즘
4. 데이터 관리 기술
클라우드 기반 데이터의 처리, 저장 그리고 관리 기술의 학습을 진행하였습니다.
- 분산시스템: 전통적인 서버 구조와 비교해서 분산 시스템에 대하여 스터디를 진행하였으며 특징과 분산데이터 저장소의 구조에 대해 학습을 하였습니다.
- 데이터 플랫폼: 데이터 플랫폼의 개념에 대해 빅데이터 플랫폼의 구축과정과 함께 배웠으며 데이터 웨어하우스와 데이터 레이크 특징 그리고 플랫폼 아키텍쳐를 중점으로 수업을 진행하였습니다.
- 크롤링의 이해: 헷갈릴 수 있는 개념인 크롤링과 스크래핑을 비교하며 차이를 인지하고 학습하였으며 스크래핑 실습을 통해 데이터를 어떻게 웹에서 추출하는지 경험을 하였습니다.
🎮 실습/과제 수행 및 문제 해결 과정
이번 주에 실습하면서 겪었던 어려움이나 궁금증의 해결 과정을 기록하였습니다
다음은 회귀모델을 이용한 중고차 가격 예측 실습을 수행하면서 겪었던 문제점 입니다
아랍에미리트의 중고차 데이터를 가져와서 회귀모델을 통해 차의 조건에 따른 가격을 예측하는 실습을 진행하였습니다.
처음에 데이터를 받아 결측치를 확인하였을 때 결측치가 상당히 많다는 것을 확인하였고
특히 실린더의 갯수나 모터트림 같이 단순히 평균이나 최빈값으로 채워넣는 것이 아닌 자동차의 모델이나 마력에 따라 결정이 되는 변수들이 결측치로 되어 있는 것을 보고 난감했었습니다.
pd.isnull(df).sum()

title                     5
...
no_of_cylinders          81
horsepower                0
...
year                    970
color                     0
emirate                   0
motors_trim              28
company                   0
model                     0
따라서 먼저 마력과 실린더의 피어슨 상관계수를 먼저 체크하여 실제로 이 데이터에서 실린더와 마력이 확실한 관계가 있다는 것을 확인하였고 마력 구간에 따라 실린더의 널 값을 채워 넣기로 결정을 하였습니다.
corr_df = df[['horsepower_clean', 'no_of_cylinders_clean']].dropna()
corr_value = corr_df.corr().iloc[0, 1]
print(f"horsepower와 no_of_cylinders 간의 피어슨 상관계수: {corr_value:.3f}")

horsepower와 no_of_cylinders 간의 피어슨 상관계수: 0.745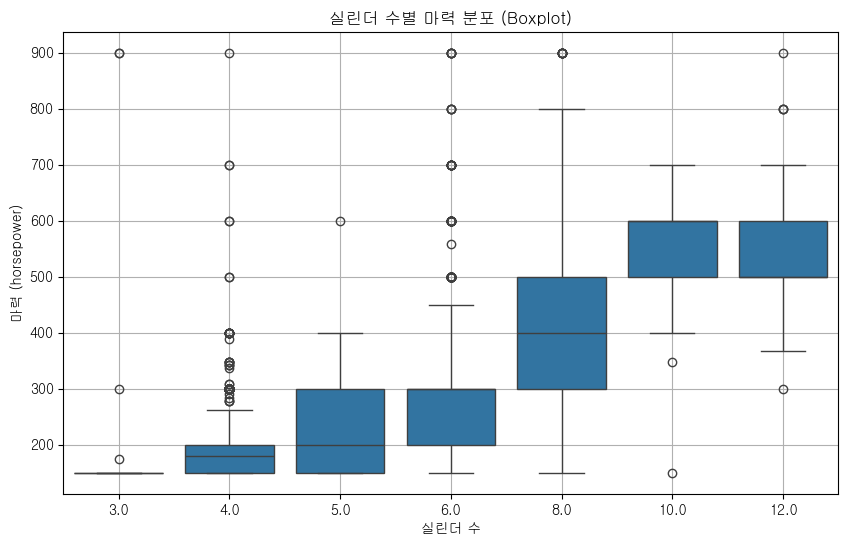
df['no_of_cylinders_clean'].value_counts().sort_index()

no_of_cylinders_clean
3.0       56
4.0     2993
5.0       53
6.0     3325
8.0     2986
10.0      53
12.0     366
이 과정에서 3,5,10 기통의 차량 분포가 매우 희소하다는 것을 발견 하였고 범위도 각각 4기통, 12 기통과 겹친다고 생각을 하여 3,4,5 기통을 4기통 그룹으로 묶어주고 10기통을 12기통에 통합을 시켜주는 데이터 처리를 하였습니다.
추가로 자동차 연식의 널값이 전체 데이터의 10퍼센트 정도였는데 평균이나 최반값으로 채워 넣으면 데이터의 왜곡이 발생할 수 있겠다는 판단이 들어 각 브랜드 + 모델별 최빈값으로 채워넣었습니다.
이러한 데이터 전처리 및 피쳐 엔지니어링 과정을 몇가지 더 거쳐서 모델을 학습시키고 교차검증을 통해 성능을 평가하였습니다.
🔍 사용한 모델
RandomForestRegressorXGBoostRegressor
📊 성능
| 모델 | RMSE | R² |
|---|---|---|
| Random Forest | 0.3338 | 0.9154 |
| XGBoost | 0.3030 | 0.9303 |
📊 5-Fold 교차검증 결과 비교 (R² 기준)
| Fold | Random Forest | XGBoost |
|---|---|---|
| 1 | 0.9062 | 0.9219 |
| 2 | 0.9041 | 0.9243 |
| 3 | 0.9121 | 0.9283 |
| 4 | 0.9062 | 0.9209 |
| 5 | 0.9208 | 0.9340 |
| 평균 | 0.9099 | 0.9259 |
회귀모델을 이용한 중고차 가격 예측 실습을 수행하면서 느낀점
처음에 데이터를 확인하였을 때 결측치를 다른 독립변수들과의 관계를 생각하지 않고 무작정 채워 넣었다가 모델의 성능이 좋지 않게 나와서 다시 생각을 깊게 해보는 계기가 되었던 것 같습니다.
특히 도메인 지식이 EDA를 진행하는 과정에 있어서 상당히 중요하다는 것을 몸소 체험하였으며 전처리와 피쳐 엔지니링에 따라 모델의 속도와 결정계수가 크게 영향을 받는다는 것을 경험하며 값지니 인사이트를 얻을 수 있었습니다.
🔮 4주차 주간 회고
💎 Liked (좋았던 점)
- 모델링: 자전거 대여량 예측, 중고차 가격 예측 등을 반복 실습하면서 모델링의 흐름이 눈에 들어오기 시작함
- 날짜 컬럼, 로그 변환 효과 체감: 날짜 컬럼 활용 및 로그 변환을 통해 모델 성능이 확연히 좋아지는 경험을 하며 데이터 변환의 힘을 체감함
- 개념 정리 기회: 분산 시스템, 데이터 플랫폼, 데이터 웨어하우스 vs 레이크, 크롤링 등 평소 모호했던 개념들을 실습과 이론을 통해 명확히 다질 수 있었음.
- 교차검증에서도 성능 유지: 과적합 의심에도 불구하고 교차검증 결과가 안정적으로 나와 만족스러웠
🌱 Learned (배운 점)
- 회귀모델 전체 흐름: 단순/다항 회귀 → 성능평가(R², RMSE) → 규제모델 (Ridge/Lasso) → 교차검증으로 이어지는 실무적인 분석 흐름 습득
- 데이터 전처리의 중요성: 이상치, 상관계수 낮은 변수 제거, 날짜 컬럼 활용, 파생변수 생성이 모델 성능에 직접적인 영향을 미침을 체험
- 분산 시스템 및 플랫폼 개념: 데이터 웨어하우스와 데이터 레이크, 고속·저속 스토리지, 오버레이의 차이 이해
- 웹 데이터 수집 기초: 웹 스크래핑의 개념과 방식, BeautifulSoup 실습을 통해 기초적인 웹 데이터 수집 흐름 학습
💡 Lacked (부족했던 점)
- 데이터 전처리 감 부족: 중고차 예측 과제에서 결측치 처리와 피처 엔지니어링이 어려웠고 파생변수 생성에도 시간이 소요됨
- 과적합 우려에 대한 불안: 높은 결정계수에도 과적합이 아닐까 고민되었지만 명확한 판단 기준 부족
- 이론 개념 혼동: 하이퍼파라미터, 정밀도 vs 재현률 같은 핵심 지표들에 대한 개념이 헷갈렸음
- 스크래핑 도구 활용 미숙: 처음 보는 함수들로 인해 실습 중 일부 흐름을 놓침
📌 Longed for (바라는 점 / 다음 목표)
- 모델 성능 향상을 위한 실험 반복: 캐글 상위권 코드와 비교하면서 자전거/중고차 예측 모델 전처리 전략 다듬기
- 날짜 및 파생변수 적극 활용: 시간 정보에서 요일, 계절, 시간대 등의 파생변수를 활용해 모델 성능 향상 시도
- 스크래핑 정복: 관심 있는 웹사이트 대상 직접 스크래핑 실습 진행 → 사용자 정의 크롤링으로 확장
- 데이터 플랫폼 구조 시각화: 오버레이, 고/저속 스토리지 등 주요 개념들을 직접 도식화하며 개념 정리
📆 이번 주말 학습 계획
이번 주말에는 정보처리기사의 필기 시험을 대비하여 4과목 이론 스터디와 4과목 기출문제 3개년을 풀 계획이며, 회귀모델을 기반으로 EDA 과정을 보다 세밀하게 하여 자전거 대여량 예측 모델을 개선할 예정입니다.