평판 소스를 두 개째 붙이는 날 문제가 생깁니다. 한쪽은 abuseConfidenceScore: 34라고 하고, 다른 쪽은 fraud_score: 48이라고 합니다. 세 번째는 엔진 20개 중 1개가 악성이라고 하고, 네 번째는 Moderate라고 합니다. 로그인 코드에 if 문이 네 줄 늘어나고, 다섯 번째 소스가 3초 동안 응답하지 않자 로그인이 같이 멈춥니다. 이번 글은 이 일을 한곳에 모으는 작은 서비스를 만들고 재 봅니다.
왜 한곳에 모으나
평판 조회를 화면 코드마다 직접 부르면 세 가지가 흩어집니다.
- 척도. 소스마다 숫자의 뜻이 다릅니다. 화면마다 따로 해석하면 가입과 결제가 같은 IP를 다르게 봅니다.
- 장애 처리. 시간 제한·재시도·캐시가 화면마다 다르게 붙거나, 아예 안 붙습니다.
- 기록. "왜 막혔나"를 남기는 형식이 제각각이라 고객 문의에 답하기 어렵습니다.
그래서 평판 조회는 서비스 하나(이 글에서는 rep-hub)로 모으고, 화면은 그 결과만 받게 합니다. 화면은 등급과 이유를 보고 행동만 정합니다. 행동은 다음 편의 주제입니다.
rep-hub의 구조
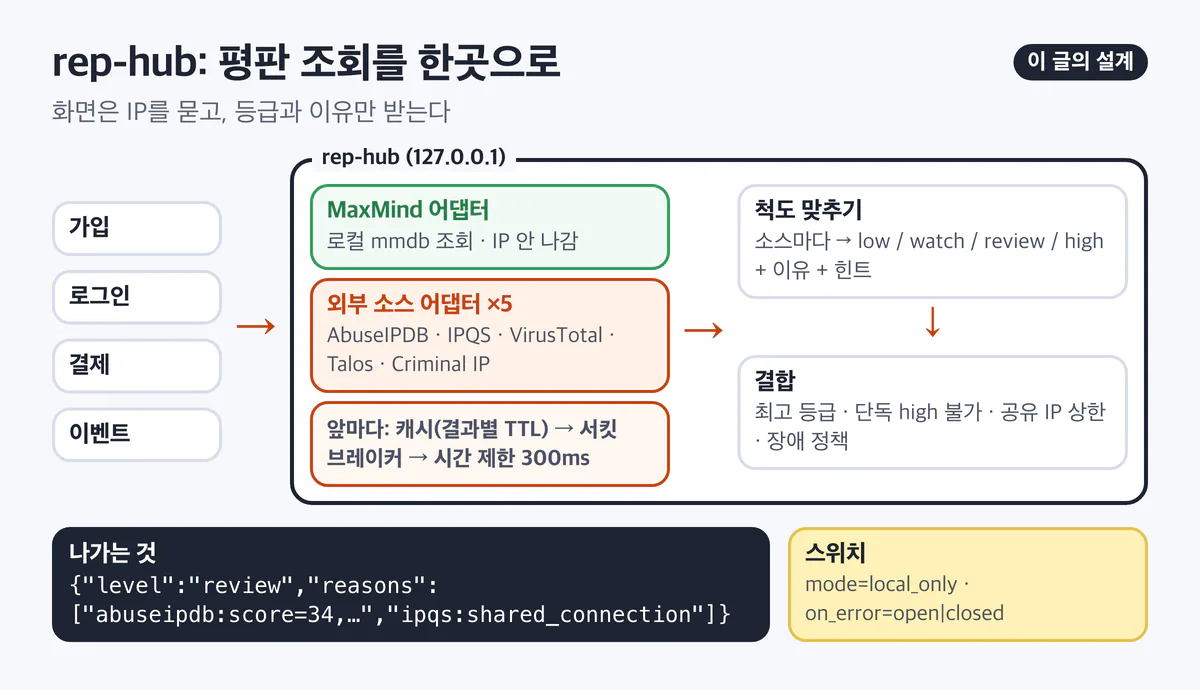
이 그림은 이 글의 설계입니다. 어느 회사의 구조를 추정한 그림이 아닙니다. 왼쪽에서 오른쪽으로 IP가 들어가 등급이 나옵니다. 그린 상자(로컬 DB)는 사용자 IP가 밖으로 나가지 않는 길이고, 주황 상자(외부 소스)는 나가는 길입니다. 외부 소스 앞에는 모두 캐시·시간 제한·브레이커가 섭니다.
실습 코드는 lab/rep-hub/에 있습니다. 소스는 이렇게 만들었습니다.
| 소스 | 실습에서 | 정직하게 말하면 |
|---|---|---|
| MaxMind | lab/maxmind/data의 mmdb 파일을 실제로 조회 | MaxMind가 공개한 테스트용 DB입니다. 실제 판정이 아닙니다 |
| AbuseIPDB · IPQS · VirusTotal · Talos · Criminal IP | 녹화 응답 재생 어댑터 | 각 솔루션 편에서 공식 문서 예시를 옮기거나 문서의 필드대로 만든 JSON(lab/vendor-samples)을 돌려줍니다. 응답에 어느 파일인지 붙습니다 |
| (같은 다섯) | 진짜 키를 꽂을 자리(LiveAdapter) | 이 실험실에서는 한 번도 켜지 않았습니다. 켜려면 환경 변수 세 개가 모두 있어야 합니다 |
녹화 어댑터에는 소스마다 20~40ms 안팎의 가짜 지연을 넣었습니다. 진짜 API의 지연이 아닙니다. 장애도 이 지연 주입 자리에 넣습니다. 그래야 나중에 진짜 어댑터로 바꿔도 같은 시험을 걸 수 있습니다.
cd lab
rep-hub/run.sh start 18650
curl -s '127.0.0.1:18650/v1/check?ip=203.0.113.7'
실제 출력(2026-10-31, macOS, 줄 일부만. ms는 매번 다름):
{
 "ip": "203.0.113.7",
 "level": "review",
 "reasons": [
  "maxmind:not_in_db",
  "abuseipdb:score=34,reports=6,reporters=3",
  "abuseipdb:usage=Mobile ISP",
  "ipqs:fraud_score=48",
  "ipqs:recent_abuse",
  "ipqs:connection=Mobile",
  "ipqs:shared_connection",
  "combine:shared_ip_possible"
 ],
 "answered": 5,
 "failed": [],
 "ms": 38.18
}203.0.113.7은 이 실험실에서 통신사 CGNAT 공인 IP 역할입니다. 뒤에 공격자 한 명이 섞여 AbuseIPDB 신고가 6건 쌓였고, IPQS는 공유 회선이라고 합니다. 결과는 점수가 아니라 등급 하나와 근거 묶음입니다. 고객센터는 이 이유 목록을 그대로 읽어 줄 수 있습니다.
척도 맞추기: 숫자 여섯 종류를 등급 넷으로
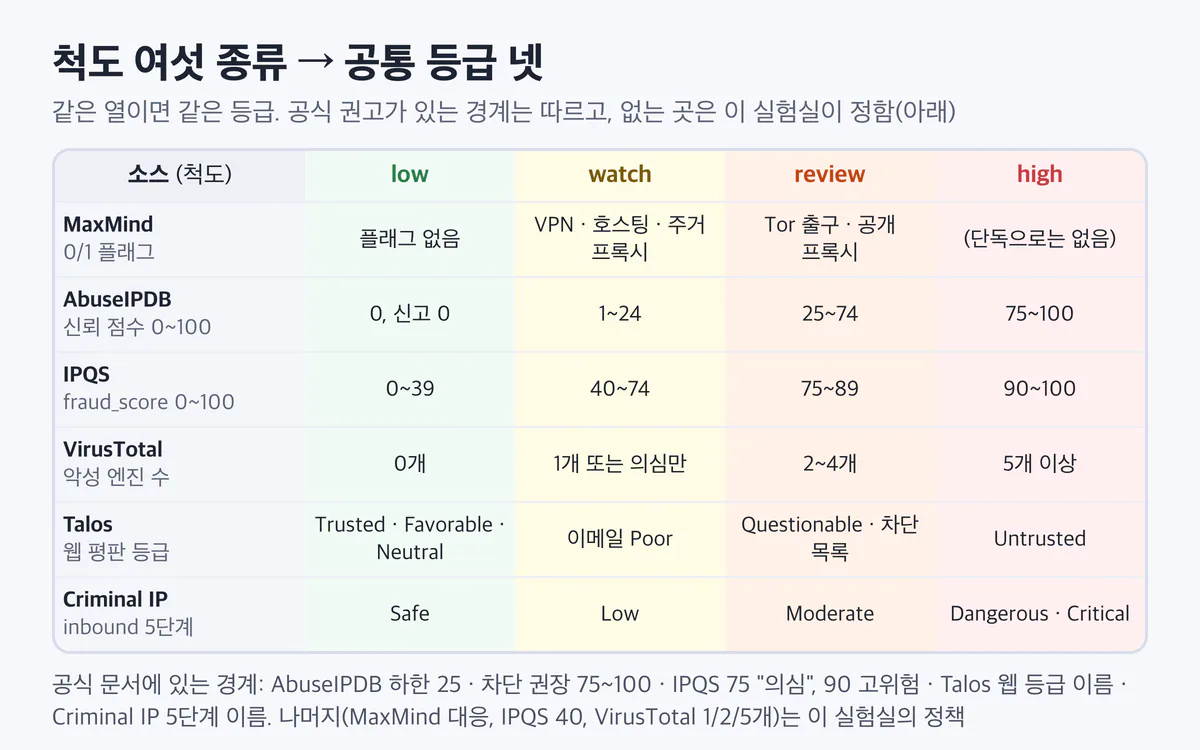
한 줄이 소스 하나입니다. 가로로 같은 칸에 있으면 같은 공통 등급입니다. 칸의 경계값은 이 실험실이 정한 정책이고, 공식 문서에서 온 경계는 그림 아래에 따로 적었습니다.
공통 등급은 네 칸입니다.
low특별한 근거 없음watch기록만 남길 근거(VPN 플래그, 엔진 1개)review사람이나 추가 인증으로 확인할 근거high여러 근거가 겹친 강한 신호
경계를 정할 때 지킨 원칙이 있습니다.
- 성격은 나쁨이 아닙니다. MaxMind의
is_hosting_provider·is_anonymous_vpn은 "사람 집이 아닐 가능성"입니다. 그래서 단독으로는watch까지만 올립니다. Tor 출구와 공개 프록시만review입니다. - 공식 경계가 있으면 따릅니다. IPQS 응답 필드 문서는 75 이상을 "의심이지만 꼭 사기는 아님", 90 이상을 고위험으로 보라고 적습니다(06편). 그래서 75를
review, 90을high시작으로 잡았습니다. AbuseIPDB 차단 목록은 점수 하한 25를 강제하고 "75~100%가 차단에 권하는 범위"라고 적습니다(05편). 그래서 25를review, 75를high시작으로 잡았습니다. 40·1 같은 나머지 경계는 이 실험실이 정한 값입니다. - 엔진 수는 다수결이 아닙니다. VirusTotal에서 엔진 1개가 악성이면
watch, 2개 이상이면review, 5개 이상이면high로 잡았습니다. 엔진마다 보는 것이 다르고, 같은 목록을 여러 엔진이 쓸 수도 있습니다(07편). - 방향이 있으면 들어오는 쪽을 씁니다. Criminal IP는 inbound·outbound를 나눠 줍니다. 내 서비스로 들어오는 요청을 판단하므로 inbound를 등급에 쓰고 outbound는 이유에만 남깁니다(09편).
- Talos는 웹 평판을 씁니다. 이메일 평판은 메일 서버 IP 기준이라 로그인 판단과 성격이 다릅니다. 이메일
Poor는watch근거로만 씁니다(08편).
코드는 소스마다 함수 하나입니다. AbuseIPDB 부분입니다.
# lab/rep-hub/rephub/normalize.py (발췌)
def abuseipdb(resp):
    d = resp.get("data", resp)
    score = d.get("abuseConfidenceScore")
    reports = d.get("totalReports", 0)
    if score >= 75:   lv = "high"
    elif score >= 25: lv = "review"
    elif score > 0 or reports > 0: lv = "watch"
    else:             lv = "low"
    ...
    if "Mobile" in usage:
        hints.append("shared_ip_possible")   # 등급이 아니라 결합 단계가 쓰는 힌트
돌려주는 것은 세 가지입니다. 등급, 이유 문자열, 그리고 힌트입니다. 힌트는 "모바일 회선이라 여럿이 쓸 수 있음"처럼 등급은 아니지만 결합 때 써야 하는 성격 정보입니다.
결합: 가장 높은 것에서 출발하되, 혼자서는 high가 못 된다
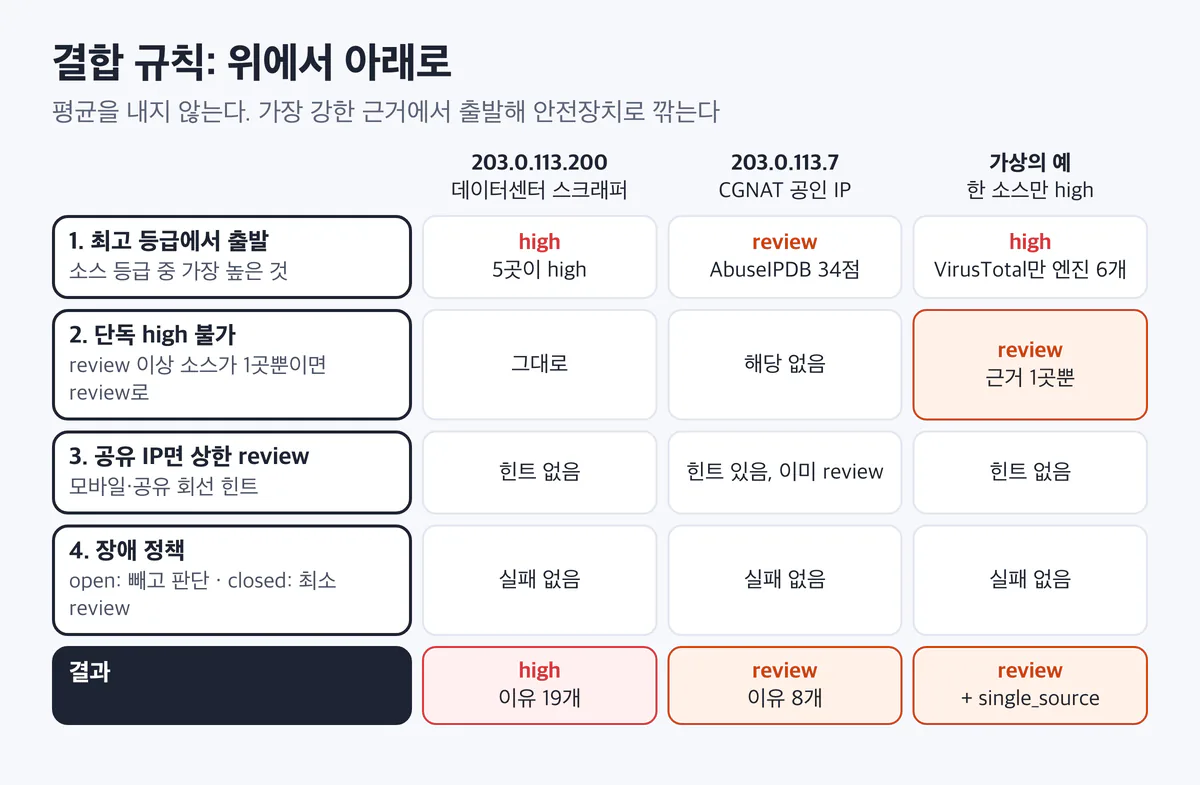
위에서 아래로 규칙 네 개를 차례로 지납니다. 오른쪽 예시 세 개가 각 단계에서 어떻게 바뀌는지 따라가 보세요.
- 가장 높은 소스 등급에서 출발합니다. 평균을 내지 않습니다. 소스 하나가 본 사실이 다른 소스의 "모름"에 묻히면 안 되기 때문입니다.
high는 근거가 둘 이상일 때만.review이상인 소스가 하나뿐이면review로 내립니다. 한 회사의 오탐 하나가 바로 강한 대응으로 이어지지 않게 합니다.- 공유 IP 힌트가 있으면
review까지. 모바일·공유 회선 힌트가 있으면 아무리 근거가 많아도high로 두지 않습니다. 그 뒤에 정상 사용자가 여럿 있을 수 있습니다(12편 ②). - 실패한 소스는 장애 정책대로. 아래 절에서 잽니다.
데이터센터 스크래퍼 역할의 203.0.113.200은 다섯 소스가 모두 high라 high로 남고, 이유가 19개 붙습니다(lab/results/13-rephub-check.txt). 사생활 보호용 VPN 사용자 역할의 1.2.0.1은 IPQS·Criminal IP가 review라 review입니다. 이 사람이 정상 사용자라는 점은 다음 편에서 중요해집니다.
사용자 IP를 밖으로 보내지 않는 모드
12편 ④에서 사용자 IP가 외부로 나가는 것이 개인정보 문제가 될 수 있다고 했습니다. rep-hub는 요청마다, 또는 서비스 전체를 로컬 소스만 쓰게 바꿀 수 있습니다.
curl -s '127.0.0.1:18650/v1/check?ip=1.2.0.1&mode=local_only'
# 서비스 전체: REPHUB_LOCAL_ONLY=1 (rep-hub/run.sh start 18650 local_only)
실제 출력(2026-10-31, macOS):
{"ip": "1.2.0.1", "level": "watch", "reasons": ["maxmind:anonymous_vpn"], "mode": "local_only", "ms": 0.89}
sources: {"maxmind": {"status": "ok", "level": "watch", "cached": false, "ms": 0.07}}
{"ip": "71.160.223.1", "level": "watch", "reasons": ["maxmind:hosting_provider"], "mode": "local_only", "ms": 1.61}
{"ip": "203.0.113.7", "level": "unknown", "reasons": ["maxmind:not_in_db"], "mode": "local_only", "ms": 0.33}
외부 소스를 아예 부르지 않으니 서버 안 처리 시간은 1ms 안팎입니다. 대신 로컬 DB가 모르는 IP는 unknown입니다. 이 실험실의 로컬 DB는 테스트용이라 문서용 IP를 거의 모릅니다. 실제 GeoIP2·GeoLite 파일을 쓰면 아는 범위가 훨씬 넓겠지만, 그 범위는 이 글에서 재지 않았습니다.
캐시와 TTL: 결과마다 다르게
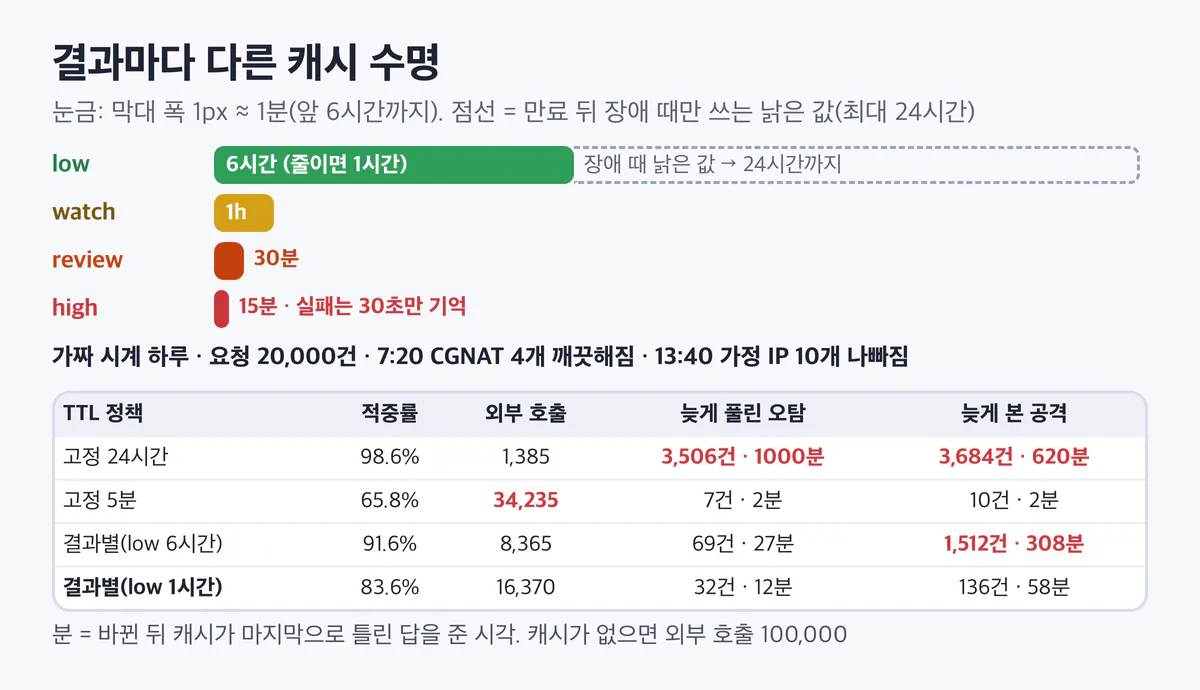
위쪽 막대는 결과 등급별 캐시 수명입니다. 막대 끝의 점선 부분은 만료 뒤에도 장애 때만 꺼내 쓰는 낡은 값(stale-if-error)입니다. 아래 표는 가짜 시계로 하루를 돌려 잰 값입니다.
TTL을 결과마다 다르게 두는 이유는 두 방향의 실수가 다르기 때문입니다.
- 나쁨을 오래 두면 오탐이 오래 갑니다. CGNAT IP 뒤의 공격자가 떠나도 캐시가 "나쁨"을 계속 줍니다.
- 좋음을 오래 두면 새 공격을 늦게 봅니다. 어제까지 깨끗하던 IP가 오늘 공격에 쓰여도 캐시가 "깨끗"을 줍니다.
가짜 시계로 하루를 돌려 비교했습니다. 같은 요청 20,000건에, 7시 20분에 CGNAT IP 4개가 깨끗해지고 13시 40분에 가정 IP 10개가 나빠지게 했습니다.
.venv/bin/python rep-hub/ttl_sim.py실제 출력(2026-10-31, macOS):
고정 24시간        적중률  98.6%  외부 호출   1385  늦게 풀린 오탐 3506건(바뀐 뒤 마지막 1000분)  늦게 본 공격 3684건(바뀐 뒤 마지막 620분)
고정 5분          적중률  65.8%  외부 호출  34235  늦게 풀린 오탐    7건(바뀐 뒤 마지막 2분)  늦게 본 공격   10건(바뀐 뒤 마지막 2분)
결과별(기본값)       적중률  91.6%  외부 호출   8365  늦게 풀린 오탐   69건(바뀐 뒤 마지막 27분)  늦게 본 공격 1512건(바뀐 뒤 마지막 308분)
결과별, 좋음도 짧게    적중률  83.6%  외부 호출  16370  늦게 풀린 오탐   32건(바뀐 뒤 마지막 12분)  늦게 본 공격  136건(바뀐 뒤 마지막 58분)
읽는 법입니다. "외부 호출"은 녹화 소스 다섯 곳에 실제로 간 호출 수입니다. 캐시가 없으면 100,000번입니다. "늦게 풀린 오탐"은 진실은 깨끗한데 캐시가 review 이상을 준 요청, "늦게 본 공격"은 반대입니다.
- 고정 24시간은 호출을 1,385번으로 줄였지만, 바뀐 사실을 10~16시간 동안 몰랐습니다.
- 고정 5분은 거의 바로 알았지만 호출이 34,235번입니다. 무료 한도로는 감당하기 어렵습니다(12편 ⑤).
- 처음 정한 결과별 기본값(좋음 6시간)은 나쁨을 27분 만에 풀었지만, 새 공격을 5시간 넘게 늦게 봤습니다. 좋음 TTL이 길었기 때문입니다.
- 좋음을 1시간으로 줄이니 늦게 본 공격이 1,512건에서 136건으로 줄고, 호출은 약 2배가 됐습니다.
정답 TTL은 없습니다. 한도(호출 수)와 늦게 아는 시간을 맞바꾸는 손잡이입니다. 이 숫자는 가짜 시나리오에서 나온 것이니, 내 트래픽의 IP 반복 정도로 다시 재야 합니다.
캐시 하나를 더 쓰는 곳이 있습니다. 장애 때 낡은 값입니다. 소스가 실패하면 만료된 값이라도 24시간 안이면 꺼내 쓰고, 이유에 ipqs:stale(1234s)처럼 나이를 남깁니다. 실패 자체도 30초 동안 기억해서 죽은 소스를 계속 두드리지 않습니다.
시간 제한과 서킷 브레이커
외부 소스 하나가 응답하지 않으면 무슨 일이 생기는지 쟀습니다. 요청 3,000건(서로 다른 IP 217개, 동시 20개)을 시나리오마다 같은 순서로 보냈습니다. IPQS를 응답하지 않게(hang) 만들었고, 소스별 시간 제한은 300ms입니다.
.venv/bin/python rep-hub/bench.py --port 18650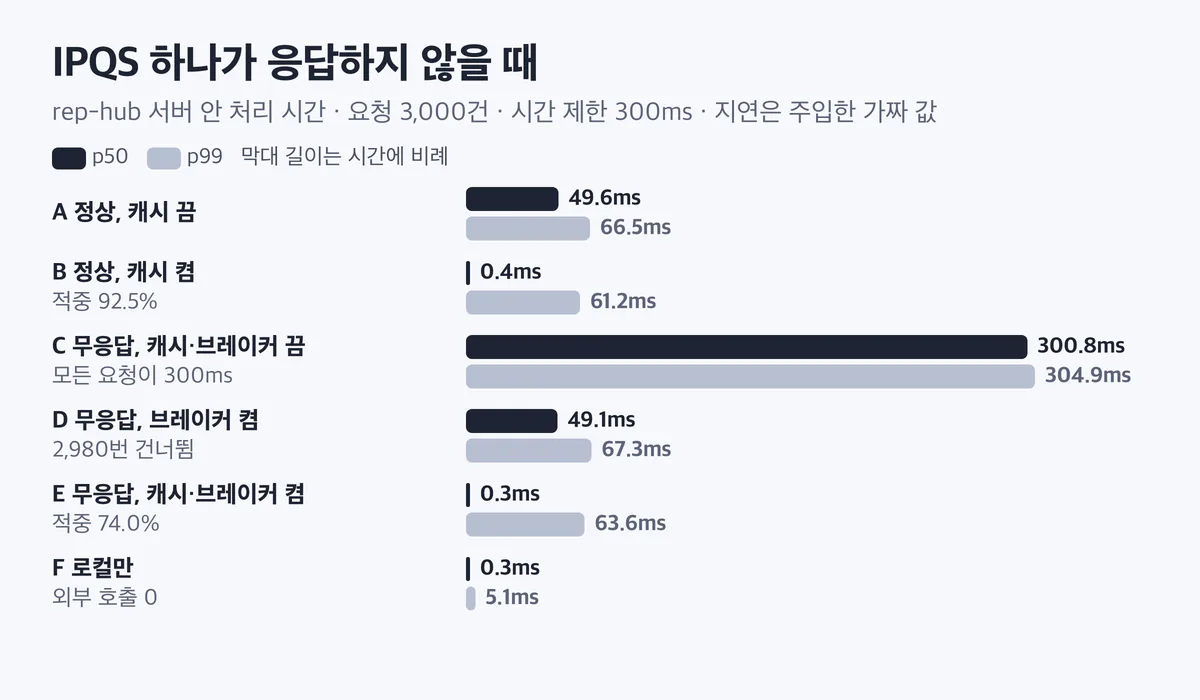
막대는 rep-hub 서버 안에서 잰 처리 시간입니다. 진한 막대가 p50(중간값), 연한 막대가 p99(100건 중 가장 느린 1건 수준)입니다. 가짜 지연을 넣은 값이라 절대값보다 시나리오 사이의 차이를 보세요.
실제 출력(2026-10-31, macOS, 서버 쪽 값만 옮김):
| 시나리오 | 서버 p50 | 서버 p99 | 캐시 적중 | 외부 호출 |
|---|---|---|---|---|
| A 정상, 캐시 끔 | 49.6ms | 66.5ms | - | 15,000 |
| B 정상, 캐시 켬 | 0.4ms | 61.2ms | 92.5% | 1,132 |
| C IPQS 무응답, 캐시·브레이커 끔 | 300.8ms | 304.9ms | - | 15,000 |
| D IPQS 무응답, 브레이커 켬 | 49.1ms | 67.3ms | - | 12,020 |
| E IPQS 무응답, 캐시·브레이커 켬 | 0.3ms | 63.6ms | 74.0% | 924 |
| F 로컬만 | 0.3ms | 5.1ms | - | 0 |
- C에서는 모든 요청이 시간 제한 300ms를 다 기다렸습니다. 시간 제한이 없었다면 IPQS가 돌아올 때까지 로그인이 멈췄을 것입니다.
- D에서 브레이커는 연속 실패 5번 만에 열렸고, 그 뒤 2,980번을 부르지 않고 넘겼습니다. 처리 시간이 정상(A)과 같아졌습니다.
- E의 적중률이 B보다 낮은 이유는 실패한 IPQS 결과는 캐시에 넣지 않기 때문입니다.
- 원문 파일에는 클라이언트 쪽 시간도 있습니다. 같은 맥북에서 부하 생성기가 함께 돌아 흔들림이 커서 표에서는 뺐습니다.
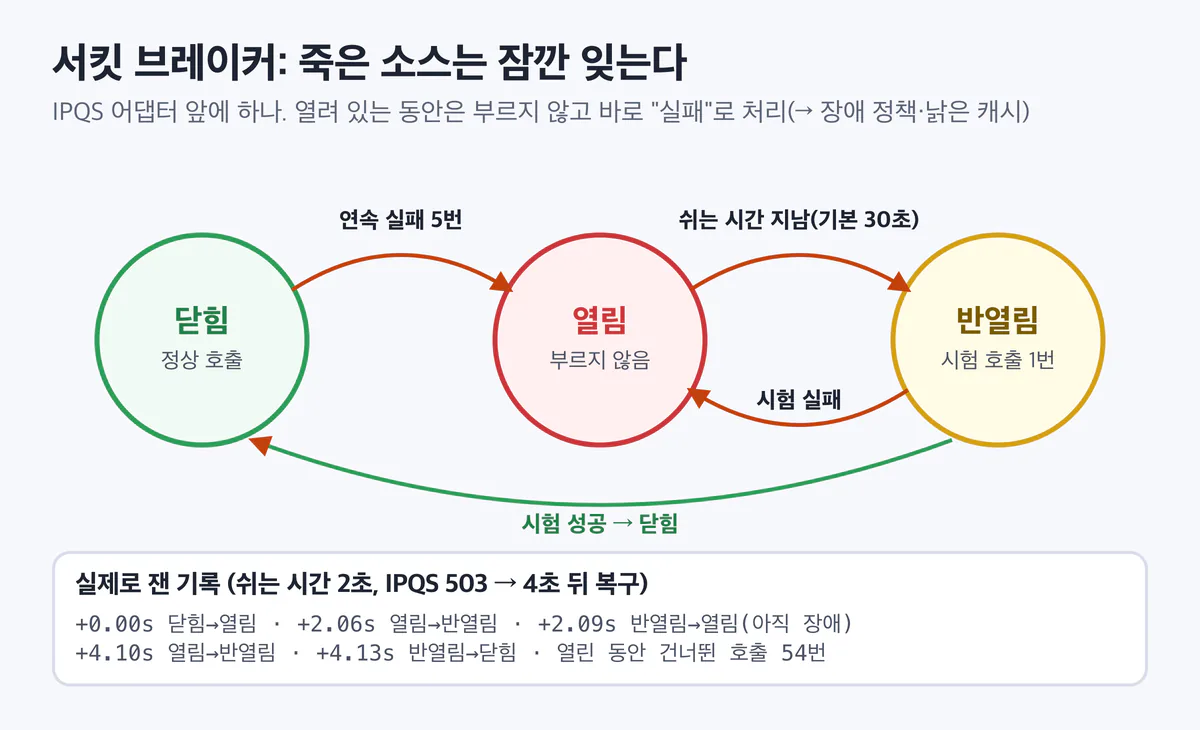
동그라미 셋이 상태이고, 화살표 위 글자가 옮겨 가는 조건입니다. 아래 줄은 쉬는 시간을 2초로 줄이고 IPQS가 503을 내다가 4초 뒤 복구되게 해서 잰 실제 기록입니다.
실제 출력(2026-10-31, macOS):
# 서킷 브레이커 상태 변화(쉬는 시간 2초): ipqs 503 → 4초 뒤 복구
   4.02s 복구 주입
  상태 변화(서버 단조 시계 초, 이전→다음):
    + 0.00s     closed → open
    + 2.06s       open → half_open
    + 2.09s  half_open → open
    + 4.10s       open → half_open
    + 4.13s  half_open → closed
  열림 상태에서 부르지 않고 넘긴 호출: 54
2초 뒤 반열림에서 시험 호출을 한 번 했는데 아직 장애라 다시 열렸습니다. 복구 뒤 반열림의 시험 호출이 성공하자 닫혔습니다. 열려 있는 동안 54번은 IPQS를 부르지 않았습니다.
fail-open과 fail-closed: 같은 장애, 다른 피해
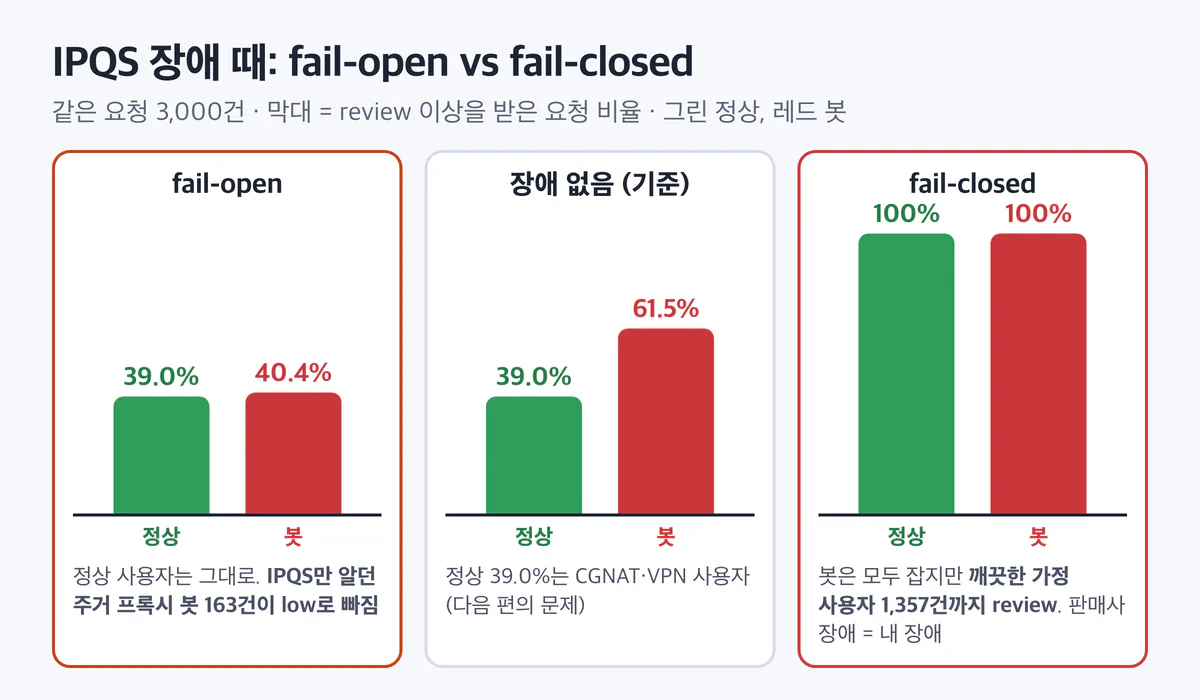
가운데는 장애가 없을 때, 왼쪽은 fail-open, 오른쪽은 fail-closed입니다. 막대 높이는 review 이상을 받은 요청 비율입니다. 그린은 정상 요청, 레드는 봇 요청입니다.
같은 요청 3,000건을 IPQS 장애 상태에서 두 정책으로 돌렸습니다. 이 실험실에서 주거 프록시 출구 일부(198.51.100.128/26)는 IPQS만 프록시로 보게 해 두었습니다.
실제 출력(2026-10-31, macOS):
  on_error=open   정상 요청 중 review 이상 869/2226 (39.0%)  봇 요청 중 review 이상 313/774 (40.4%)
    resi_bot    n=461   low=461
  on_error=closed 정상 요청 중 review 이상 2226/2226 (100.0%)  봇 요청 중 review 이상 774/774 (100.0%)
    home        n=1357  review=1357
  (장애 없음)      정상 요청 중 review 이상 869/2226 (39.0%)  봇 요청 중 review 이상 476/774 (61.5%)
resi_bot n=461 low=298 review=163- fail-open은 정상 사용자에게는 아무 일도 없었습니다. 대신 IPQS만 알던 주거 프록시 봇 163건이 모두
low로 빠졌습니다. 장애 동안 그 봇들은 그냥 통과합니다. - fail-closed는 봇을 모두
review이상으로 올렸지만, 깨끗한 가정 사용자 1,357건까지 모두review가 됐습니다. 평판 회사 장애가 내 서비스의 장애가 됩니다. - 정상 요청의 39.0%가 장애 없이도
review이상인 것은 CGNAT·VPN 사용자 때문입니다. 이 숫자를 그대로 차단에 쓰면 어떻게 되는지가 다음 편입니다.
그래서 화면마다 다르게 정합니다. 대부분의 화면은 fail-open이 맞고, 장애 동안만 "한 단계 조심"(예: 결제 금액 한도 낮추기)을 겁니다. fail-closed는 손해가 큰 일부 행동(큰 금액 출금, 관리자 로그인)에만 둡니다.
오탐과 한계
- 녹화 응답은 판정이 아닙니다. 다섯 소스의 응답은 문서 예시나 합성 예시입니다. 등급 결과는 이 설계가 그 응답을 어떻게 읽는지 보여 줄 뿐, 그 회사가 그 IP를 실제로 어떻게 보는지가 아닙니다.
- 경계값은 내 정책입니다. AbuseIPDB 25/75와 IPQS 75/90은 문서의 권고를 따랐지만, VirusTotal 1/2/5개, IPQS 40, Talos 등급 대응은 이 실험실이 정한 값입니다. 권고값도 판매사 고객 전체 기준이라 내 트래픽으로 다시 재야 합니다.
- 지연은 가짜입니다. 녹화 소스의 지연은 주입한 값입니다. 실제 판매사 API의 응답 시간은 재지 않았습니다.
- TTL 결과는 가짜 시나리오입니다. IP가 얼마나 자주 반복되는지, 상태가 얼마나 자주 바뀌는지에 따라 답이 달라집니다.
- 결합 규칙도 틀릴 수 있습니다. "단독 소스는 high 불가"는 한 소스만 아는 진짜 공격을 늦춥니다. "공유 IP면 review까지"는 공유 IP 뒤의 진짜 공격자에게도 관대합니다. 그래서 IP 평판만으로 강한 대응을 하지 않고, 다음 편처럼 계정 신호와 합칩니다.
실무 체크
- 평판 조회는 서비스 하나로 모으고, 결과는 점수가 아니라 등급과 이유 목록으로 남깁니다.
- 외부 소스마다 시간 제한과 서킷 브레이커를 붙이고, 화면마다 fail-open/fail-closed를 미리 정합니다.
- 캐시 TTL은 결과마다 다르게 두고, 좋음 TTL과 한도를 함께 재서 정합니다.
정리
- 척도가 다른 소스를 공통 등급 넷과 이유 목록으로 바꾸면 화면 코드는 등급만 보고 행동을 정할 수 있습니다.
- 결합은 가장 높은 근거에서 출발하되, 혼자서는
high가 못 되고 공유 IP면review까지로 묶었습니다. - 소스 하나가 응답하지 않을 때 시간 제한만 있으면 모든 요청이 300ms 늦어졌고, 브레이커를 켜니 정상과 같아졌습니다.
- fail-open은 장애 동안 봇을 놓치고(봇
review이상 61.5% → 40.4%), fail-closed는 정상 사용자 전부를 불편하게 했습니다(39.0% → 100%).
출처와 확인 날짜
모든 링크는 2026-10-31에 확인했습니다.
- AbuseIPDB API 문서(CHECK 필드, BLACKLIST
confidenceMinimum25~100, 차단 권장 75~100): https://docs.abuseipdb.com/ - IPQS 프록시 탐지 API 응답 필드(75·85·90 구간,
shared_connection): https://www.ipqualityscore.com/documentation/proxy-detection-api/response-parameters - VirusTotal IP 객체(
last_analysis_stats,last_analysis_results): https://docs.virustotal.com/reference/ip-object - Cisco Talos 평판 센터 개요: https://support.talosintelligence.com/docs/rep-overview/
- Criminal IP 자산 IP 보고서 API: https://search.criminalip.io/developer/api/get-asset-ip-report
- MaxMind 공개 테스트 데이터: https://github.com/maxmind/MaxMind-DB/tree/main/test-data
- 실험 결과:
lab/results/13-rephub-check.txt,13-rephub-bench.txt,13-rephub-ttl-sim.txt(2026-10-31 실행)
이전 글 도입 체크리스트: 고를 때 물어야 할 여덟 가지
다음 글 점수를 정책으로: 막지 말고 마찰을 더하라
시리즈 전체 목록 IP 평판은 어떻게 만들어지고, 어떻게 써야 하나 전체 목록
