13편의 rep-hub를 로그인에 붙이고 "review 이상이면 차단"이라는 한 줄을 넣었다고 해 봅시다. 데이터센터에서 오는 로그인 대입 봇이 모두 막힙니다. 좋은 소식입니다. 같은 날 고객센터에는 "모바일로는 로그인이 안 돼요"라는 문의가 쌓입니다. 같은 통신사 공인 IP를 쓰는 사람 수백 명이 함께 막혔기 때문입니다. 이번 글은 점수를 행동으로 바꾸는 법이고, 그 비교를 실제로 돌린 결과입니다.
대응 사다리: 확신만큼만 세게
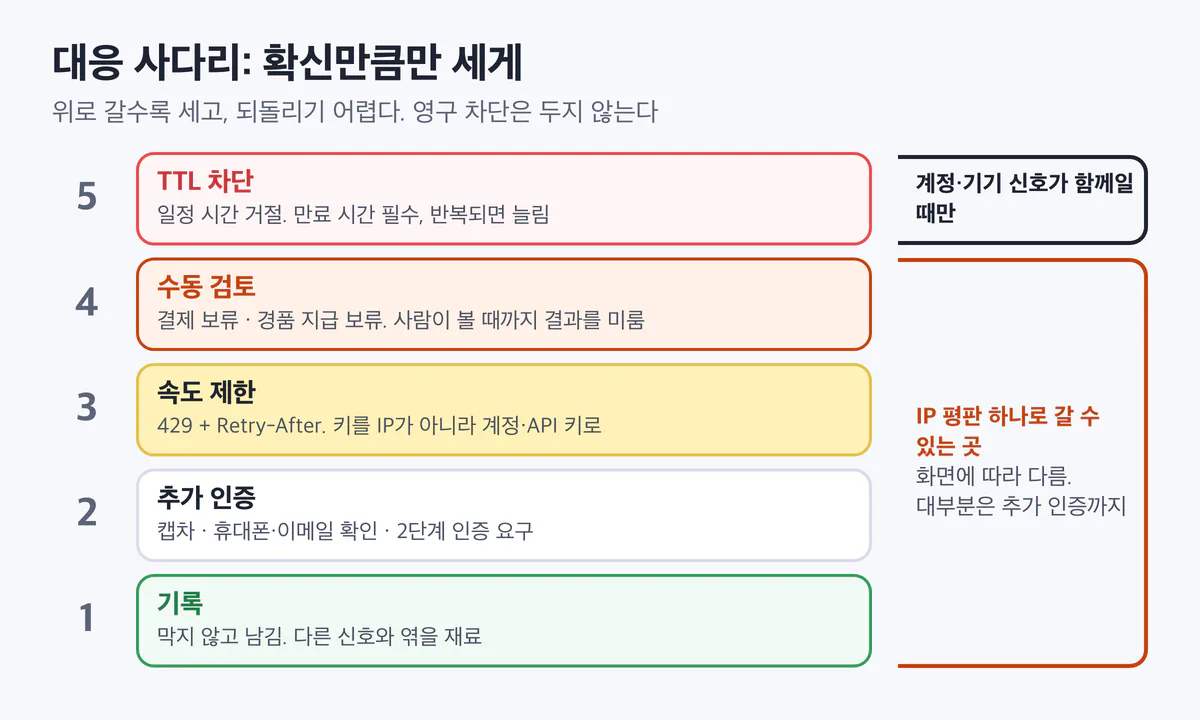
아래에서 위로 올라갈수록 세지고, 되돌리기 어려워집니다. 오른쪽 주황 괄호는 IP 평판 하나만으로 갈 수 있는 곳입니다. 대부분의 화면은 추가 인증까지만 쓰고, 결제·이벤트처럼 결과를 미룰 수 있는 화면만 수동 검토까지 씁니다. 맨 위 차단은 계정·기기 신호가 함께 있을 때만 씁니다.
- 기록(log). 아무것도 막지 않고 남깁니다. 나중에 다른 신호와 엮을 재료입니다.
- 추가 인증(friction). 사람인지, 본인인지 한 번 더 확인합니다. 캡차, 휴대폰·이메일 확인, 2단계 인증 요구가 여기 들어갑니다. 정상 사용자는 몇 초 불편하고 통과합니다.
- 속도 제한(limit). 일정 시간 요청 수를 줄입니다. 429와
Retry-After로 언제 다시 오라고 알려 줍니다. - 수동 검토(review). 결제 보류, 경품 지급 보류처럼 사람이 확인할 때까지 결과를 미룹니다. 비용이 큰 행동에 씁니다.
- TTL 차단(block). 일정 시간 거절합니다. 차단에는 반드시 만료 시간을 붙이고, 영구 차단은 두지 않습니다.
앞 시리즈의 방어선 1-④에서 같은 사다리를 탐지 규칙에 썼습니다(기록 → 지연 → 429 → 챌린지 → 세션 폐기 → TTL 차단). 이번에는 재료가 IP 평판이라는 점만 다릅니다. 그 편의 결론은 "IP 기준 신호는 기록까지만, 강한 대응은 신원(계정) 기준 신호로"였습니다. 이번 글은 여러 소스를 합친 등급이 있으니 한 칸 더 나갑니다. IP 평판으로는 추가 인증·검토까지, 차단은 신원 신호가 있을 때만.
화면마다 다른 기준
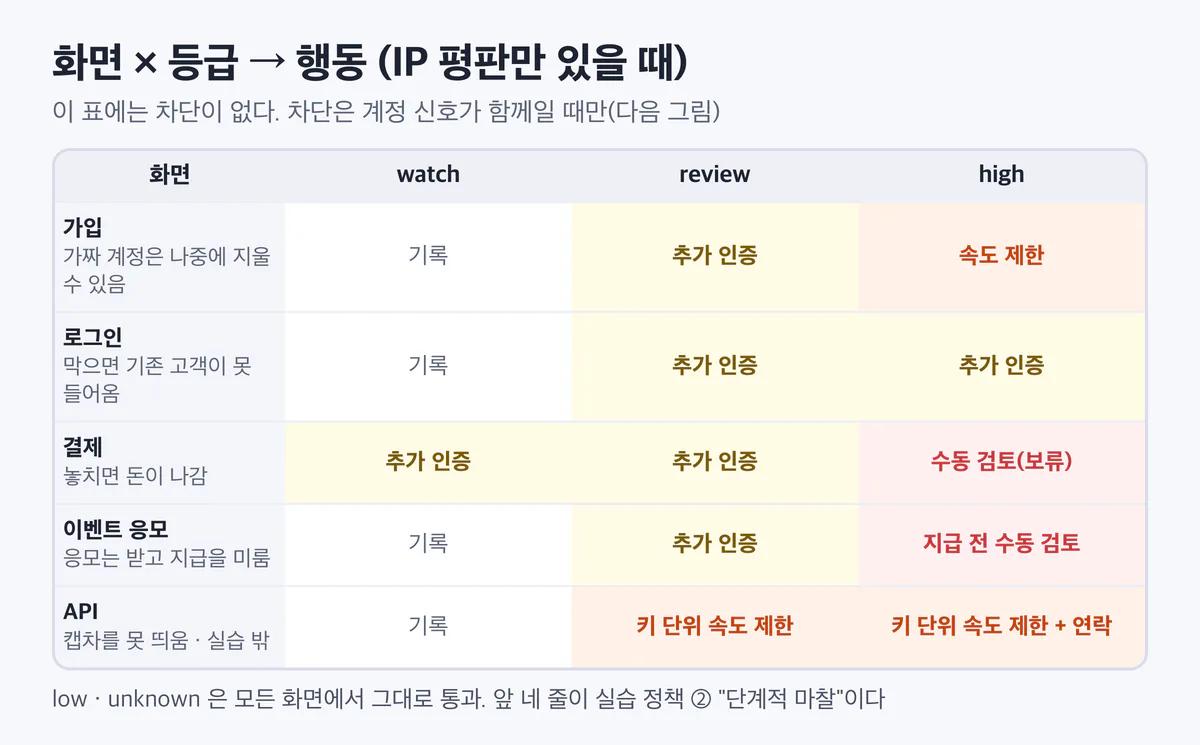
한 줄이 화면 하나이고, 열이 rep-hub가 준 등급입니다. 칸 안이 그 화면에서 하는 행동입니다. 이 표에는 차단이 한 칸도 없습니다. IP 평판만으로는 차단하지 않기 때문입니다.
화면마다 기준이 다른 이유는 실수의 값이 다르기 때문입니다.
| 화면 | 봇을 놓치면 | 정상 사용자를 막으면 | 그래서 |
|---|---|---|---|
| 가입 | 가짜 계정이 쌓임(나중에 지울 수 있음) | 신규 고객을 잃음 | 마찰은 가볍게, high는 속도 제한 |
| 로그인 | 계정 탈취 | 기존 고객이 못 들어옴 | 추가 인증까지. 차단은 계정 신호가 있을 때만 |
| 결제 | 돈이 나감(차지백) | 매출을 잃음 | watch부터 추가 인증, high는 수동 검토 |
| 이벤트 응모 | 경품이 봇에게 감 | 응모자 불만 | 응모는 받고 지급을 수동 검토 |
| API | 데이터 긁어 가기 | 제휴사 연동이 끊김 | 캡차를 못 띄우므로 속도 제한, 키 단위로 |
이벤트는 "응모는 받되 지급을 보류"가 좋은 예입니다. 봇이 응모해도 경품은 나가지 않고, 정상 사용자는 응모가 막히지 않습니다. 판단을 돈이 나가는 시점으로 미루는 것입니다.
IP 평판은 다른 신호와 합친다
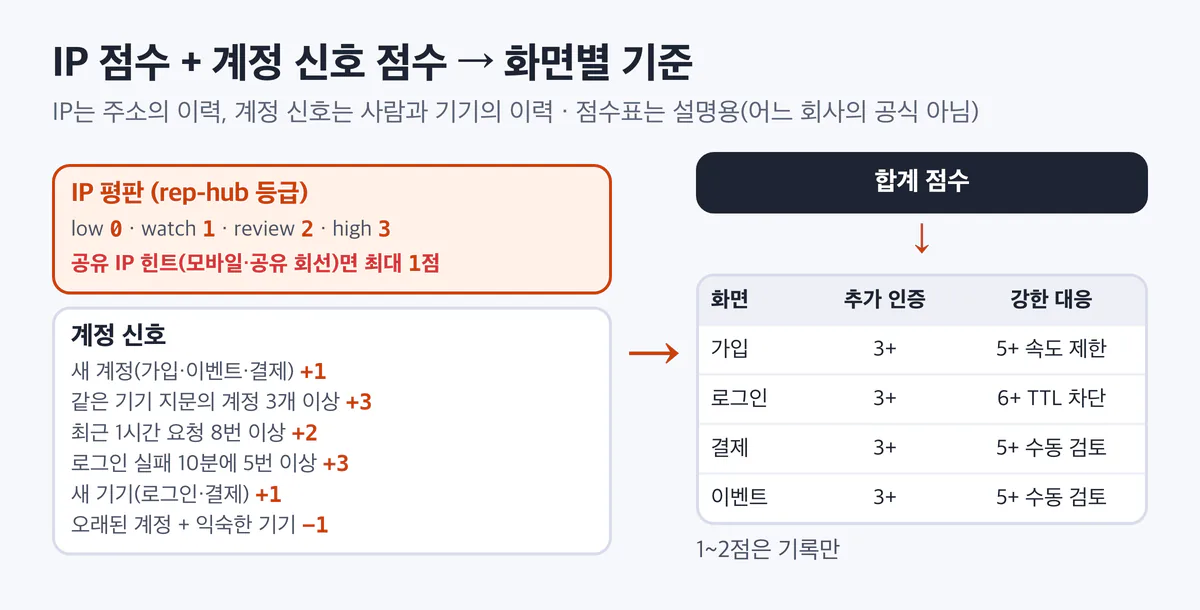
왼쪽 위가 IP 평판, 왼쪽 아래가 계정 신호입니다. 두 점수를 더해 오른쪽의 화면별 기준과 비교합니다. 가장 중요한 줄은 왼쪽 위의 "공유 IP면 1점까지"입니다. CGNAT·공유 회선 힌트가 있으면 IP가 아무리 나빠 보여도 1점만 셉니다.
IP는 주소의 이력이고, 계정 신호는 사람(계정)과 기기의 이력입니다. 공유 IP 뒤에서는 주소의 이력이 남의 것일 수 있지만, 계정의 이력은 그 사람 것입니다.
# lab/traffic/evaluate.py (발췌)
def account_points(e):
    p = 0
    if e["screen"] in ("signup", "event", "payment") and e["account_age_days"] < 1: p += 1  # 새 계정
    if e["device_accounts"] >= 3: p += 3              # 같은 기기 지문에 계정 3개 이상
    if e["velocity_1h"] >= 8: p += 2                  # 최근 1시간 요청 8번 이상
    if e["screen"] == "login" and e["failed_logins_10m"] >= 5: p += 3
    if e["screen"] in ("login", "payment") and e["new_device"]: p += 1
    if e["account_age_days"] >= 180 and not e["new_device"]: p -= 1   # 오래된 계정 + 익숙한 기기
    return p

def p_combined(e, rep):
    ip = {"low": 0, "watch": 1, "review": 2, "high": 3}.get(rep["level"], 0)
    if "shared_ip_possible" in rep.get("hints", []):
        ip = min(ip, 1)                               # 공유 IP면 1점까지
    s = ip + account_points(e)
    friction, strong, action = THRESH[e["screen"]]    # 예: login (3, 6, "block")
    ...
화면별 기준은 가입 (3, 5, 속도 제한), 로그인 (3, 6, TTL 차단), 결제 (3, 5, 수동 검토), 이벤트 (3, 5, 수동 검토)로 두었습니다. 3점 이상이면 추가 인증, 강한 기준 이상이면 그 화면의 강한 대응입니다. 이 점수표는 설명용이고, 어느 회사의 공식이 아닙니다.
섀도 모드로 먼저 잰다
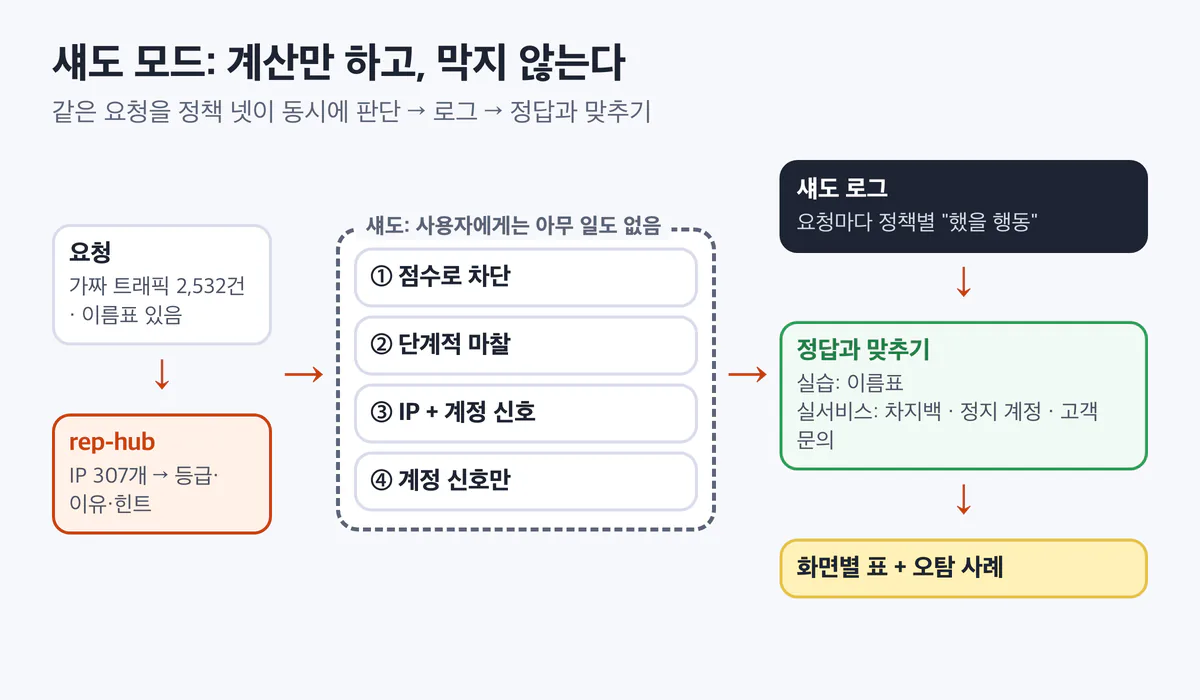
왼쪽에서 오른쪽으로 흐릅니다. 가운데 점선 상자 안의 정책 넷은 계산만 하고 아무것도 막지 않습니다. 오른쪽에서 정답(이름표)과 맞춰 봅니다. 실제 서비스에서는 이름표 대신 차지백, 나중에 정지한 계정, 고객 문의가 정답 역할을 합니다.
이번 실습의 가짜 트래픽입니다.
cd lab
rep-hub/run.sh start 18650
.venv/bin/python traffic/gen_traffic.py
.venv/bin/python traffic/evaluate.py --port 18650
실제 출력(2026-10-31, macOS):
# 가짜 트래픽 2532건 → traffic.jsonl
actor         signup    login  payment    event     합계
home              26      431       77       78      612
cgnat             27      617      108       95      847
vpn_user           4       58       15        6       83
resi_bot         120        0       29      371      520
dc_scraper        40      400       30        0      470
distinct IP: 307 CGNAT 공인 IP 4개 뒤 사용자 300명- home 가정 사용자 220명. 공인 IP 120개(한 집에 둘인 경우 있음,
192.0.2.x) - cgnat 통신사 CGNAT 뒤 사용자 300명. 안쪽 주소는
100.64.x.x, 서버가 보는 공인 IP는 4개뿐. 그 IP에는 다른 공격자 때문에 신고가 쌓여 있음 - vpn_user 사생활 보호용 VPN을 쓰는 정상 사용자 30명
- resi_bot 주거 프록시로 요청마다 출구를 바꾸는 가입·이벤트 어뷰징 봇(계정 120개)
- dc_scraper 데이터센터에서 남의 계정으로 로그인을 대입하는 봇
규칙을 만든 사람이 데이터도 만들었으니, 일부러 불리하게 섞었습니다. 정상 사용자 중 4%는 가족 태블릿·PC방처럼 기기 하나에 계정이 여럿이고, 5%는 자주 누르는 사용자이고, 이벤트 응모자의 20%는 그날 가입했습니다. 봇의 25%는 사람 속도로 움직이고, 30%는 매번 새 기기 지문을 씁니다.
정책은 넷입니다.
- ① 점수로 차단 review 이상이면 차단
- ② 단계적 마찰 앞의 화면별 표대로. IP만으로 차단 없음
- ③ IP + 계정 신호 앞의 점수표
- ④ 계정 신호만 비교용. IP 평판을 아예 안 씀
결과: 같은 트래픽, 정책 넷
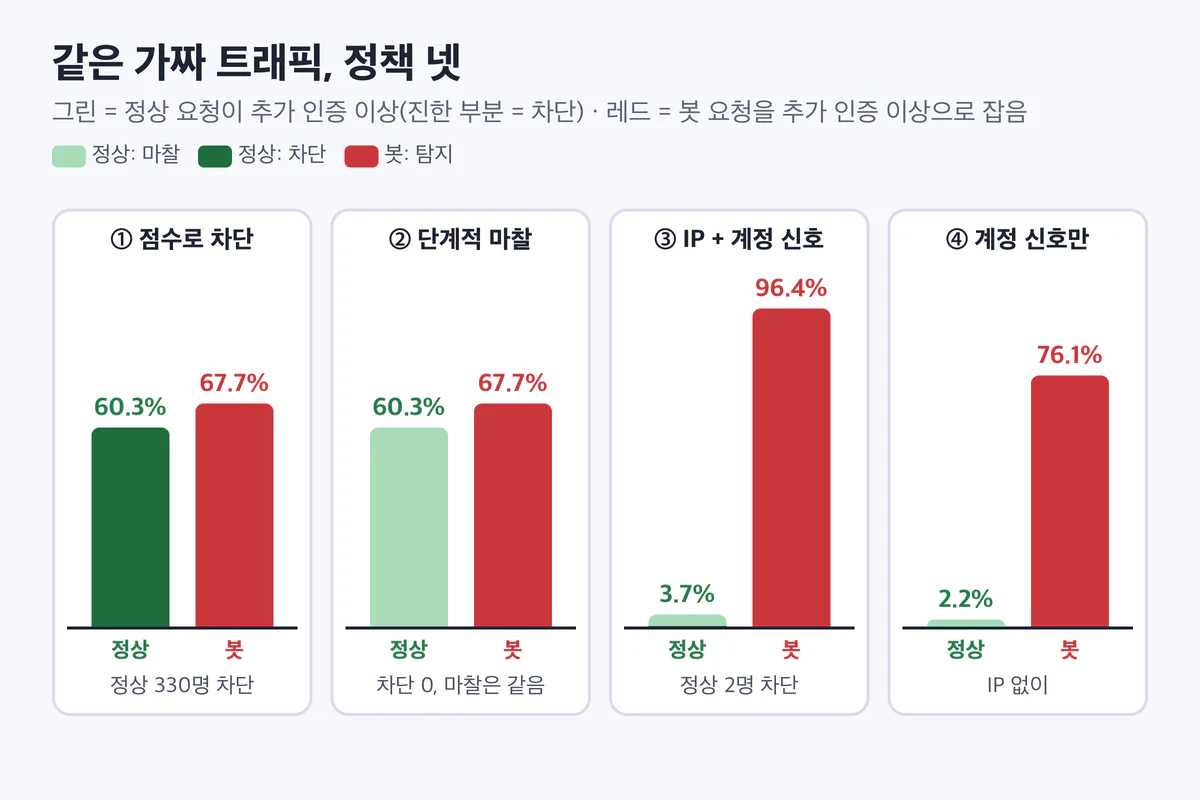
막대 둘씩이 정책 하나입니다. 그린은 정상 요청이 추가 인증 이상을 받은 비율(진한 부분이 차단), 레드는 봇 요청을 추가 인증 이상으로 잡은 비율입니다. 그린은 낮을수록, 레드는 높을수록 좋습니다.
실제 출력(2026-10-31, macOS, 전체 줄):
화면      정책                       정상 n      마찰률      차단률    봇 n      탐지율      차단률
전체      ① 점수로 차단                 1542    60.3%    60.3%    990    67.7%    67.7%
전체      ② 단계적 마찰                 1542    60.3%     0.0%    990    67.7%     0.0%
전체      ③ IP+계정 신호               1542     3.7%     0.2%    990    96.4%    24.9%
전체      ④ 계정 신호만                 1542     2.2%     0.1%    990    76.1%     0.0%
화면별로 나누면 이렇습니다(정상 마찰률 / 봇 탐지율).
| 화면 | ① 점수로 차단 | ② 단계적 마찰 | ③ IP + 계정 신호 | ④ 계정 신호만 |
|---|---|---|---|---|
| 가입 | 54.4% / 56.9% (전부 차단) | 54.4% / 56.9% | 1.8% / 88.1% | 1.8% / 75.0% |
| 로그인 | 61.0% / 100% (전부 차단) | 61.0% / 100% | 3.9% / 100% | 2.3% / 61.8% |
| 결제 | 61.5% / 64.4% (전부 차단) | 61.5% / 64.4% | 4.5% / 98.3% | 3.0% / 66.1% |
| 이벤트 | 56.4% / 38.0% (전부 차단) | 56.4% / 38.0% | 2.2% / 95.7% | 1.1% / 93.5% |
읽을 것 셋입니다.
- ①은 정상 요청의 60.3%를 차단했습니다. 사람으로 세면 정상 사용자 330명(CGNAT 300명 전원, VPN 사용자 30명 전원)이 한 번 이상 막혔습니다. 그런데 봇은 67.7%만 잡았습니다. 깨끗한 가정 회선을 빌려 쓰는 주거 프록시 봇은 IP 평판으로는 대부분 안 보이기 때문입니다.
- ②는 ①과 숫자가 같지만 차단이 0입니다. 같은 사람들이 불편해졌지만 막히지는 않았습니다. 사다리만 바꿔도 피해의 종류가 바뀝니다. 다만 정상 요청의 60%에 캡차를 띄우는 것도 서비스로서는 큰 비용입니다.
- ③은 정상 마찰을 3.7%로 줄이고 봇을 96.4% 잡았습니다. ④(계정 신호만, 76.1%)와 비교하면 IP 평판이 더한 몫이 보입니다. 정상 마찰은 1.5%p 늘고, 봇 탐지는 20.3%p 늘었습니다. 대부분은 데이터센터 로그인 대입 봇입니다(④ 62.3% → ③ 100%).
누가 맞았나
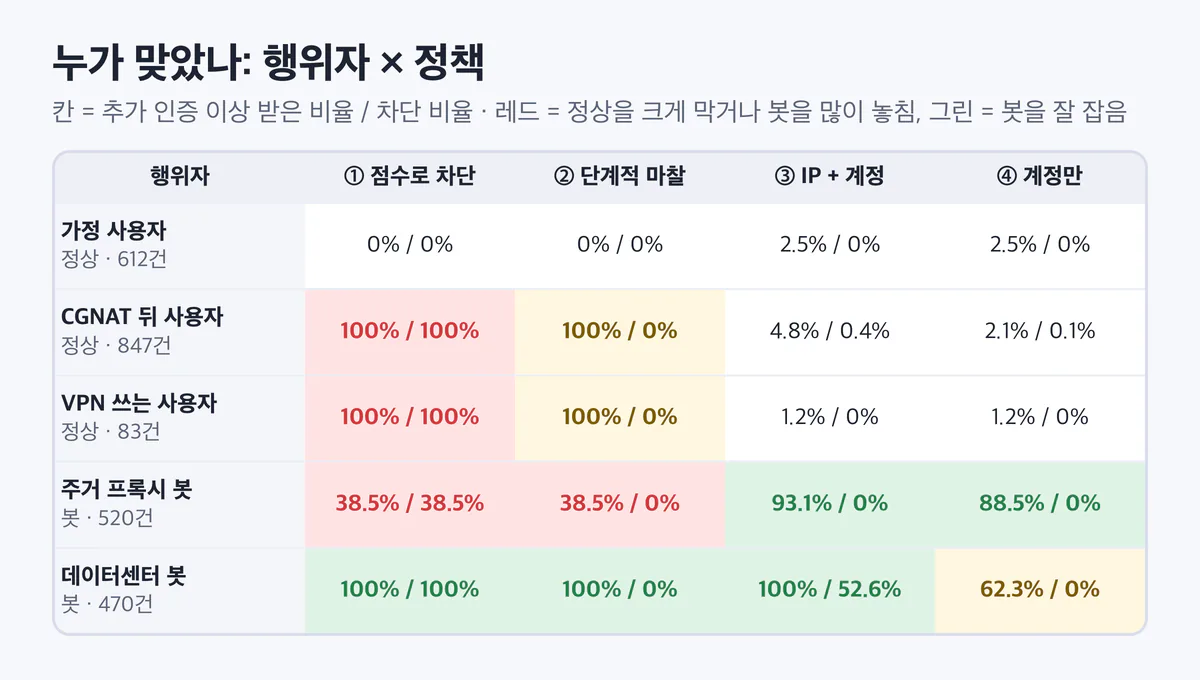
줄이 행위자, 열이 정책입니다. 칸의 앞 숫자는 추가 인증 이상을 받은 비율, 뒤 숫자는 차단 비율입니다. 레드 칸은 정상 사용자를 크게 막았거나 봇을 많이 놓친 곳, 그린 칸은 봇을 잘 잡은 곳입니다.
실제 출력(2026-10-31, macOS):
## 행위자별: friction 이상 받은 비율 / block 받은 비율
actor           n              ① 점수로 차단              ② 단계적 마찰            ③ IP+계정 신호              ④ 계정 신호만
home          612           0.0% /   0.0%           0.0% /   0.0%           2.5% /   0.0%           2.5% /   0.0%
cgnat         847         100.0% / 100.0%         100.0% /   0.0%           4.8% /   0.4%           2.1% /   0.1%
vpn_user       83         100.0% / 100.0%         100.0% /   0.0%           1.2% /   0.0%           1.2% /   0.0%
resi_bot      520          38.5% /  38.5%          38.5% /   0.0%          93.1% /   0.0%          88.5% /   0.0%
dc_scraper    470         100.0% / 100.0%         100.0% /   0.0%         100.0% /  52.6%          62.3% /   0.0%

## 한 번이라도 block 받은 정상 사용자 수(사람 기준)
  ① 점수로 차단               330명  cgnat 300명, vpn_user 30명
  ② 단계적 마찰               0명
  ③ IP+계정 신호             2명  cgnat 2명
  ④ 계정 신호만               1명  cgnat 1명
③에서도 막힌 정상 사용자가 2명 있습니다. 섀도 로그(lab/traffic/shadow_log.jsonl)를 열어 보면 둘 다 기기 하나를 가족 여럿이 쓰는 CGNAT 사용자가 비밀번호를 5~6번 틀린 경우입니다. 계정 신호 점수만 5~7점이었습니다. 이런 사례가 섀도 모드의 수확입니다. 켜기 전에 "로그인 차단 기준을 7점으로" 또는 "로그인은 차단 대신 비밀번호 재설정 유도"로 고칠 수 있습니다.
③이 놓친 봇도 있습니다. 주거 프록시 봇 요청 36건입니다. 모두 IP가 깨끗하고(low), 매번 새 기기 지문을 쓰고, 사람 속도로 움직인 봇이었습니다. IP·기기·속도 어느 쪽에도 흔적이 없으면 이 방식으로는 못 잡습니다. 이벤트라면 "지급 전 수동 검토"가, 결제라면 결제 단계의 신호(카드·배송지)가 다음 방어선입니다.
외부로 안 보내면 무엇을 잃나
같은 평가를 rep-hub의 외부 전송 안 함 모드로도 돌렸습니다(--mode local_only, lab/results/14-shadow-eval-local-only.txt). ③의 봇 탐지율이 96.4%에서 76.1%로 내려가 ④(계정 신호만)와 같아졌습니다. 다만 이 실험실의 로컬 소스는 MaxMind 테스트용 DB라서 문서용 IP를 거의 모릅니다. 실제 Anonymous IP DB는 데이터센터 대역을 is_hosting_provider로 많이 알 것이므로, 이 차이는 "로컬 DB가 내 트래픽의 IP를 얼마나 아는지"에 달려 있습니다. 실제 GeoIP2 Anonymous IP나 GeoLite2 데이터로 같은 평가를 돌리면 이 차이가 얼마인지 알 수 있습니다.
섀도 모드에서 켜기까지
이 실습은 몇 초 만에 끝났지만, 실제 서비스에서는 이렇게 진행합니다.
- 섀도로 2~4주. 정책 넷을 동시에 계산해 로그만 남깁니다. 요일·월말·이벤트 날이 한 번씩은 들어가게 합니다.
- 정답과 맞추기. 차지백, 나중에 정지한 계정, 고객 문의, 수동 검토 결과를 이름표로 씁니다.
- 오탐 사례를 읽기. 숫자보다 사례가 중요합니다. 위의 "가족 기기 + 비밀번호 실수"처럼 규칙을 고칠 단서가 나옵니다.
- 한 화면, 한 칸씩 켜기. 가장 손해가 큰 화면(결제)의 가장 약한 행동(추가 인증)부터 켭니다. 차단은 맨 나중입니다.
- 되돌리기를 먼저 만들기. 결정마다 이유를 남기고, 고객센터가 결정 하나를 풀 수 있게 합니다. 차단에는 TTL을 붙입니다.
오탐과 한계
- 모든 숫자는 가짜 트래픽에서 나왔습니다. 행위자 비율, 계정 신호의 분포, 녹화 응답 모두 지어낸 것입니다. 실제 서비스의 오탐률이나 탐지율이 아닙니다.
- 규칙과 데이터를 같은 사람이 만들었습니다. 그래서 ③이 좋아 보이는 것은 어느 정도 당연합니다. 일부러 정상 사용자에게 봇 같은 신호를 섞었지만, 실제 데이터는 더 지저분합니다.
- 계정 신호에도 개인정보가 있습니다. 기기 지문, 행동 기록은 IP보다 더 민감할 수 있습니다. 12편 ④와 같은 확인이 필요합니다(법률 자문 아님).
- 추가 인증도 비용입니다. 캡차 하나에도 이탈하는 사용자가 있습니다. 마찰률 3.7%가 내 서비스에서 감당할 만한지는 전환율로 재야 합니다.
- 봇은 적응합니다. 기기 지문을 매번 바꾸고 사람 속도로 움직이는 봇은 이 방식으로 못 잡았습니다. 이 글은 막는 쪽의 정책만 다룹니다.
실무 체크
- IP 평판 등급만으로는 차단하지 않습니다. 화면별 사다리에서 추가 인증까지만 씁니다.
- 공유 IP 힌트가 있으면 IP 점수를 깎고, 계정·기기·속도 신호와 합쳐 강한 대응을 정합니다.
- 새 정책은 섀도 모드로 2~4주 돌리고, 오탐 사례를 읽은 뒤 한 화면의 약한 행동부터 켭니다.
정리
- 대응은 기록 → 추가 인증 → 속도 제한 → 수동 검토 → TTL 차단으로, 확신만큼만 세게 합니다.
- 같은 가짜 트래픽에서 "점수로 차단"은 정상 사용자 330명을 막고 봇은 67.7%만 잡았습니다.
- IP 평판과 계정 신호를 합치니 정상 마찰 3.7%, 봇 탐지 96.4%였습니다. IP 평판이 더한 몫은 봇 탐지 20.3%p였고, 대부분 데이터센터 봇이었습니다.
- 섀도 모드는 숫자보다 사례를 줍니다. 막힐 뻔한 두 사람이 규칙을 어떻게 고칠지 알려 줬습니다.
출처와 확인 날짜
모든 링크는 2026-10-31에 확인했습니다.
- 앞 시리즈 방어선 1-④ 단계적 대응과 섀도 모드: https://velog.io/@bumicklee/realtime-detect-06-graduated-response
- 앞 시리즈 방어선 2-② IP 평판·위협 인텔리전스의 쓸모와 한계: https://velog.io/@bumicklee/realtime-detect-08-ip-reputation
- RFC 6585 429 Too Many Requests: https://www.rfc-editor.org/rfc/rfc6585.html
- RFC 6598 공유 주소 공간(100.64.0.0/10): https://www.rfc-editor.org/rfc/rfc6598.html
- 실험 결과:
lab/results/14-traffic-gen.txt,14-shadow-eval.txt,14-shadow-eval-local-only.txt(2026-10-31 실행)
이전 글 연동 아키텍처: 여러 소스를 하나의 판단으로
다음 글 정리: 비교표와 고르는 법
시리즈 전체 목록 IP 평판은 어떻게 만들어지고, 어떻게 써야 하나 전체 목록
