열거 공격을 잡는 첫 생각은 "1분에 100번 넘게 부르면 막자"입니다. 실험실에서 이 규칙(60초 120회)을 돌려 보면 빠른 열거와 폭주 수집은 잡습니다. 하지만 90초에 한 번 오는 느린 열거는 영원히 못 잡고, 0.4초마다 목록을 다시 부르는 잘못 만든 정상 앱은 잡습니다. 무엇을 세느냐가 얼마나 세느냐보다 중요합니다.
슬라이딩 윈도우란
슬라이딩 윈도우는 "지금부터 거꾸로 W초 동안 일어난 일"을 계속 세는 방식입니다. 고정 윈도우(매 분 0초에 숫자를 0으로)와 달리 경계에서 두 배로 몰아치는 요청도 놓치지 않습니다.
Redis 공식 튜토리얼은 두 가지를 소개합니다.
- 슬라이딩 윈도우 로그: 일이 생길 때마다 시각을 기록하고, 오래된 기록을 지우고, 남은 개수를 셉니다. 정확하지만 기록 수만큼 메모리를 씁니다. 인증·결제처럼 정확해야 하는 곳에 권합니다.
- 슬라이딩 윈도우 카운터: 이전 칸과 현재 칸의 숫자를 비율로 섞어 근사합니다. 가볍습니다. 일반 속도 제한의 기본값으로 권합니다.
탐지에는 로그 방식이 잘 맞습니다. 이유는 다음 절에 있습니다. "몇 번"이 아니라 "서로 다른 것이 몇 개"를 세고 싶기 때문입니다.
정렬 집합 하나로 "서로 다른 것"을 센다
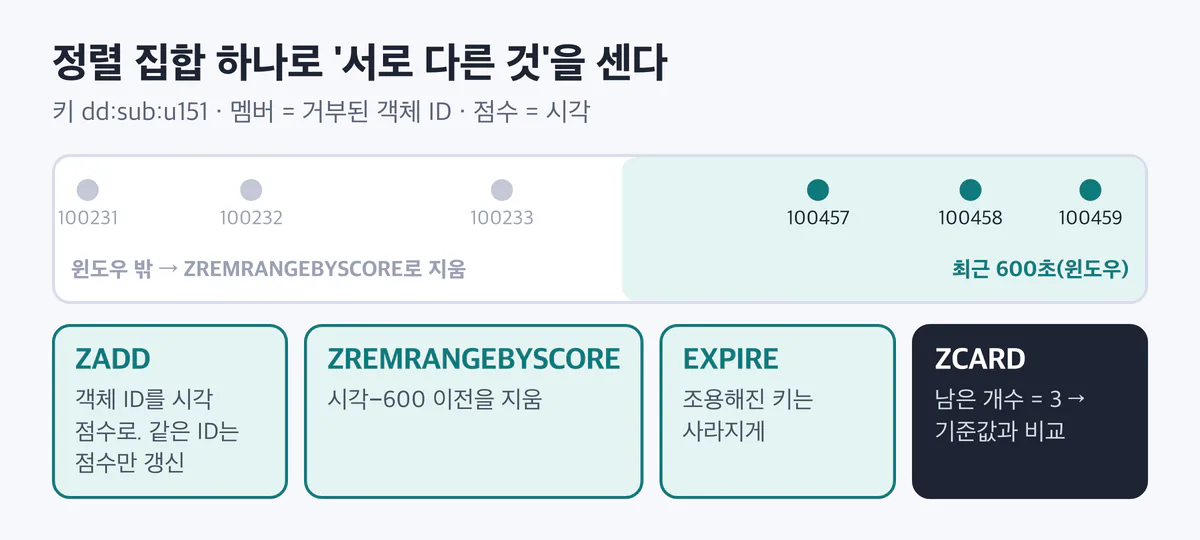
Redis 정렬 집합(Sorted Set)은 "멤버 → 점수" 묶음입니다. 점수에 시각을 넣으면 됩니다.
- 멤버를 요청 번호로 넣으면 → 최근 W초의 요청 수
- 멤버를 거부된 객체 ID로 넣으면 → 최근 W초 동안 거부된 서로 다른 객체 수. 같은 주문을 열 번 재시도해도 1로 셉니다.
실험실 lab/detect.py의 Lua 스크립트입니다. 추가, 정리, 세기를 한 번에 원자적으로 합니다.
-- KEYS[1]=키, ARGV[1]=시각, ARGV[2]=멤버, ARGV[3]=시각-윈도우, ARGV[4]=만료(초)
redis.call('ZADD', KEYS[1], ARGV[1], ARGV[2])
redis.call('ZREMRANGEBYSCORE', KEYS[1], '-inf', ARGV[3])
redis.call('EXPIRE', KEYS[1], ARGV[4])
return redis.call('ZCARD', KEYS[1])
키는 규칙:기준:값 모양입니다. 예: dd:sub:u151(사용자 u151이 거부당한 서로 다른 객체). Redis가 없을 때를 위해 같은 의미의 메모리 버전도 있고, 3부 실험에서 두 버전의 경보가 완전히 같다는 것을 확인했습니다.
무엇을 셀까
실험실의 규칙 다섯 개입니다. 기본 기준값은 괄호 안입니다.
| 규칙 | 세는 것 | 겨냥 |
|---|---|---|
deny_distinct | 거부·없음 처리된 서로 다른 객체 수(600초, 5개) | IDOR 열거 |
status_4xx | 403·404 응답 수(60초, 10개) | 원문의 "403 급증" 규칙 |
distinct_objects | 응답 상태와 상관없이 연 서로 다른 주문 수(600초, 30개) | 인가 검사가 없을 때의 열거 |
fuzz | 검증 실패 수(300초, 10개) | 파라미터 퍼징 |
rate | 요청 수(60초, 120개) | 폭주·수집 |
원문의 "id 값만 연속해서 바뀐 횟수"는 deny_distinct로 바꿨습니다. 연속 번호만 보면 공격자가 번호를 건너뛰거나 섞을 때 놓칩니다. 거부된 서로 다른 객체 수는 순서와 상관없이 셉니다.
무엇을 기준으로 셀까
같은 규칙도 기준(키)에 따라 결과가 바뀝니다.
- 신원(계정·세션·API 키): 로그인한 공격은 거의 다 여기 걸립니다. 계정을 여러 개 쓰면 나뉩니다.
- IP: 계정을 바꾸는 공격을 잡습니다. 대신 IP를 바꾸면 놓치고, CGNAT 뒤 정상 사용자를 함께 셉니다.
그래서 둘 다 셉니다. 다만 대응은 신원 기준 경보에만 걸고, IP 기준 경보는 기록과 보조 판단에만 쓰는 것이 이 시리즈의 기본값입니다(6편, 8편). IPv6는 한 가입자가 보통 /64 대역을 통째로 받으므로 주소 하나가 아니라 /64로 묶어 셉니다.
기준값은 정상 트래픽으로 정한다
기준값은 감으로 정하지 않습니다. 정상 트래픽의 최댓값을 먼저 재고, 그 위에 둡니다. 실험실에서 deny_distinct(신원 기준, 600초)의 기준값만 바꿔 본 결과입니다.
| 기준값 | 오탐 사용자(정상 150명 중) | 잡은 IDOR 공격(4종 중) |
|---|---|---|
| 2 | 14명 | 4 |
| 3 | 0명 | 4 |
| 5 | 0명 | 3(계정 바꾸기 놓침) |
| 10 | 0명 | 2 |
기준값 2에서 걸린 14명은 가족이 보낸 주문 링크 두 개를 연 정상 사용자였습니다. 3이면 그들은 빠지고 공격 네 가지는 모두 잡힙니다. 이 표는 이 실험실의 합성 트래픽에서 나온 숫자입니다. 여러분 서비스의 기준값은 여러분의 정상 트래픽으로 다시 재야 합니다. 자세한 실험은 14편에 있습니다.
Jaccard 유사도와 엔트로피를 쓰지 않는 이유
원문은 "요청 패턴의 Jaccard 유사도가 90% 이상이면서 파라미터 값만 바뀌면 퍼징"이라고 합니다. Jaccard 유사도는 두 집합이 얼마나 겹치는지(교집합 ÷ 합집합)입니다. 문제는 정상도 그렇게 생겼다는 점입니다. 목록 2쪽, 3쪽, 4쪽을 넘기는 요청은 경로와 파라미터 이름이 100% 같고 값만 바뀝니다. 90%라는 숫자에도 근거가 없습니다.
엔트로피(값이 얼마나 무작위로 보이는지) 기반 규칙도 비슷합니다. UUID, 토큰, 검색어는 정상인데 엔트로피가 높고, 연속 번호 열거는 엔트로피가 오히려 낮습니다. 엔트로피는 "이상한 문자열"을 찾을 때 보조 신호는 될 수 있지만, 열거나 IDOR의 기준이 되기 어렵습니다.
대신 앱이 이미 판단한 결과를 셉니다. 스키마가 거절했는가(fuzz), 인가가 거절했는가(deny_distinct). 판단은 이미 끝났고, 탐지는 그 개수를 셀 뿐입니다. 그래서 정확합니다.
운영에서 챙길 것
- 여러 서버면 공유 저장소에서 셉니다. 서버마다 메모리로 세면 로드밸런서가 요청을 나눠 각 서버가 1/N만 봅니다.
- 요청당 왕복을 한 번으로. 규칙마다 Redis를 따로 부르면 느립니다. 실험실에서 규칙마다 부르는 방식은 p50 지연이 7.06ms, 파이프라인으로 한 번에 보내는 방식은 5.44ms였습니다(탐지 끔 3.86ms, 15편).
- 키에 만료를 겁니다. 조용해진 사용자의 키가 영원히 남지 않게 합니다.
- 같은 경보를 반복하지 않습니다. 실험실은 같은 (규칙, 키) 경보를 60초에 한 번만 냅니다.
- Redis가 죽으면 탐지만 멈추게 합니다. 탐지 실패가 서비스 장애가 되면 안 됩니다.
정리
- 요청 수보다 거부된 서로 다른 객체 수, 검증 실패 수가 열거와 퍼징을 훨씬 정확하게 가릅니다.
- Redis 정렬 집합과 Lua 하나로 "최근 W초 동안 서로 다른 것의 개수"를 원자적으로 셉니다.
- 신원과 IP를 둘 다 세되, 대응은 신원 기준에 겁니다. 기준값은 정상 트래픽으로 정합니다.
출처와 확인 날짜
모든 링크는 2026-10-30에 확인했습니다.
- Redis 속도 제한 튜토리얼(슬라이딩 윈도우 로그·카운터): https://redis.io/tutorials/howtos/ratelimiting/
- Redis 정렬 집합: https://redis.io/docs/latest/develop/data-types/sorted-sets/
- 기준값 표와 지연 수치: 실험실
lab/results/run-shadow-redis/sweeps.csv,lab/results/bench-*.json(2026-10-30 실행, 14·15편) - IPv6 /64 할당 관행: RFC 6177 https://www.rfc-editor.org/rfc/rfc6177.html (가입자에게 /48~/64를 주는 관행. 실제 할당 크기는 통신사마다 다름, 확인 필요)
이전 글 방어선 1-①: 인가 거부를 보안 이벤트로 남기기
다음 글 방어선 1-③: 미끼 객체 하나가 경보 천 개보다 낫다
시리즈 전체 목록 해킹 시도를 몇 초 안에 잡는 서버 전체 목록
