원문의 그림은 모든 요청을 eBPF와 OpenTelemetry로 모아 Kafka에 넣고, Flink가 실시간으로 분석해 차단 목록을 돌려보내는 모양입니다. 큰 회사의 보안 데이터 플랫폼은 실제로 이렇게 생겼습니다. 그런데 서버 세 대짜리 서비스가 이것부터 만들면, 탐지 규칙보다 Kafka 운영에 시간을 더 쓰게 됩니다. 파이프라인은 도구가 아니라 지연 예산으로 고릅니다.
지연 예산이란
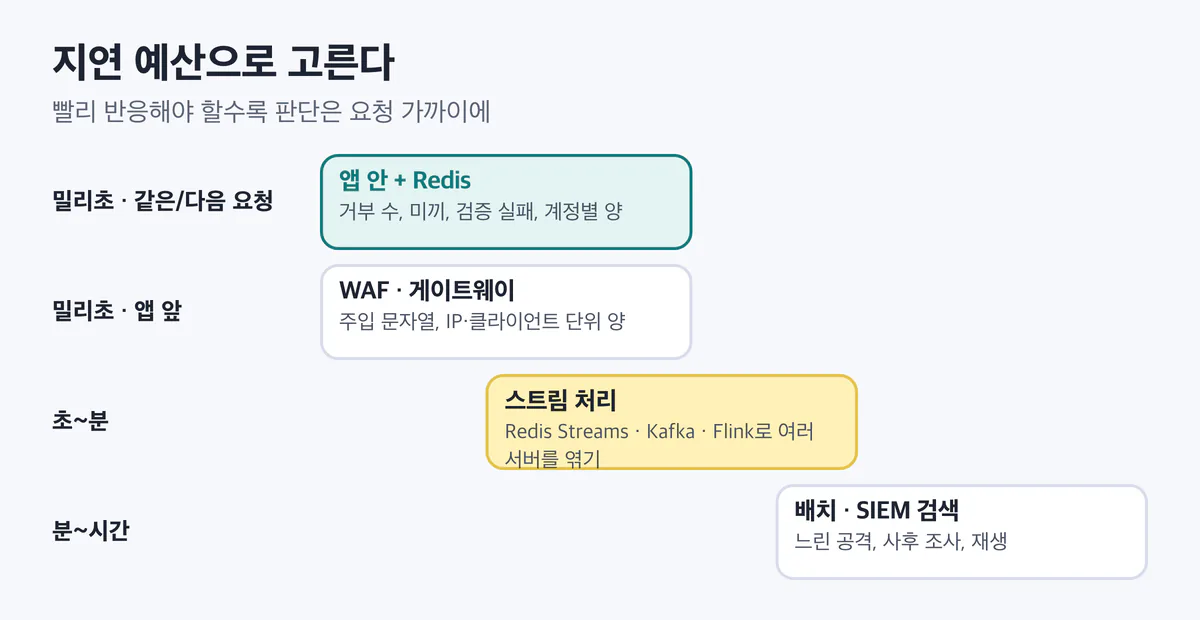
지연 예산(latency budget)은 "공격이 시작된 뒤 몇 초 안에 반응해야 하나"입니다. 반응이 빨라야 할수록 판단은 요청 가까이에 있어야 합니다.
| 반응 시간 | 어디서 | 무엇을 |
|---|---|---|
| 밀리초(같은 요청 또는 바로 다음 요청) | 앱 안 + Redis | 인가 거부 수, 미끼 접근, 검증 실패, 계정별 요청 수 |
| 밀리초(앱 앞) | WAF, 게이트웨이 | 주입 문자열, IP·클라이언트 단위 양 |
| 초~분 | 스트림 처리 | 여러 서버·서비스를 엮은 같은 주체, 로그인과 조회를 엮은 패턴 |
| 분~시간 | 배치, SIEM 검색 | 몇 시간에 걸친 느린 공격, 사후 조사 |
실험실에서 앱 안 + Redis 방식은 요청당 지연을 p50 기준 약 1.6ms 늘렸고(15편), 결정은 바로 다음 요청부터 적용됐습니다. 빠른 열거를 0.8초(모의 시각) 만에 잡은 것도 이 방어선입니다. 이 속도는 스트림 파이프라인으로는 내기 어렵습니다. 반대로 스트림이 아니면 못 하는 일도 있습니다.
스트림이 필요한 때
- 서버가 여러 대이고 상태를 한곳에 모을 수 없을 때. 서비스마다 언어와 저장소가 다르면 공유 Redis 하나로 엮기 어렵습니다.
- 서로 다른 종류의 신호를 엮을 때. "로그인 실패가 많던 IP에서 성공한 계정이 바로 주문 조회를 훑는다"는 로그인 서비스와 주문 서비스를 함께 봐야 보입니다.
- 긴 윈도우. 몇 시간~며칠 걸친 느린 공격. 앱 안의 Redis에 며칠 치 기록을 들고 있기는 부담입니다.
- 보관과 재생. 규칙을 바꾼 뒤 지난주 트래픽으로 다시 돌려 보기(14편의 재생과 같은 일).
구성 요소 한 줄씩
- OpenTelemetry(OTel). 추적·지표·로그를 같은 형식으로 내보내는 표준입니다. 앱이 보안 이벤트를 OTel 로그나 스팬 속성으로 내보내고, OTel Collector가 받아 나릅니다.
- Vector, Fluent Bit. 로그를 읽고, 바꾸고, 다른 곳으로 보내는 수집기입니다. 둘 다 Kafka로 보낼 수 있습니다. 한 가지 주의: Vector의 Redis 싱크는 Redis Streams를 지원하지 않습니다. 리스트, 발행/구독 채널, 정렬 집합만 됩니다. 원문 그림처럼 Vector에서 Redis Streams로 바로 넣으려면 다른 길이 필요합니다.
- Kafka. 대용량 이벤트를 순서대로 보관하고 여러 소비자에게 나눠 줍니다.
- Apache Flink. 스트림 위에서 윈도우 연산을 합니다. 고정 크기 윈도우(tumbling), 겹치는 윈도우(sliding), 활동이 끊기면 닫히는 세션 윈도우를 지원하고, 이벤트 시각과 워터마크(이 시각 이전 이벤트는 다 왔다는 표시)로 늦게 도착한 이벤트를 다룹니다. 늦은 이벤트 허용 시간의 기본값은 0입니다.
- Redis Streams. Redis 안의 추가 전용 로그입니다.
XADD로 넣고, 소비자 그룹으로XREADGROUP해서 나눠 읽고,XACK로 처리 완료를 표시합니다.MAXLEN으로 길이를 자릅니다.
작게 시작하기: Redis Streams
이미 Redis를 쓰고 있다면 방어선 3을 Redis Streams로 시작할 수 있습니다. 앱이 보안 이벤트만 스트림에 넣고, 별도 소비자가 서버 전체를 엮어 봅니다.
# 앱: 보안 이벤트가 있을 때만 넣는다(모든 요청이 아니라)
r.xadd("sec-events", {"sub": rec["sub"], "type": ev["type"],
                      "obj": str(ev.get("object", "")), "t": str(rec["t"])},
       maxlen=1_000_000, approximate=True)

# 소비자: 그룹으로 나눠 읽고, 처리한 뒤 확인
r.xgroup_create("sec-events", "correlator", id="$", mkstream=True)
while True:
    for _, entries in r.xreadgroup("correlator", "c1", {"sec-events": ">"}, count=500, block=1000):
        for entry_id, ev in entries:
            correlate(ev)                      # 서비스 여러 개의 같은 주체를 엮는다
            r.xack("sec-events", "correlator", entry_id)
핵심은 모든 요청이 아니라 보안 이벤트만 보낸다는 점입니다. 실험실 2시간 분량 5,373건 중 거부·없음·검증 실패 이벤트가 붙은 요청은 917건(약 17%)이었습니다. 그중 상당수가 공격 트래픽입니다. 운영에서는 정상 요청이 훨씬 많으니 비율은 더 작아집니다. 양이 줄면 Kafka 없이도 버팁니다.
엮은 결과는 다시 결정 API로 돌아갑니다. 앱과 엣지가 같은 결정 저장소(예: Redis의 TTL 키)를 읽으면, 방어선 3의 판단이 방어선 1·2에 바로 반영됩니다.
파이프라인의 지연은 0이 아니다
스트림 경로에는 수집 버퍼, 배치 전송, 소비자 지연이 쌓입니다. 관리형 서비스도 마찬가지입니다. AWS WAF 문서는 비율 기반 규칙이 정밀한 속도 제한용이 아니며, 한도를 넘은 뒤 조치까지 보통 30초 이내, 길게는 몇 분이 걸릴 수 있다고 적습니다.
이 시리즈는 OTel → Vector → Kafka → 소비자 전체 경로의 끝에서 끝까지 지연을 재지 않았습니다(【작성자 실측】 필요). 도입한다면 "이벤트 발생 시각"과 "결정 적용 시각"을 함께 남겨 직접 재세요.
고르는 순서
- 앱 하나, 서버 몇 대: 앱 안 + 공유 Redis(방어선 1). 파이프라인 없음.
- 서비스 여러 개: 보안 이벤트만 Redis Streams나 관리형 큐로 모아 소비자 하나가 엮기.
- 이미 로그 플랫폼이 있다: 그 플랫폼(SIEM, ClickHouse 등)에 보안 이벤트를 넣고 예약 검색으로 느린 공격 보기.
- 초당 수십만 이벤트, 복잡한 상관 규칙: Kafka + Flink.
정리
- 파이프라인은 지연 예산으로 고릅니다. 즉시 막을 것은 앱 안(밀리초), 여러 서버를 엮을 것은 스트림(초~분), 느린 공격과 조사는 배치(분~시간).
- 모든 요청이 아니라 보안 이벤트만 보내면 파이프라인이 훨씬 작아집니다.
- Redis Streams로 작게 시작할 수 있습니다. Kafka와 Flink는 규모가 필요할 때 고릅니다.
- 파이프라인 경로의 지연은 직접 재야 합니다.
출처와 확인 날짜
모든 링크는 2026-10-30에 확인했습니다.
- Vector Kafka 싱크: https://vector.dev/docs/reference/configuration/sinks/kafka/
- Vector Redis 싱크(list, channel, sortedset): https://vector.dev/docs/reference/configuration/sinks/redis/
- Fluent Bit Kafka 출력: https://docs.fluentbit.io/manual/data-pipeline/outputs/kafka
- Flink 윈도우: https://nightlies.apache.org/flink/flink-docs-stable/docs/dev/datastream/operators/windows/
- Flink 시간과 워터마크: https://nightlies.apache.org/flink/flink-docs-stable/docs/concepts/time/
- Redis Streams: https://redis.io/docs/latest/develop/data-types/streams/
- AWS WAF 비율 기반 규칙 주의 사항: https://docs.aws.amazon.com/waf/latest/developerguide/waf-rule-statement-type-rate-based-caveats.html
- OpenTelemetry HTTP 규약: https://opentelemetry.io/docs/specs/semconv/http/http-spans/
- 앱 안 지연 수치: 실험실
lab/results/bench-*.json(2026-10-30 실행, 15편)
이전 글 방어선 2-②: IP 평판·위협 인텔리전스의 쓸모와 한계
다음 글 eBPF는 무엇을 잘하나: HTTP 탐지가 아니라 런타임 보안
시리즈 전체 목록 해킹 시도를 몇 초 안에 잡는 서버 전체 목록
