데이터 행 추출
행단위 데이터 추출
괄호 안에 필요한 데이터 행 작성(슬라이싱 하듯)
df1.iloc[]데이터 정렬
sort_values 사용하여 정렬.
by 다음에 원하는 컬럼명 적고 내림차순을 원하면 ascending=False 작성
df1.sort_values(by='소계(발생)', ascending=False)여러개의 조건으로 정렬할 때
df1.sort_values(by=['소계(발생)','소계(검거)'], ascending=[False,True])정렬 후 위에서부터 10개만 출력
df1.sort_values(by=['소계(발생)','소계(검거)'], ascending=[False,True]).iloc[:10]데이터 필터
범주형 데이터의 경우
df1['살인(발생)'].value_counts()

살인(발생)
3      7
2      4
1      3
5      3
4      3
7      3
8      2
10     2
163    1
14     1
13     1
9      1
11     1
Name: count, dtype: int64
원하는 조건 저장
cond1 = (df1['살인(발생)']==3)살인(발생)이 3건인 7개의 행만 선택되어 출력됨.
df1.loc[cond1]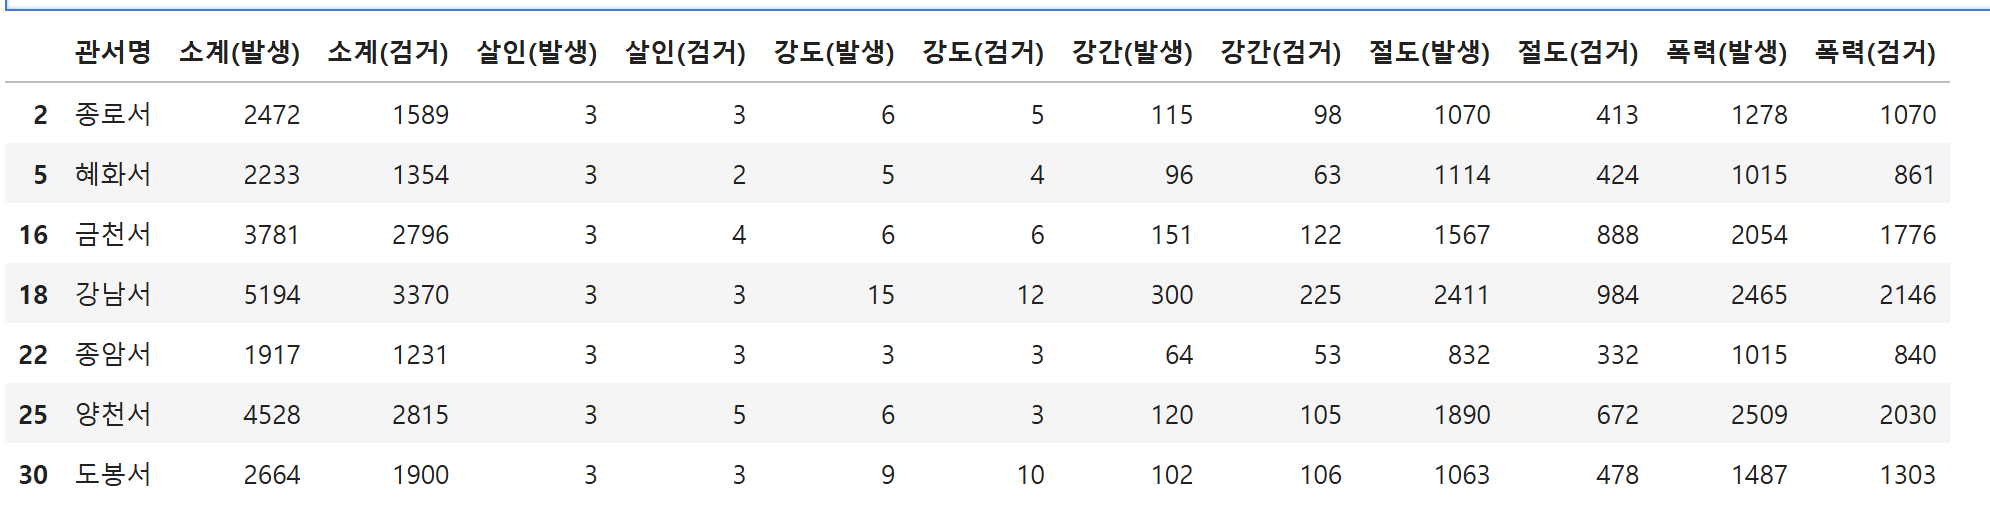
cond1과 반대되는 데이터 출력 (살인(발생)이 3건이 아닌 데이터)
df1.loc[~cond1]조건에 2개일때 필터링하기
살인(검거)컬럼 확인
df1['살인(검거)'].value_counts()각각 cond1, 2로 변수 저장 후 loc로 불러오는데, and구문을 &로
살인발생 3건이면서 검거는 2건인 경우 필터링
cond1 = (df1['살인(발생)']==3)
cond2 = (df1['살인(검거)']==2)
df1.loc[cond1 & cond2]
|를 사용하면 or조건
df1.loc[cond1 | cond2]결과 저장하기
필요한 조건으로 필터링 완료한 후 새로운 변수에 저장하여, to_csv로 저장
cond1 = (df1['살인(발생)']==3)
cond2 = (df1['살인(검거)']==2)
df3 = df1[cond1 & cond2]
df3.to_csv('result.csv')
한글파일이 깨지지않게 하려면?
df3.to_csv('result.csv', encoding='cp949')
화이팅