Database
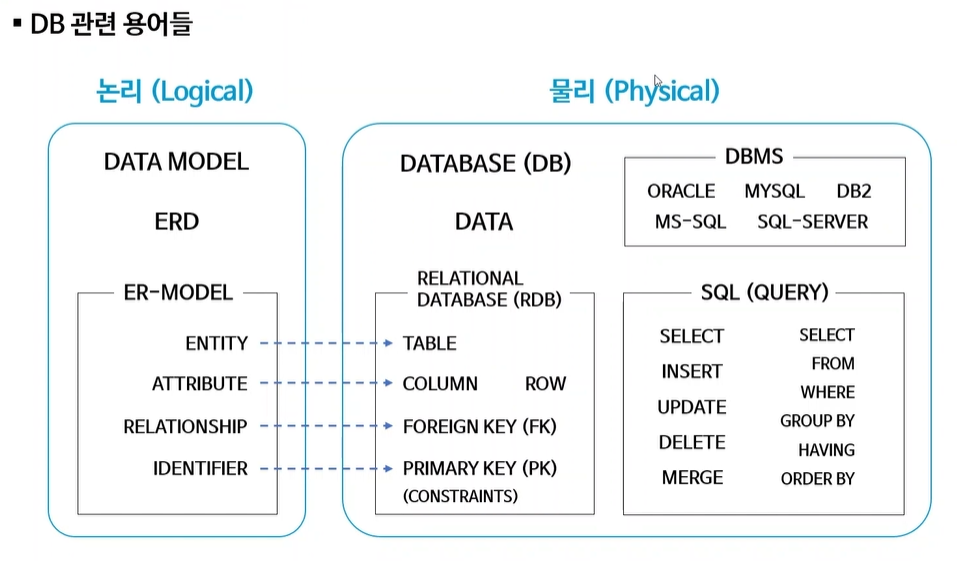
물리적관계(Physical) : 물리적관계는 실체가 있는 것
논리적관계(Logical) : 논리적관계는 물리적관계를 만들기 전 설계단계
Database?
: 데이터베이스는 파일이다. 잘 저장하기 위해서 데이터베이스를 사용하고, 데이터를 효율적으로 관리하기 위해서 데이터들 사이에서 관계를 맺어둔 파일이다.
Database의 특징
-
자료추상 : 자료를 추상적으로 저장한다. 즉,공통적인것, 비슷한 것만 저장한다.
ex) 이름: 심준보, 나이: ? , 성별: 남, 키: 176, 몸무게: 65kg, 손톱길이: 0.3cm, 안경착용 : 유한 사람의 정보를 저장하고, 다른 사람들의 정보를 저장하려고 한다. 이럴때 이런 디테일한 정보들을 저장하기 어렵다. 공통적인 성질들만 뽑아서 대충 저장하자 라고 하는 것이 데이터베이스의 특징인 자료추상이다.
NoSql은 저런 디테일한 정보까지 저장하자!
-
자료독립 : 데이터와 프로그램의 독립성을 유지. 데이터와 데이터를 사용하는 프로그램이 독립적이다. 데이터의 형태가 아무리바껴도 프로그램이 바뀔필요가 없다. 프로그램이 바뀌어도 데이터의 형태가 바뀔필요가 없다.
ex) 데이터와 프로그램의 독립성이 유지되지 않는다면?
자료를 pdf로 다 뿌렸는데 자료를 pptx로 바꾼다면? 자료를 보기위해 프로그램을 새로 깔던가 방법을 바꾸어야한다. -
자기정의 : 자료의 구성과 내용을 DB자신이 저장 및 관리. 데이터는 엑셀처럼 표로 저장하는데, 자기자신을 구성하는 정보나 형식같은 것들도 자기자신이 정의를 하고있다.
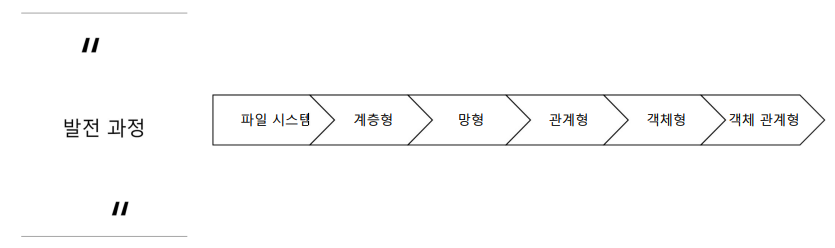
파일시스템 : 파일은 HDD에 저장된다. 파일을 효율적으로 쓸수있게 해주는것이 파일시스템
계층형 : 폴더형태가 계층형이다. 리눅스의
관계형 : 가장 많이 사용하고 있다.
파일시스템 안에다가 데이터베이스 파일을 만들어서 관리하는데 관계형으로 관리를 한다.
DBMS(Database Management System)
데이터베이스 파일을 열어서 볼 수 있는, 또는 관리하는 프로그램을 DBMS라고 한다. 데이터베이스 서버이다. 데이터베이스 서비스를 제공하는 프로그램인 것.
DBMS의 종류
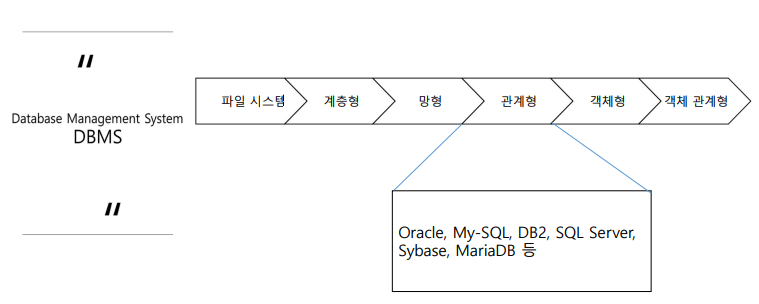
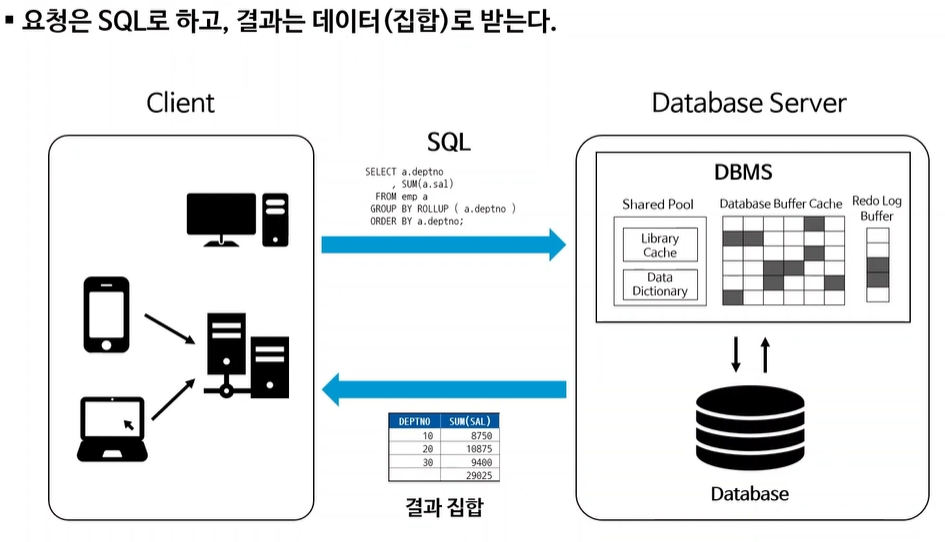
클라이언트에서 SQL문으로 DBMS라고 불리는 소프트웨어에 요청을 보내고 DBMS에서 데이터를 찾아 결과를 다시 클라이언트에 보내준다.
Data Modeling
사람정보를 어떻게 데이터베이스에 저장하지? 공통적특징을 어떻게 뽑아서 저장하지 했을때, 현실세계의 데이터 구조를 데이터 구조로 저장시키는 중간과정.
현실세계의 데이터 구조를 데이터구조로 기술한다 -> 객체지향과 비슷한 개념.
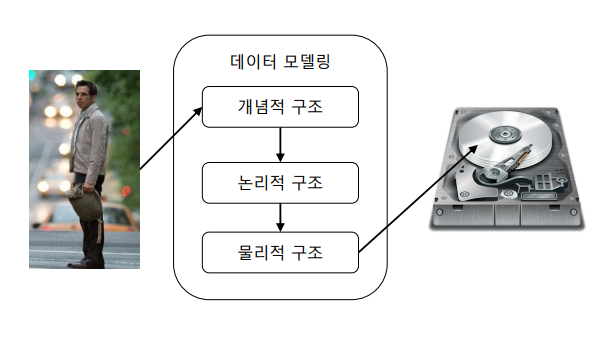
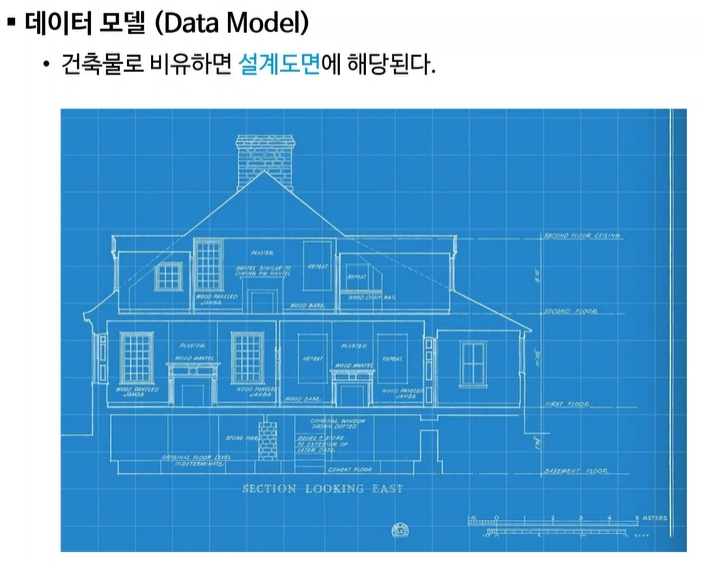
DataBase : "건축물"
Data Model :
"건출물"을 짓기 위한 "설계도면".
현실세계를 database로 구축할 수 있도록 "추상화"한것
추상화: 어떤 것을 뽑아서 단순화 시킨 것
- 복잡한 현실세계(기업의 비지니스)를 약속된 표기법에 의해 단순화시켜 표현함
- database에 저장하기 위해 애매모호함을 제거하고 명확화하여 기술
Data Modeling :
현실세계를 약속된 표기법에 의해 표현하는 과정
database를 구축하기 위한 분석/설계의 과정분석 :
비지니스를 분석하는 것
1. 데이터베이스가 없는 새로운 시스템을 만드는 경우
2. 데이터베이스가 있고, 기존 데이터베이스를 분석해서 새로 넘어가는 경우(어느정도 규모가 있는 회사의 경우, database는 존재하고 있다 기존의 database를 분석해서 새로운 database로 바꾸는 경우(AS-IS : 기존database/To-BE : 새로만들 database / As-Is DB를 먼저 분석해서 기존의 database의 구조를 파악하고 추가적 비지니스구조를 파악해서 To-Be DB 설계 단계로 넘어간다.)
Data Modeling 이해관계자
: Data Modeling 과정에 참여하는 사람들

데이터모델러 : 데이터모델링의 전문지식을 가지고 직접 설계하는 사람(외부 컨설팅 또는 기업내부)
실무담당자 : 비지니스를 가장 잘 알고 있는 사람. 데이터모델러에게 잘 설명해줄 수 있는 사람
애플리케이션 개발자 : 데이터모델기반으로 데이터베이스가 만들어지면 그것을 사용해서 IT시스템을 만드는 사람(SQL을 가장 많이 사용하는 사람)
DBA(DB관리자) : 데이터모델기반으로 데이터베이스가 만들어지면 DB를 전문적으로 관리해주는 사람
설계과정
-
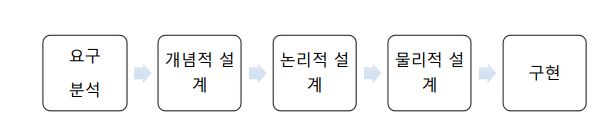
요구분석 : 이커머스를 예로 들면 상품저장, 회원기능, 회원구매내역, 등 어떤것이 필요한지를 분석. 정답이 없고, 고객이 요구하면 미팅을 통해서 요구를 분석한다.
요구분석의 결과물 : 요구사항명세서(글) -
개념적 설계 : 데이터를 구조화, 정형화 시키기 위해 추상적인 개념으로 표현하는 과정. 비지니스에서 가장 중요한 핵심 비지니스만 뽑아서 간단하게 표현하는 것. 추상화 수준이 높은 단계인데 추상화 수준이 높다는 말은 간략화를 많이 시킨다는 의미. 주문을 저장할때 어떤걸 넣어야 좋은지 설계하고 주문은 관계, 사용자, 고객은 NTT 등 그림으로 만들어서 다이어그램으로 표현함.
개념적설계의 결과물 : ER다이어그램(글을 그림으로 표현)
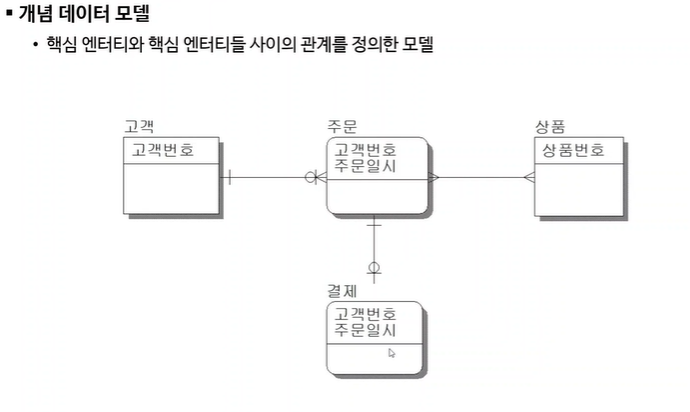
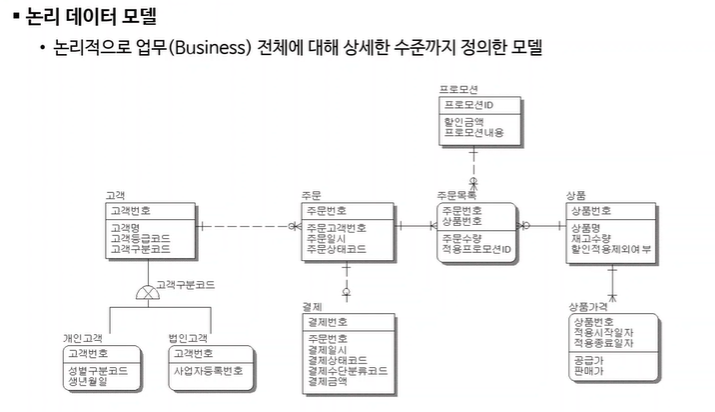
- 논리적 설계: 본격적인 설계단계. Entity, 속성, 관계, 식별자(데이터모델요소들) 등을 정의함으로써 데이터 구조를 논리적으로 구체화하는 과정.전체 비지니스가 다 드러나야함.
논리적설계 결과물 : 릴레이션스키마, 데이터타입, 길이, null값 허용여부, 기본값, 제약조건 등을 세부적으로 결정.
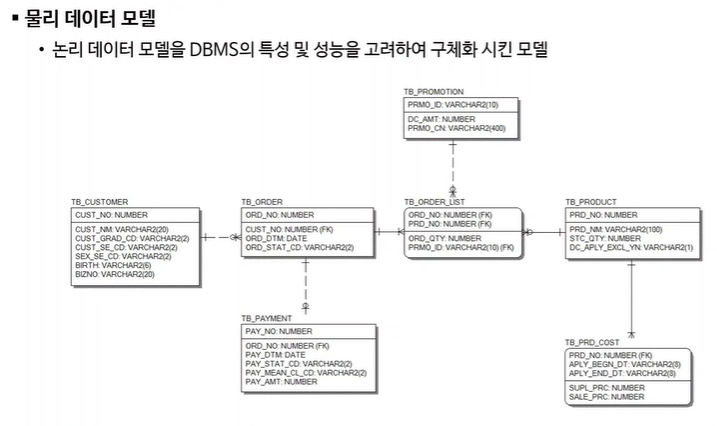
- 물리적 설계: HDD나 OS의 특성을 고려해 인덱스 구조나 내부저장구조등에 대한 물리적 구조를 설계. 서버를 몇개를 쓸건지 등 DBMS가 결정되는 단계가 물리적 데이터를 설계하는 과정에서 결정된다.
물리적 설계 결과물 : 물리적스키마
- 구현 : SQL을 사용하여 DBMS를 통해 실제DB를 만드는 과정
Data Modeling의 요소들
1.Entity
2.관계(Relationship)
3.속성(Attribute)
Entity(실체,객체)
- database에 정보로써 저장될 수 있는 사람, 사물, 개념, 행위 등의 실체. 업무상 필요하고 관리하고자 하는 대상으로써 그 대상들 간에 동질성을 지닌 개체 집합(공통적 특징들을 가지고있는 여러가지를 묶은것) 이나 그들이 행하는 행위의 집합
동질성 : 개체들이 가지고 있는 공통적 특징들 / 범위를 어디까지 한정할 것 인지에 따라 달라질 수 있다.
ex) '고객' = '상품구매이력이 있는 개인이나 법인'으로 정의한다면
잠재고객, 단체 등은 고객이 될 수 없다.
집합 : 원소들의 모임
ex) 우리의 재화나 서비스를 사용하는 고객, 판매하는 상품

- 개념들도 Entity로 정의할 수 있는데, 실제로 만질 수 없지만, 머리로 떠올리면 알 수 있는 것들을 일컫는다. 조직도, 할인, 프로모션, 이벤트를 예로 들 수 있다. ex)프로모션
- 행동들도 데이터로 쌓일 수 있으므로 Entity로 정의한다. ex)결제
Supertypes / Subtypes Entity
- Supertypes Entity : 개체들이 일반화 과정에서 생성되는 상위집합
- SUbtypes Entity : 특정 기준에 따라 상세화된 개체들의 부분집합(Supertypes의 모든 공통속성을 상속 / 개별속성을 가질 수 있음)

관계(Relationship)
Entity와 Entity 간의 논리적인 상호연관성(양쪽에서 연관성이 있어야한다). 실제로는 Entity(여러개가 모여있는 집합)내에 있는 개체간의 논리적인 연관성이라고 할 수 있다.

ex) 고객과 상품간의 관계가 있다라고 본다면, 구매하다 라는 관계가 있는것. 빈정욱고객이 버거, 튀김, 콜라를 다 구매하고, 황진영고객이 핫도그, 사이다를 구매하는 등의 개체간의 연관성이 있지만, 설계단계에서는 '고객이 상품을 구매한다.' 라는 큰 묶음으로 보는 것.
관계라는 요소를 나타날때는 크게 두가지로 나뉜다.
- 관계차수(Cardinality) : 두 Entity간의 관계에서 참여자(개체)의 수를 표현한것
ex) 1:1, 1:n, n:n- 선택성(Optionality) : 두 Entity간의 관계에서 개체들의 필수/선택 참여 여부를 표현한 것.
ex) 필수참여, 선택참여
Attribute(속성)
- 개체집합이 가지고 있는 특징이나 성질
- Entity에 표현되는 구체적인 정보항목
ex)고객이 있다면 고객의 어떤정보를 관리할 것인지 구체적인 정보들

- 의미적으로 더 이상 분리되지 않는 최소의 데이터단위 -> 비지니스마다 최소의 데이터단위가 바뀔 수 있다.
ex) - 공공기관 행정 DB : 시도, 시군구, 읍면동 (ex. 서울시, 송파구, 잠실2동) -> 행정단위가 중요하기 때문에 행정단위별로 통계를 내거나 action이 생기는 경우가 많기 때문에 시, 구, 동 을 다 짤라서 보관한다.
- 온라인 쇼핑몰 DB : 우편번호, 상세주소(ex. 05501, oo아파트 oo동 ooo호) -> 배송단위의 경우 시,구,동을 굳이 다 짤라서 보관할 필요가 없다.
- 의미적으로 더 이상 분리되지 않는 최소의 데이터단위 -> 비지니스마다 최소의 데이터단위가 바뀔 수 있다.
식별자(Identifier) - 속성에 포함되어있음
- Entity의 각 개체를 유일하게 식별할 수 있는 속성들의 조합.
ex)
고객을 각각 구분한다고 했을때, 고객데이터가 무수히 많을지라도 고객데이터 하나를 끄집어낼 수 없으면 쓸모가없다. 따라서 데이터 하나하나를 구분하기 위해서 필요한 속성이 식별자속성이다.

식별자의 특징
- 유일성 - 하나씩 식별할 수 있는 것
- 최소성 - 데이터를 식별할 수 있는 여러속성을 최소한으로 두는 것
- 불변성 - 식별자 속성을 가급적 변하지 않아야한다.
- 존재성 - 데이터가 다 존재해야한다.
식별자의 분류
- 주식별자 - 데이터를 각각 구분할 수 있는 식별자
- 보조식별자 - 데이터를 식별할 수 있지만 주식별자는 아닌 식별자
- 단일식별자 - 하나의 속성으로만 이루어져있는 식별자 ex) 주문번호
- 복합식별자 - 여러속성을 조합해 이루어져있는 식별자 ex) 주문일자+고객번호+주문순번
- 본질식별자 - 우리의 비지니스에서 항상 쓰이고 있는, 원래 쓰고 있었던 속성들로 사용하는 식별자
- 인조식별자 - 하나하나 식별하기 위해서 번호를 부여하거나 ID를 부여하는 것
식별관계 vs 비식별관계
- 식별관계 : 부모 Entity의 식별자 속성을 자식Entity의 식별자 속성으로 가지는 관계 / 밀접한관계

-> 고객이 1 고객연락처가 n 즉, 이 둘은 1:N 관계이다. 따라서 고객을 부모Entity, 고객연락처를 자식Entity라고 할 수 있다. 여기서 부모Entity의 속성을 자식Entity에서도 속성으로 가지면 식별관계.
- 비식별관계 : 부모 Entity의 식별자 속성을 자식Entity의 일반속성으로 가지는 관계 / 느슨한관계

-> 고객, 거래처를 부모Entity, 연락처를 자식Entity라고 했을때, 자식Entity에서 부모Entity의 속성을 식별자가 아니라 일반속성으로 가지게 되면 비식별관계.
데이터 모델 읽는 방법
ERD표기법
ERD가 데이터모델과 같은말이다.

Supertypes/Subtypes 표기법

exclusive - 부분집합들 사이에 겹치는 부분이 없다 배타적이다 라는 뜻
inclusive - 부분집합들 사이에 겹치는 부분이 존재할 수 있다는 뜻
관계표기법

-
관계종류(식별관계)

-
관계읽기 (I/E표기법)


정규화(Normalization)
- 기업에서 사용하는 database 즉, 관계형 database의 근간이 되는 이론.
정규화 & 반정규화
1. 정규화
정규화 : 데이터의 중복최소화, 이상현상(데이터가 이상하게 변질되는 현상)이 발생하지 않도록 함수종속을 기반으로 연관성있는 속성들로만 Entity를 구성하는 과정.
이상현상 : 데이터가 이상하게 변질되는 현상. 불필요한 데이터중복으로 인해 데이터의 삽입/갱신/삭제 시 발생하는 이상현상.
함수종속 : 한 Entity내에서 특정속성의 값을 알게되면 다른속성들의 값이 저절로 결정될때, 기준이 되는 속성을 결정자속성(== 식별자속성), 결정자에 의해 정해지는 속성을 종속자 속성.
ex) 고객번호, 고객명, 성별, 생년월일

정규화 - 정규화를 하는 과정
정규형 - 정규화를 하는 과정을 통한 결과
비정규형 - 정규화가 전혀 되어있지 않은 것
잘못된 사례
-
잘못된사례1

-> 업무가 많은 사람인데 업무가 추가되었다고 치면, 테이블의 구조를 계속 확장시켜야한다. 한번설계가 끝난 후 구조를 변경시킨다는 것은 쉽지 않은 일이다. 즉, 유연성이 떨어지는 사례 -
잘못된 사례2

-> 데이터가 아래로 추가되는 것은 정상적인 일. 그렇지만 정보가 하나였던 것이 중복이 되어 3개로 늘어남. 데이터를 수정해야하는 일이 생겼을때 하나만 수정하고 나머지는 수정하지 않는 문제가 생길 수 있다.
그렇다면 올바른 사례는 무엇일까?
제 1 정규형
- 모든 속성의 값이 원자값(Atomic Value)으로만 구성되어있다.

-> 담당업무 테이블을 하나 따로 만들어서 담당업무만 늘어나고 나머지 데이터는 그대로 하나씩 있도록 해준다. 사원구분코드와 사원번호를 가지고 담당업무가 무엇인지 찾아서 데이터를 가져오게한다. 이런 정규화를 마치면 제 1 정규형이 되는 것이다.
-> 문제점 : 사원구분명은 사원번호가 바뀐다고 해서 바뀌지 않는다. 사원구분코드가 사원구분명을 결정한다. 사원구분명도 특정정보만 바꾸고 나머지를 건들지 않으면 사원구분코드인 01의 의미가 다 변하게 된다. 어떻게 하면 좋을까 -> 2차정규화로 쪼개준다.
제 2 정규형
-
2차정규화의 결과
-
주식별자가 아닌 모든 속성이 주식별자 속성에 완전 함수 종속된다.
-> 사원구분코드와 사원번호 두개가 다 같이 있어야만 나머지 모든 속성을 결정할 수 있다.

-
위의 문제에서 사원구분코드와 사원구분명을 따로 테이블을 만들어준 다음 중복을 제거해버린다. 중복되는 데이터가 1개로 합쳐진다. 사원구분코드당 사원구분명 하나인 데이터로 관리가 가능해진다.
-
여기도 문제점을 발견할 수 있는데 부서번호를 보면 부서번호가 부서명과 부서위치를 결정하는 주식별자이다. 어떻게 하면 좋을까?
제 3 정규형
-
일반 속성들 간에 함수종족이 존재하지 않는다.
-
주식별자가 아닌 일반 속성들 간에 종속관계가 존재하면 안된다. 그런데 부서번호가 부서명과 부서위치를 종속시키므로 부서번호, 부서명, 부서위치를 부서테이블로따로 만들어 빼주고 기본 테이블에 부서번호를 남기고 연결고리를 만들어준다. 일반속성들간에 종속관계가 존재해 이를 따로 정규화시키는 것을 제 3 정규화라고 하고 그 결과가 제3정규형이다.

제3차정규화를 거치고 난 후 정규화된 데이터모델

-> 4개로 데이터를 쪼개서 관리하는 것. 제가 필요한 정보가 나뉘어져있다면 SQL로 조회해서 데이터를 가져오는것.
정규형 정리
Entity가 정규화된 정도. 정규화를 통해 해당 단계의 조건을 만족하는 상태
- 제1정규형 : 모든 속성의 값이 원자값(Atomic value)으로만 구성되어있다. 즉, 모든 속성에 다중속성값이 존재하지 않는다.
- 제2정규형 : 주식별자가 아닌 모든 속성이 주식별자 속성에 완전 함수종속된다. 즉, 부분적 함수종속이 존재하지 않는다.(식별자 일부에만 종속하지 않는다.)
- 제3정규형 : 일반속성들 간에 함수종속이 존재하지 않는다. 즉, 이행적 함수종속이 존재하지 않는다.(식별자가 종속시키고, 일반속성이 다른속성을 종속시키지 않는상태)

그렇다면 제3차정규화까지 거쳐 제3정규형을 만들어놓고 반정규화를 하는 것일까?
2. 반정규화(De-Nomarlization)
-
정규화된 Entity, 속성, 관계에 대해 시스템의 성능향상과 개발과 운영의 단순화를 위해 중복, 통합, 분리등을 수행하는 데이터 모델링의 기법 -> 특정한 상황에서만 사용하는 것.
- Entity(테이블) 반정규화, 속성(칼럼) 반정규화(일반적인 반정규화과정), 관계 반정규화

-> 주문수량과 상품단가를 곱하면 주문총금액을 구할 수 있지만, 주문테이블에 따로 속성으로 넣은 이유는 속도때문이다. 성능향상 때문에 반정규화를 하는 경우가 많다. -
반정규화를 남용하게되면 시스템 전반적으로 데이터 무경성이 깨질 위험이 있으므로, 꼭 필요한 경우에만 적용해야하며 데이터 정합성을 지키기 위한 별도의 방안을 마련해야한다.
실습

Entity 도출
1. 학적
2. 학부생, 대학원생, 졸업생
3. 자료(학술자료 및 미디어자료)
4. 관련키워드
5. 자료관리대장


- 속성도출
초록색 - 속성
파란색 - Entity

- 관계 및 식별자 도출
빨간색 - 식별자
노란색 - 관계
중간에 관계를 관리해줄수 있는 자료관리대장테이블이 추가되어야한다.
M:M관계 일때 1:M 그리고 1:M 으로 나누어서 표현할 수 있다.


-슈퍼타입 / 서브타입으로 표현한다면

관계형 Database
- 초기에는 파일시스템으로 데이터를 관리했다. 하지만 데이터가 증가함에 따라 데이터를 효율적응로 관리할 수 있는 체계가 필요해졌다.
- 관계형 데이터베이스는 정규화를 기반으로 한 데이터 모델링을 통해 데이터 이상현상을 제거하고 데이터중복을 최소화해 데이터를 저장한다. DBMS의 발전으로 동시에 데이터를 공유하고 조작할 수 있게 되었다. 관계형 데이터베이스의 데이터를 다루는 유일한 언어가 SQL이다.
데이터 모델링의 결과물인 ERD를 기반으로 관계형 database가 구축된다.

관계형 database의 요소들
1. 테이블
데이터를 저장하기 위한 2차원 구조의 객체. Column과 Row로 이루어짐. 엑셀을 생각하자!
- Entity가 물리적으로 구현된 것. 관계형 database의 가장 기본적 구성요소
- Column (열): 속성이 물리적으로 구현된것. 테이블의 세로구조
- Row (행) : 테이블에 저장된 개별데이터. 테이블의 가로구조 데이터 조회 및 조작의 대상

2. 제약조건
특정조건을 위반하는 데이터가 입력되지 않도록 제한하는 DBMS의 기능
- PK(Primary Key) : 동일한 값 or NULL값이 입력되지 X
- FK(Foreign Key) : 부모테이블에 없는 데이터는 자식테이블에도 데이터가 없도록 하겠다 라는 의미. 두 테이블이 있고, 1:N관계라고 했을때, 1이 부모테이블 N이 자식테이블이라고 가정하자. 1이라는 의미는 데이터가 1개만 존재한다는 뜻이고, N쪽은 연관된 데이터가 여러개 존재한다는 의미이다. 그러므로 오른쪽테이블이 부모테이블, 왼쪽테이블이 자식테이블이다.

3. SQL(Structured Query Language)
- 관계형데이터베이스의 표준언어
- 구조적, 집합적, 선언적 : 원하는 결과집합을 구조에 맞춰 질의. 구체적프로세싱과정을 프로그래밍할 필요가 없다.
- SQL문의 종류

세팅 개념 정리
기업에는 Server에 DBMS가 설치되어있고, Database도 Server에 존재한다.
- 개별사용자는 Database Server에 접속하기 위한 Client 프로그램(workbench, oracle)만 설치하면 된다.

- 우리는 개인PC에서 사용해보는 것이라서 따로 서버가 존재하지 않기 때문에 DBMS를 개인컴퓨터에 직접 설치