수포자, 문과, 비상경계 과오 청산(4)
결정 트리란?
결정 트리의 원리
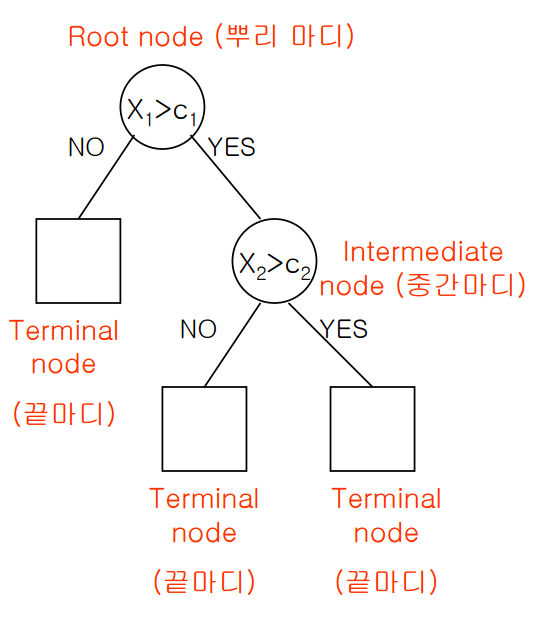
결정 트리(Decision Tree)는 데이터의 특징을 기반으로 의사 결정을 수행하는 트리 구조의 알고리즘이다. 노드는 데이터의 특정 속성을 나타내며, 가지(branch)는 가능한 선택지를 의미한다. 처음 분류 기준 (즉, 첫 질문)을 Root Node라고 하고, 맨 마지막 노드를 Terminal Node 혹은 Leaf Node라고 한다.
정보 이득, 엔트로피, 지니 불순도 개념
결정 트리는 데이터를 분할할 때 정보 이득(Information Gain), 엔트로피(Entropy), 그리고 지니 불순도(Gini Impurity) 개념을 활용한다.
-
불순도(Impurity): 해당 범주 안에 서로 다른 데이터가 얼마나 섞여 있는지를 뜻한다. 설탕 통에 소금이 많이 섞여있다면 불순도가 높은 거고, 설탕만 들어있다면 불순도가 낮은 것처럼 말이다. 결정 트리는 불순도를 최소화(혹은 순도를 최대화)하는 방향으로 학습을 진행한다.
-
엔트로피: 데이터의 불순도를 측정하는 지표로, 값이 낮을수록 데이터가 더 균일하게 분포되어 있음을 의미한다. 엔트로피의 최소값은 0, 최대값은 1이다. 구하는 공식은 다음과 같다.
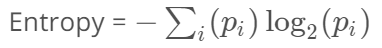
-
지니 불순도: 한 데이터가 특정 클래스로 분류될 확률을 계산하여 불순도를 측정한다.
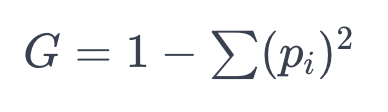
계산이 상대적으로 단순하여 많은 결정 트리 알고리즘에서 기본적으로 사용된다. -
정보 획득(Information gain): 분기 처리를 통해 데이터를 분할했을 때 줄어든 엔트로피의 양을 의미한다.
트리 깊이와 과적합 문제
트리가 너무 깊어지면 학습 데이터에 과적합(overfitting)할 가능성이 높아진다. 이를 방지하기 위해 다음과 같은 방법을 사용한다.
- 최대 깊이 제한: 트리의 깊이를 제한하여 복잡도를 조절한다.
- 가지치기(Pruning): 정보 이득이 낮은 노드를 제거하여 트리의 복잡성을 줄인다.
- 최소 샘플 수 지정: 노드가 분할되기 위한 최소 샘플 수를 설정하여 트리 성장을 제한한다.
결정 트리의 장단점
장점
- 이해하기 쉽고 시각적으로 표현 가능
- 연속형 및 범주형 데이터 모두 처리 가능
- 피처 스케일링이 필요하지 않음
단점
- 데이터가 적을 경우 과적합 위험
- 작은 변화에도 트리 구조가 크게 변할 수 있음
랜덤 포레스트란?
랜덤 포레스트의 원리
랜덤 포레스트(Random Forest)는 여러 개의 결정 트리를 결합하여 성능을 향상시키는 앙상블 학습 기법이다. 여러 개의 트리를 훈련한 후 평균을 내어 예측 성능을 높인다.
특징 랜덤화와 배깅
랜덤 포레스트는 각 노드에서 무작위로 선택된 특징 부분집합만을 고려하여 분할하는 특징 랜덤화(Feature Randomness) 기법을 사용한다. 이는 트리 간의 상관성을 줄이고, 모델의 다양성과 일반화 능력을 높이는 데 기여한다.
또한, 랜덤 포레스트는 배깅(Bagging) 기법을 활용하여 데이터 샘플을 무작위로 추출하여 각각의 트리를 독립적으로 학습시킨다. 반면, 부스팅(Boosting)은 이전 모델의 오차를 점진적으로 보완하는 방식이다.
랜덤 포레스트의 중요 변수 선택
랜덤 포레스트는 변수 중요도를 계산할 수 있어, 가장 중요한 피처를 선택하는 데 유용하다. 모델이 각 변수의 기여도를 평가하여 중요한 변수를 식별할 수 있다.
SVM (Support Vector Machine)의 이해
결정 경계와 마진의 개념
SVM은 데이터의 분류를 위한 최적의 결정 경계(Decision Boundary)를 찾는 알고리즘이다. 두 클래스 간의 거리를 최대로 하는 초평면(Hyperplane)을 찾는 것이 핵심 원리이다.
소프트 마진과 C 파라미터
SVM에서는 모든 데이터가 정확하게 분류될 필요는 없다. 이를 위해 소프트 마진(Soft Margin) 개념이 도입되었으며, C 파라미터를 통해 오분류를 어느 정도 허용하는 방식을 조정할 수 있다. C 값이 크면 마진이 작아지고, 작은 값이면 마진이 커져 일반화 성능이 높아진다.
커널 트릭을 활용한 고차원 분류
SVM은 선형적으로 분류되지 않는 데이터를 분류하기 위해 커널 트릭(Kernel Trick)을 사용한다.
- 선형 커널: 데이터가 선형적으로 구분 가능할 때 사용
- 다항식 커널: 다항식 변환을 적용하여 고차원 특징을 반영
- RBF 커널(Gaussian Kernel): 복잡한 비선형 관계를 학습하는 데 유용
PCA (Principal Component Analysis)란?
차원 축소의 필요성
고차원 데이터는 시각화가 어렵고 연산 비용이 크기 때문에 차원을 축소하여 중요한 정보를 유지하면서 계산 효율을 높이는 기법이 필요하다.
주성분 분석 원리와 분산 보존율
PCA는 데이터를 가장 잘 표현하는 새로운 축(주성분, Principal Component)을 찾아 변환하는 방법이다. 공분산 행렬을 기반으로 고유벡터를 계산하여 데이터의 주요 패턴을 파악한다.
분산 보존율(Explained Variance Ratio)은 각 주성분이 전체 데이터의 분산을 얼마나 설명하는지를 나타낸다. 이를 통해 몇 개의 주성분을 선택해야 하는지를 결정할 수 있다.
Python 실습
랜덤 포레스트의 특징 중요도 시각화
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import LabelEncoder
from sklearn.metrics import accuracy_score, confusion_matrix, classification_report

# 타이타닉 데이터셋 로드
url = 'https://raw.githubusercontent.com/datasciencedojo/datasets/master/titanic.csv'
data = pd.read_csv(url)

# 데이터 전처리
data.drop(['Name', 'Ticket', 'Cabin'], axis=1, inplace=True)  # 불필요한 열 삭제
data['Age'].fillna(data['Age'].mean(), inplace=True)  # 결측값 대체
data['Embarked'].fillna(data['Embarked'].mode()[0], inplace=True)  # 결측값 대체

# 범주형 데이터 인코딩
label_encoders = {}
for column in ['Sex', 'Embarked']:
    le = LabelEncoder()
    data[column] = le.fit_transform(data[column])
    label_encoders[column] = le

# 특징과 라벨 분리
X = data.drop('Survived', axis=1)
y = data['Survived']

# 학습 데이터와 테스트 데이터 분리
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

# 랜덤 포레스트 모델 생성 및 학습
rf = RandomForestClassifier(n_estimators=100, random_state=42)
rf.fit(X_train, y_train)

# 테스트 데이터 예측
y_pred = rf.predict(X_test)

# 정확도 및 성능 평가
accuracy = accuracy_score(y_test, y_pred)
print(f'Accuracy: {accuracy:.2f}')
print('Classification Report:')
print(classification_report(y_test, y_pred))
print('Confusion Matrix:')
print(confusion_matrix(y_test, y_pred))

# 특징 중요도 추출
importances = rf.feature_importances_

# 특징 중요도를 내림차순으로 정렬
indices = np.argsort(importances)[::-1]

# 특징 중요도 시각화
plt.figure(figsize=(10, 5))
plt.title("Feature Importance in Random Forest Model")
plt.bar(range(X.shape[1]), importances[indices], align='center')
plt.xticks(range(X.shape[1]), indices, rotation=90)
plt.xlabel("Feature Index")
plt.ylabel("Importance Score")
plt.show()
SVM을 적용한 이미지 분류 예제
import matplotlib.pyplot as plt
from sklearn import datasets
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.svm import SVC
from sklearn.metrics import accuracy_score, classification_report, confusion_matrix

# 데이터 로드
digits = datasets.load_digits()

# 특징과 라벨 분리
X = digits.data
y = digits.target

# 학습 데이터와 테스트 데이터 분리
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

# 특징 스케일링
scaler = StandardScaler()
X_train = scaler.fit_transform(X_train)
X_test = scaler.transform(X_test)

# SVM 모델 생성 및 학습
svm = SVC(kernel='linear')
svm.fit(X_train, y_train)

# 테스트 데이터 예측
y_pred = svm.predict(X_test)

# 정확도 및 성능 평가
accuracy = accuracy_score(y_test, y_pred)
print(f'Accuracy: {accuracy:.2f}')
print('Classification Report:')
print(classification_report(y_test, y_pred))
print('Confusion Matrix:')
print(confusion_matrix(y_test, y_pred))

# 예측 결과 시각화
fig, axes = plt.subplots(2, 5, figsize=(10, 5))
axes = axes.flatten()
for i, ax in enumerate(axes):
    ax.imshow(X_test[i].reshape(8, 8), cmap='gray')
    ax.set_title(f'Prediction: {y_pred[i]}')
    ax.axis('off')
plt.show()
PCA를 적용한 데이터 시각화
import matplotlib.pyplot as plt
from sklearn.decomposition import PCA
from sklearn.datasets import load_iris
from sklearn.preprocessing import StandardScaler

# Iris 데이터셋 로드
iris = load_iris()
X = iris.data
y = iris.target

# 특징 스케일링
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)

# PCA 적용 (2개의 주성분으로 차원 축소)
pca = PCA(n_components=2)
X_pca = pca.fit_transform(X_scaled)

# 시각화
plt.figure(figsize=(8, 6))
scatter = plt.scatter(X_pca[:, 0], X_pca[:, 1], c=y, cmap='viridis', alpha=0.7)

# 범례 추가
legend1 = plt.legend(*scatter.legend_elements(), title="Classes")
plt.gca().add_artist(legend1)

# 제목과 축 레이블 설정
plt.title("PCA Visualization of Iris Dataset")
plt.xlabel("Principal Component 1")
plt.ylabel("Principal Component 2")

# 주성분 축의 중요도 (설명 분산 비율)
explained_variance = pca.explained_variance_ratio_
plt.annotate(f"Explained variance:\nPC1: {explained_variance[0]:.2f}\nPC2: {explained_variance[1]:.2f}",
             xy=(1, 1), xycoords='figure fraction', ha='right', va='top', fontsize=10)

plt.show()
