[Tanstack Query] useMutation 후처리 전략 비교 (Invalidation vs Direct Update vs Optimistic Updates)

팀원들과 프로젝트를 진행하던 중 TanstackQuery의 useMutation으로 create, update, delete 작업을 진행했다. 그렇게 pr을 올리고 받은 리뷰...
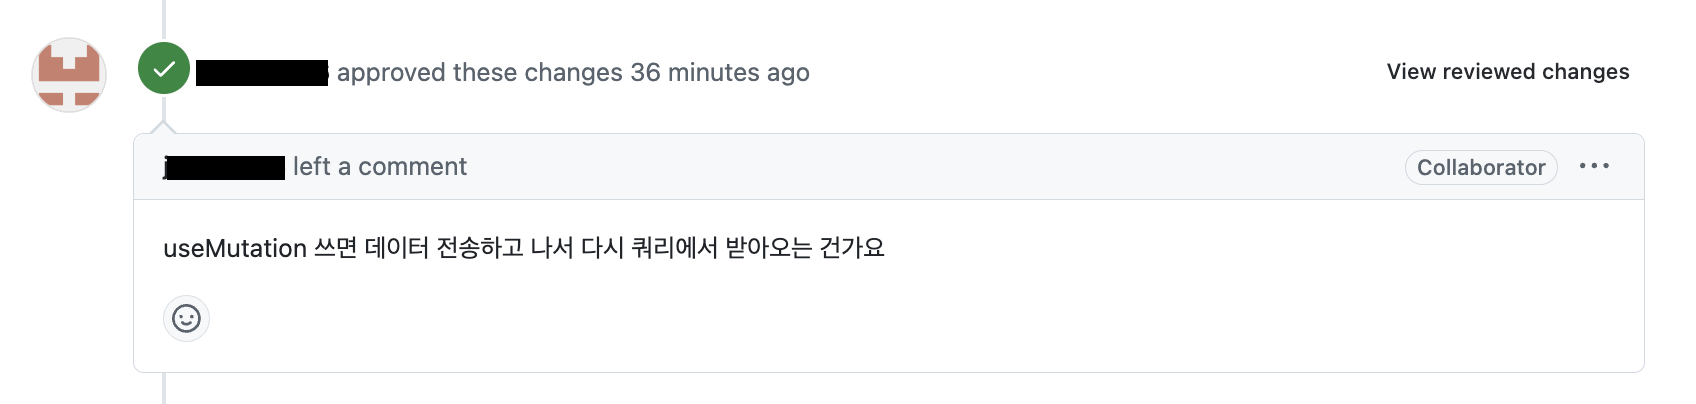
생각해보니, 나 또한 Tanstack Query를 사용하면서 한번도 mutation 이후 처리하는 전략에 대한 고민과 기준을 생각해 본 적이 없어서 이번 기회를 통해 리뷰를 달며 추가적으로 학습하고 정리하는 시간을 가지려고 한다.
useMutation 이후 데이터 상태 관리를 위한 3가지 전략
- Invalidation (무효화)
- Direct Cache Update (캐시 직접 업데이트)
- Optimistic Update(낙관적 업데이트)
내가 알고 있는 크게 3가지의 경우로 나누었고, 각 방식이 어떤 차이점이 있는지 알아보자.
1. Invalidation (무효화)
무효화의 경우, mutation이 성공하면 기존에 있던 데이터를 무효화하고, 해당하는 querykey를 가진 Query를 다시 요청하는 방식이다.
이는 나 외에 다른 사용자들이 동시에 상호작용이 많을 경우 적합하다고 생각한다.
    const queryClient = useQueryClient();

    const { mutateAsync: updateStudent, isPending } = useMutation({
        mutationFn: (formData: StudentType) => {
            return updateStudentAPI(selectedStudent!.userId, formData);
        },
        onSuccess: () => {
            queryClient.invalidateQueries({
                queryKey: ['students', generationId],
            });
        },
    });
위의 코드를 보면, mutation에 성공할 경우, queryClient의 invalidateQueries 메서드를 통해 queryKey를 전달하는 것을 볼 수 있다.
이로 인해 쿼리에 성공하면 해당 queryKey를 가진 쿼리를 서버에 다시 요청하게 되고, 매우 신선한(?) 상태의 보장된 데이터를 얻어 올 수 있게 된다.
이는 사실 Admin 기능에 학생을 관리하는 기능에서 구현된 실제 나의 사례인데, 내가 개발하고 있는 서비스의 Admin은 1명이기 때문에 굳이 무효화를 했었어야 했나? 생각이 든다. 아래의 2번 방법을 보게 되면 이해할 것이다.
Invalidation
장점
- 데이터 정합성 보장
- 다른 유저와 상호작용 많은 기능 시 적합
단점
- 추가 네트워크 요청 발생
2.Direct Cache Update (캐시 직접 업데이트)
캐시를 직접 업데이트 하는 방식은 요청(쿼리)을 다시 보내는가? 보내지 않는가?에 가장 큰 차이가 있다.
1번의 경우 성공할 경우 쿼리를 다시 요청하기 때문에 Create, Update, Delete 작업에 한 번, 다시 새로운 결과를 얻기 위한 Read 작업에 한 번, 총 두 번의 요청을 필요로 하지만,
2번의 경우 캐시를 직접 업데이트 할 경우 mutation 성공의 결과에 따라 성공했을 경우 캐싱된 내용을 서버에 요청을 보내지 않고 동일한 결과를 얻었을 것이므로, 직접 client에서 update하는 것이라고 볼 수 있다.
const mutation = useMutation({
  mutationFn: updateTodo,
  onSuccess: (newTodo) => {
    queryClient.setQueryData(['todos'], (old) => {
      return old.map(todo =>
        todo.id === newTodo.id ? newTodo : todo
      );
    });
  }
});
위의 코드를 보면 queryClient의 setQueryData메서드를 통해 직접 캐싱된 데이터를 업데이트 하는 것을 볼 수 있다.
이를 통해 다른 사용자와 동시다발적으로 CUD 작업을 하는 것이 아니라면, 쿼리를 1번 아낄 수 있기 때문에 다시 쿼리를 보내서 결과를 반영하는데 걸리는 시간을 줄일 수 있어 빠른 UI 반영이 가능하고, 요청하는 물리적인 횟수가 줄어 서버의 부하도 줄일 수 있다.
앞서 언급했던 ADMIN 기능의 경우 다른 사용자와의 상호작용이 있는 페이지가 아니었고, 단순히 ADMIN 혼자서 학생을 관리한 결과만 반영하기 때문에 2번 방식이 더 적절한 사례가 아니었나 다시 한 번 생각해 볼 수 있었다.
Direct Cache Update
장점
- 빠른 UI update
- 서버 부하 감소(쿼리 횟수 절약)
단점
- 다른 사용자의 변경사항을 놓칠 수 있다.
3. Optimistic Update
낙관적 업데이트는 사용자에게 빠른 UI와, 데이터의 정합성을 모두 보장받을 수 있는 방법으로, 주로 좋아요 기능과 같은 실시간 반영에 사용하면 좋다.
전체적인 흐름은 이러하다.
진행중인 쿼리 취소 -> 이전 데이터 캐싱 -> 성공할 것을 예상으로 보낸 요청의 데이터 먼저 UI에 반영 -> 쿼리 결과에 따른 처리
const mutation = useMutation({
  mutationFn: updateTodo,
  onMutate: async (newTodo) => {
    // 낙관적 업데이트
    await queryClient.cancelQueries({ queryKey: ['todos'] });
    const previousTodos = queryClient.getQueryData(['todos']);
    queryClient.setQueryData(['todos'], (old) => {
      return old.map(todo => todo.id === newTodo.id ? newTodo : todo);
    });
    return { previousTodos };
  },
  onError: (err, newTodo, context) => {
    // 실패시 롤백
    queryClient.setQueryData(['todos'], context.previousTodos);
  },
  onSuccess: (serverData) => {
    // 서버 응답으로 최종 업데이트
    queryClient.setQueryData(['todos'], (old) => {
      return old.map(todo =>
        todo.id === serverData.id ? serverData : todo
      );
    });
    // 또는
    // queryClient.invalidateQueries({ queryKey: ['todos'] });
  }
});
위의 코드를 보면 queryClient의 cancelQueries 메서드를 통해 mutation 중에 진행중인 쿼리를 취소한다. 이 후 응답 결과에 따른 작동 방식을 정의한다.
에러가 발생했을 시 저장해 둔 이전 UI 상태를 그대로 돌려 UI를 롤백하는 것을 알 수 있다.
요청 성공 시 서버에서 받은 응답을 기반으로 UI를 다시 그릴 수 있다.
이 때, 나는 궁금한 것이 생겼다.
Tanstack query의 값 비교
만약, 낙관적 업데이트 이후 성공해서 onSuccess가 트리거 되었을 때
1. 낙관적 업데이트 한 데이터와 서버에서 받은 응답이 다른 결과가 나왔다면?
2. 낙관적 업데이트 한 데이터와 서버의 데이터가 같은 결과 값이라도,
무조건 리렌더가 일어나는 것이 아닌가?
어떤 것이 반영되고, 그 결과에 대한 비교는 어떻게 이루어지는가?
해당 질문에 대한 대답을 Claude에게 물어봤다.
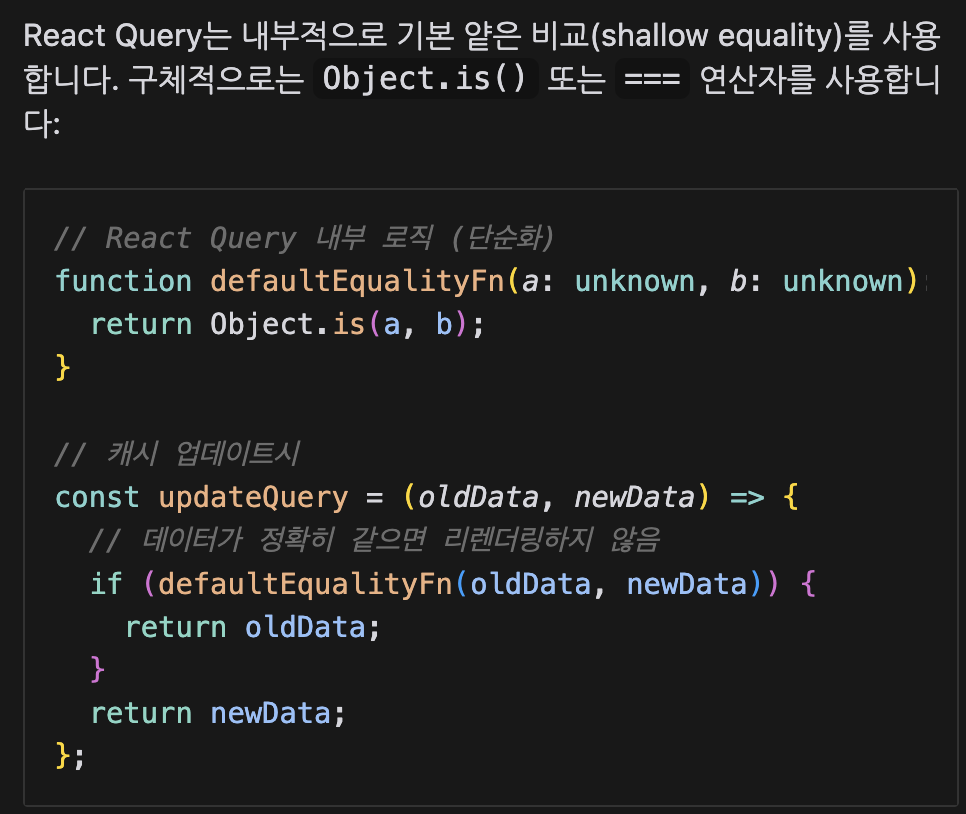
Tanstack Query는 내부적으로 두 데이터 간의 얕은 비교를 통해 데이터가 일치하는지 1차적으로 확인한다. 이를 통해 데이터가 일치할 경우 리렌더를 하지 않으며, 일치하지 않을 경우 Server의 응답을 기준으로 리렌더 한다는 답변을 받았다.
Optimistic Update
장점
- 빠른 UI update
- 데이터 정합성 보장
단점
- 구현 복잡도 증가, 롤백 처리 필요
마무리
팀원의 질문 통해 오늘은 mutation 후 3가지 방법에 대해서 다시 회고해보는 시간을 가질 수 있었다.
내가 사용한 방식을 왜 사용했고, 이를 통해 어떤 결과가 나왔는 지 생각해보는 것은 개발자가 의사결정의 능력을 키우는 면에서 매우 중요한 것이기 때문에, 굉장히 값진 시간이었다고 할 수 있다.