2023/03 에 작성한 글을 옮깁니다.
MySQL을 운영하다 보면 트랜잭션이 어떻게 커밋되고, 복제 환경에서 어떤 흐름으로 데이터가 전달되는지 궁금해질 때가 있다. 이 글에서는 Single DB에서의 2 Phase Commit 구조부터 HA 환경의 Semi-sync 복제, 그리고 복제 안정성을 위한 설정까지 차근차근 살펴본다.
Single DB에서의 2 Phase Commit
MySQL의 트랜잭션 커밋은 단순히 “데이터를 저장한다”는 개념을 넘어서, Binary Log 커밋과 Storage Engine 커밋, 두 단계로 나뉘어 처리된다. 이를 2 Phase Commit(2PC)이라 부른다.
흐름을 순서대로 따라가 보면 다음과 같다. 먼저 Binlog가 스토리지 엔진에 prepare 신호를 보내고, 스토리지 엔진은 prepared 상태를 Binlog에 알린다. 이 시점까지는 언제든지 롤백이 가능하다. 이후 Binlog가 실제로 파일에 기록되는 순간이 커밋의 기준점이 된다. 이 Binary Log 파일 쓰기가 완료되면 해당 트랜잭션은 커밋된 것으로 간주하며, 이것이 Master 레벨의 커밋이다. 마지막으로 스토리지 엔진 커밋이 완료되어야 Slave까지 포함한 완전한 커밋이 이루어지고, 클라이언트에 결과가 반환된다.
핵심은 3번(Binary Log 파일 쓰기)이 커밋 여부를 결정한다는 점이다. 이 이전에 장애가 발생하면 롤백, 이후라면 커밋으로 처리된다. MySQL은 충돌 복구 시 redo log를 활용하며, sync_binlog=1 환경에서는 최신 binlog 파일을 검사해 트랜잭션 xid 값을 수집하고 마지막 유효 위치를 계산하는 과정을 통해 데이터 정합성을 보장한다.
HA 환경과 Semi-sync 복제
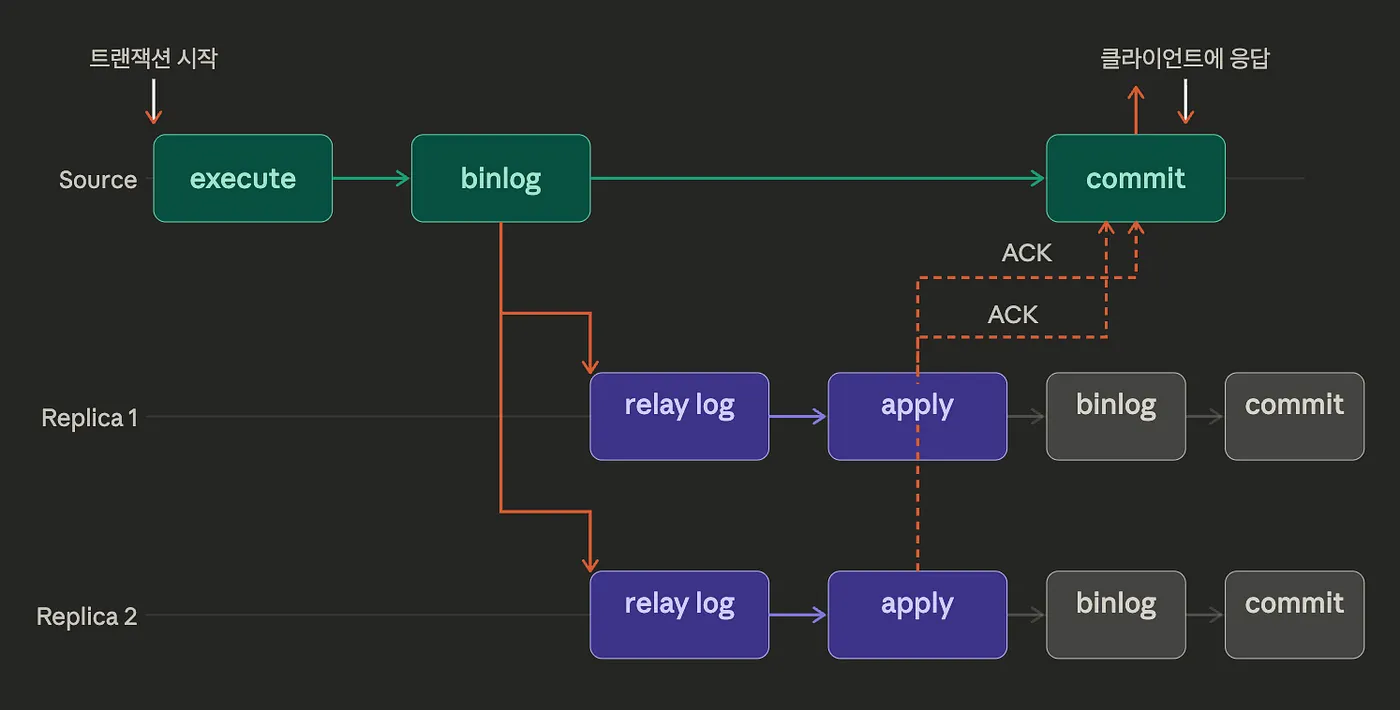
HA 구성에서는 Binary Log가 기록된 이후의 흐름이 중요해진다. Slave의 IO thread가 Master의 Binary Log 이벤트를 감지하면 Relay Log에 기록하고, SQL thread가 이를 읽어 실제 데이터에 반영하는 구조다.
이 과정에서 Semi-sync 복제는 중요한 역할을 한다. Semi-sync의 핵심은 Slave 중 최소 하나가 Binary Log를 수신했다는 ACK를 Master에 보내야 클라이언트에 결과를 반환한다는 것이다. 이를 통해 데이터가 최소 한 곳 이상에 전달되었음을 보장할 수 있다.
다만 Slave의 응답을 무한정 기다릴 수는 없기 때문에, rpl_semi_sync_master_timeout 값만큼 대기한 뒤 응답이 없으면 비동기(async) 모드로 전환된다. Slave가 과부하 상태일 때는 ACK가 늦어지고, 이것이 Master에 지연을 유발할 수 있다는 점을 운영 시 주의해야 한다.
ACK를 기다리는 시점: AFTER_SYNC vs AFTER_COMMIT
Semi-sync에서 ACK를 기다리는 위치는 rpl_semi_sync_source_wait_point 파라미터로 결정된다. 기본값인 AFTER_SYNC는 Storage Engine 커밋 이전, 즉 Binary Log 기록 직후에 ACK를 기다린다. 반면 AFTER_COMMIT은 Storage Engine 커밋까지 완료된 후 클라이언트 결과 반환 전에 ACK를 기다린다.
Semi-sync의 잠재적 문제: Old Master 데이터 불일치
Semi-sync가 완벽한 데이터 보장을 하는 것처럼 보이지만, 드문 경우에 예외가 존재한다. AFTER_COMMIT 모드에서 Binary Log는 이미 기록되었지만 Slave가 ACK를 보내기 전에 OOM 등의 이유로 장애가 발생하면, Master는 커밋된 것으로 판단하지만 Slave는 해당 트랜잭션을 받지 못한 상태가 된다.
Master가 즉시 재기동되어 정상화된다면 Slave가 해당 트랜잭션을 다시 수신해 반영할 수 있다. 하지만 장애로 인해 Slave가 새로운 Master로 승격되는 Role Change가 발생하면, Old Master에만 존재하는 트랜잭션이 생겨 데이터 불일치가 발생한다. 이 경우 Old Master는 복제 재구성이 필요하다.
바이너리 로그 디스크 동기화 설정
OS에 디스크 쓰기를 맡기면 데이터 보장이 어렵기 때문에, DB가 직접 디스크 동기화를 제어하는 것이 중요하다. 이를 위한 두 가지 핵심 파라미터가 있다.
sync_binlog=1로 설정하면 트랜잭션 커밋 전에 Binary Log를 디스크에 동기화한다. innodb_flush_log_at_trx_commit=1은 트랜잭션 커밋마다 로그를 디스크에 기록하고 플러시한다. 값을 0으로 설정하면 성능은 가장 좋지만 데이터 보장이 되지 않고, 2로 설정하면 MySQL 크래시에는 영향이 없지만 OS 크래시에는 취약하다. 운영 환경에서 0이나 2를 선택하는 경우는 주로 복제 지연을 빠르게 따라잡기 위한 목적이다.
복제 안정성을 위한 설정들
1. Master Info 메타데이터 불일치
sync_master_info가 1보다 큰 경우(표준 설정값은 10000), Master로부터 받아온 메타데이터가 즉시 갱신되지 않아 불일치가 발생할 수 있다. 이 값을 1로 줄이면 정확성은 높아지지만 병목이 발생해 복제가 느려질 수 있으므로, 대안으로 relay_log_recovery=1 설정을 활용한다.
relay_log_recovery=1은 Slave 재시작 시 손상된 Relay Log를 무시하고, Relay Log Info 기준으로 Master로부터 Binary Log를 다시 가져오도록 한다. 구체적으로는 재기동 시 새로운 Relay Log 파일을 생성하고 SQL thread position을 초기화한 뒤, Source로부터 Relay Log를 다시 읽는 과정을 자동으로 수행한다. 예기치 않은 중단 이후 충돌 안전 복제를 보장하기 위해 사용이 권장된다.
2. GTID 기반 복제 vs 파일 위치 기반 복제
복제 방식에는 두 가지가 있다. GTID 기반 복제는 복제본이 이미 수신하거나 커밋한 트랜잭션의 GTID를 기반으로, 소스와 복제본의 트랜잭션을 자동으로 비교해 누락된 트랜잭션을 찾아 가져온다. 파일 위치 기반 복제는 Relay_Master_Log_File과 Exec_Master_Log_Pos 값을 기반으로 IO thread가 적용해야 할 트랜잭션을 소스의 Binary Log에서 검색한다.
파일 위치 기반 복제에서는 몇 가지 주의할 점이 있다. relay_log_purge=0으로 설정하면 제거되지 않은 파일에서 Relay Log를 읽어 데이터 불일치가 발생할 수 있으므로 relay_log_purge=1이 권장된다. 또한 MySQL 5.7.13 미만에서 Multi-threaded 복제를 사용하면 Relay Log 트랜잭션 시퀀스에 불일치와 간격이 발생할 수 있다.
3. Relay Log Info 메타데이터 불일치
relay_log_info_repository=FILE로 설정된 경우(MySQL 5.7 기본값) 디스크 flush 타이밍이 모호해 메타데이터 불일치가 발생할 수 있다. relay_log_info_repository=TABLE로 변경하면 트랜잭션과 함께 원자적으로 기록되어 안정성이 높아진다. 이는 MySQL 8.0의 기본값이기도 하다.
마치며
MySQL의 트랜잭션과 복제 구조는 단순해 보이지만, 그 내부에는 데이터 정합성을 지키기 위한 치밀한 설계가 담겨 있다. 특히 HA 환경에서는 Semi-sync의 동작 원리와 한계를 정확히 이해하고, 각 파라미터의 트레이드오프를 고려해 적절히 설정하는 것이 안정적인 운영의 핵심이다.