1. 개요
Java 문법을 복습하며 Collection 구현체들을 사용하는 것 자체에서 고민이 많았습니다.
조금이라도 효율적으로 구성해야하는 서버의 특성 상 자세히 그 특성을 알고 쓰고 싶은데, 그정도의 지식 깊이를 쌓지 못한 것 같습니다.
부족한 내용들을 다시 공부하였고, 나중에 까먹으면 다시 보기 위해 정리하였습니다.
#Reference
2. Set이란?
순서 X, 데이터 중복 X
Set은 앞선 Collection 종류들과는 달리 특정 값들을 담는 주머니 같은 역할을 합니다.
저장 시 순서가 존재하지 않으며, 값이 중복되어 저장되지 않는 자료구조입니다.
보통 빠르게 값의 포함여부 확인이 필요한 경우 사용합니다.
Interface 분석: Set<T>
Set Interface는 다양한 명세들이 존재합니다.
Collection 공통명세를 제외한 주요 메서드들은 다음과 같습니다:
| 유형 | Method | Return | 설명 |
|---|---|---|---|
| 생성 | Set.of( E... elements ) | Set<E> | 주어진 인자를 담는 Set을 생성하여 반환합니다. Set.of()는 ImmutableCollection Class를 통해 ImmutableSet을 생성하므로, 내부 값을 추가/삭제할 수 없습니다. |
| 생성 | Set.copyOf( Collection collection ) | Set<E> | 인자로 주어진 Collection 객체를 사용하여 ImmutableSet을 생성합니다. Set.of()와 마찬가지로 내부 요소를 추가/삭제할 수 없습니다. |
| 조회 | Set.containsAll( E element ) | boolean | 인자로 주어진 Collection의 모든 요소가 Set에 존재하는 값인지 검사합니다. 모든 값이 존재하는경우 true를, 1개라도 존재하지 않는경우 false를 return합니다. |
| 추가 | Set.add( E element ) | boolean | element를 추가합니다. 새로운 값인경우 값을 추가하고 true를, 기존에 이미 값이 있는경우 false를 return합니다. |
| 삭제 | Set.remove( E element ) | boolean | element를 삭제합니다. 삭제할 값이 존재하는 경우 삭제하고 true를, 삭제할 값이 없는경우 false를 return합니다. |
3. 구현체 톺아보기
전체적인 구현체들의 상속관계는 다음과 같습니다
- AbstractCollection (implements Collection) [Class(Abstract)]
- AbstractSet (implements Set) [Class(Abstract)]
- HashSet (implements Clonable, java.io.Serializable) [Class]
HashSet
순서가 중요하지 않고, 메모리 제한이 있을 때 빠른접근이 필요한 경우 사용.
검색/삽입/삭제속도에서 이점
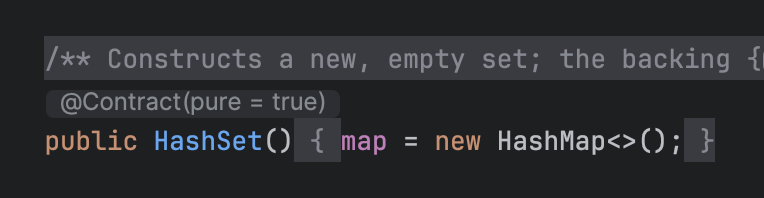
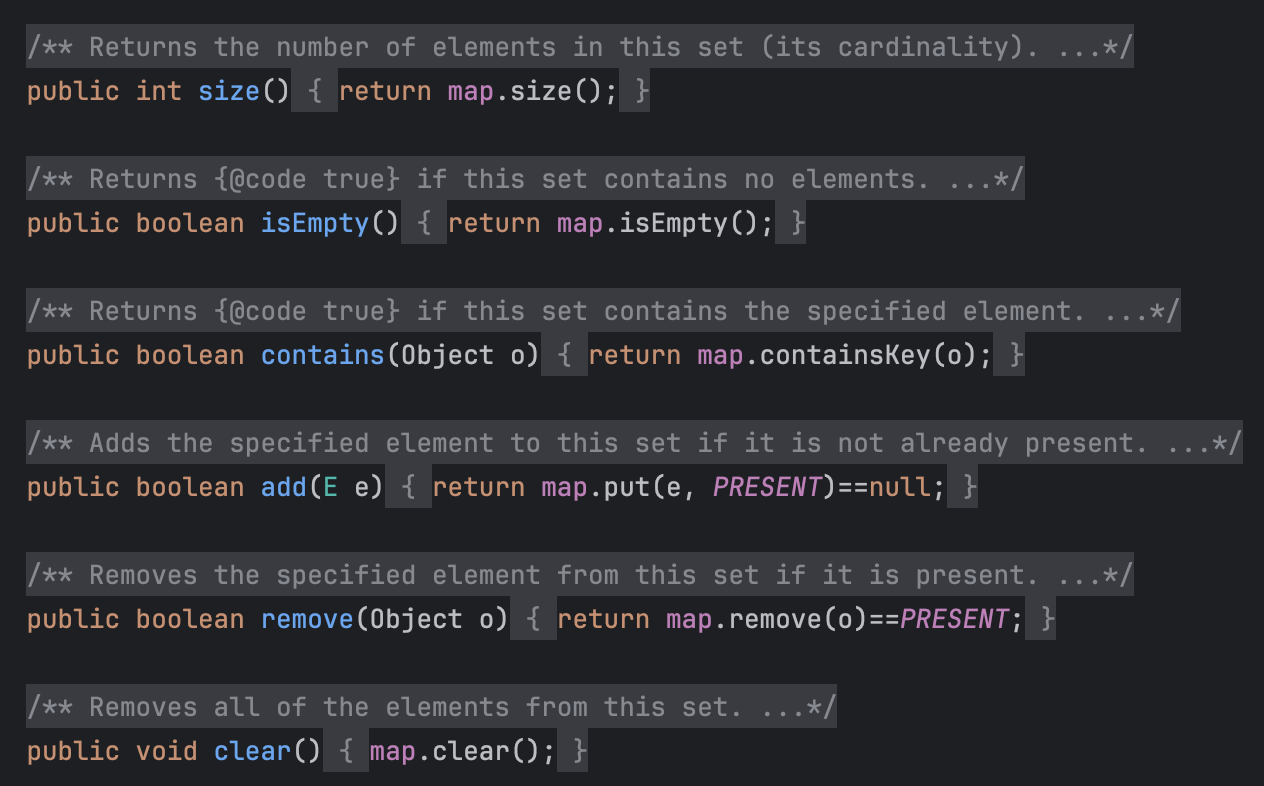
HashMap을 사용하여 Collection 구현명세에 부합하도록 만든 Set의 구현체입니다. Map의 Key는 중복될 수 없다는 특징을 이용하여 추가하는 데이터들을 Set의 key로 추가합니다.
(아래 이미지에서, add()의 구현을 위해 내부적으로 value자리에 PRESENT라는 dummy 객체를 채웁니다)
Map의 구현명세 상 key가 중복되는경우에 대한 예외발생이 이미 구현되어있으므로 별도의 복잡한 구현과정 없이 사용할 수 있습니다.
관련된 내용은 HashMap과 관련된 글에서 더 자세히 다루어 두었습니다.
TreeSet
중간중간 정렬상태를 확인해야하는 경우 사용
TreeMap을 사용하여 Collection 구현명세에 부합하도록 만든 Set의 구현체입니다. HashSet과 동일하게 구현되어있으며, 저장방식은 TreeMap 분석 블로깅에서 더 자세히 다루어 두었습니다.
4. 결론
HashSet과 TreeSet을 분석해보니 Set을 위한 특화 자료구조를 구현한 것이 아닌
Map을 활용하여 Collection 명세에 맞게 자료구조를 구현하였다는 것을 알았습니다.
Map에 대하여 공부해보며 상황에 따라 적절한 자료구조를 분석해봐야 하겠습니다..
하면 할 수록 늘어나는 할일
