1. 개요
Java 문법을 복습하며 Collection 구현체들을 사용하는 것 자체에서 고민이 많았습니다.
조금이라도 효율적으로 구성해야하는 서버의 특성 상 자세히 그 특성을 알고 쓰고 싶은데, 그정도의 지식 깊이를 쌓지 못한 것 같습니다.
부족한 내용들을 다시 공부하였고, 나중에 까먹으면 다시 보기 위해 정리하였습니다.
2. PriorityQueue
A. Queue란?
순서 O, 데이터 중복 O
Queue는 List처럼 순서와 데이터 중복을 허용하는 자료구조입니다.
List와 다른 특징이라면, 중간 특정위치에 다른 데이터를 추가하는 것이 불가하고,
입력은 무조건 tail(=끝), 출력은 무조건 head(=앞)에서만 가능합니다.
B. PriorityQueue란?
일반적으로 FIFO 구조를 가지는 Queue의 특성과는 다르게, 각 element의 우선순위에 따라 출력순서가 정해지는 Queue입니다. 데이터를 추가할 때, 배열을 이진트리 형태로 이동하며 comparator로 값을 비교 후 결과에 따라 오름차순 정렬하여 저장합니다. (객체 내 shiftUp() method 사용)
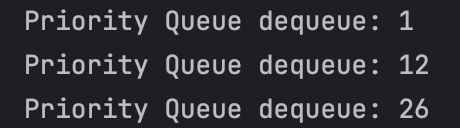
담는 자료형이 비교가능한 값인 경우, 입력값들이 오름차순으로 출력됩니다
PriorityQueue<Integer> pq1 = new PriorityQueue();
pq1.offer(1);
pq1.offer(26);
pq1.offer(12);

while( !pq1.isEmpty() ) {
    System.out.printf( "Priority Queue dequeue: %d\n", pq1.poll() );
}
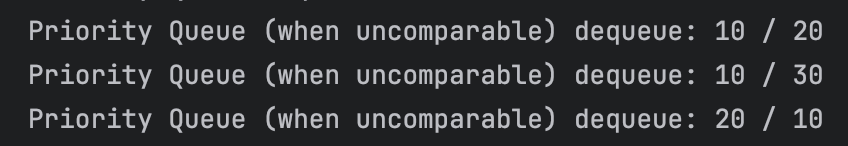
담는 자료형이 비교가능한 값이 아닌 경우,
해당 값들을 비교할 수 있는 Comparator를 만들어 두번째 인자로 제공해야 하며,
Comparator.compare()의 결과에 따라 값이 비교되어 결정됩니다.
class Test {
    private int a;
    private int b;

    public Test(int a, int b) {
        this.a = a;
        this.b = b;
    }

    public int getA() {return a;}
    public int getB() {return b;}
}

    // 비교할 대상에 대한 Comparator를 생성
    class TestComparator implements Comparator<Test> {
        @Override
        public int compare(Test o1, Test o2) {
            if ( o1.getA() == o2.getA() ) return o1.getB() - o2.getB();
            return o1.getA() - o2.getA();
        }
    }

    PriorityQueue<Test> pq2 = new PriorityQueue<>(10, new TestComparator() ); // 2번째 인자로 비교할 수 있는 Comparator 구현체를 제공
    pq2.offer( new Test( 20, 10 ) );
    pq2.offer( new Test( 10, 20 ) );
    pq2.offer( new Test( 10, 30 ) );

    while( !pq2.isEmpty() ) {
        Test polled = pq2.poll();
        System.out.printf( "Priority Queue (when uncomparable) dequeue: %d / %d\n", polled.getA(), polled.getB() );
    }
3. PriorityQueue 톺아보기
A. PriorityQueue 생성: 저장공간 크기 설정
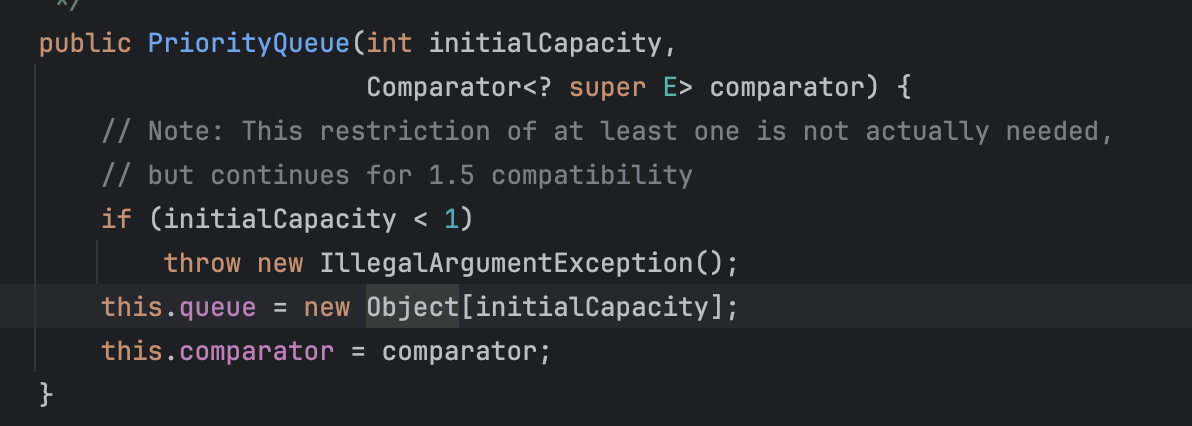
PriorityQueue는 내부적으로 객체배열을 사용해 데이터들을 저장합니다.
이를 위해 필요한 배열크기를 사용자에게 입력받으며, 미설정 시 기본적으로 11칸짜리 배열로 생성됩니다.
comparator가 제공되는 경우, comparator도 이때 설정됩니다.
B. 데이터 추가
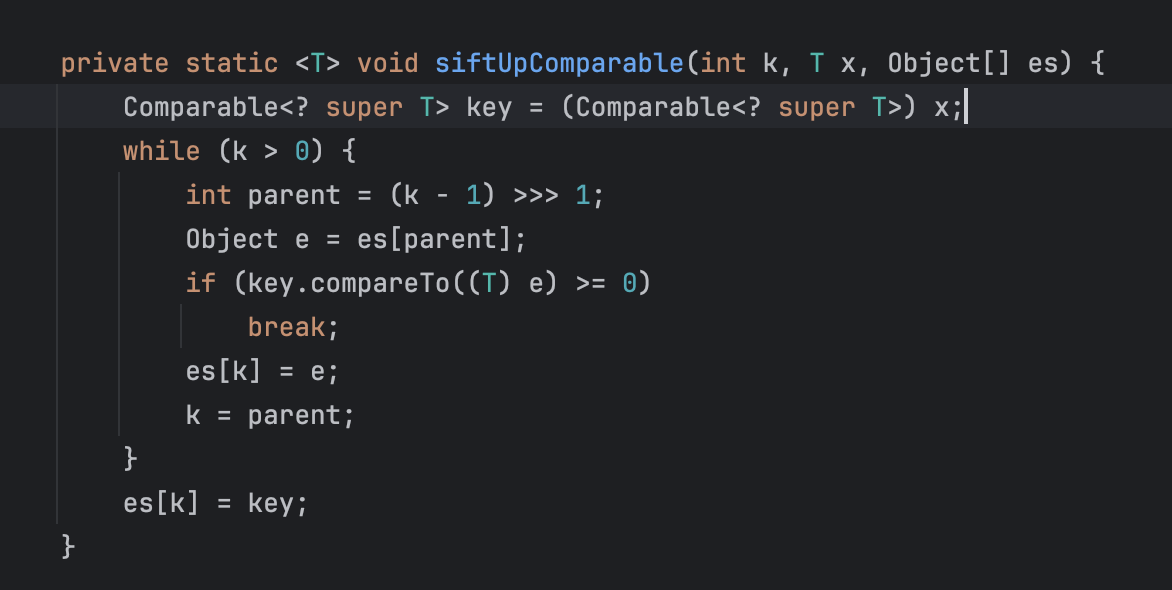
PriorityQueue.offer()를 통해 데이터가 추가되면, 내부의 shiftUp() 메서드가 호출되어 사용자가 지시한 데이터의 추가작업이 수행됩니다. (위 이미지는 데이터가 comparator 없이도 comparable할 때 사용되는 shiftUpComparable() 메서드 입니다)
이때, PriorityQueue는 설정되어있는 comparator에 따라 데이터를 추가하는데,
가장 마지막위치에서 시작해서 논리적 트리의 형태로 1칸씩 올라가다가 우선순위 정렬이 완료되면 그때 이동을 멈추고 데이터를 저장합니다.
다시말해, PriorityQueue는 데이터를 저장할 때 정해진 기준에 따라 정렬하여 데이터를 저장합니다.
C. 데이터 접근
1) 데이터 조회 (peek, poll 등)
Queue의 특성으로 인해, PriorityQueue 또한 tail에서만 데이터를 꺼낼 수 있습니다. PriorityQueue는 정렬 기준에 의해 데이터를 추가하는 시점에 이미 정렬되어 가장 먼저나가야 할 데이터가 tail에 위치해있으므로 (= index '0' 위치),
PriorityQueue.peek(), poll(), element(), remove() 등이 실행되면 별도의 연산없이 바로 접근하려는 값을 가져올 수 있습니다.
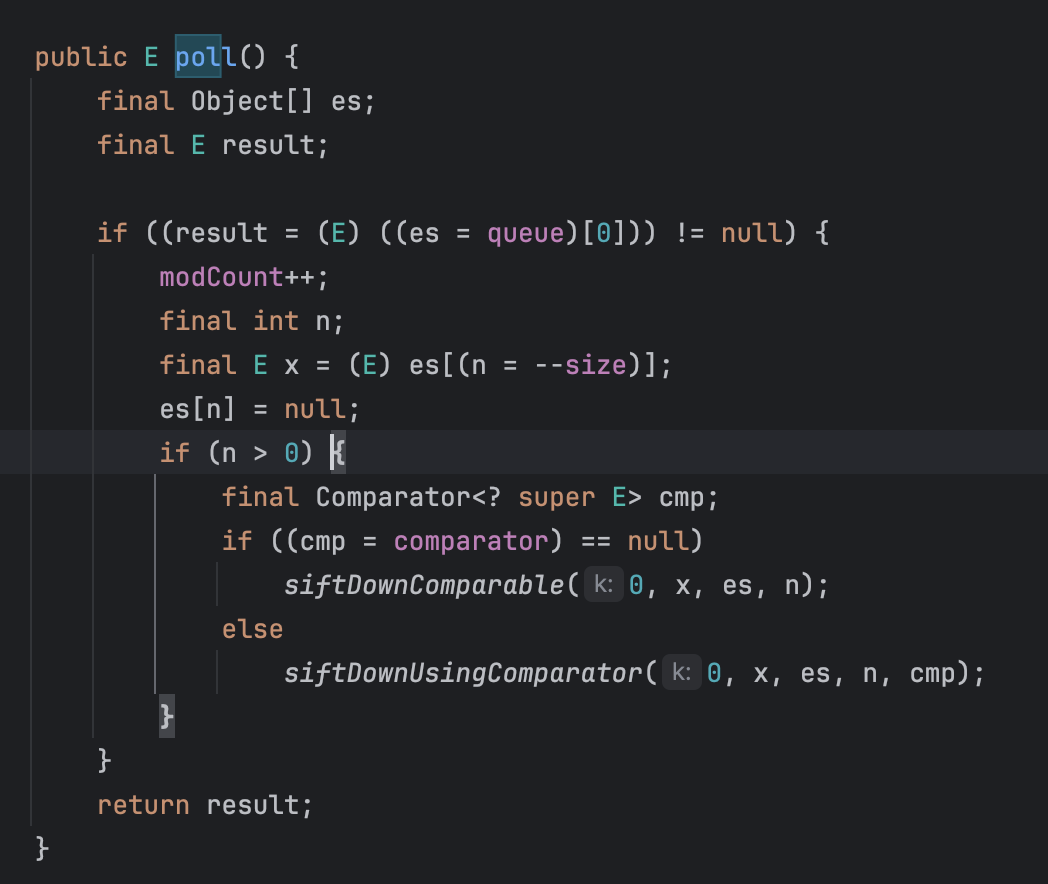
단, poll()과 remove()의 경우 tail에 있는 데이터를 확인 후 제거하는 작업이 함께 수행되므로 남아있는 데이터들에 대한 재정렬 작업이 필요합니다.
따라서 이를 수행하기 위해 shiftDownUsingComparator()나 shiftDownComparable()를 사용해 재정렬하는 과정이 필요해 추가적인 연산 소요시간이 필요합니다.
2) 데이터 유무확인 (contains, indexOf 등)
PriorityQueue.contains()는 PriorityQueue.indexOf()의 결과로 동작하므로 indexOf() 메서드의 연산시간에 영향을 받습니다.
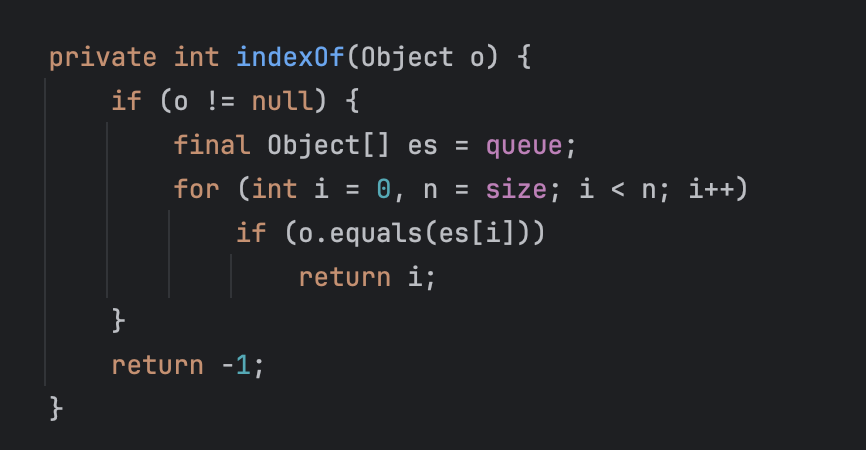
PriorityQueue.indexOf()는 현재 담겨있는 데이터의 크기만큼 순회하며 주어진 데이터와 일치하는 항목을 탐색합니다.
하나씩 접근하여 데이터의 동일성여부를 확인하기 때문에, 최대 O(n) 시간만큼 소요됩니다.
4. 결론
PriorityQueue의 구조를 알아보며 기능에 따라 소요되는 시간들과 그 이유를 알아볼 수 있었습니다.
상황에 맞게 적절한 필요와 소요시간을 잘 고려하여 선택하는 연습을 해야할 것 같습니다.
