본 포스팅의 내용은 Gareth James, Daniela Witten, Trevor Hastie, Robert Tibshirani, Jonathan Taylor (2023), 「An Introduction to Statistical Learning with Applications in Python」, Springer 를 참고하였습니다.
선형회귀(linear regresion)은 매우 단순한 지도학습 방법 중 하나이다.
특히 변수 중에 양적 반응을 예측하는데 중요한 도구이다.
이 장에서는 최소제곱법을 사용한 모형을 주로 다룬다.
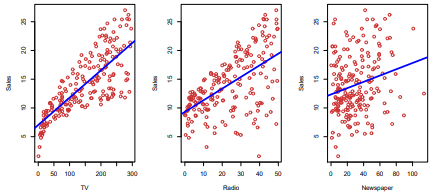
[그림 2.1] 각 매체 간의 광고 예산 당 판매량에 대한 그래프
우리는 예측변수(광고예산(TV, Radio, Newspaper))와 반응변수(Sales)에 대하여 분석하는 과정에서 몇 가지 의문이 든다.
- 광고 예산과 판매량 사이에 무슨 관계가 있을까?
- 광고 예산과 판매량 사이의 관계는 얼마나 강할까?
- 어떤 매체가 판매량과 관련되어 있을까?
- 각각의 매체와 판매량 사이에는 얼마나 큰 영향력이 있을까?
- 선형 관계가 존재하는가?
- 광고 매체 사이에 시너지 효과가 있을까?
이러한 각각의 질문을 해소하는 역할을 하는 것이 선형회귀를 통한 분석이다.
단순선형회귀는 단일한 예측변수 를 기반으로 양적 반응 를 예측하는 방법이다. 사이에 모종의 선형 관계가 있다고 가정한다면, 다음과 같이 쓸 수 있다.
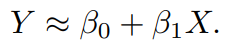
은 각각 절편(intercept)과 기울기(slope)항을 나타내며, 모형계수(coefficient), 모수(parameter)이라고도 불린다.
훈련데이터를 통해 추정값 를 얻으면 다음과 같이 미래의 판매량을 예측 가능하다.
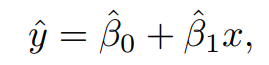
3.1.1 계수 추정하기
앞 그림[2.1]의 n=200 데이터 셋의 관측쌍 에 잘 맞는
계수 추정값 를 구해야 한다.
다시 말해, 절편과 기울기를 통해 데이터 관측점과 최대한 가깝게 되는 것을 목적으로 한다.
이 가까움(closeness)의 정도를 측정하는 방법 중 가장 일반적인 방법이 최소제곱(least squares) 기준을 최소화 하는 것이다.
를 의 번째 값을 기반으로 한 의 예측값이라고 할 때, 은 번째 잔차(residual)을 나타낸다. 잔차제곱합(RSS, residual sum of squares)은 다음과 같이 정의한다.
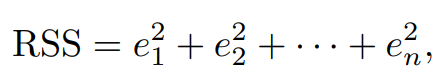
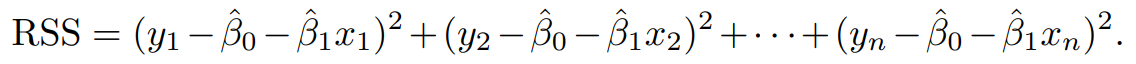
최소제곱법은 이 RSS를 최소화하는 를 선택하는 방법이다. 최소화 하는 값은 다음과 같다.
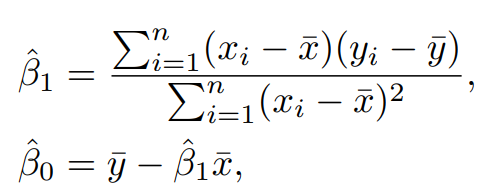
이는 단순선형회귀의 최소제곱 계수 추정값을 정의한다.
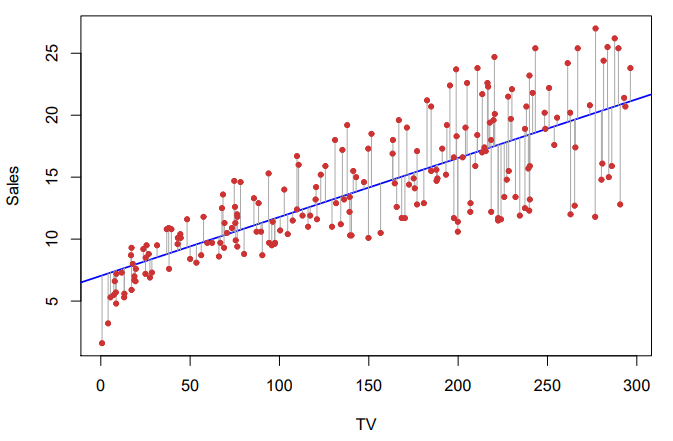
[그림 3.1] TV에 대한 Sales의 회귀모형을 최소제곱법으로 적합한 결과
다음은 인 Advertising에 대한 단순선형회귀적합이다.
이는 TV광고에 $1000을 투입할 경우, 제품을 47.5단위 더 판매된다는 것을 의미한다.
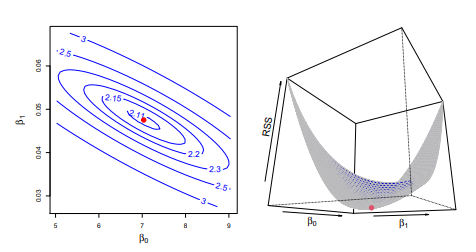
[그림 3.2] Advertising 데이터에서 Sales를 반응변수, TV를 예측변수로 두었을 때의 RSS의 등고선 그래프와 3차원 그래프
두 그래프는 최소제곱 추정값의 쌍을 나타내었으며 빨간 점이 위치한 두 값이 RSS를 가장 최소화함을 알 수 있다.
3.1.2 회귀계수 추정값의 정확도 평가하기
의 참 관계는 앞 장에서 언급한 것 처럼 의 형태로 취할 수 있다. 를 선형함수로 근사할 때 다음과 같은 관계로 나타낼 수 있다.
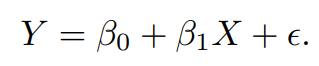
해당 식은 모집단 회귀선(population regression line)을 정의하고 있다.
는 절편(intercept)의 항으로, 값이 0일 때 의 기댓값이다.
는 기울기(slope)의 항으로, 가 1단위 늘어날 때의 의 평균 증가량이다.
은 오차항으로, 단순 모형에서 놓친 값으로, 와 독립이다.
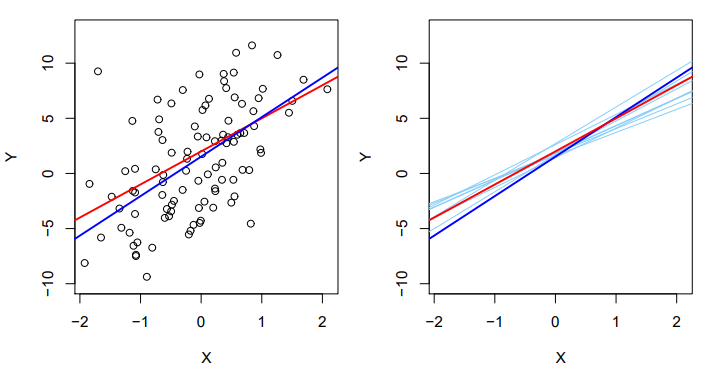
다음은 임의의 함수 에 대한 모형이다.
빨간 선은 모집단 회귀선으로, 실제로 알 수 없는 선이다.
파란 선은 관측 데이터를 기반으로 한 최소제곱 추정값을 나타낸 선이다.
오른쪽 하늘색 선 10개는 모집단에서 10개의 데이터셋을 추출하여 추정값을 통해 예측한 선이다.
이처럼 모집단 회귀선은 알 수 없지만, 주어진 계수 추정값을 이용해 예측할 수 있다.
모집단 회귀선과 최소제곱선과의 차이는 표준적인 통계 접근법의 자연스러운 확장이라고 할 수 있다.
관측값의 평균인 표본 평균를 통해 모집단의 평균을 추정하는 과정에서,
모평균과 표본평균은 같다고 할 수는 없지만 표본 평균은 모평균에 대한 좋은 추정값을 제시한다.
이렇게 선형회귀를 평균 추정과 같은 원리로 이해하는 것은 편향(bias)의 개념으로 이해하는 것이 타당하다.
-> 과정에서 이 추정값은 비편향추정값(unbiased eseimate)이라고 할 수 있는데,
비편향이란 가 를 과대추정 및 과소추정을 하지 않는다는 말인데, 이는 수 많은 관측 집합에서 얻은 의 추정값에 대한 평균값이기 때문에 이 평균은 정확히 와 같게 될 것이다.
이러한 비편향의 성질은 최소제곱 계수 추정값에서 적용할 수 있다.
오른쪽 그래프처럼 수 많은 데이터 관측 집합에서 구한 최소제곱 추정 값을 평균을 낸다면 모평균 회귀선에 근사할 것이다.
모평균 추정에 대한 가정을 이어간다면,
표본평균 이 에 얼마나 정확하게 추정하는지에 대해 확인하기 위해서는 의 표준오차(SE, standard, error)를 계산해야 한다.
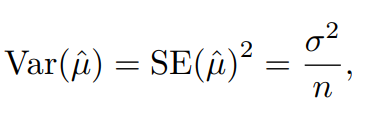
다음은 표준오차를 나타내는 공식이며, 은 확률변수 의 실현값 각각의 표준편차의 제곱이다.
관측값이 많아질수록 표준오차는 작아지게 되고, 모평균에 근접하게 된다.
이와 연계하여 최소제곱 추정값 의 표준오차를 계산하기 위해서는 다음과 같은 식을 사용한다.
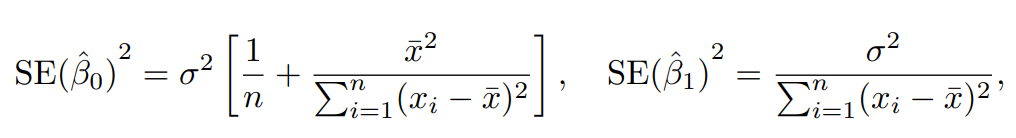
여기서 이고, 각각의 오차항의 분산이 으로 동일하고, 무상관(uncorrelated)라고 가정을 한다면,
은 가 표본 평균에 많이 퍼져 있을수록 작아진다.
데이터의 관측값이 한 곳에 몰려있다면 전체적인 패턴을 알기 힘들다. 이는 넓은 범위의 테스트 데이터가 나왔을 때, 오차가 클 것이다.
일반적으로 은 알 수 없지만 데이터에서 추정은 가능하다. 의 추정값을 잔차표준오차(RSE, residual standard error)라고 하는데, 라고 할 수 있다.
표준오차는 신뢰구간(confidence interval)을 계산하는데 사용될 수 있다.
95% 신뢰구간은 95% 확률로 모수의 알려지지 않은 참값이 포함되는 범위로 정의된다.
(하한(lower limit), 상한(upper limit))
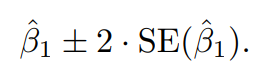
즉, 근사적으로 95%확률로 의 참값의 범위를 나타낸다.
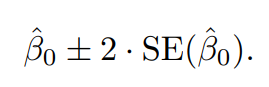
마찬가지로 95%확률로 의 참값의 범위를 나타낸다.
예를 들어 광고 데이터의 의 95% 신뢰구간이 [0.042, 0.053]이라면,
광고 예산이 $1000 증가한다면 제품 생산량이 42~53단위만큼 증가할 확률이 95%라는 것이다.
표준오차는 계수에 대한 가설검정(hypothesis test)를 수행하는 데 사용될 수 있다.
가장 일반적인 가설검정은 다음과 같은 귀무가설(null hypothesis)와 대립가설(alternative hypothesis)으로 이루어진다.
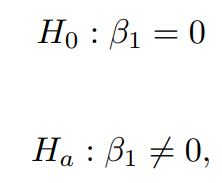
여기서 귀무가설은 사이에 연관이 없다는 것이고, 대립가설은 사이에 연관이 있다는 것이다.
귀무가설이 참이라면, 로 축소된다.
귀무가설을 검정하려면 이 0이 아님을 증명해야하고, 이는 에 따라 달라진다.
이 작다면 간에 관계가 있다는 것을 입증할 수 있기 때문이다.
반면에 해당 값이 크다면, 의 절댓값이 충분이 커야 귀무가설을 기각할 수 있다.
실제 분석은 다음과 같은 통계량(t-statistics)이 주어진다.
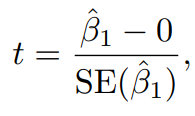
이 식은 표준편차의 개수로 이 0에서 얼마나 멀리 떨어져 있는지 측정한다.
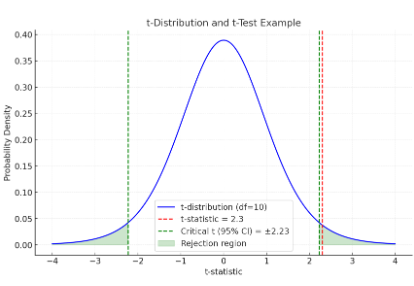
실제로 가 연관이 없다면 자유도가 n-2인 분포를 따르고, 표본정규분포를 따르게 된다.
95% 신뢰구간(2.23)으로 보았을 때,통계량(2.3)이 임계값을 넘어감으로, 귀무가설을 기각할 수 있고, 통계적으로 유의하다고 볼 수 있다.
이 값의 기준은 주로 5%, 1%이다.
가 작다는 의미는 예측변수와 반응변수 사이에 실제 연관성이 있음에도, 우연으로 연관성이 나타날 가능성이 낮다는 뜻이다.
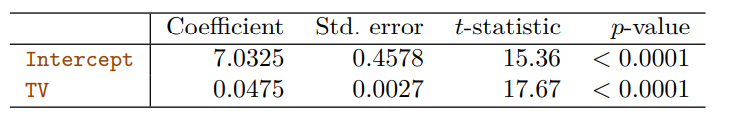
[그림2.1]의 Advertising 데이터에서 TV 광고예산에 대한 제품 판매 대수의 회귀를 위한 최소제곱모형의 세부정보이다.
의 값이 표준오차에 비해 매우 크다는 것을 알 수 있고, 이는 t-통계량이 매우 크게 되면서, 값 또한 매우 작아지는 것을 알 수 있고, 이는 두 계수 모두 통계적으로 유의하다는 결론을 낼 수 있다.
3.1.3 모형의 정확도 평가하기
선형회귀 모형이 얼마나 데이터에 잘 적합하는지 수량화 하는 방법은 보통 서로 관련 있는 두 가지 수량으로 나타낸다. 잔차표준오차(RSE, residual standard error)와 통계량이다.
1) 잔차표준오차
에서 의 표준편차 추정값이다.
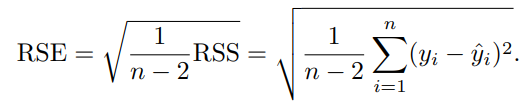
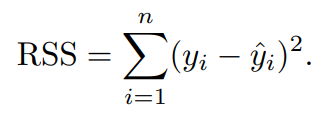
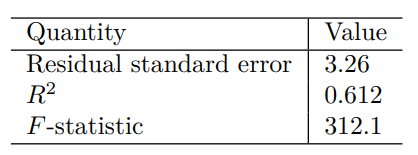
분석 결과 RSE = 3.26으로 실제 판매량은 평균적으로 참 회귀선에서 대략 3,260개만큼 벗어나 있다.
이는 최소제곱계수를 모평균 회귀선 만큼 정확하게 구한다고 하더라도 평균적으로 3,260개는 벗어난다는 의미이다.
전체 Sales의 평균 값은 14,000개로, 퍼센트 오차는 약 23%이다.
이처럼 RSE는 데이터에 대한 모형의 적합 결여(lack of fit)의 측도로 간주된다.
1) 통계량
통계량은 적합의 정도에 대한 대안적인 측도, 비율의 형태(0~1)로 Y의 단위에 의존하지 않는다.
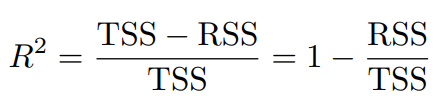
은 총제곱합(TSS, total sum of squares)이다.
는 반응변수 의 총분산으로, 회귀분석을 하기 전 반응에 내재된 변동의 양이다.
는 회귀분석을 수행한 후에도 설명되지 않은 변동의 양이다.
를 수행하면서 설명된 반응변수의 변동 양을 측정한다.
통계량이 1에 가까워질수록 반응변수의 변동에서 많은 부분을 회귀로 설명할 수 있다는 의미이다.
통계량이 0에 가깝다는 의미는 선형모형이 잘못되었거나, 오차 분산 이 매우 크다는 의미이다.
예: 은 전체 데이터 변동의 2/3정도가 설명된다는 의미이다.
좋은 은 적용하는 분야에 따라 다르게 나타난다.
예: 천문학에서의 은 1에 매우 가까워야하며, 심리학, 마케팅 분야에서는 0.1이 매우 의미있는 값일 수도 있다.
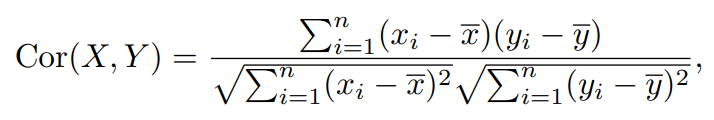
이는 상관관계(correlation)로 의 선형 관계를 나타내는 측도이다. 이 식을 통해서도 선형모형의 적합도를 평가할 수 있다. 로 나타내며, 임을 보일 수 있다.
하지만 이러한 관계는 단순선형관계일 때만 성립한다. 왜냐하면 상관관계는 단일한 변수 쌍의 연관성에 대한 수량화를 나타내는 것이기 때문이다.
