본 포스팅의 내용은 Gareth James, Daniela Witten, Trevor Hastie, Robert Tibshirani, Jonathan Taylor (2023), 「An Introduction to Statistical Learning with Applications in Python」, Springer 를 참고하였습니다.
단순선형회귀는 단일 예측변수를 기반으로 반응변수를 예측하는 방법이다.
하지만, 두 가지 이상의 예측변수일 때의 반응 변수와의 관계는 어떻게 예측할까?
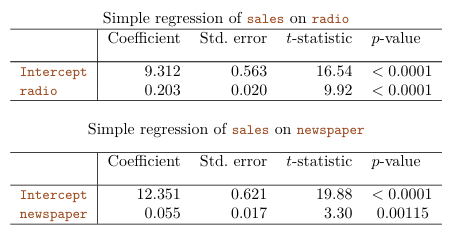
[그림 3.3]Advertising 데이터에 대한 두 가지 예측변수(radio, newspaper)의 단순선형회귀모형 계수
한 가지 방법은 단순선형 회귀모형을 개별로 계산하는 방법이다.
하지만 이는 여러 개의 개별적인 회귀식을 통해 한 가지 반응변수를 예측하는데 어려움이 있다.
또한 각각의 회귀식은 회귀계수를 추정할 때, 서로의 변수를 고려하지 않아 예측변수 간의 상관관계를 파악할 수 없다.
따라서 각각의 단순선형회귀모형을 적합하는 것보다 이를 확장해 다중선형회귀모형을 적합하는 것이 올바르다.
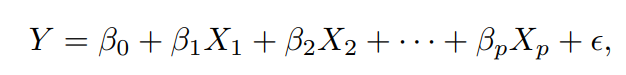
다중선형회귀모형은 다음과 같은 형식으로 취하며, 는 절편(intercept)을 나타낸다.
는 각각의 예측 변수에 대한 기울기(slope)를 나타내며, 이는 다른 모든 예측변수가 고정된 상태에서 가 1단위 늘어날 때 에 미치는 평균적인 영향을 뜻한다.
Advertising 데이터에 비유하면 다음과 같다.

3.2.1 회귀계수 추정하기
최소제곱법을 통한 회귀계수의 추정식은 다음과 같다.
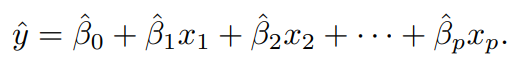
이때, 다음 주어신 식과 같이 잔차제곱합(RSS)을 최소화하는 를 선택한다.
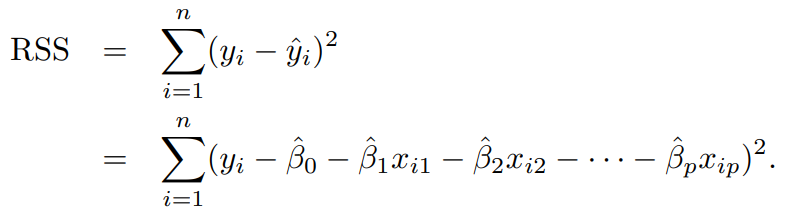
은 다중회귀계수 추정값이다. 복잡한 형태처럼 보이지만, 행렬대수를 통해 쉽게 표현 가능하다.
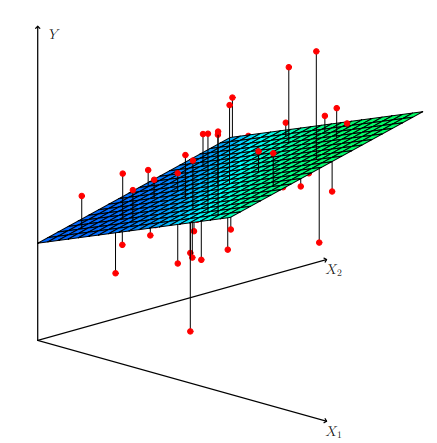
[그림 3.4] 예측변수가 2개인 예제 데이터의 최소적합의 예
다음 표는 Advertising 데이터에서 3가지 변수에 대한 다중회귀계수 추정값이다.
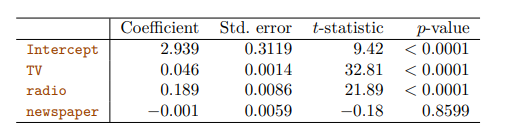
예측변수 radio, TV 같은 경우에는 유의한 수준의 와 계수 추정값을 알 수 있었다.
하지만 예측변수newspaper의 계수 추정값은 0에 가까우며, 또한 1에 아까워 유의하지 않음을 알 수 있다.
그렇다면 newspaper 변수는 sales와 관계가 없다는 결론을 내리는 것이 타당한가? 하지만 그래프를 보았을 때는 유의성이 있는 것 처럼보였다.
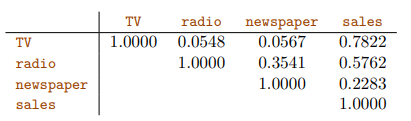
다음은 3가지 예측변수와 반응변수 간의 상관행렬이다. 여기에서 눈여겨 볼 지표는 radio-newspaper 사이의 상관계수(0.3541)이다.
이 말은 즉슨, radio 광고를 많이 할 수록 newspaper광고 또한 같이 증가한다는 것을 의미한다.
결론적으로 radio의 광고 예산량이 newspaper의 광고예산량, 제품 판매량을 증가하는 것은 맞지만, newspaper 광고 예산량 증가가 제품 판매량을 증가시키는 것은 아니다.
여름에는 상어의 공격횟수, 아이스크림 판매량이 증가하는 형태를 띈다. 이를 각각 예측변수, 반응변수에 설정하고 회귀분석을 했더니 양의 결과가 나온다.
하지만 실제로 아이스크림 판매를 금지시킨다고해서 상어의 공격이 줄어들까?
서로의 관련성이 없다는 지표는 다중회귀분석 결과를 통해 알 수 있다.
이는 기온이라는 변수를 조정하지 않고 계산을 하였을 때의 문제이므로, 올바른 변수를 찾는 것이 중요하다.
3.2.2 몇 가지 중요한 질문들
우리는 다중선형회귀를 수행할 때 보통 다음과 같은 중요한 질문을 던질 수 있다.
- 예측변수 중 적어도 하나는 반응변수 예측에 유용한가?
- 모든 예측변수가 를 설명하는데 유용할 것인가? 일부 집합만 유용할 것인가?
- 모형이 데이터에 잘 적합하는가?
- 예측변수의 값이 주어졌을 때 반응변수의 예측값이 무엇인가? 얼마나 정확한가?
우리는 이러한 질문에 하나씩 답해볼 것이다.
1) 반응변수와 예측변수는 관련되어 있을까?
이 경우는 의 값이 모두 0인지 확인해볼 필요가 있다. 이때 가설검정(hypothesis test)을 사용한다.
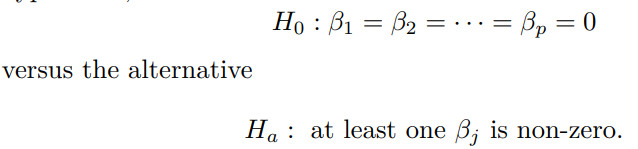
귀무가설은 모든 최소제곱 계수가 0이라는 것이고, 귀무가설은 적어도 하나 이상은 0이 아니라는 것이다.
가설검정을 수행하기 위해 계산할 F-통계량은 다음과 같다.
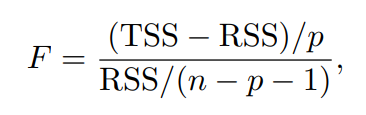
, 이고, 분모는 다음과 같이 나타낼 수 있다.
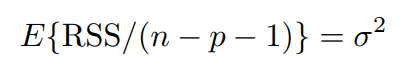
또한 가 참인 경우 분자는 다음을 만족한다.
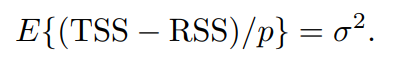
반면 가 참인 경우, 연관성을 보이는 경우는 보다 커지게 되므로 1보다 커질 것이고, 이는 F가 1보다 클 것으로 기대한다.
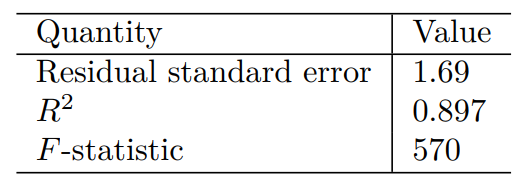
다음 표는 Advertising 데이터에서 3가지 예측변수를 통해 반응 변수 sales를 회귀분석해 얻은 다중선형모형의 F-통계량이다.
위의 값은 570이로 측정되었고, 1보다 훨씬 큰 수이므로 귀무가설을 반하는 증거, 즉 예측변수가 반응변수에 적어도 하나는 관련이 있음을 시사한다.
F-통계량의 값이 얼마나 커야 귀무가설을 기각할 수 있을까?
크기를 좌우하는 지표는 n,p로 샘플 데이터와, 예측변수의 개수이다.
n(샘플 데이터)의 양의 증가할수록 분모의 크기가 줄어들고, F값이 증가하며 p(예측변수)가 줄어들수록 분모의 크기가 커져 F 값이 감소한다.
따라서 n의 크기가 충분히 작다면 상대적으로 더 큰 F-값에 대한 신뢰를 해야 한다.
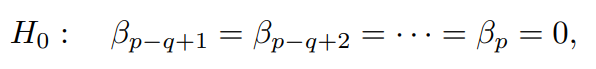
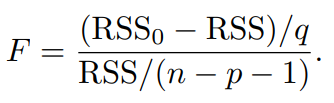
부분적인 예측변수에 대한 귀무가설을 세울 때는 다음과 같은 식을 세우면 되고, F-값 또한 다음 식을 통해 계산하면 된다.
이때 은 원하는 예측변수의 부분집합을 제외하면 된다.
우리는 개별 예측변수에 대한 t-통계량과 p-값을 통해 예측변수에 대한 반응변수의 개별적인 연관성을 알 수 있다.
즉, F값을 구할 때 q=1로 고정한 후 검정하는 것과 같다고 볼 수 있다.
또한 개별 예측변수의 매우 낮은 p-값을 통해 해당 예측변수가 반응변수와 연관성 있다고 단정할 수 있다.
하지만 예측변수의 크기가 매우 클때 이러한 논리에 결함이 생긴다.
예를 들어 p의 개수가 100개 이상일 경우, 귀무가설은 100개의 예측변수가 모두 반응변수에 연관성이 없다는 것이고, 유의수준을 0.05로 설정했을 때 p-값 중 약 5%는 우연에 의해 0.05 미만이 되었을 것이다.
즉, 서로 간에 연관성이 없을지라도 우연에 의해 낮은 값의 p-값을 관찰하게 될 가능성이 있다.
하지만 F-통계량은 예측변수의 수에 따라 조정되기 때문에 이러한 문제가 생기지 않는다.
(가 참일 경우 예측변수의 수나 관측 수에 상관 없이 0.05 이하의 p-값을 가질 확률이 5%이다.)
또한 p>n인 경우 최소제곱을 사용한 다중선형회귀모형을 적합할 수 없으므로 F-통계량을 사용하지 못한다.
2) 중요한 변수 선택하기
다중회귀의 첫번째 단계는 F-통계량을 계산해 유의미한 p-값을 가진 예측변수가 있는지에 대해 확인하는 것이다.
만약 적어도 하나 이상의 예측변수가 연관성이 있다고 결론을 내린다면, 어떤 변수인지에 대한 접근이 필요하다.
따라서 우리는 수많은 예측변수 중에서 연관성이 있는 변수를 찾아내는 작업(변수선택, varable selection)이 필요하다.
가장 좋은 모형을 선택하는 방법은 (Mallows' ), AIC(Akaike Information Criterion), BIC(Bayesian Information Criterion) 등이 있다.
여기에서는 고전적인 접근법에 대한 간략하 개요만 제시한다.(6장 후술 예정)
이상적으로 변수선택 과정에서 다양한 모형을 시도하고 각각의 모형은 서로다른 예측변수의 부분집합만을 포함하고 싶을 것이다.
예를 들어 p=2인 경우 총 4가지의 모형을 그릴 수 있다.
이렇게 p개의 변수의 부분집합을 포함하는 모형은 총 가지다. 따라서 모든 부분집합에 대한 모형을 세우는 것은 매우 어려운 일이다.
대신 고려할 모형 집합을 더 작은 규모로 선택하는 자동화되고 효율적인 접근법이 필요하다. 총 세가지 고전적인 접근법을 살펴보자.
- 전진선택(forward selection):
- 예측변수가 없는 모형(영모형, null model)에서 시작한다.
- p개의 단순선형회귀모형을 적합하고, RSS가 가장 작은 변수를 영모형에 추가한다.
- 그 모형에 해당 변수를 추가해 새로운 두 변수 모형을 얻는다.
- 중지 규칙이 만족할 때까지 반복한다.
- 후진선택(backward selection):
- 모든 변수가 포함되 모형에서 시작한다.
- 통계적으로 가장 유의하지 않은 변수(가장 큰 p-값)을 제거 한후 모형을 적합
- 모든 변수의 p-값이 특정 임계값 아래로 내려갈 때까지 반복한다.
- 혼합선택(mixed selection):
- 변수가 없는 상태에서 모형을 추가하며 전직선택 방식으로 계속한다.
- 모형에 새로운 예측변수가 추가됨에 따라 p-값이 커지게 되는데, 특정 임계값을 넘어갈 경우 그 변수를 모형에서 제거한다.(후진선택 방식)
- 위 과정을 반복해 모든 변수의 p-값이 충분히 낮아지고 모형 밖의 모든 변수는 모형에 추가하면 p-값이 커질 때까지 반복한다.
전진선택은 항상 사용 가능하고, 후진선택은 p>n일 경우 사용불가이다. 하지만 전진선택은 앞서 고른 변수가 나중에는 불필요하게 추가된 변수가 될 수 있다는 단점이 있다.
혼합선택은 이러한 문제점들을 해결한다.
3) 모형적합도
모형적합도를 설명하는 가장 일반적인 수치형 측도 두 가지는 RSE와 이다. 이 수치들을 앞선 단순선형회귀와 동일한 방식으로 계산하고 해석한다.
단순회귀에서 은 반응변수와 변수의 상관계수의 제곱임을 알 수 있었다.
다중선형회귀에서는 이 반응변수와 적합된 선형모형 사이의 상관계수의 제곱인 임을 알 수 있다.
이 1에 근접할수록 모형이 반응변수 분산의 많은 부분을 설명한다.
예를 들어 Advertising 데이터에서 세 가지 매체를 사용해 sales를 예측하는 모형의 은 0.8972이고, 세 가지중 두 가지(TV, Radio)를 사용해 예측하는 모형의 은 0.89719이다.
앞서 newspaper은 sales와 연관성이 없다는 것을 p-값이 유의하지 않다는 것을 통해 알 수 있었지만 해당 변수가 포함되었을 때 이 아주 조금 증가했다.
이처럼 연관성이 없는 변수일지라도 변수를 모형에 추가할 때마다 은 항상 증가함을 알 수 있다.
왜냐하면 추가된 변수가 훈련 데이터의 잔차제곱합을 감소시키기 때문이다.
예측변수 newspaper을 추가해도 소폭의 의 증가를 보이는 양상이 확인된다면, 이 변수를 제외할 수 있는 증거로 할 수 있으며, 해당 변수는 과적합이 발생해 테스트 표본에서 좋지 않은 결과를 얻을 수 있다.
다음은 RSE이다.
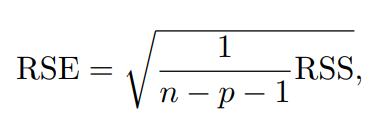
RSE가 작은 예측변수를 포함하는 모형을 선택하는 것이 모형적합도를 향상시킬 수 있다.
하지만 RSS의 감소보다 p증가에 비해 상대적으로 작을 경우, 설명력없는 예측 변수를 추가하더라도 RSE가 증가할 수 있다.
두 방법 이외에도 데이터를 그래프로 그리는 것 또한 유용할 수 있다.
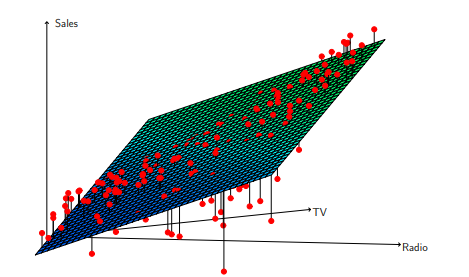
[그림 3.5] 예측변수가 TV, Radio인 선형회귀모형을 적합한 결과
일부 관측치는 최소제곱 회귀평면 위로, 일부 관측치는 최소제곱 회귀평면 아래로 있는 것을 알 수 있다.
이 선형모형은 광고 비용 대부분이 TV 또는 Radio 어느 한쪽으로만 주로 지출된 경우 sales를 과대추정하는 것으로 보인다. 예산이 두 매체로 나누어진 경우에는 sales를 과소평가하고 있다.
빨간 점이 위에 있는 경우: TV와 Radio를 함께 사용했을 때의 시너지 효과를 과소추정하고 있음
빨간 점이 아래에 있는 경우: TV나 Radio중 하나만 사용해도 높은 sales를 반영한다는 오판에 대한 과대추정을 하고 있음.
4) 예측
다중회귀모형을 적합한 후 예측변수의 값 집합을 기반으로 반응변수 를 예측할 수 있다. 그러나 이 예측과 관련해서 세 가지의 불확실성이 있다.
-
우리가 구한 계수 추정값을 통해 구한 최소제곱평면은 다음과 같다.
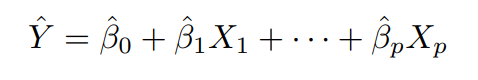
하지만 참 모집단 회귀평면은 다음과 같다.
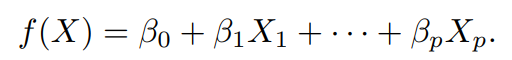
최소제곱평면은 참 모집단 회귀평면에 대한 추정이므로 이에 대한 부적확성은 축소가능 오차(reducible error)과 관련이 있다. 이는 신뢰구간을 계산해 얼마나 가까운지 결정할 수 있다.
-
실제로 가 선형모형이라고 가정하는 것은 모형 편향(model bias)이라고 하는 잠재적 축소가능 오차가 추가될 가능성이 있다.
-
이 모든 참 값을 알고 있다고 해도 축소 불가능항 오차인 랜덤한 오차항의 존재가 있기 때문에 반응변수 값을 완벽히 예측할 수 없다.
따라서 축소가능 오차, 축소불가능 오차를 모두 고려한 예측구간 는 항상 신뢰구간보다 넓다.
