본 포스팅의 내용은 Gareth James, Daniela Witten, Trevor Hastie, Robert Tibshirani, Jonathan Taylor (2023), 「An Introduction to Statistical Learning with Applications in Python」, Springer 를 참고하였습니다.
3.3.1 질적예측 변수
지금까지 논의에서는 선형회귀모형의 모든 변수를 양적변수(quantitiative variable)이라고 가정했지만,
실제 상황에서는 일부 예측변수가 질적변수(qualitative variable)인 경우가 많다.
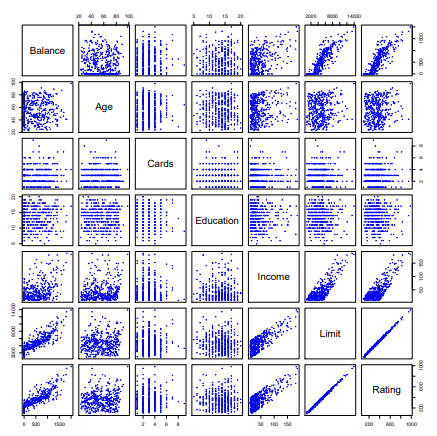
[그림 3.6] 질적 예측변수를 포함한 다양한 산점도 행렬
다음 Credit 데이터 세트는 여러가지 양적 변수, 질적 변수를 함께 나타낸 산점도 행렬을 알아보자.
두 수준으로 이루어진 예측변수
주택소유 여부(own)에 따라 신용카드 잔액의 차이를 조사하는 경우를 생각할 때,
질적 예측변수가 단지 두 수준(level)일 때, 해당 변수를 회귀모형에 포함하는 일은 매우 간단한다.
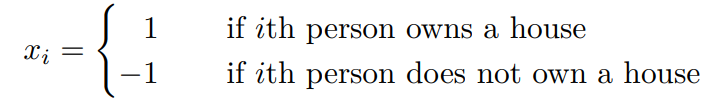
이 변수를 회귀식에서 예측변수로 사용하면 다음과 같은 모형이 된다.
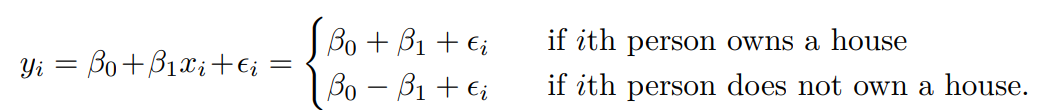
여기서 -1을 0으로 한다면 는 주택이 없는 사람의 신용카드 잔액, 는 주택이 있는 사람의 신용카드 잔액이라고 할 수 있고,
를 소우자와 비소유자 사이의 평균 신용카드 잔액의 차이라고 할 수 있다.
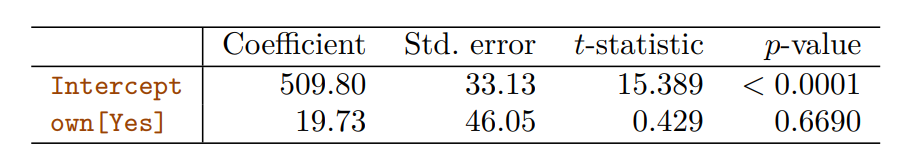
하지만 모형의 p-값을 보면 매우 높은 것을 알 수 있고, 이는 주택 소유 여부에 따른 평균 신영카드 잔액의 차이에 대한 통계적 증거가 없음을 알 수 있다.
소유자/비소유자를 1/0이 아닌 1/-1로 코드화를 바꾸는 것이 통계적 증거를 바꿀 수는 없다.
수준이 여러 개인 질적 변수
region(동부, 서부 , 남부)같은 level이 3개인 질적 변수는 어떻게 해야할까?
첫 번째 가변수는 다음과 같다.
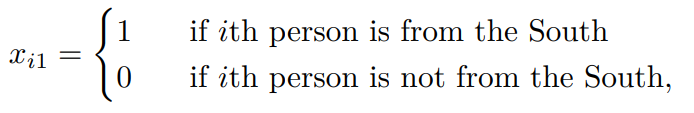
두 번째 가변수는 다음과 같다.
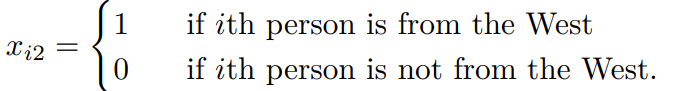
이 두 변수를 이용해 회귀식에 사용하면 다음과 같은 모형을 얻을 수있다.
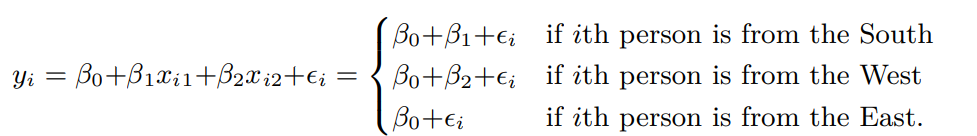
는 동부 출신의 개인들의 평균 신용카드 잔액, 은 남부와 동부의 차이, 는 동부와 서부의 평균 잔액차이로 해석될 수 있다.
이처럼 가변수의 개수는 항상 수준의 개수보다 하나 적다.
가변수가 없는 수준은 기준범주(baseline)이라고 한다.
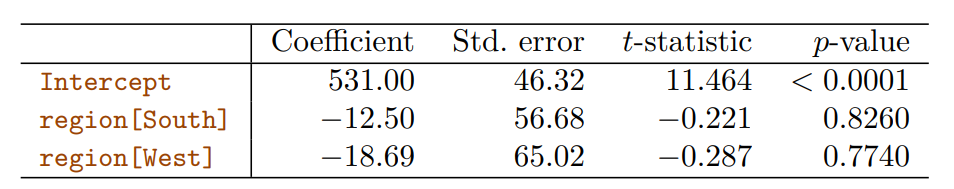
여기서 기준범주는 동부 출신이고, 값은 $531인 것을 알 수 있다. 또한 두 가변수에 대한 p-value가 높으므로, 다음과 같이 해석할 수 있다.
- 동부, 남부 출신 사이에 개인별 평균 신용카드 잔액의 차이에 대한 통계적 근거는 없다.
- 동부, 서부 출신 사이에 개인별 평균 신용카드 잔액의 차이에 대한 통계적 근거는 없다.
하나의 수준을 기준범주로 임의선택을 할 수 있고, 어떤 집단을 선택하던 간에 최종 예측은 동일하지만, 계수와 p-value는 달라진다.
이렇게 개별 계수에 의존하는 대신 F-검정을 이용하면 가변수 코딩에 의존하지 않아도 된다.
3.3.2 선형 모형의 확장
표준 선형회귀모형은 해석 가능한 결과를 제공하며 많은 실세계 문제에서 작동하기도 한다.
하지만 몇 가지 제한적인 가정이 필요하다.
예측변수와 반응변수 사이의 관계에 대한 가장 중요한 가정 두 가지는 가법성(additivity)와 선형성(linearity)이다.
- 가법성 가정: 예측변수와 반응변수 사이의 연관성이 다른 예측변수 값에 의존하지 않는다는 것
- 선형성 가정: 예측변수의 한 단위 변화와 연관된 반응변수의 변화가 반응변수의 값에 관계없이 일정하다는 것이다.
여기에서는 간략하게 몇 가지 고전적인 접근법을 이용해 선형모형을 확장하는 방법을 살펴본다.
가법성 가정 제거하기
이전 장에서 Advertising 데이터 분석에서 한 광고 매체 비용 증가가 판매량에 미치는 효과는 다른 매체와는 독립이라고 가정했을 때, TV와 radio가 sales와 관련이 있다는 결론이 도출되었다.
하지만 이 단순모형이 틀릴 수도 있다.
라디오 광고에 돈을 썼을 때 TV 광고의 효과성이 증가해 기울기 항에 영향을 준다는 경우를 생각해보자.
이 경우, 예산이 $100,000일 때, 양 매체에 절반씩 지출한다면 어느 한 매체에 전액 투자하는 경우보다 높은 sales를 이끌어낼 수 있다.
마게팅에서는 이를 시너지(synergy)효과라고 하고, 통계학에서는 상호작용(interaction)효과라고 한다.
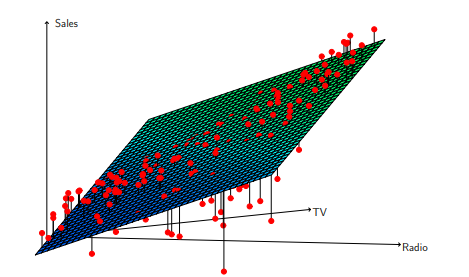
[그림 3.5] 예측변수가 TV, Radio인 선형회귀모형을 적합한 결과
실제로 TV 또는 radio의 수준이 낮을 때는 sales의 참 값이 선형모형이 예측하는 것보다 낮다.
하지만 광고를 두 매체로 분할했을 때는 모형이 sales를 과소평가하는 경향을 보인다.
변수가 두 개인 표준 선형회귀모형을 보자.
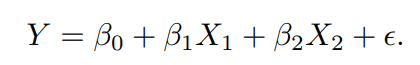
이 모형에 따르면 의 한 단위 증가는 평균을 만큼 늘린다고 해석할 수 있고, 의 존재가 이를 부정하는 것은 아니다.
이 모형을 확장하는 방법 중 한 가지는 '상호작용 항'이라는 세 번째 예측변수를 포함하는 방법이다.
이 변수는 ,의 곱으로 만들어진다.
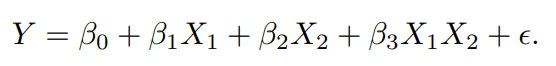
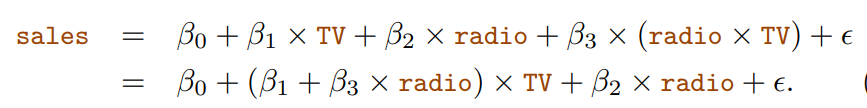
이는 다음과 같이 다시 쓸 수 있다.
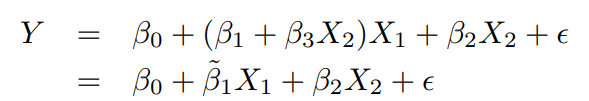
예) 생산 lines의 수와 총 workers의 수를 기반으로 생산된 units의 수를 예측하려고 한다.
여기에서 생산 lines이 아무리 많아도 workers가 없으면 units생산이 안 되고, 반대로 workers가 많아도 생산 lines이 없으면 units 생산이 안 된다. 따라서 이 둘을 상호작용 관계라고 할 수 있다. 이를 통해 선형 회귀모형을 확장해보자.

다시 돌아와서 Advertising 데이터 예제에서의 상호작용을 반영한 선형회귀모형을 다음과 같다.
다음은 회귀모형을 적합한 결과이다.
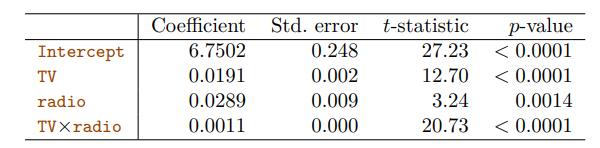
이 모형이 주 효과(main effect)만 포함하는 모형보다 확실히 우월한 결과를 보여준다. 또한 상호작용 항의 p-value가 매우 낮은 것은 의 강력한 증거이다.
또한 이 모형의 은 로 기존의 모형 과 확실히 대비가 된다.
이는 가법 모형을 적용한 후 남아 있는 sales 변동의 가 상호작용 항으로 설명되었다는 것을 의미한다.
이 예제에서는 세 변수가 모두 통계적으로 유의하므로 모두 모형에 포함해야한다.
하지만 상호작용 항의 p-값이 매우 작지만 관련된 주효과(TV, radio)는 그렇지 않은 경우가 있다.
계층 원칙(hierarchical principle)에 따르면 상호작용을 모형에 포함하면 주효과의 계수와 연관된 p-value가 유의하지 않더라도 주효과에 포함해야한다.
이러한 원칙은 상호작용항이 반응변수와 관련이 있다면 주 효과의 계수가 정확히 0인지 아닌지는 중요 관심사가 아니라는 논리를 근거로 한다.
또한 상호작용항은 일반적으로 주효과와 상관관계에 있으므로 이 둘을 제외하면 상호작용의 의미가 변경되는 경향이 있다.
이전은 양적변수+양적변수 간의 상호작용이었다면 이번에는 양적변수+질적변수이다.
이또한 마찬가지로 적용된다.
이전의 Credit 데이터에서 양적변수 income과 질적변수 student를 사용해 balance를 예측하는 경우를 가정하자. 상호작용이 없는 모형은 다음과 같다.
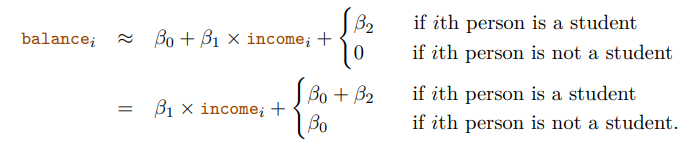
다음은 income과 student의 가변수를 곱해 만든 상호작용 변수를 추가했을 때 모형이다.
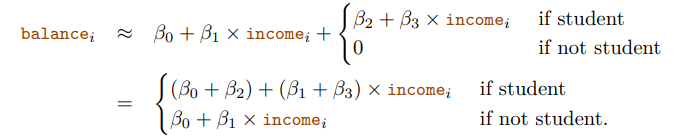
다음은 상호작용항의 유무에 따른 선형회귀 적합결과이다.
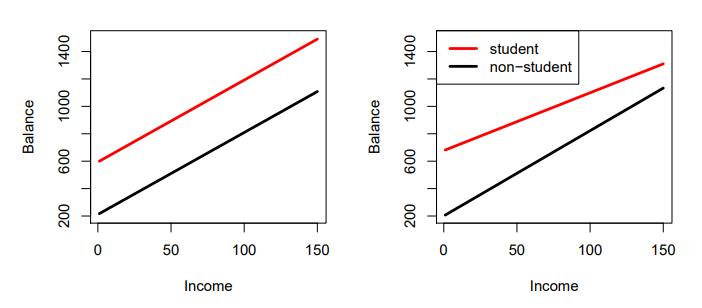
[그림 3.7] Credit 데이터에 대한 최소제곱선: 상호작용의 유무에 따른 변화
왼쪽은 income의 증가가 student의 상태 유무와는 관계없이 신용카드 잔액(balance) 증가에 기여를 한다.
오른쪽은 두 변수의 상호작용항을 고려해 만든 최소제곱선이다.
이는 수입의 변화가 학생/비학생의 신용카드 잔액에 다르게 영향을 미칠 수 있는 가능성을 시사한다.
학생의 기울기보다 비학생의 기울기가 더 가파르다는 것은 수입의 증가가 학생에 비해 비학생의 더 많은 신용카드 잔액의 증가와 연관이 있음을 알 수 있다.
비선형관계
경우에 따라 반응변수와 예측변수 사이의 참 관계가 비선형일 수도 있다. 따라서 여기서는 다항회귀(polynomial regression)을 사용해 비선형 관계를 포함하도록 선형모형을 직접 확장하는 간단한 방법을 제시한다.
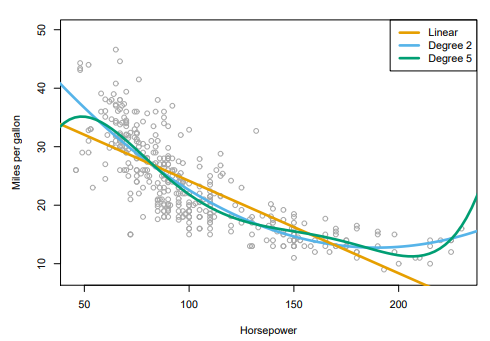
[그림 3.8] Auto 데이터 세트. 여러 대의 자동차에 대한 mpg와 horse power가 표시되어있다.
이 그림은 Auto 데이터 세트에 있는 여러 대의 자동차에 대한 mpg(갤런당 마일로 측정된 가스 마일리지)와 horsepower(마력)이 표시되어 있고, 오렌지 색이 선형회귀 적합 결과이다.
두 변수 간에 관계는 뚜렷함을 알 수 있지만 관계가 선형관계보다는 비선형관계, 곡선 형태임을 알 수 있다.
선형모형에 비선형 연관성을 포함하는 간단한 접근법은 예측변수의 변환 버전을 포함하는 방법이다.
다음 그림의 점들은 이차(quadratic)형태인 것처럼 보이므로 다음과 같은 형태의 모형을 가정할 수 있다.

식은 horsepower의 비선형함수를 통해 mpg를 예측하고 있지만 이 식은 여전히 선형회귀모형이다.
, 을 만족하는 단순한 다중선형회귀모형이다.
이를 통해 적합한 비선형 적합은 파란색 곡선으로 오렌지 색보다 상당히 값에 근접하다.
(녹색 곡선은 5차 항까지 했을 때의 적합이다)
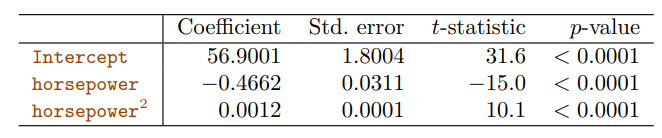
이차 적합의 , 선형 적합은 이다.
그리고 p-value 또한 이차항에서 매우 유의하게 나타난다.
왜 2차항까지만 포항하고, 3차,4차,5차항까지 포함하지 않을까?
앞선 그림과 같이 너무 많은 차항까지 포항하게 된다면 최소제곱선은 불필요하게 구불구불해지며 이는 더 나은 데이터에 대한 적합으로 이어지지는 않는다.
방금 설명한 방식에 대한 접근법을 다항회귀라고 하는데, 예측변수의 다항함수를 선형모형에 포함하기 때문이다.
3.3.3 잠재적인 문제들
이번에는 특정 데이터 세트에 선형회귀모형을 적합할 때 여러 문제가 발생할 수 있고, 흔한 문제에 대해 알아보자.
- 반응-예측변수 관계의 비선형성
- 오차항 사이의 상관성
- 오차항의 분산이 상수가 아님
- 이상점
- 높은 영향력(지렛값)을 가지는 점들
- 공선성
1) 데이터의 비선형성
잔차 그래프(residual plot)는 비선형성을 식별하는 유용한 그래픽 도구이다.
단순선형회귀모형이 있으면 잔차 대 예측변수 의 그래프를 그릴 수 있다.
다중회귀모형은 예측변수가 여러 개이므로 대신 잔차 대 예측값(또는 적합값(fited value)) 그래프를 그린다.
이상적인 경우 잔차그래프에서는 눈에 띄는 패턴이 나타나지 않는다.
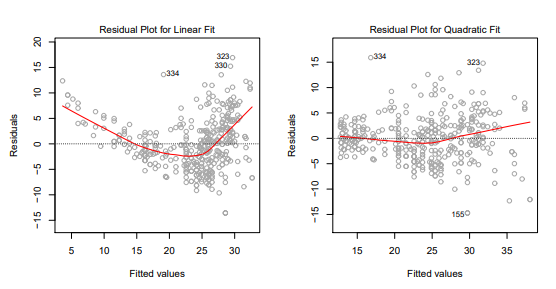
[그림 3.9] Auto 데이터 세트의 잔차 대 예측값 그래프.
빨간색 선은 잔차에 대한 평활 적합(smooth fit)으로 쉽게 추세를 식별하기 위해 표시한 것이다.
왼쪽 그래프는 잔차는 분명한 U-자형을 보인다. 이는 데이터의 비선형성을 드러내는 것이다.
반면에 오른쪽 그래프는 이차항을 포함하는 모형에서 나온 잔차 그래프를 제시한 것이다.
이는 왼쪽 그래프보다 패턴이 나타나지 않으며, 즉 이차항이 데이터에 대한 적합을 개선했다는 것을 알 수 있다.
이렇게 잔차 그래프가 데이터에 비선형 연관성이 있을 때, 단순하게는 예측변수의 비선형 변환을 통해 해결하는 방법이 있다.
2) 오차항 사이의 상관관계
선형회귀의 중요한 가정은 오차항 이 무상관(uncorrelated)이라는 것이다.
하지만 실제로 오차항 사이에 상관관계가 있다면 추정된 표준오차는 실제 표준오차를 과소추정하는 경향이 있다.
결과적으로 표준오차를 통해 구한 신뢰구간은 실제 참값을 포함할 확률이 0.95보다 훨씬 낮을 수 있다.
또한 모형과 관련된 p-value도 실제보다 낮아 통계적으로 유의하다고 잘못 결론 내릴 수 있다.
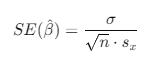
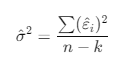
오차항의 표준편차(𝜎)가 작아지면, SE도 작아져서 신뢰구간이 좁아짐.
오차항을 구할 때, 잔차를 이용해 구하게 되고 오차항과 가 상관관계가 있다면 과소추정할 수 있다.
오차항 사이의 상관관계는 시계열 데이터에서 자주 나타난다.
인접한 시점에서 얻은 관측들 사이에는 많은 경우 양의 상관관계를 가진다.
오차항 사이의 양의 상관관계가 있다면 잔차에서 트래킹(tracking)을 발견할 수 있다.
즉, 인접한 잔차들이 비슷한 값을 갖는 경향을 가진다.
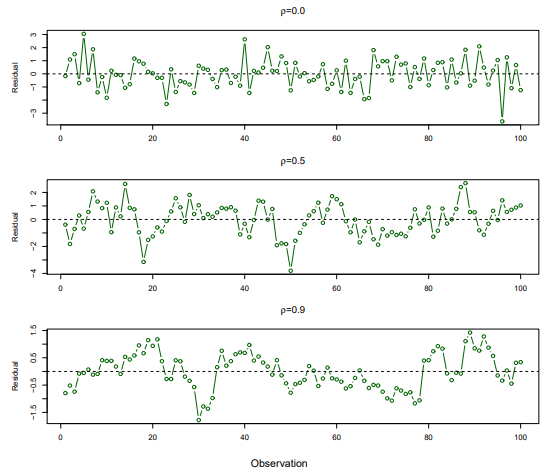
[그림 3.10] 인접한 시점에서 오차항의 상관관계. 의 정도를 다르게 해 모의 생성한 시계열 데이터 세트에서 나온 잔차 그래프.
맨 위 그래프는 무상관 오차항으로 생성된 데이터에 대한 선형회귀적합의 잔차이다.
맨 아래 그래프는 오차항이 0.9의 상관관계를 가질 때 보이느 데이터 세트에서 나온 잔차이다.
여기에서는 잔차에 뚜렷한 패턴이 있다. 이접한 잔차들은 비슷한 값을 가지는 경향을 보인다.
따라서 오차항 사이에 상관관계가 없단는 가정은 선형회귀 뿐만 아니라 다른 통계 방법에서도 매우 중요하며, 이런 상관관계의 위험을 완화하기 위해서는 좋은 실험 설계가 필수적이다.
(헤테로스케다스틱 견고 표준오차, 2단계 최소자승법, 도구변수 회귀 등)
3)이분산 오차항
선형회귀모형의 또 다른 중요한 가정은 오차항들의 분산 이 일정하다는 점이다.
표준오차, 신뢰구간, 가설검정은 이 가정에 의존한다.
하지만 오차항들의 분산이 반응변수 값의 크기에 따라 증가하는 경우가 있다. 비상수 분산 또는 이분산성(heteroscedasticity)를 확인하려면 잔차 그래프에서 '깔대기 모양'이 존재하는지 보면 된다.
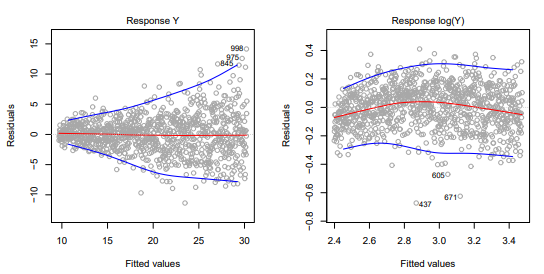
[그림 3.11] 잔차 그래프. 잔차의 이분산성을 확인하기 위한 예제
오른쪽 그래프는 반응변수를 를 사용해 변환한 잔차 그래프이다.
약간의 비선형성이 있지만 일정한 분산을 가지는 것처럼 보인다.
이를 해결하는 해결책 중 하나는 가중최소제곱(weighted least squares)을 이용하는 방법이 있다.
가중최소제곱은 분산의 역수에 비례해 가중치를 주는 방법으로 이 경우에는 를 가중치로 줄 수 있다.
선형회귀 소프트웨어는 대부분 관측 가중치를 허용한다.
4) 이상점
이상점은 가 모형으로 예측한 값과 크게 다른 경우이다.
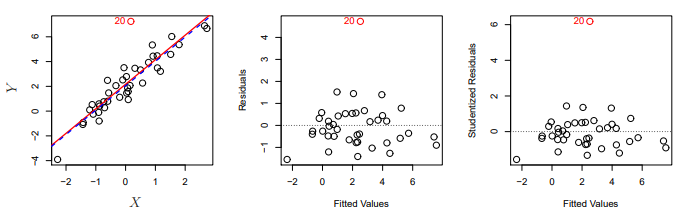
[그림 3.12] 왼쪽: 최소제곱 회귀선, 가운데: 잔차 그래프, 오른쪽: 이상점의 스튜던트화 잔차
빨간색 점은 전형적인 이상점의 예시이다.
빨간색 실선은 최소제곱 회귀 적합 결과이고 파란색 파선은 이상점을 제거한 후 최고제곱 적합 결과이다.
기울기는 거의 변하지 않으며, 절편만 미미하게 변화한다.
이상점이 최소제곱선에 큰 영향을 주지 않더라도, 다른 문제를 일으킬 수 있다.
예를 들어 RSE가 1.09이지만, 이상점을 제거했을 때, 0.77이 된다.
RSE는 신뢰구간과 p-value를 계산하는데 쓰기 때문에 이렇게 큰 변화는 결과 해석에 영향을 줄 수 있다.
마찬가지로 이상점을 포함하면 이 0.892 -> 0.805로 감소한다.
잔차 그래프는 이상점을 식별하는 데 사용될 수 있다.
그러나 실제 상황에서 어느 정도를 이상치로 판단하기 어려움이 있기 때문에 각각의 잔차 를 표준오차 추정값으로 나누어 계산한 스튜던트화 잔차(studentized residual)를 그릴 수 있다.
스튜던트화 잔차의 절대값이 3보다 큰 관측은 이상점일 가능성이 있다.
이상점이 데이터 수집이나 기록의 오류로 발생했다고 믿는다면 한 가지 간단한 해결책은 관측값을 제거하는 것이다.
다만 이상점은 예측변수의 누락 같은 모형의 결함을 나타낼 수 있기 때문에 주의해야한다.
5) 높은 지렛점
이상점은 예측변수 가 있을 때 반응 가 특이한 관측이다.
반면에 높은 지렛값(high leverage)는 의 값이 특이한 관측이다.
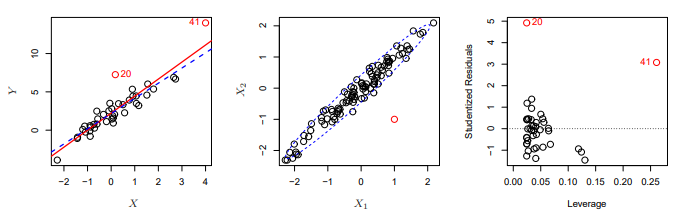
[그림 3.13] 높은 지렛점과 관련된 예제.
41번 빨간색 관측은 20번 관측에 비해 예측변수의 값이 커짐에 따라 높아진 지렛값이다. 파란색 파선은 41번 관측을 제거했을 때 적합결과이다.
이전 그림에 비해 높은 지렛값을 제거했을 때 최소제곱선에 더 큰 영향을 줄 수 있다는 것을 알 수 있다.
단순선형회귀에서는 지렛값이 높은 관측을 상당히 쉽게 식별할 수 있다.
그러나 예측변수가 많은 다중회귀에서는 개별 예측변수에는 정상적인 범주에 있지만 전체 예측변수 세트라는 차원에서는 특이한 관측일 수 있다.
가운데 그림은 , 를 모두 고려했을 때 높은 지렛점을 관측함을 알 수 있다.
한 개의 예측 변수만을 확인했을 때는 알 수 없을 수도 있는 결과이다.
한 관측의 지렛값을 계산하기 위해 제릿값 통계량(leverage statistics)을 이용한다. 이 통계량이 크면 지렛값이 높은 관측이라는 뜻이다. 단순선형회귀의 경우에는 다음과 같다.
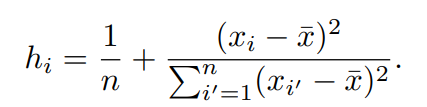
이 식에서 는 가 로부터 멀어질수록 증가한다는 것이 명확하다.
는 항상 과 1사이의 값이며, 주어진 관측의 지렛값 통계량이 을 크게 초과한다면 해당 점이 높은 지렛값을 가지는 점이라고 예상할 수 있다.
오른쪽 그림은 스튜던트화 잔차 대 의 그래프를 제시한다.
41번 관측의 지렛값 통계량과 스튜던트화 잔차가 높은 것이 눈에 띈다.
41번 관측은 지렛값이 높을 뿐만 아니라 이상점이기도 하다.
6) 공선성
공선성(collinearity)은 두 개 이상의 예측변수가 서로 밀접하게 관련되어 있는 상태를 말한다.
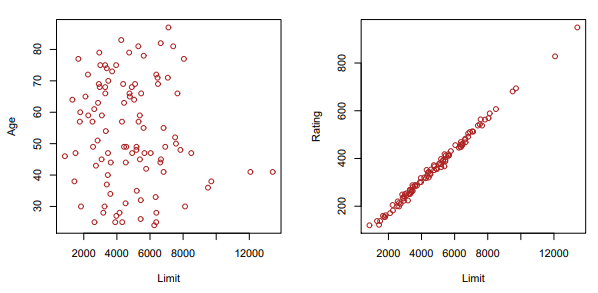
[그림 3.14] Credit 데이터 세트에서 관측값의 산점도
왼쪽 그림을 보면 Limit 변수와 Age 간의 뚜렷한 관계가 없어 보인다.
오른쪽 그림의 예측 변수 Limit와 Rating은 매우 높은 상관을 보이기 때문에 '공선성'을 보인다고 할 수 있다.
공선성이 있으면 공선변수(collinear variable)들의 개별적인 효과를 반응변수와 분리하기 어렵기 때문에 회귀분석 상황에서 문제를 일으킬 수 있다.
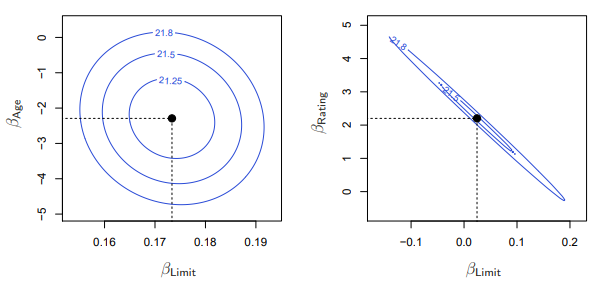
[그림 3.15] Credit 데이터 세트에 다양한 회귀분석을 수행할 때 모수 의 함수로 표현되는 RSS 값의 등고선 그래프이다.
다음 그림은 공선성으로 발생할 수 있는 몇 가지 어려움을 보여준다.
왼쪽 그림은 balance를 limit와 age로 회귀한 서로 다른 가능한 계수 추정값에 대한 RSS 등고선 그래프이다.
이 축은 최대 표준오차의 네 배까지 가능한 계수 추정값을 포함하도록 그렸다.
예를 들어 참 limit 계수는 틀림없이 0.15 ~ 0.20 사이에 있을 것이다.
반면에 오른쪽 그림은 공선성이 매우 높다는 것을 알 수 있다.
여기서 limit 계수는 -0.2 ~ 0.2 사이로 확장된다.
limit 계수와 rating 계수의 개별적인 불확실성은 더 커졌지만, 거의 확실히 이 등고선 계곡 어딘가에 위치할 것이다.
공선성은 회귀계수 추정값이 정확도를 감소시키기 때문에 의 표준오차를 증가시킨다.
또한 각 예측변수의 t-통계량은 를 그 표준오차로 나누어 계산한다.
따라서 공선성은 t-통계량을 감소시키다.
이는 결과적으로 공선성이 있을 때, 귀무가설을 기각하지 못할 수 있다.
다시 말해, 가설검정의 검정력(power), '영이 아닌' 계수를 정확히 찾아낼 확률이 공선성으로 감소된다.
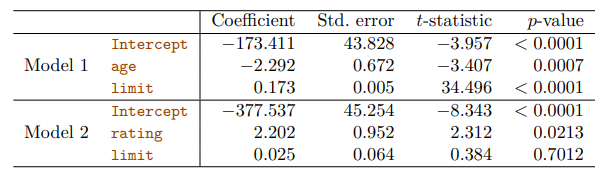
이 표는 두 개의 개별적인 다중회귀모형에서 얻은 계수 추정값을 비교하고 있다.
첫 번째표는 p-value가 낮으므로 유의하다고 볼 수 있다.
두 번째 표는 두 변수 사이의 공선성이 있는 변수 간의 모델으로, limit변수의 표준오차가 12배 가량 증가했고, p-value값 또한 매우 높다.
즉, limit 변수의 중요성이 공선성으로 인해 가려진 것이다.
이러한 상황을 피하기 위해서는 모형을 적합할 때 잠재적으로 공선성 문제가 있는지 확인하고 해결하는 것이 좋다.
공선성을 감지하는 간단한 방법은 예측변수들의 상관행렬을 보는 것이다.
이 행렬의 어떤 원소가 절댓값이 크다면 상관관계가 높은 변수 쌍이라는 뜻으로 데이터에 공선성 문제가 있음을 알 수 있다.
하지만 모든 공선성 문제가 상관행렬을 검토해서 찾아낼 수 있는 것은 아니다.
변수 쌍 사이에는 상관관계가 특별히 높지 않더라도 세 개 이상의 변수 사이에 공선성이 존재할 수 있다.
이러한 상황을 다중공선성(multicollinearity)이라고 한다.
다중공선성을 평가하는 더 나은 방법은 분산팽창인자(VIF, variance inflation factor)를 계산하는 것이다. VIF는 전체 모형을 적합할 때 의 분산을 단독으로 적합했을 때의 분산으로 나눈 값이다.
VIF 최솟값은 1이며, 이는 공선성이 전혀 없음을 나타낸다.
보통 실제 예측변수 사이에는 약간의 공선성이 있다.
경험적으로 5 또는 10을 초과했을 때 문제가 있음을 나타낸다.
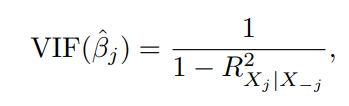
다음 식은 VIF를 계산하는 식이다.
여기서 분모는 를 다른 모든 예측변수로 회귀할 때의 이다.
공선성 문제를 직면했을 때 두 가지 간단한 해결방법이 있다.
먼저 문제가 되는 변수 중 하나를 제외하는 방법이다.
두 번째 방법은 공선성 변수들을 하나의 예측변수로 결합하는 방법이다.
예를 들어 limit와 rating의 표준화된 버전에서 평균을 취해 '신용 가치'를 측정하느 새 변수를 만들 수 있다.
