Docker 기반 OpenRouteService를 활용한 도보 소요 시간 계산(4)
1. TimesNet을 통한 성능지표 확인
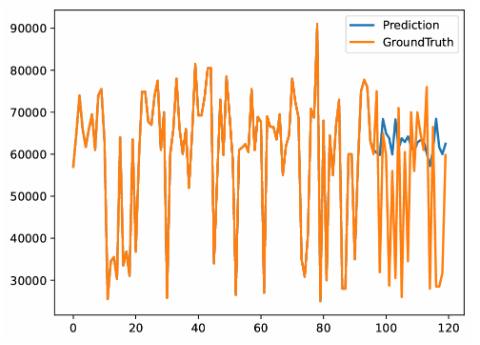
이전까지 모은 데이터셋을 활용해서 TimesNet 모델을 이용해 분석을 진행해보았고, 성능은 다음과 같았다.
(파라미터는 TimesNet 논문의 기반 모델의 틀은 유지하고, 데이터셋의 특성에 따라 일부만 변형하였다.)
array([1.3796588e+04, 2.9077901e+08, 1.7052244e+04, 3.4556463e-01,
       2.5386664e-01], dtype=float32)
예측값이 실제 값을 따라가지 못하고, 극값에 반응을 어려워한 것으로 나타났다.
또한 성능 지표도 매우 좋지 못했는데, 5가지 지표에서 다음과 같다. (단위: 만 원)
- Mae: 13,796
- Mse: 290,779,010
- Rmse: 17,052
- Mape: 0.34
- mspe: 0.25
또 다른 분석으로 다중선형 회귀분석을 통해 성능지표를 확인해보았다.
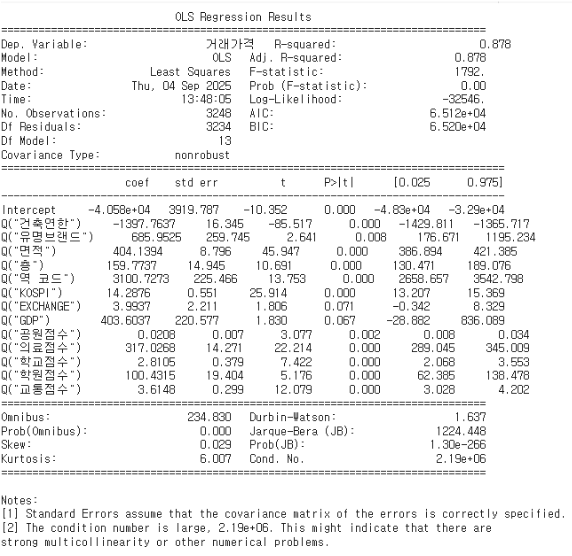
두 개정도의 변수를 제외하고 통계적으로 유의했으며, 모델의 결정계수(0.878)으로 TimesNet의 모델에 비해 높은 성능 지표가 나왔으며, 단순한 모델을 사용했을 때보다 낮은 성능의 TimesNet 모델 성능이 나왔다.
2. 원인 분석
TimesNet의 낮은 성능의 원인을 찾기 위해 문제점에 대해 차례대로 생각해보았다.
- 데이터셋 자체의 문제(접근도 변수 수집 과정에서의 문제점)
- TimesNet 모델을 돌리기전 데이터셋 포맷 전처리 문제
- 시계열 데이터에 따른 데이터셋 포맷 불일치 문제
2.1. AI Studio - Auto Model
Altair에서 개발한 AI Studio를 활용해 여러 모델을 한 눈에 확인할 수 있도록 했다.
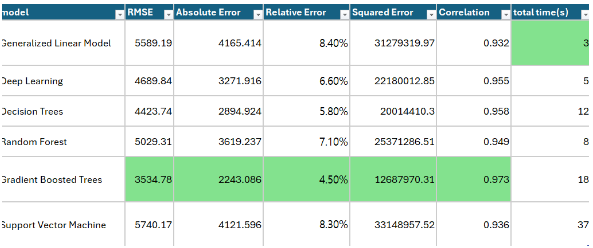
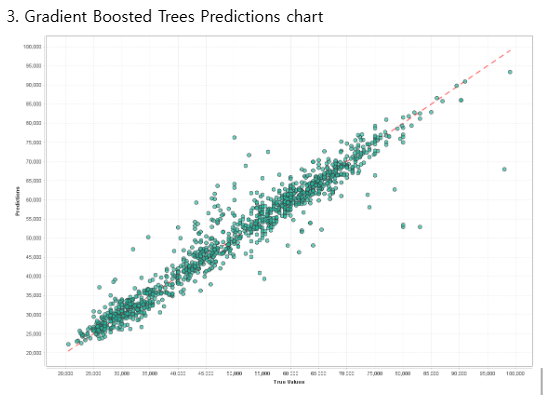
총 6개의 모델을 통해 성능 지표를 간단히 확인할 수 있었다. 이 중에서 트리 기반의 GBT 모델이 가장 성능이 높았으며,
기존 TimesNet에 비해 훨씬 성능 높은 것을 알 수 있었다.
(RMSE: GBT - 3534 / TimesNet - 17,052)
따라서 데이터셋의 수집과정이 TimesNet의 유독 낮은 성능을 대표하지 않은 것으로 판단했다.
2.2. 데이터셋 전처리 문제
데이터셋의 전처리 포맷을 확인하기 위해 TimesNet 모델의 코드를 보며 문제점을 확인해보았다.
먼저 데이터셋은 scaling 기능이 모델 안에 있기 때문에 원 상태로 들어가야 한다.
    def __read_data__(self):
        self.scaler = StandardScaler()
        df_raw = pd.read_csv(os.path.join(self.root_path,
                                          self.data_path))
또한 유명 브랜드 여부(0,1), 역 코드(0,1,2) 같은 범주형 변수를 더미변수로 바꿔주는 코드가 없어 사전에 바꿔주어야 한다.
다변수일 경우, 변수의 날짜에 대한 동일한 시간축을 적용해 진행해야한다.
위와 같이 데이터셋에 대한 전처리는 문제되지 않은 것으로 파악했다.
2.3. 시계열 데이터 특성에 따른 데이터 전처리
시계열 데이터는 다음과 같은 필수적으로 만족해야하는 가정이 있는데 정상성(stationarity)이다.
이는 시계열 데이터는 다음과 같은 조건을 만족해야 하고, 만족하지 않을 경우 조치를 취해야한다.
- 모든 시점에 대한 일정한 평균을 가지며, 차분을 통해 정상화시킨다.
- 모든 시점에 대한 일정한 분산을 가지고, 변환을 통해 정상화시킨다.
- 공분산 또한 시차에만 의존할 뿐, 특정 시점에 의존하지 않는다.
실제 데이터는 정상성 시계열 데이터보다는 비정상 시계열 데이터가 많으므로 전처리를 통해 시계열 데이터를 분석해야한다.
또한 데이터가 계절성, 주기성 등을 가지는 경우가 많이 때문에 확장된 모델을 통해 제거를 할 수 있다.
따라서 정상성을 만족하지 못한다면, 특정 기간에 대한 시계열 데이터로 다른 시기로 일반화할 수 없다.
나는 여기서 나의 데이터셋 자체가 잘못됨을 알 수 있었다.
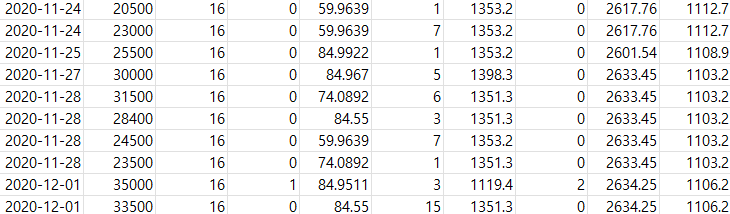
모든 가정은 "모든 시점"에 대한 일정한 평균, 분산, 공분산을 만족해야 한다는 것이다.
이 가정에 기반해서 나의 데이터셋에는 두 가지 문제점이 있음을 알 수 있었다.
- 모든 날짜에 대한 데이터셋이 갖춰지지 않았다.
- 중복된 날짜 아파트 거래 건수 존재
첫 번째 문제점은 전체 구간에 대한 학습이 진행되어야 정상성 추정이 안정되며, 예측력이 올라가기 때문에 개선이 필요하다.
두 번째 문제점은 많은 시계열 데이터 분석 모델에 해당되는데, 많은 시계열 데이터 모델은 데이터를 읽을 때, "시점(time step)이 등간격"이라고 가정해 "각각의 row마다 다른 시간"이라고 인식한다.
따라서 데이터셋에 중복의 날짜 아파트 거래 건수를 모델에서는 개별 시간대의 아파트 거래라고 판단한다.
결측의 경우에는 Nan값 처리를 하거나 보간 방법을 통해 해결이 가능하고,
중복의 경우에는 같은 시점에 대한 아파트 거래내역을 하나로 합쳐야 한다.
전자는 상대적으로 쉽게 해결이 가능하지만, 후자는 각각의 변수를 어떠한 기준으로 합쳐야하는지에 대한 근거가 필요하기 때문에 쉽지 않다고 생각했다.
따라서 TimesNet 낮은 성능에는 위의 결측과 중복된 날짜의 데이터가 대부분이기 때문에 발생했다고 판단하는 것이 합리적이다.
3. 개선점
따라서 이러한 문제점을 개선할 방법을 생각해보았다.
- 시계열 데이터 이외의 데이터 해석이 용이한 데이터 분석 접근법
- 등간격 시계열 데이터가 아닌 데이터셋에서도 분석할 접근법
3.1 Event Study 접근법
FNGUIDE(2013-02-19), “Event Study Manual”에 따르면,
Event Study 접근법은 배당, 유상증자, 합병 및 인수, 이익공시같은 고유 사건들이 주식 가격에 미치는 영향력을 파악하는 방법론이다.
Brown and Warner (1980, 1985), Malatesta (1986) 등 선행 연구가 진행된 전통적인 통계 분석 방법이라고 할 수 있다.
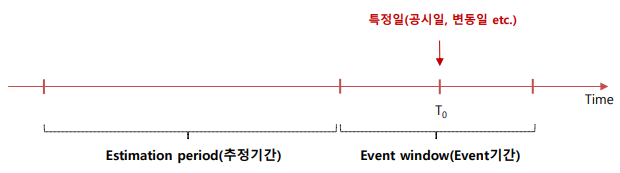
- 추정기간: 특정일에 영향을 받지 않은 구간
(추정기간의 설정 이유는 이 기간 동안의 자료를 이용하여 정상적 기대수익률을 추정하기 위해서이다.) - Event기간: 특정일에 영향을 받은 구간
(예: 공시일(Announcement date)을 중심으로 그 전후의 일정기간)
추정기간을 검증하기 위해서는 평행추세가정이 되어야 한다.
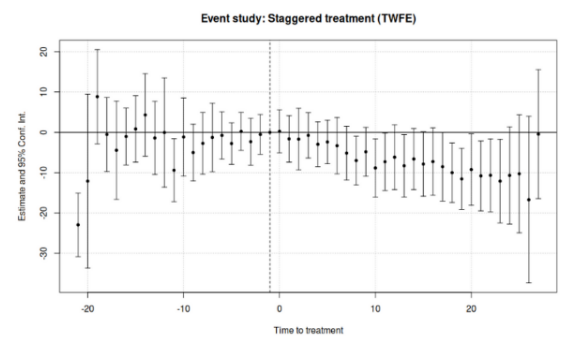
금융 분야에서는 이렇게 정책 이전의 정상적인 수익률을 파악하기 위해 추정기간이 필요하지만,
정책효과 분석 및 부동산 관련 분석에는 이미 다른 변수들이 회귀적합을 통해 시장의 움직임을 표현할 수 있어 따로 필요 없다.
내가 원하는 것은 연장사업을 통해 역세권(예: 10분 기준) 여부에 따른 아파트 가격 변화를 보고 싶은 것이기 때문에 baseline(개통일)로 두고 통제집단과의 비교를 진행했다.