논문 정보: A Comprehensive Survey of Deep Learning for Time Series
Forecasting: Architectural Diversity and Open Challenges
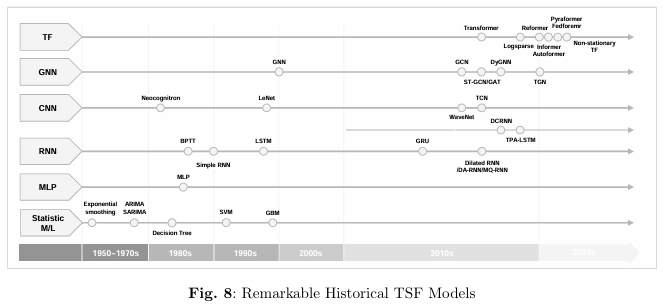
Historical TSF Models
Conventional Methods (Before Deep Learning)
딥러닝이 발전하기 전, 통계적 기법(Statistical Models), 머신러닝(Machine Learning Models)모델이 TSF에 사용.
기존 통계적 모델의 선형 관계 사전 정의 한계로, 비선형 패턴 학습(시계열 데이터 내 복잡한 패턴 포착에 어려움.
-> 사전 정의를 하지 않으며 데이터로부터 직접 비선형 패턴 학습을 하는 머신러닝 기법이 주로 TSF에 사용.
머신러닝 모델들은 전통적인 통계 모델보다 데이터 구조(data structures)와 패턴(patterns)을 더 잘 포착하며, 대규모 데이터셋에서 높은 예측력
데이터의 다양한 특징(feature)과 관계를 자동으로 학습하고 최적화하는 능력 덕분에, TSF에서 광범위하게 활용 중.
지수평활법(Exponential Smoothing)(Brown (1959), Holt (1957), Winters (1960))
1) 과거 데이터의 가중 평균을 이용하여 미래 값을 예측하는 방법.
2) 과거 데이터에 지수적 가중 감쇠(exponential weight decay)를 적용하여 최근 데이터에 더 큰 가중치를 부여함으로써 작동.
자기회귀 누적이동평균모형 (ARIMA),((Box et al., 1970)):
1) 데이터 내의 자기상관성을 활용하여 미래 값을 예측하며, 세 가지 주요 구성요소로 이루어짐.
2) AR, MA, I
-> 자기회귀 (AR) : 과거 값들의 선형 결합을 이용해 현재 값을 예측
-> 이동평균 (MA) : 과거 오차항의 선형 결합을 이용해 현재 값을 예측
-> 누적 (I) : 데이터의 비정상성을 제거하기 위해 차분(differencing) 과정을 거쳐 정상성을 달성.
계절 ARIMA (SARIMA):
1) 계절적 차분(seasonal differencing)과 계절적 자기회귀, 이동평균 요소를 포함함으로써 규칙적인 주기적 패턴을 가진 데이터를 효과적으로 모델링하고 예측.
의사결정나무(Decision Trees) (Quinlan, 1986):
1) classification) or prediction을 수행하기 위해 트리 구조를 사용하는 머신러닝 모델.
2) 직관적이고 해석이 용이하지만, 과적합(overfitting)에 취약.
서포트 벡터 머신(SVM, Support Vector Machines) (Cortes and Vapnik, 1995):
1) classification) 및 regression 분석을 위한 지도학습모델로, 최대 마진을 찾는 것이 특징.
2) high-dimensional data와 non-linearities을 효과적으로 처리하여, classification) 및 regression 작업에서 강력한 성능.
서포트 벡터 회귀(SVR, Support Vector Regression) (Vapnik et al., 1996):
1) SVM 개념을 회귀 문제에 적용한 형태로, 최적의 초평면(optimal hyperplane)을 사용하여 데이터 포인트를 예측.
2) 초평면은 데이터 포인트들 간의 error가 특정 임계값을 초과하지 않도록 훈련.
그래디언트 부스팅 머신(GBM, Gradient Boosting Machines)(Friedman, 2001):
1) 여러 개의 weak models을 하나의 strong predictive model로 결합.
2) 앙상블 학습으로 반복적으로 모델을 개선하여 높은 예측 성능을 제공.
XGBoost (Chen and Guestrin, 2016):
1) Gradient Boosting algorithm의 확장판으로, 효율성과 성능을 향상시키기 위한 다양한 최적화 기법들을 포함.
2) 특히 시계열 예측 대회(time series forecasting competitions)에서 탁월한 성능으로 큰 주목을 받음.
Fundamental Deep Learning Models
딥러닝이 발전하면서 MLP, RNN, CNN, GNN 기반 모델들을 백본모델로 하는 TSF 모델이 발전하게 됨.
다층 퍼셉트론(MLP, Rumelhart et al., 1986) 및 역전파 알고리즘(초기 인공신경망):
1) 비선형 패턴(non-linear patterns)을 모델링하는 데 강력한 성능
2) time series data processing에 이를 적용하려는 시도가 활발히 이루어짐.
3) MLP를 이용한 심층 신경망 학습에 제약
(만들어질 당시에는 statistical methods / machine learning models 모델이 시계열 분석에 주로 사용)
- Limited in learning temporal dependencies
- Vanishing gradient issue
- Lack of data and computing resources
순환 신경망(Recurrent Neural Networks, RNNs) (Hopfield, 1982):
1) 순차 데이터(시계열 데이터) 처리를 위해 설계된 모델, MLP의 한계를 극복하기 위해 고안
2) 입력층(input layer), 은닉층(hidden layer), 출력층(output layer) 구성으로 시간 의존성 문제 해결
3) 시퀀스 길이(sequence length)와 관계없이 모든 시간 단계에서 동일한 가중치 -> parametric efficiency(시계열, NLP에서 활용)
4) RNN의 한계(2000 초반까지 사용되지 못함)
-> Vanishing gradient problem
-> Exploding gradient problem
-> Difficulty in parallel processing
장단기 메모리(Long Short-Term Memory, LSTM) (Hochreiter & Schmidhuber, 1997):
1) RNN의 장기 의존성 문제를 해결하기 위해 고안
2) 셀 상태(cell state)와 입력 게이트(input gate), 출력 게이트(output gate), 망각 게이트(forget gate)로 구성
(gate mechanism을 통해 중요한 정보를 오랜 기간 보존하고 불필요한 정보를 제거)
게이트 순환 유닛(Gated Recurrent Unit, GRU) (Cho et al., 2014):
1) LSTM의 성능을 유지하면서 간결한 구조(update gate와 reset gate)
Notable RNN Variants
1) Dilated RNN (Chang et al., 2017): Dilated Recurrent Skip Connections 제안, 긴 시퀀스의 매개변수 효율성 증대, 복잡한 의존성 학습 효과적
2) DA-RNN (Qin et al., 2017): 장기의존성 해결을 위한 dual-stage attention mechanism 제안, (인코더: 입력 어텐션/디코더: 시간적 어텐션)
3) MQ-RNN (Wen et al., 2017): Seq2Seq 신경망 프레임워크, 분위 회귀(Quantile Regression) 결합, 각 시점에서 여러 예측 구간(forecast horizon)을 동시에 생성
그래프 신경망(Graph Neural Networks, GNNs) (Scarselli et al., 2008):
1) 노드(node)와 엣지(edge) 간의 복잡한 구조적 관계 모델링
2) MTS의 복잡한 구조적 관계를 위해 적용, dynamic characteristics을 포착해 복잡한 패턴을 포착하는데 유용.
3) 초기에는 주목받지 못함(CNN, RNN의 강점에 비해 특징이 두드러지지 않음)
GNN의 확장과 발전
1) 그래프 합성곱 신경망(Graph Convolutional Networks, GCNs) (Kipf & Welling, 2017):
-> 그래프 구조에 대한 합성곱 연산으로 노드 특징 학습, 변수 간 관계 및 temporal locality 학습에 효과적
2)공간-시간 그래프 합성곱 신경망(Spatial-Temporal Graph Convolutional Networks, ST-GCN) (Yan et al., 2018):
-> GCN(공간적 패턴 학습) - RNN(시간적 패턴 포착), 교통 예측(traffic prediction)과 같은 시계열 문제 해결
3) 그래프 어텐션 네트워크(Graph Attention Networks, GATs) (Veličković et al., 2018):
-> 어텐션 메커니즘 사용으로 노드 간 관계 학습, 노드 중요도 포착을 통한 시계열 데이터 내 significant events을 식별하는 데 유리한 모델
4) 동적 그래프 신경망(Dynamic Graph Neural Networks, DyGNNs) (Ma et al., 2020):
-> 시간이 지나면서 구조가 변하는 그래프를 학습하기 위해 만들어진 모델, 복잡한 시간적 패턴과 관계 구조를 효과적으로 포착
5) 시간 그래프 네트워크(Temporal Graph Networks, TGNs) (Rossi et al., 2020):
-> 그래프의 노드가 시간에 따라 변화하는 상황을 모델링하기 위해 도입된 구조, 시간에 따라 중요도가 달라지는 이웃 노드의 정보를 학습, 향후 상태를 예측하기 위한 기반 제공
The Prominence of Transformer-based Models
Transformer(Vaswani et al., 2017)은 인코더/디코더 구조로 되어있는 self-attention 메커니즘을 가진 모델로,자연어 처리 분야에서 seq2seq 작업을 수행하기 위해 개발됨.
병렬 처리 능력과 long-term dependency 문제를 효과적으로 해결하는 모델을 시계열 분야로 확장하게 됨
Transformer 모델이 나온 이후로 Transformer 기반으로 하는 TSF 모델들이 주로 연구 됨.
Transformer 기반 모델의 연구 방향과 한계점
Transformer는 다음과 같은 장점으로 주목을 받았으나, 모델 구조 자체의 문제점이 존재해 한계를 보완하는 것을 중점으로 진행하였으며, 다음과 같은 한계가 존재했음.
- Efficiency Challenges
1) Transformer의 핵심 단점인 O(L²) 시간·메모리 복잡도 문제 해결의 한계(self - attention 자체의 계산 비용이 높음)
2) Fedformer(Fourier / Wavelet 기반 주파수 도메인 변환으로 복잡도 감소 시도)
3) Sparse Attention 계열(LogTrans, Pyraformer): 계산 효율성 증대되나, 정보 손실 문제 발생, 다양한 도메인에서 일관된 성능 향상이 어려움 - Context Window Limited to Current Input
1) 입력 길이가 길어질수록 메모리와 계산량이 폭증(전체 시퀀스를 한번에 입력해야하기 때문)
2) 기존 기술(RNN, SSM)은 긴 문맥 처리시 유리(hidden state 구조로 이전 정보를 누적해 유지 가능) - Ineffectiveness of Expanding Input Window Length
1) 연구 결과(Zeng et al., 2023; Zhou et al., 2021; Wen et al., 2023):
-> 입력 윈도우를 늘려도 성능이 그대로이거나 오히려 나빠지는 경향 포착
-> Linear 기반 모델은 창 길이를 늘릴수록 지속적인 성능 향상
2) Transformer가 긴 시퀀스를 받으면 장기 패턴을 추출하기보다 오히려 노이즈에 overfit
기존 Non-Transformer-based Models의 연구 진행
기존 Transformer 기반 모델은 O(L²)의 시간 복잡도 / 높은 메모리 사용량 / 장기 의존성 학습(모델의 구조적 용량을 넘어설 경우) / 과적합(높은 모델 복잡도로 많은 데이터 필요) 에 대한 문제점이 지적되어 기존 딥러닝 기반의 모델들이 다시 TSF 모델에 주목을 받음.
또한 LTSF-Linear 모델의 나온 이후로 Transformer 기반 모델에 대한 성능에 대한 회의를 불러일으킴.
"The era of Transformer prevalence has come to an end, ushering in a renaissance in time series research"
Non-Transformer-based Models
RNN 기반 모델(Recurrent Neural Networks, RNNs):
-> 순차처리의 구조는 시간순서 반영 및 장기의존성 학습 / 데이터 메모리 요구량이 낮음 / 실시간 스트리밍 데이터 처리에 적합
2) CNN 기반 모델(Convolutional Neural Networks, CNNs):
-> self-attention 보다 시간복잡도 및 메모리 부담이 적음 / 주기성, 계절성, 지역적 패턴 추출 -> 전역 패턴에 강점을 보인 Transformer에 보완
3) GNN 기반 모델(Graph Neural Networks, GNNs):
-> 노드와 엣지 구조로 표현, 메모리 사용이 적으며, 시공간 관계 동시 학습 가능 / 고차원 multivariate 데이터에 강력
4) MLP 기반 모델(Multi-Layer Perceptrons, MLPs):
-> 훈련이 빠르고, 메모리 사용량이 적으며, 경량 모델 설계에 적합(모바일, 임베디드에 적합)
LTSF-Linear (Zeng et al., 2023)
1) 기존 Transformer 모델의 한계(permutation-invariant, positional embedding으로 일부 극복하려 했으나, multi-head attention 과정에서 정보 손실이 필연적으로 발생(Zhou et al., 2021).)
2) 시간 순서 정보를 더 잘 보존하고 추세(trend)와 계절성(seasonality)과 관련된 특성을 더 잘 추출
->Transformer 기반 모델의 성능에 대한 회의를 불러일으킴