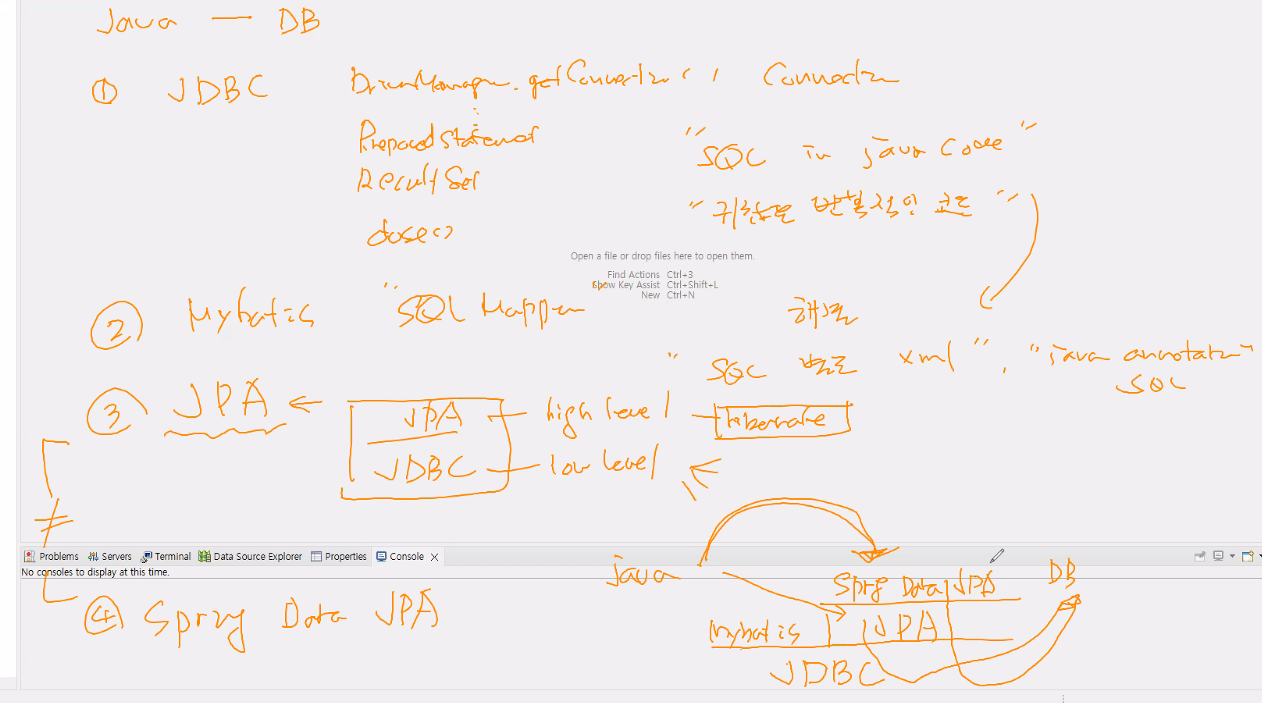
JPABasic 복습
@Entity 어노테이션
@Id
영속성
config - PersistenceUnitInfo
@Override
public List getManagedClassNames() {
return List.of("entity.Product");
}
find, detach, remove
jpql
실습
import config.MyPersistenceUnitInfo;
import entity.Employee;
import jakarta.persistence.EntityManager;
import jakarta.persistence.EntityManagerFactory;
import org.hibernate.jpa.HibernatePersistenceProvider;

import java.util.HashMap;
import java.util.Map;

public class Test {
    public static void main(String[] args) {
        Map<String, String > props = new HashMap<>();
        props.put("hibernate.hbm2ddl.auto","create"); // create(drop&create), update(없으면 create, 변하면 alter)
        props.put("hibernate.show_sql","true");

        EntityManagerFactory emf= new HibernatePersistenceProvider()
                .createContainerEntityManagerFactory(new MyPersistenceUnitInfo(), props);
        EntityManager em = emf.createEntityManager();

        em.getTransaction().begin();

        Employee emp = new Employee();

        // 1. 테이블 + auto increment 없이 1건 insert
//        emp.setId(1);
//        emp.setName("홍길동");
//        emp.setAddress("where");

        // 2. id에 auto increment 넣고 1건 insert
//        emp.setId(2);
//        emp.setName("홍길동");
//        emp.setAddress("where");

        // 3. id 제외
//        emp.setName("홍길동");
//        emp.setAddress("where");

        // 4. @GeneratedValue(strategy = GenerationType.AUTO) 추가
//        emp.setName("홍길동");
//        emp.setAddress("where");

        emp.setName("홍길동2");
        emp.setAddress("where2");

        // @GeneratedValue 설정값에 따라 다르게 구현
        // mysql, oracle 다름

        em.persist(emp);

        em.getTransaction().commit();
        em.close();
    }
}
package entity;
import jakarta.persistence.*;
@Entity
public class Employee {
// @Id만 있으면 db의 기본 id 정책 따름
@Id
// hibernate에 위임. mysql은 별도의 _seq 테이블 생성 및 관리
// 1->51 -> 101... 하지만 employee 테이블 id는 1->2->3...
// @GeneratedValue(strategy = GenerationType.AUTO)
// hibernate가 id 값을 제공
// create table Employee (id integer not null auto_increment 가 포함된 sql 수행
// insert into Employee (address,name) values (?,?) - id없는 insert문 수행
// @GeneratedValue(strategy = GenerationType.IDENTITY)
// mysql인 경우, .AUTO와 동일 <= Sequence 객체 제공 x
// oracle 경우, Sequence 객체 제공
// @GeneratedValue(strategy = GenerationType.SEQUENCE)
// .AUTO, .SEQUENCE와 유사, 테이블명이 hibernate_sequences로 변경, name 관련 컬럼 추가
// oracle, Sequence대신 Table을 사용하는 옵션
// @GeneratedValue(strategy = GenerationType.TABLE)
// UUID로 만들어지는 ID는 중복 가능성 X
// org.hibernate.HibernateException: Unanticipated return type [java.lang.Integer] for UUID conversion 에러 발생
// id string으로 수정
// 3135c247-6e3e-4ab3-ae81-ee29b2c37a60 형태의 문자열 id 생성
// insert into Employee (address,name,id) values (?,?,?)로 auto increment X
@GeneratedValue(strategy = GenerationType.UUID)
// private int id;
private String id;
// ...복합키
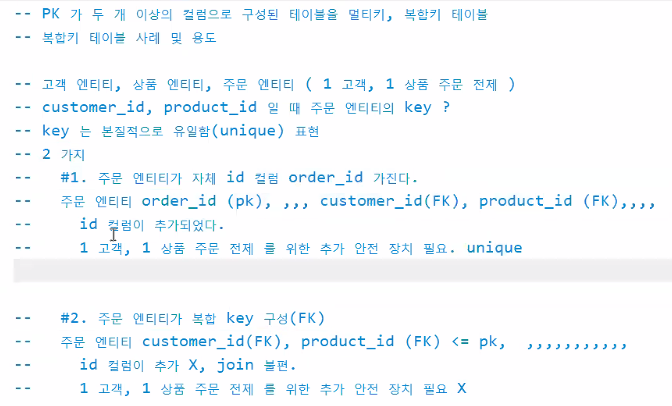
두 개 이상의 칼럼을 묶어서 하나의 기본키(Primary Key, PK)로 사용하는 것
1. 언제 사용하나요? (사용 사례)
주로 "비즈니스 로직상 중복되면 안 되는 조합"이 명확할 때 사용
① 다대다(N:M) 관계를 해소하는 연결 테이블 (교차 엔티티)
가장 대표적인 케이스. 두 테이블을 연결하는 중간 테이블에서는 두 부모의 ID를 묶어서 식별자로 쓰는 경우가 많음.
예시: 수강신청 테이블
한 학생(student_id)은 여러 강의를 들을 수 있고, 한 강의(course_id)는 여러 학생을 받는다.
하지만 "한 학생이 똑같은 강의를 두 번 신청"할 수는 없다.
복합키: (student_id, course_id)
② 부모-자식 관계가 강력하게 종속될 때 (식별 관계)
자식 데이터가 부모 없이는 존재 의미가 없고, 부모 내에서 순번 등으로 구분될 때 사용.
예시: 주문상세 테이블
주문 테이블의 order_id가 있어야 주문상세가 존재.
하나의 주문 안에서 첫 번째 상품, 두 번째 상품이 나뉜다.
복합키: (order_id, product_id) 또는 (order_id, line_number)
2. 장점(Pros)
-
데이터 무결성 보장 (강력함)
DB 차원에서 중복 데이터를 원천 봉쇄 (예: 같은 학생이 같은 수업을 또 신청하는 사고 방지)
별도의 UNIQUE 인덱스를 걸지 않아도 PK 자체가 유니크함을 보장 -
저장 공간 절약
인공적인 키(예: enrollment_id) 컬럼을 따로 만들지 않아도 되므로, 컬럼 하나분의 공간을 아낄 수 있다. -
데이터 조회 성능 (특정 상황)
복합키를 구성하는 컬럼들로 자주 조회(WHERE student_id = 1 AND course_id = 5)한다면, PK 자체가 인덱스이므로 조회 속도가 매우 빠르다.
3. 단점 (Cons) - 요즘 개발 트렌드에서 기피하는 이유
-
SQL 작성이 복잡해짐 (Join 지옥)
단일키라면 ON a.id = b.id면 되지만, 복합키는 ON a.id1 = b.id1 AND a.id2 = b.id2 처럼 조건절이 길어짐다. -
자식 테이블의 비대화
복합키를 가진 테이블을 다른 테이블이 참조(FK)하려면, 그 자식 테이블도 부모의 모든 키 컬럼을 다 가지고 있어야 한다. => 테이블 구조가 복잡해짐. -
JPA(ORM) 사용 시 매우 번거로움
스프링 JPA 등에서 복합키를 매핑하려면 별도의 식별자 클래스(@IdClass 또는 @EmbeddedId)를 만들어야 하고, Equals와 HashCode를 직접 구현해야 하는 등 개발 비용이 급상승 -
비즈니스 로직 변경에 취약
나중에 "학생이 같은 강의를 재수강할 수 있다"로 규칙이 바뀌면, PK 구조 전체를 뜯어고쳐야 함
=> DB의 중요성보다 그냥 웹 개발을 할때는 복합키보다는 대리키(Surrogate Key) 사용(비즈니스 로직 변경에 유연하기때문), 대신 데이터 무결성에 상대적으로 약하여 비즈니스 중복을 막기 위해 (student_id, course_id)에 유니크 제약조건을 건다. 주로 조인의 속도를 향상시키기 위해 많이 사용한다.