스터디 전까지 내용을 수정해두는 것이 목표이다.
문제 이해 및 설계 범위 확정
시스템 설계 면접의 첫 단계는 적절한 질문을 통해 요구사항과 시스템의 범위를 명확히 정의하는 것이다.
책에서 가상 면접을 통해 정의한 검색어 자동완성 시스템의 주요 요구사항과 개략적인 규모는 다음과 같다.
요구사항
- 빠른 응답 속도: 사용자가 입력할 때마다 자동완성 결과를 제공해야 하며, 목표 응답 시간은 100ms 이내이다.
- 연관성: 입력한 검색어와 관련성이 높은 검색어를 제공해야 한다.
- 정렬: 검색어의 인기도 등의 순위 모델을 기준으로 결과를 정렬해야 한다.
- 확장성: 증가하는 트래픽을 안정적으로 처리할 수 있어야 한다.
- 고가용성: 일부 서버나 네트워크에 장애가 발생하더라도 서비스를 계속 제공할 수 있어야 한다.
개략적 규모 추정
-
일일 검색 횟수:
1,000만 명 × 10회 = 1억 건/일 -
평균 QPS:
검색 1회당 평균 20건의 자동완성 요청이 발생한다고 가정하면
1억 × 20 ÷ 86,400 ≈ 약 24,000 QPS -
최대 QPS:
평균 QPS의 2배를 가정하면 약 48,000 QPS -
신규 검색 데이터:
전체 검색어의 20%가 신규 검색어라고 가정하면
1,000만 × 10회 × 20바이트 × 20% ≈ 0.4GB/일
따라서 이 시스템은 평균 약 24,000 QPS, 최대 약 48,000 QPS의 높은 요청량을 처리하면서도 100ms 이내의 응답 속도와 높은 가용성을 유지할 수 있도록 설계해야 한다.
개략적 설계안 제시 및 동의 구하기
이러한 요구사항에 맞춰 시스템을 개발하기 위해서는 데이터를 생성하는 작업과 사용자 요청에 응답하는 작업이 필요하다.
두 작업은 그 특성이 다르기 때문에, 대규모 시스템에서는 사용자 검색 요청과 검색어 데이터 생성을 하나의 서비스에서 처리하기보다 각각 분리하여 처리해야 한다.
데이터 수집 서비스
사용자가 입력한 질의를 실시간으로 수집하는 시스템.
데이터가 많은 애플리케이션에 실시간 시스템은 좋지 않지만, 설계안을 만드는 출발점으로는 괜찮을 것.
동작 방식은 이러하다.
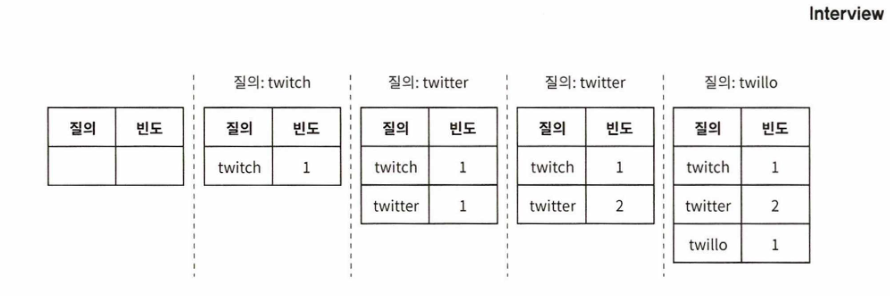
질의문과 사용 빈도를 저장하는 빈도 테이블(frequency table)이 있다고 가정할 때, 최초에는 비어 있다가 사용자가 'twitch', 'twitter', 'twitter', 'twillo'를 순서대로 검색하면 그 상태가 다음과 같이 바뀌어 간다.
질의 서비스
주어진 질의에 다섯 개의 인기 검색어를 정렬해 내놓는 서비스.
동작방식은 이러하다. 아래 표와 같은 필드가 있다고 가정할 때,
| 필드 | 설명 |
|---|---|
| query | 질의문을 저장하는 필드 |
| frequency | 질의문이 사용된 빈도를 저장하는 필드 |
사용자가 “tw”를 검색창에 입력하면 질의문이 사용된 빈도에 따라 “top 5” 자동완성 검색어가 표시되어야 한다.
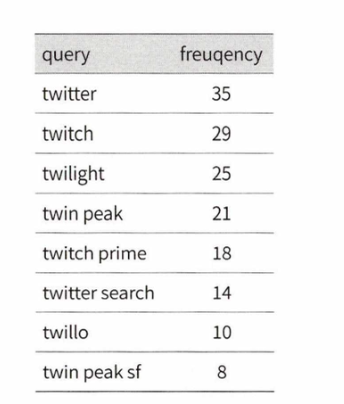
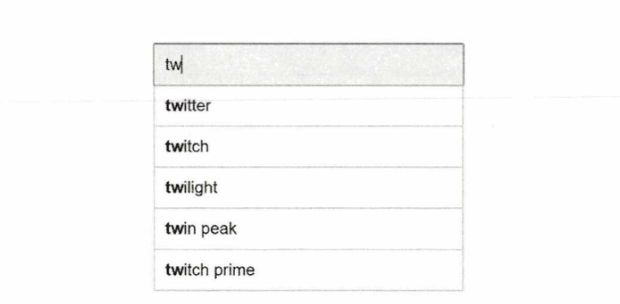
이 질의서비스는 SQL 질의문을 이용해서도 확인가능하다.
SELECT * FROM frequency_table
WHERE query Like 'prefix%'
ORDER BY frequency DESC
LIMIT 5
한계 : 데이터 양이 적을 때는 나쁘지 않은 선택이지만, 데이터가 아주 많아지면 데이터베이스가 병목이 될 수 있다.
상세설계
데이터베이스 양이 많을 때, 병목을 해결하는 방법에 대해 고민하며 상세설계를 진행하자.
트라이 자료구조 (Trie)
문자열들을 간략하게 저장할 수 있는 자료구조.
- 트라이는 트리 형식의 자료구조이다.
- 트라이 자료구조의 루트 노드는 빈 문자열을 나타낸다.
- 각 노드는 글자(character) 하나를 저장하며, 26개(해당 글자 다음에 등장할 수 있는 모든 글자의 개수)의 자식 노드를 가질 수 있다.
- 각 트리 노드는 하나의 단어 또는 접두어 문자열(prefix string)을 나타낸다.
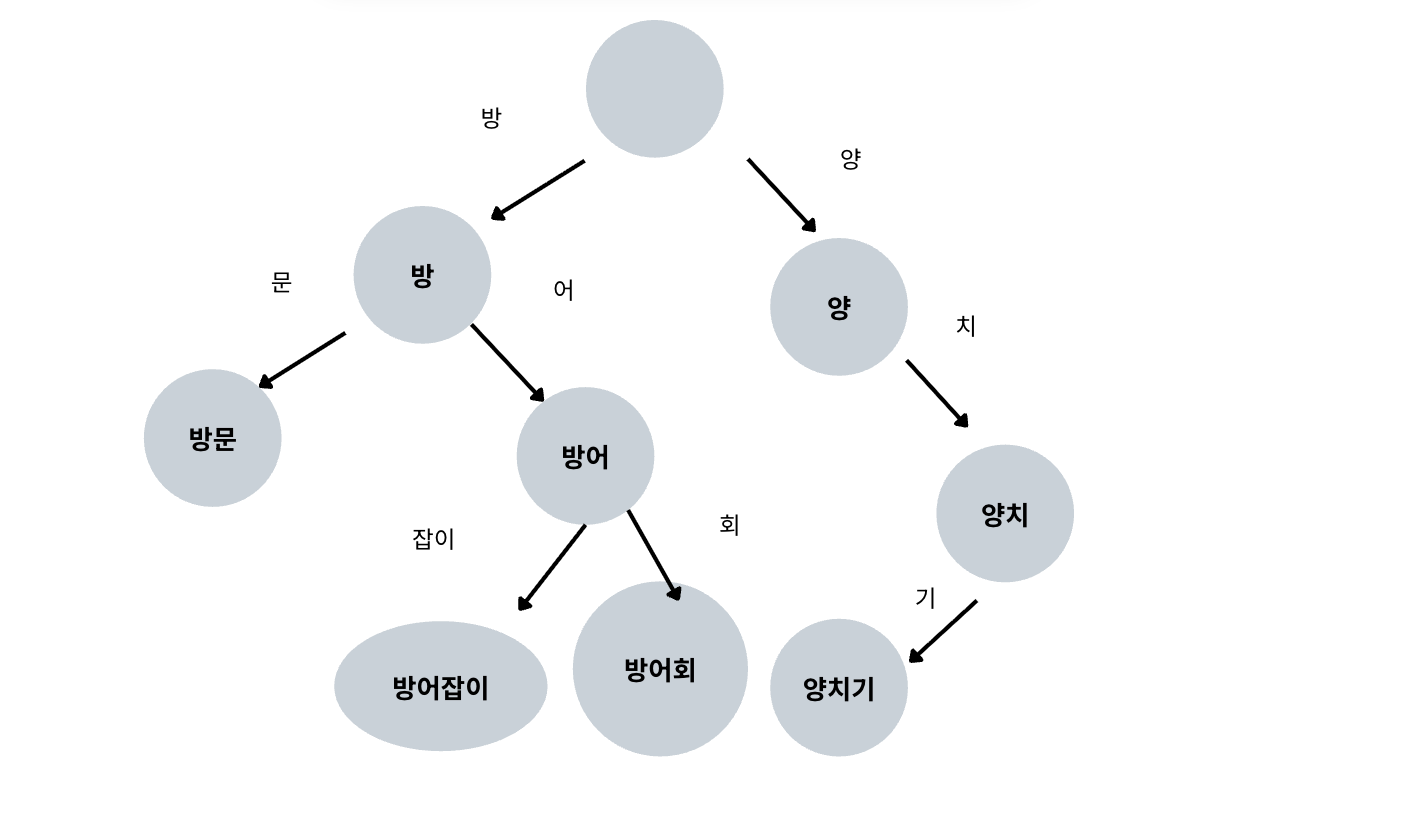
...
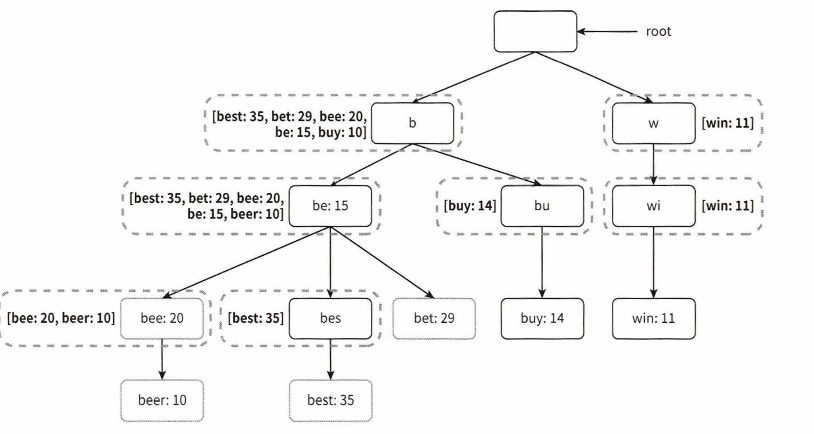
아래와 같이 노드에 빈도 정보를 저장한 트라이 자료구조가 있다고 해 보자.
| query | frequency |
|---|---|
| 방어회 | 20 |
| 방어잡이 | 1 |
| 방문 | 27 |
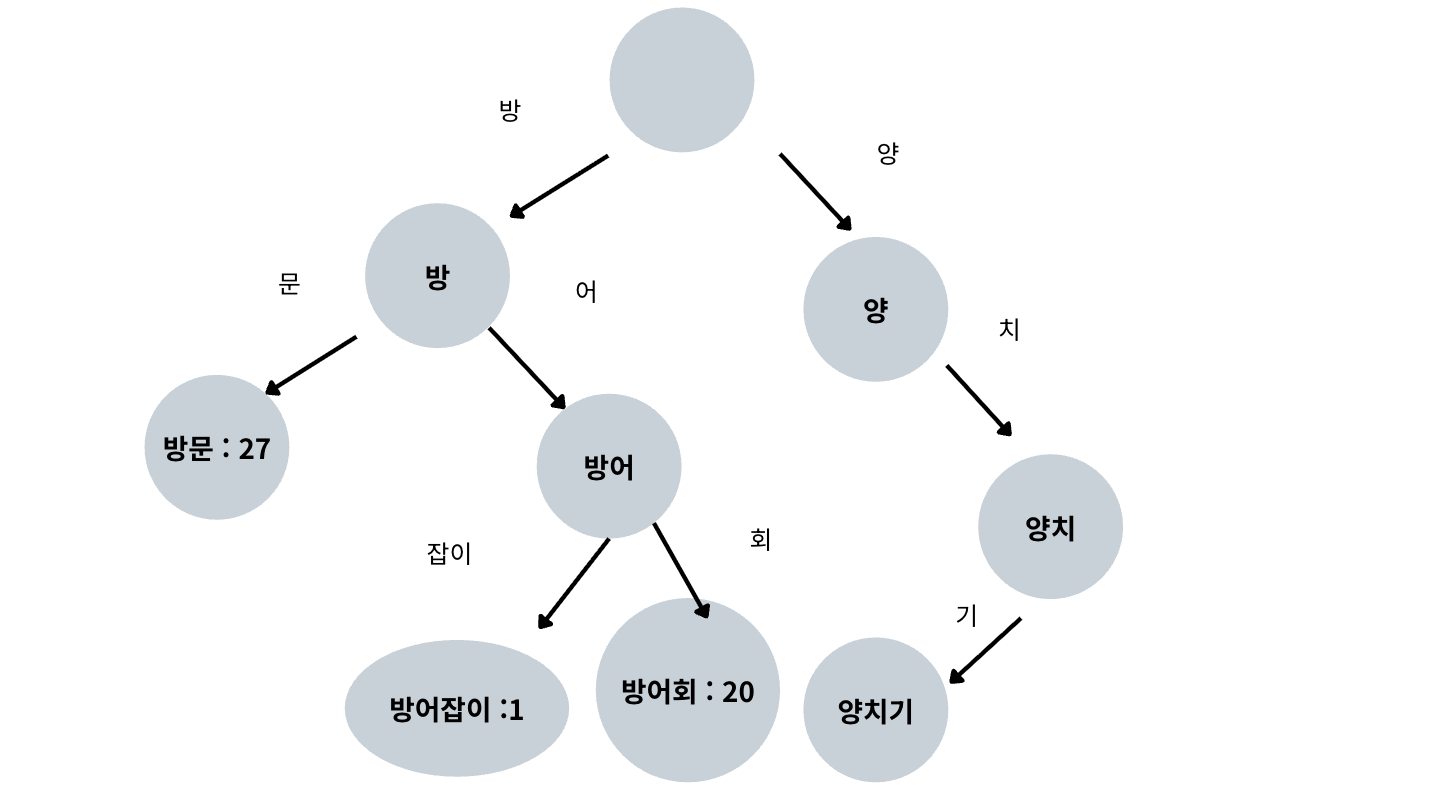
트라이 알고리즘을 적용한 인기검색어 기능은 아래와 같이 작동한다.
1. 사용자가 검색한 접두어를 확인. 해당 접두어로 시작하는 모든 단어 탐색해 유효 노드 찾기.
2. 유효노드를 정렬하여 가장 많이 사용된 단어 개수 k개 출력하기.
위 예시에서는 방문 > 방어회 > 방어잡이 순으로 출력될 것이다.
접두어 최대 길이 제한
검색어 길이에 상한(최대 50자)을 두면, 접두어 노드를 찾는 시간이 검색어 길이와 무관하게,
일정하게 유지될 것이다.
노드에 인기 검색어 캐시
각 노드에 인기 검색어를 미리 저장해 두면 매번 전체 트라이를 검색하지 않아도 된다.
이 방식은 인기 검색어를 질의하는 시간 복잡도를 낮추지만, 각 노드에 질의어를 저장할 공간이 많이 필요하다는 단점도 있다.
저장 공간을 희생하고 빠른 응답 속도를 취할 것인가? 서비스의 성격에 맞추어 잘 고민해 보자.
지금까지 데이터베이스 양이 많을 때, 병목없는 검색어 자동완성 시스템을 구현하는 방법 일부에 대해 알아보았다.
이후 내용은 스터디장이 진행할 것이다.
ebs 세바시 특강을 넘어설 명강의! 기대를 안고 확인해보자!!
데이터 수집 서비스
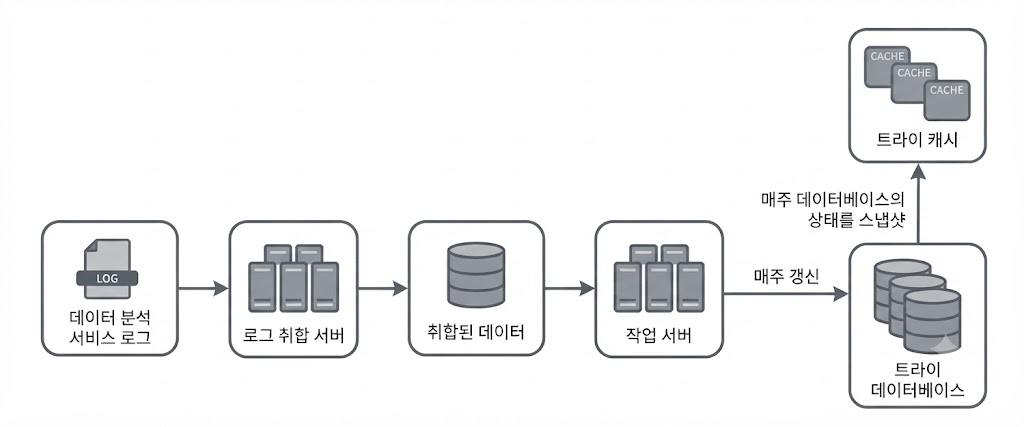
사용자가 검색창에 키워드를 입력할 때마다 트라이를 자주 갱신하면 질의 서비스는 심각하게 느려질 것이다.
트라이를 자주 갱신하지 않으면서도 사용자가 입력하는 데이터를 수집할 방법에 대해 모색한다.
데이터 분석 서비스 로그
검색할 때마다 트라이를 수정하지 않고, 검색 데이터를 데이터 분석 서비스 로그에 먼저 저장해 둔 뒤 일정한 주기로 트라이를 갱신한다.
데이터 분석 서비스 로그에는 검색창에 입력된 질의에 관한 원본 데이터가 보관되며,
인덱스 갱신으로 인한 성능 저하를 우려해 인덱스를 걸지 않는다.
로그 취합 서버