A Two-Stage Framework with Contrastive Representation Learning for Drug-Disease Association Prediction under Positive-Unlabeled Learning
THL Nguyen et al, "A Two-Stage Framework with Contrastive Representation Learning for Drug-Disease Association Prediction under Positive-Unlabeled Learning" Discover Artificial Intelligence 2026
Introduction
새로운 약물-질병 연관성을 식별하는 것은 생의학 정보학의 근본적인 문제로, 약물 재창출, 정밀 의학 및 질병 치료법 발굴에서 중요한 역할을 한다.
기존 약물이 질병에 미칠 수 있는 잠재적 치료 효과를 계산적으로 추론함으로써, DDA 예측은 유망한 약물-질병 쌍을 우선순위화하여 실험적 검증에 필요한 비용과 시간을 크게 줄일 수 있다.
DDA 예측은 생의학 데이터의 본질적인 특성으로 인해 여전히 매우 어려운 문제로 남아 있다.
- 약물-질병 연관성 행렬은 극도로 희소하다.
가능한 모든 약물-질병 쌍 중 실험적으로 확인된 것은 극히 일부에 불과하며, 대부분 관측되지 않은 상태로 남아 있다. 그러므로 관측되지 않다고 관계가 없는게 아니라 아직 밝혀지지 않은 관계일 수 도 있다. - 약물-약물 및 질병-질병 유사도와 같은 보조 정보는 종종 노이즈가 많고 불완전하여, 이종 그래프에서의 표현 학습을 더욱 복잡하게 만든다
기존 end-to-end link prediction은 원래 adjancency matrix를 복원하는 adjacency reconstruction을 사용한다. 하지만 prediction target인 edge 정보가 representation learning 과정에 이미 들어갈 수 있다는 문제점이 존재한다. 즉, information leakage 문제가 존재할 수 있다.
또한 unlabeled pair를 그냥 negative로 샘플링하면 hidden positive까지 negative로 학습되어 negative label contatmination이 발생할 수 있다.
Method
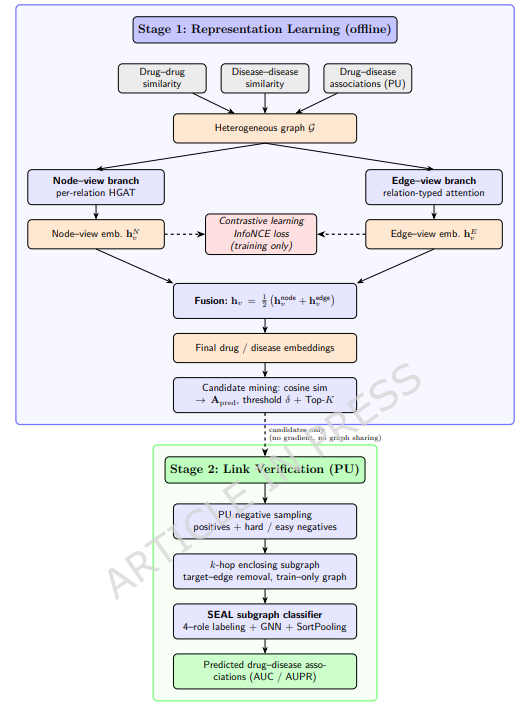
Stage 1 : Multi-View Contrastive Learning on Heterogeneous Graph & Candidate
Stage 1의 목표는 희소하고 이종적인 관계형 데이터로부터 각 약물 및 질병 노드에 대한 고품질 임베딩을 학습하는 것이다.
동일한 노드의 서로 다른 의미론적 뷰를 서로 대조하는 Multi-View contrastive learning 패러다임을 채택한다.
Heterogeneous Graph Construction
약물-질별 연관성 행렬, 약물-약물 유사도 행렬, 질병-질병 유사도 행렬이 주어졌을 때, 다음과 같은 이종 그래프를 구축한다.
노드 집합은 약물 노드와 질병 노드로 구성. 엣지 집합은 약물-약물, 질병-질병 및 약물-질병 관계를 포함
Node View Representation
Node View는 서로 다른 관계 유형에서 의미적 관련성에 따라 이웃 노드의 중요도를 모델링한다.
- : 관계 유형의 집합
- : 관계 에서 노드 의 이웃 집합
- : 학습 가능한 관계별 변환 행렬
- : 관계 에서 이웃 가 노드 에 미치는 중요도를 측정하는 어텐션 계수
- : 비선형 활성화 함수
이때 어텐션 계수 는 관계별 어텐션 메커니즘을 사용하여 다음과 같이 계산된다.
- : 관계 유형 에 특화된 학습 가능한 어텐션 가중치 벡터
Edge View Representation
Edge View는 엣지별 정보를 인코딩함으로써 관계 의미론을 명시적으로 모델링한다.
- : 학습 가능한 엣지 인코더
어텐션 계수는 다음과 같이 정의 된다.
Multi-View Contrastive Learning Objective
위에서 각 노드 에 대해서 node view representation, edge view representation을 얻었다.
이 두 뷰는 동일한 노드에 대해 서로 다른 의미론적 관점에 해당하며 positive sample로 취급된다.
다른 노드의 표현은 negative sample로 취급된다.
전체 contrastive loss는 다음과 같이 정의된다
Final Node Embedding
contrastive learning 이후, 노드 의 최종 임베딩은 두 뷰를 융합하여 다음과 같이 얻는다
그 결과, 각 약물 및 각 질병 노드에 대해 통합된 임베딩을 얻는다.
Drug-Disease Score Computation and Adjacency Matrix Update
이렇게 각 약물 노드와 질병 노드는 최종 임베딩 벡터 와 연결된다.
약물-질병 쌍 간의 연관성 점수는 유사도 함수를 통해 계산된다
예측된 약물-질병 인접 행렬 는 임계값 처리를 통해 다음과 같이 구성된다
생성된 행렬 는 기존 약물-질병 연관성을 보강하며, 이후 단계에서 후보 집합을 구성하는데 사용된다.
Candidate Set Construction
원래 알려진 약물-질병 연관 행렬 와 위에서 계산한 를 사용한다.
후보 집합은 contrastive learning에서 높은 가능성을 갖는 것으로 예측되었지만, 원래의 레이블된 positive pair에 포함되지 않은 약물-질병 쌍으로 구성한다.
후보 집합의 크기를 추가적으로 제어하고 잠재적인 노이즈를 줄이기 위해, 에서 약물 에 대해 가장 높은 점수를 갖는 개의 질병 집합을 구성한다.
는 오직 후보를 선택하는 데만 사용되며, 이후 검증 모델의 그래프 구조에는 포함되지 않는다!
Stage2 : Subgraph-Based Assocaitation Verification
후보 생성을 위한 전역 표현 학습에 초점을 맞추는 Stage 1과 달리, Stage 2는 약물-질병 연관성 예측을 검증 문제로 정식화 한다.
즉, 약물-질병 쌍 가 주어졌을 때, 그래프의 국소 구조적 패턴을 명시적으로 모델링하여 해당 쌍이 실제 연관성이 있는지 판단한다.
Stage1과 독립적으로 작동하게 설계되었으며 학습 데이터에서 관측된 원래의 관계 구조에만 의존하므로써 단계 간 정보 누출을 방지한다.
Training Samples under the PU Setting
실험적으로 검증된 약물-질병 연관성 집합은 positive sample로 취급한다.
하지만 PU에서는 검증된 음성 레이블이 없으므로, 레이블이 없는 약물-질병 쌍으로부터 negative sample을 생성한다.
구체적으로, 레이블이 없는 쌍은 에 따라 hard negative와 easy negative로 구분된다.
PU learning에서 이다. 하지만 unlabeled 전체를 그냥 negative라고 두면, hidden positive까지 0으로 학습하게 되므로 잘못된 negative label이 섞이는 문제가 생긴다.
uPU는 unlabeled 전체를 사용하되, 안에 positive가 일정 비율 섞여 있을 것이라고 보고 unlabeled 안의 hidden positive contribution을 빼서 risk를 보정한다.
nnPU는 nPU의 보정식을 실제 데이터에 적용하면 negative risk 항이 음수가 될 수 있고 이로 인해 모델이 과적합이 될 수 있으므로 가 되도록 제한한다.
하지만 논문은 loss를 보정하지 않고 negative sampling 자체를 조절한다.
Global Training Graph Construction
local 구조 정보를 추출하기 위해 학습 데이터만을 사용하여 global 학습 그래프를 생성한다
노드 는 모든 약물 및 질병 노드로 구성되며, 엣지 집합 은 약물-약물 유사도 엣지, 질병-질병 유사도 엣지, 의 약물-짋여 연관성 엣지를 포함한다.
⚠️ Stage 1에서 학습된 어떤 임베딩도 에 포함되지 않는다.
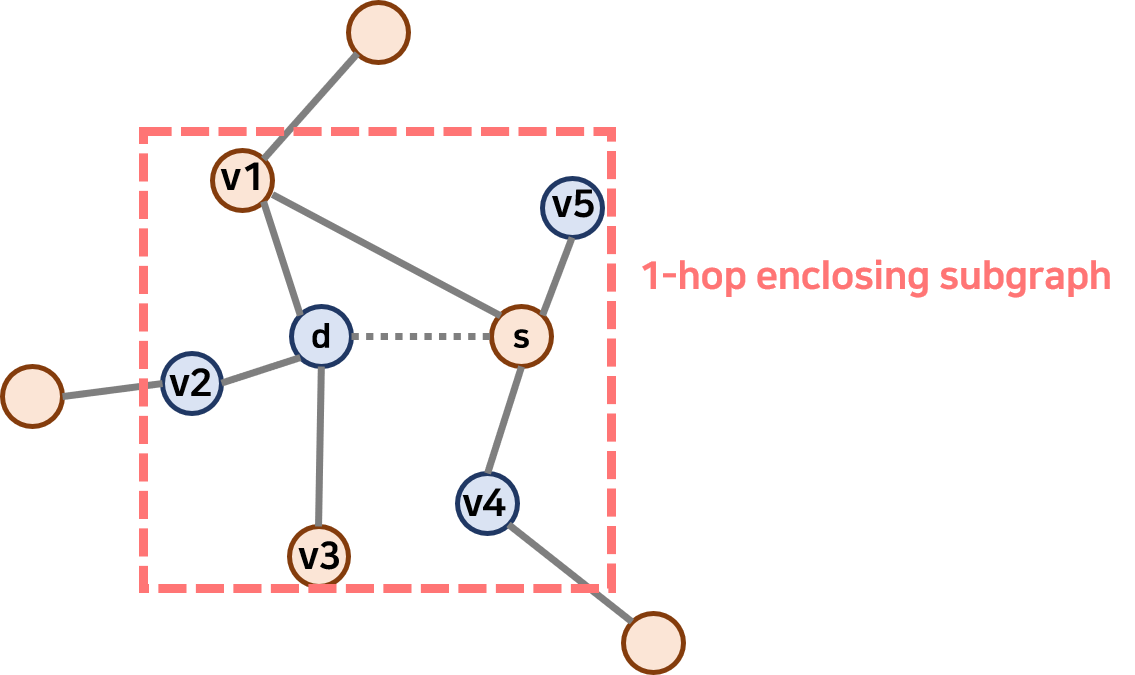
k-hop Enclosing Subgraph Extraction
각 학습 쌍 에 대해, 약물 노드 와 질병 노드 를 중심으로 하는 서브그래프를 추출한다.
노드를 둘러싸는 서브그래프의 노드 집합을 다음과 같이 정의한다
- : 노드 와 사이의 최단 경로 거리
이후 선택된 노드들 사이에 원래 존재하던 edge를 가져온다. 이때 우리가 예측하려는 것은 의 association 여부이므로 와 사이에 직접적인 엣지가 존재하는 경우, 검증 전에 해당 엣지를 둘러싸는 서브그래프에서 제거한다.
Structural Node Labeling
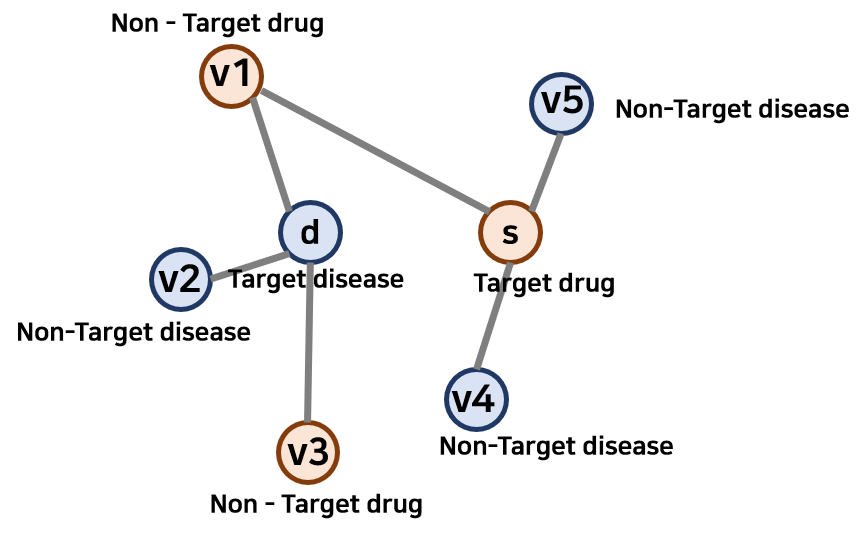
서브그래프 내에서 노드들의 상대적인 구조적 역할을 인코딩 하기 위해 4가지 역할의 노드 레이블링 방식을 적용한다.
각 노드 에 대해 최단 경로 거리를 계산한다
이러한 거리와 노드 유형을 기반으로 각 노드에 타깃 약물 노드, 타깃 질병 노드, 비타깃 약물 노드, 비타깃 질병 노드 중 하나의 역할이 할당된다.
이는 각 노드의 구조적 위치와 의미적 정체성을 명시적으로 인코딩하여, 모델이 서로 다른 local 위상 구성을 구별할 수 있도록 한다.
Subgraph Representation Learning
위에서 각 노드에 할당된 역할 레이블은 학습 가능한 역할 임베딩에 매핑된다. 이후 Message passing을 통해 가 노드 표현은 업데이트가 된다
- : 노드 의 역할 임베딩
- : 서브그래프에서 의 이웃 집합
이렇게 개의 레이어를 거친 후, SortPooling을 사용하여 노드 표현을 고정 차원의 서브그래프 표현으로 집계한다.
Verification Objective
서브그래프 표현 가 주어졌을 때, 검증 모델은 해당 약물-질병 쌍이 실제 연관성을 형성할 확률을 다음과 같이 예측한다
모델은 다음의 이진 교차 엔트로피 손실을 최소화하여 학습된다
Results
모델이 실제 질병에 대해 생물학적으로 말이 되는 약물을 상위 후보에 올리는가?
특정 disease를 고정한 뒤 drug candidate 전체에 대해서 scoring하고 score를 내림차순으로 ranking한다.
Breast Cancer
논문에서는 breast cancer가 heterogeneous한 molecular subtype과 다양한 치료 전략을 가지므로 drug repositioning에서 자주 사용되는 benchmark dataset이다.
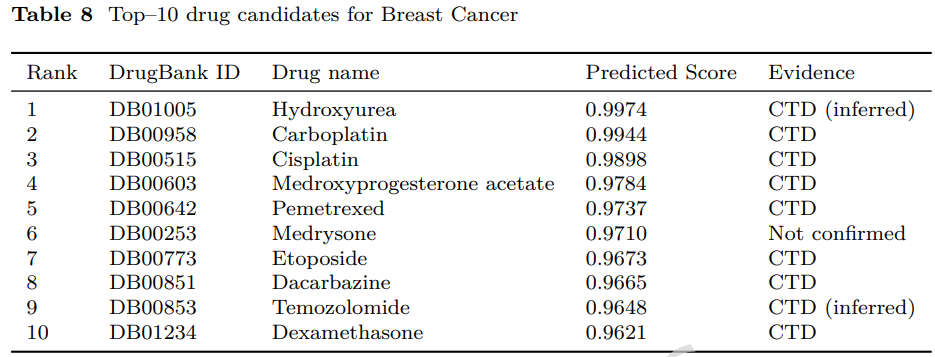
이 중 여러 약물이 기존 anticancer agent이고, DNA damage, mitotic inhibition, cell-cycle disruption 등의 mechanism과 연결된다. 또한 Medroxyprogesterone acetate와 Dexamethasone은 hormone-related 또는 supportive/disease-specific therapeutic setting과 연결되어 있다
즉, Breast Cancer에서는 다양한 mechanism의 약물이 상위에 등장하고 이는 breast cancer 자체의 biological heterogeneity와 잘 맞는다.
Parkinson Disease case study
논문에서 Parkison disease의 핵심 병태 생리를 dopaminergic neuron degeneration 과 dopamine deficiency로 설명한다.
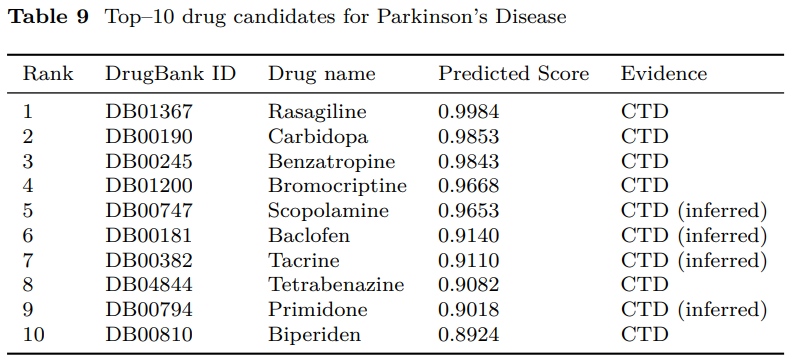
mechanism은 다음과 같다. Rasagiline은 selective MAO-B inhibitor로 dopamine degradation을 줄입니다. Carbidopa는 levodopa bioavailability를 높입니다. Bromocriptine은 dopamine receptor agonist입니다.Benztropine과 Biperiden은 tremor 및 motor symptom 관리에 사용되는 anticholinergic agent입니다.
즉 상위 prediction들이 상당히 일관되게 dopamine / motor-control mechanism 주변에 모여 있다.
Claim
Breast Cancer의 상위 prediction은 여러 mechanism에 걸쳐 있으며 이는 breast cancer의 heterogeneous biology가 반영된 결과라고 해석할 수 있다. 반면 Pakinson disease에서는 prediction이 상당히 좁은 mechanism에 집중되고 이는 Parkison disease의 비교적 pathway-concentrated한 biological mechanism과 연결할 수 있다.
즉, 저자들은 실험을 통해 known drug가 prediction에 나왔음이 아닌 질병의 biological characteristics에 따라 서로 다른 형태의 drug ranking pattern이 나타났음을 주장한다.
Conclusion
본 연구는 약물–질병 연관성 예측을 현실적인 Positive–Unlabeled(PU) learning 문제로 정의하고, 기존 방법에서 발생할 수 있는 negative contamination과 information leakage를 줄이기 위해 two-stage framework를 제안한다.
Stage 1에서는 heterogeneous biomedical graph에 대해 contrastive learning을 수행하여 drug와 disease embedding을 학습하고, 이를 기반으로 유망한 association candidate를 생성한다. Stage 2에서는 SEAL 기반의 k-hop subgraph verification을 통해 각 candidate의 local structural pattern을 다시 검증한다. 이처럼 representation learning과 link verification을 분리한 것이 본 방법의 핵심이다.
실험 결과, Cdataset에서 AUC 0.9406, AUPR 0.9461을 기록했고, Fdataset에서도 안정적인 성능을 보였다. 특히 ablation study에서는 Stage 2의 verification module이 가장 큰 성능 향상에 기여했으며, Stage 1은 candidate generation과 negative selection에 중요한 역할을 했다.
또한 Breast Cancer와 Parkinson Disease에 대한 case study에서는 각 질병의 생물학적 특성과 일치하는 약물들이 상위에 랭크되어, 모델이 disease-specific한 정보를 어느 정도 반영하고 있음을 보여주었다.
다만 본 연구는 두 개의 중간 규모 benchmark에 대해서만 평가되었고, drug–drug 및 disease–disease similarity의 품질에 성능이 영향을 받을 수 있다. 또한 candidate threshold, Top-K, hard/easy negative ratio와 같은 hyperparameter가 dataset에 따라 달라질 수 있으며, class prior를 직접 추정하지 않는 prior-free PU 방식이라는 한계도 존재한다.
향후에는 더 크고 다양한 biomedical network와 prospective time-split 환경에서의 검증, gene·pathway·side effect와 같은 추가 biomedical entity의 통합, SAR 환경에 적합한 class-prior estimation 및 uPU/nnPU 적용, 그리고 실제 wet-lab validation이 필요하다.