DrugGen 2: A disease-aware language model for enhancing drug discovery
신약 개발은 후보 물질 설계부터 임상 적용까지 많은 시간과 비용이 필요한 과정이다. 기존에는 표현형 스크리닝이나 특정 단백질 타깃을 기준으로 한 약물 설계가 주로 활용되었지만, 방대한 화학 공간을 효율적으로 탐색하기에는 한계가 있었다. 최근에는 머신러닝과 딥러닝 기반 생성 모델이 분자의 특성, 생물학적 활성, 합성 가능성 등을 학습하면서 새로운 후보 물질을 보다 효율적으로 설계할 수 있게 되었다.
특히 LLM은 SMILES와 같은 순차적인 분자 표현을 처리할 수 있어 분자 생성 분야에서도 활용되고 있다. 기존 연구들은 단백질 타깃이나 분자 특성을 조건으로 새로운 화합물을 생성하거나, 강화학습을 통해 유효성·신규성·결합 친화도 등을 개선하는 방향으로 발전해 왔다.
하지만 대부분의 기존 모델은 질병 자체의 맥락을 직접 반영하지 않는다는 한계가 있다. 동일한 단백질 타깃이라도 질병에 따라 관련 경로나 생물학적 환경이 달라질 수 있기 때문에, 단순히 타깃 정보만을 이용한 분자 생성으로는 질병 특이적인 약물 설계에 한계가 있다.
이를 해결하기 위해 제안된 모델이 DrugGen-2이다. DrugGen-2는 기존 DrugGen을 확장한 모델로, 질병 정보와 단백질 타깃 정보를 동시에 조건으로 사용하여 분자를 생성한다. 구체적으로 질병은 MeSH(Medical Subject Headings) 기반의 DAG 정보로 표현하고, 타깃은 아미노산 서열로 입력한다. 모델은 이 두 정보를 바탕으로 해당 질병–타깃 조합에 적합한 SMILES 형태의 분자를 생성한다.
Method
Datasets
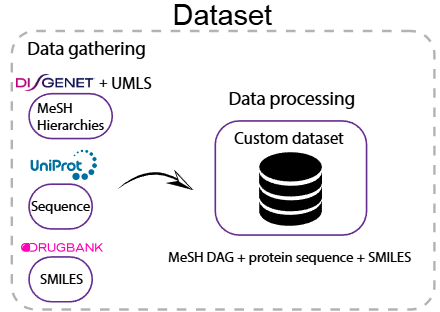
질병 - 타깃 - 약물의 관계를 동시에 학습하기 위해 여러 생의학 데이터베이스를 결합하여 학습 데이터셋 구축
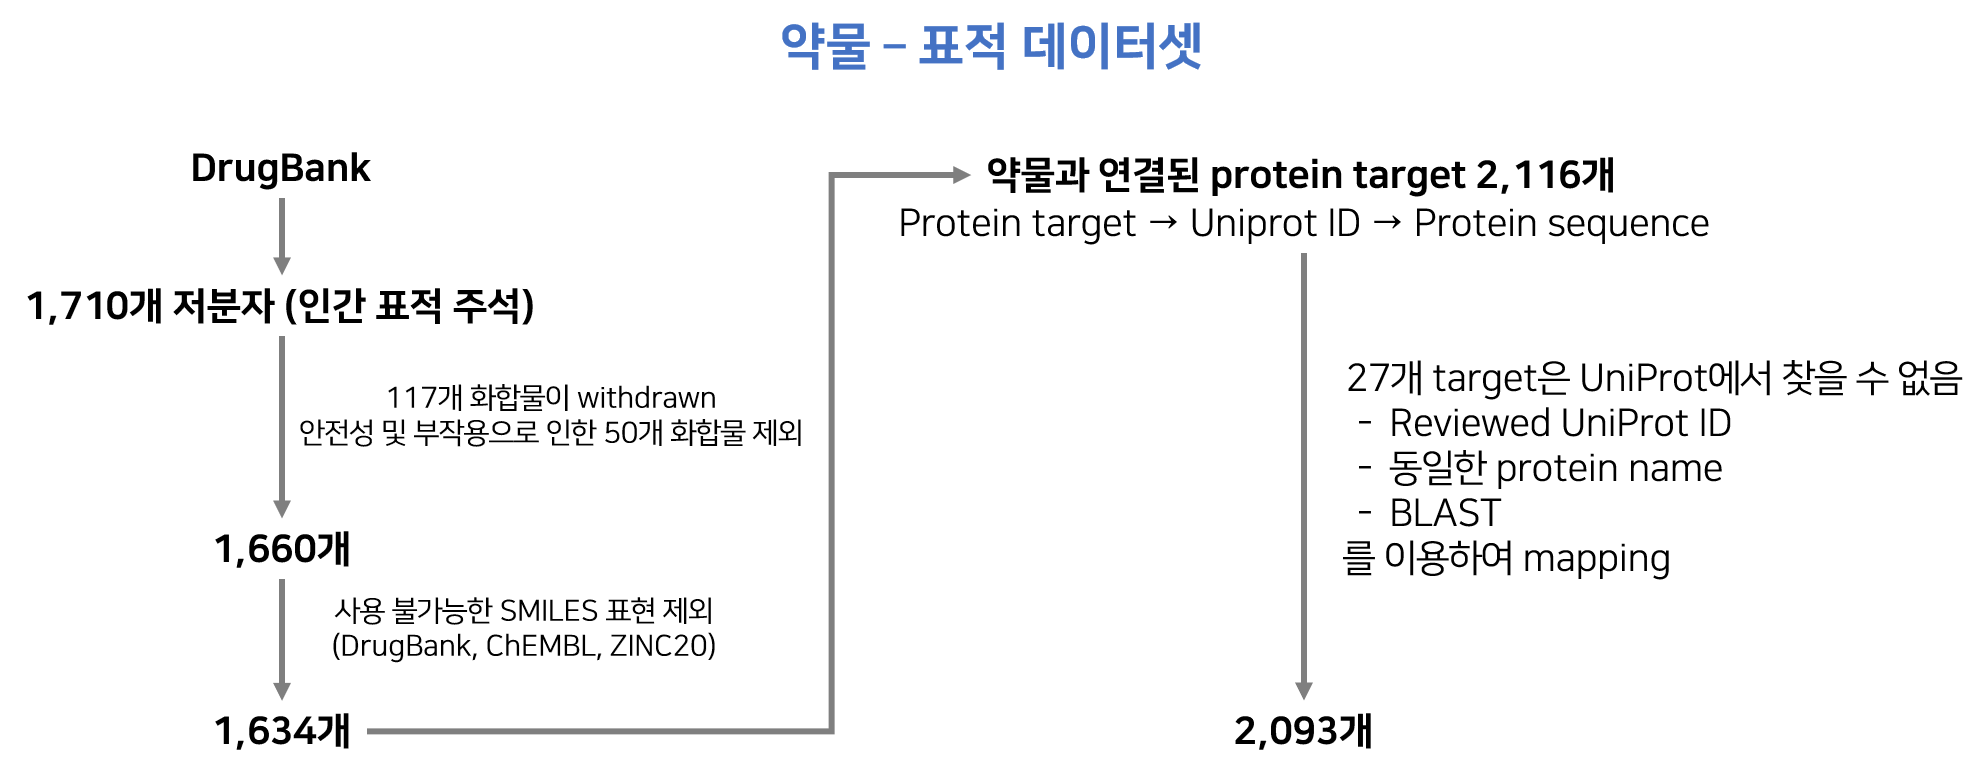
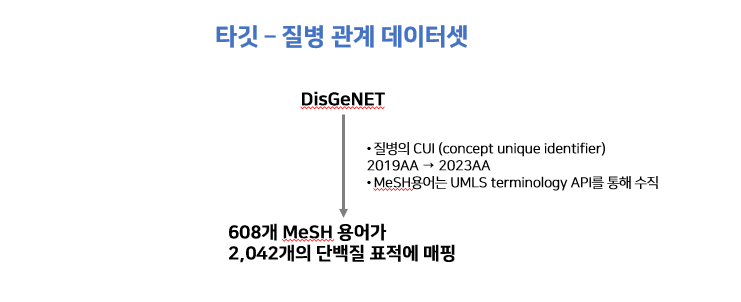
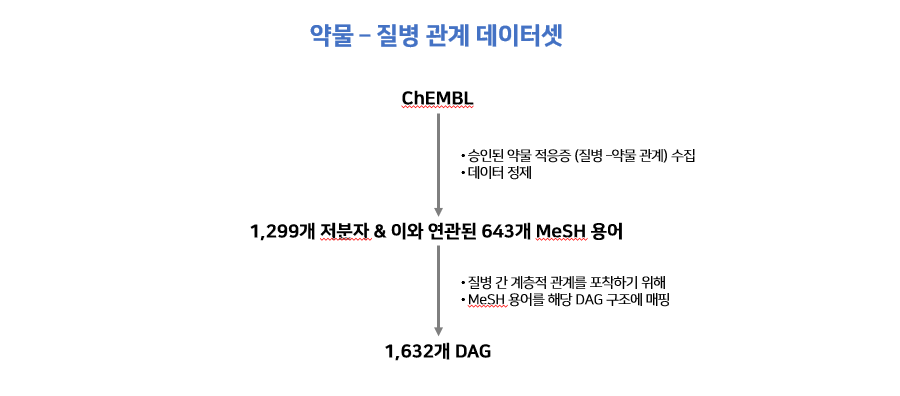
-
기존 DrugGPT 토크나이저를 사용하고, 기존에 정의된 특수 토큰 "startoftext", "endoftext", "PAD"에 "D","P","L" 세 가지 특수 토큰 추가
-
전체 어휘 크기는 53,086개 토큰
-
1,113,539개 MeSH-sequence-SMILES 문자열 생성 후, 직접적인 MeSH-SMILES 관계를 갖는 문자열만 필터링하여 최종적으로 13,908개의 MeSH-sequence-SMILES 문자열을 얻었음
<|startoftext|> + <D> + <MeSH DAG> + <P> + <Sequence> + <L> + <SMILES> + <|endoftext|>Framework
DrugGen-2는 ligand generation에 특화된 GPT-2 기반 모델인 DrugGPT를 기반으로 하며, 승인된 약물과 이에 대응하는 질병–타깃 정보를 이용해 fine-tuning되었다.
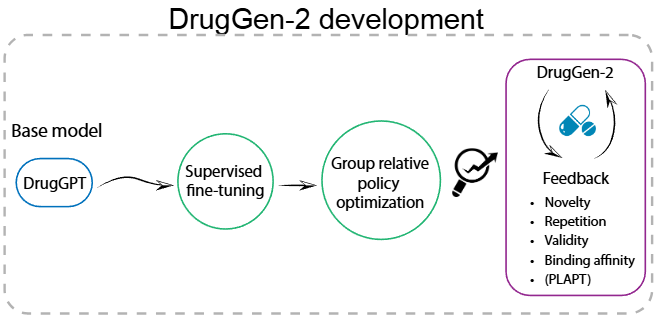
학습은 두 단계로 진행된다. 1️⃣ SFT(Supervised Fine-Tuning)를 통해 모델이 질병–타깃–약물 데이터의 패턴을 학습하도록 하고, 2️⃣ GRPO(Group Relative Policy Optimization) 기반 강화학습을 적용해 생성되는 분자의 품질을 추가로 개선한다.
Supervised Fine-tuning
13,908개의 토큰화된 MeSH-sequence-SMILES 문자열을 기반으로 사전학습 된 DrugGPT 모델에 대해 transformer reinforcement learning(TRL) 라이브러리의 SFT trainer 모듈을 사용하여 SFT를 수행하였다.
<|startoftext|>
<D> MeSH DAG
<P> Protein sequence
<L> Approved drug SMILES
<|endoftext|>
위 데이터를 통해 모델은 학습하며 다음 관계를 본다
Disease context + Target protein sequence => Approved drug SMILES기존 DrugGPT는
protein sequence -> DrugGPT -> SMILES형태의 target-conditioned molecular generation 모델
즉, "이 단백질에 어떤 ligand가 적절한가?"만 배우는 것이 아니라, "이 질병 맥락에서 이 단백질에 어떤 drug가 연결되는가?"를 배우게 하는 것
Group Relative Policy Optimization
SFT를 통해 DrugGen-2는 질병 정보와 단백질 타깃을 입력받아 이에 대응하는 SMILES를 생성하는 기본적인 패턴을 학습한다. 하지만 SFT는 정답 데이터에 존재하는 분자 분포를 모방하는 데 초점이 있기 때문에, 생성된 분자가 실제로 얼마나 유효한지, 새로운 구조인지, 타깃과 잘 결합하는지까지 직접 최적화하기 어렵다
이를 보완하기 위해 GRPO를 사용한다. GRPO는 여러 개의 생성 결과를 하나의 그룹으로 묶고, 그룹 내부에서 상대적으로 더 좋은 결과에 높은 보상을 주면서 모델을 업데이트하는 강화학습 방식이다.
하나의 입력에서 여러 개의 분자 생성
기존 policy인 를 사용하여 하나의 prompt 에 대해 40개의 SMILES를 생성하도록 한다.
여기서 prompt는 다음과 같다
<D> MeSH DAG
<P> Protein sequence
<L>
각 분자에 reward 부여
생성된 각 SMILES는 reward function을 이용해 평가된다.
- Binding affinity reward
생성된 molecule이 target protein에 얼마나 잘 결합할 것으로 예측되는가 평가
validity-checker를 통해서 invalid한 경우 reward 0, valid한 경우 PLAPT를 통해 affinity를 예측하고 reward로 사용 - Novelty
approved drug dataset에 존재하면 reward 0, 그렇지 않으면 reward 1 - Uniqueness
같은 batch 안에서 동일하거나 중복된 경우 reward 0, 그렇지 않으면 reward 1
절대적인 reward가 아닌 그룹 내부에서 상대적으로 평가
하나의 prompt에서 생성된 40개의 분자에 각각 reward를 계산한 뒤, 해당 그룹의 평균 reward를 baseline으로 사용
예를 들어 다음과 같이 reward가 나왔을 경우
SMIELS 1 -> 0.4
SMILES 2 -> 0.8
SMILES 3 -> 0.5
SMILES 4 -> 0.9
...
그룹 평균 reward가 0.6이라면
SMILES 1 : 평균보다 낮음 -> negative advantage
SMIELS 2 : 평균보다 높은 -> positive advantage
SMILES 3 : 평균보다 낮음 -> negative advantage
SMILES 4 : 평균보다 높은 -> positive advantage
...
와 같이 상대적인 성능을 계산하고, 이를 Advantage라고 한다.
좋은 분자를 생성한 token의 확률을 높인다
Advantage가 계산되면 GRPO는 policy model 를 업데이트한다. 좋은 reward를 받은 SMILES는 positive advantage를 가지므로, 해당 SMILES를 생성했던 token sequence의 확률을 높인다. 반대로 평균보다 낮은 reward를 받은 SMILES는 생성 확률을 낮추는 방향으로 업데이트한다.
PPO나 전통적인 RLHF 방식에서 일반적으로 현재 상태에서 앞으로 받을 reward를 예측하기 위해 별도의 Value MOdel 또는 Critic이 필요하다. 하지만 GRPO는 하나의 prompt에서 여러 개의 결과를 생성하고, 그 그룹의 평균 reward를 baseline으로 사용한다. 그러므로 별도의 Value MOdel을 학습할 필요가 없다.
Clipping을 통한 안정적인 학습
강화학습에서는 reward가 높은 결괄르 발견했다고 해서 policy를 한 번에 크게 변경하면 학습이 불안정해질 수 있다.
이를 방지하기 위해 clipped policy ratio를 사용한다. policy ratio는 이전 policy와 현재 policy가 특정 token을 생성할 확률이 얼마나 달라졌는지를 나타낸다
이 값이 지나치게 커지거나 작아지면 policy가 너무 빠르게 변하고 있음을 의미한다. 따라서 GRPO는 다음과 같이 변화량을 제한한다.
KL Divergence로 SFT 모델에서 너무 멀어지는 것을 방지
또 하나의 안정화 장치로 KL divergence penalty를 사용한다. GRPO를 계속 수행하면 reward를 최대화하기 위해 모델이 지나치게 특이한 분자를 생성하거나, SFT를 통해 배운 기존 분포에서 크게 벗어날 가능성이 있다. 이를 막기 위해 SFT가 완료된 모델을 reference policy 로 유지한다.
현재 policy 가 reference policy와 너무 멀어지면 penalty를 부여한다
결국 GRPO는 새로운 고품질 분자를 탐색하면서도 SFT를 통해 이미 학습한 화학적 생성 패턴을 유지하도록 설계되어 있다.
Results
Reward functions efficiently guided DrugGen-2 during training
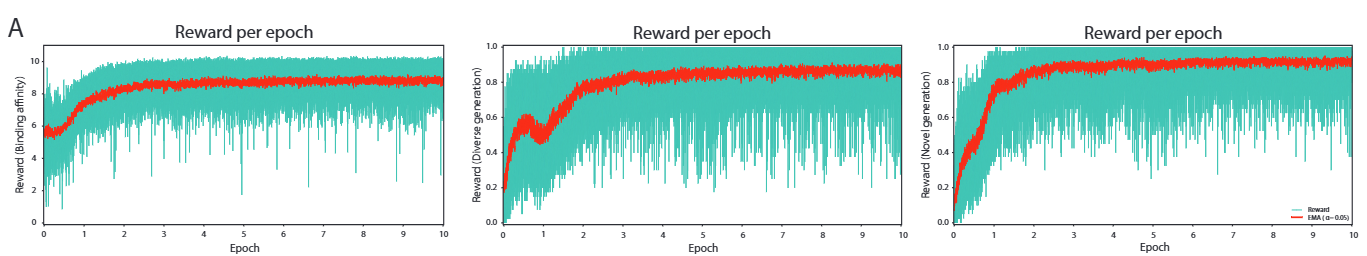
GRPO에서 사용한 세 종류 reward가 학습이 진행될수록 점차 converge했고, 이는 optimization이 안정적으로 진행되었음을 나타낸다
DrugGen 2 achieves higher unique generation across targets compared to DrugGen and DrugGPT
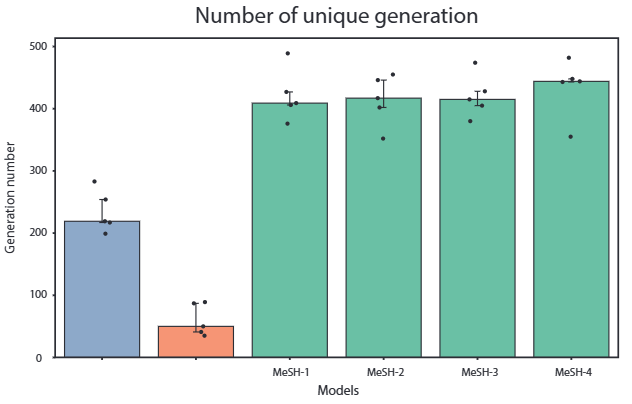
모델의 고유한 분자 생성 능력을 평가하기 위해, 선택된 단백질 표적에 대해 500개의 고유 후보 분자를 생성하도록 하였다.
DrugGen 2는 일관되게 가장 많은 고유 분자를 생성했다. (409 ~ 444)
이는 Drug Gen(50), DrugGPT(219)와 비교하여 높은 수준이었다.
이는 DrugGen 2가 여러 표적에서 고유 분자를 생성하는 능력이 현저히 높으며, 서로 다른 MeSH DAG 입력에서도 일관된 성능을 보임을 나타낸다.
DrugGen 2 demonstrates strong similarity to approved drugs
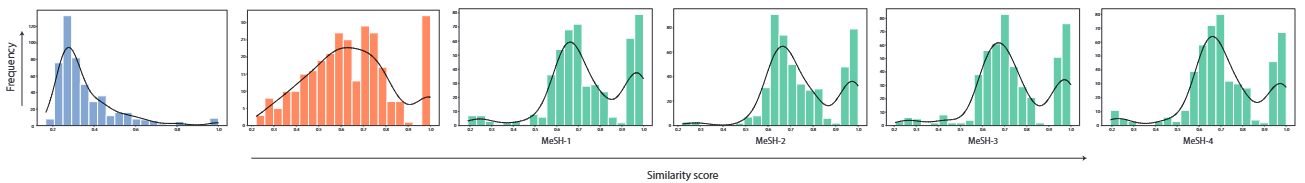
DrugGen 2가 생성한 분자는 모든 MeSH범주에서 승인된 약물과 더 높은 유사도를 보였다.
DrugGen 2 demonstrates improved binding affinity across five key targets
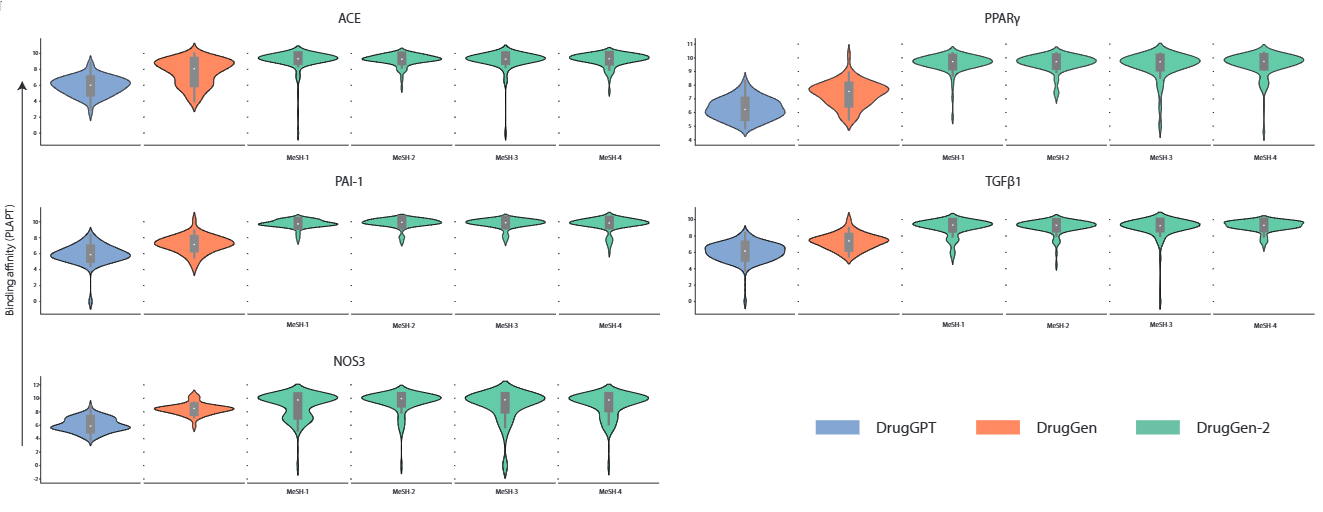
PLAPT로 결합 친화도를 예측한 결과 DrugGen 2가 5개의 모든 DN 관련 표적에서 DrugGPT와 DrugGen보다 일관되게 우수한 성능을 보였다.
Docking simulation determined the quality of the generated molecules
Protein Data Bank에서 결정 구조를 이용할 수 있는 두 단백질인 ACE와 PPARR를 선택하였다. 각 MeSH-표적 쌍에 대해 총 125개의 분자를 생성하고 도킹 분석을 수행하였다.
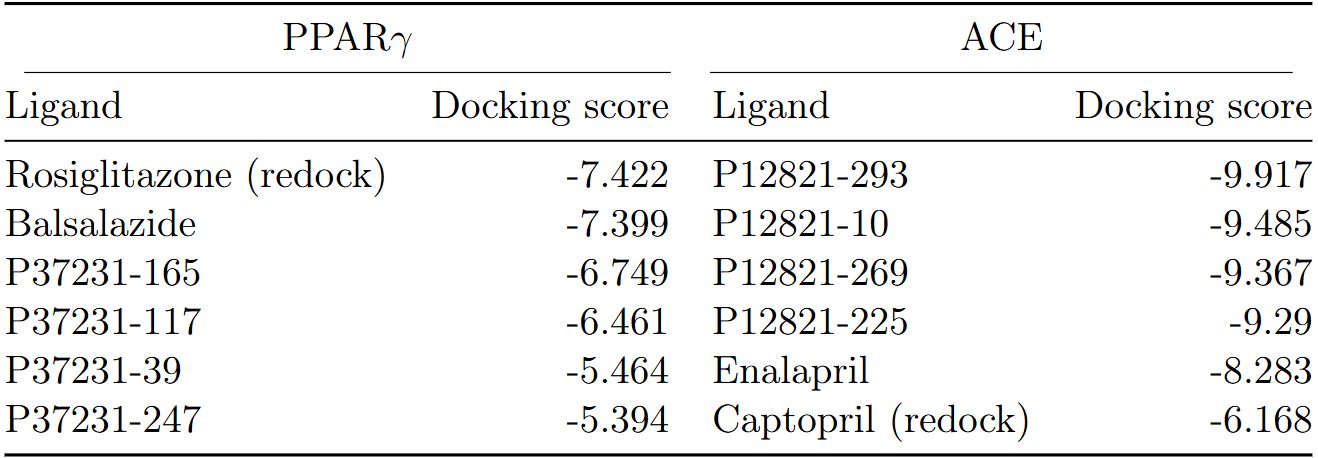
ACE의 경우 P12821-293, P12821-10, P12821-269 화합물은 Enalapril보다 현저히 낮은 도킹 점수를 나타냈으며, ACE 활성 부위 내 결합 자세는 참조 리간드와 공간적으로 밀접하게 정렬되었다.
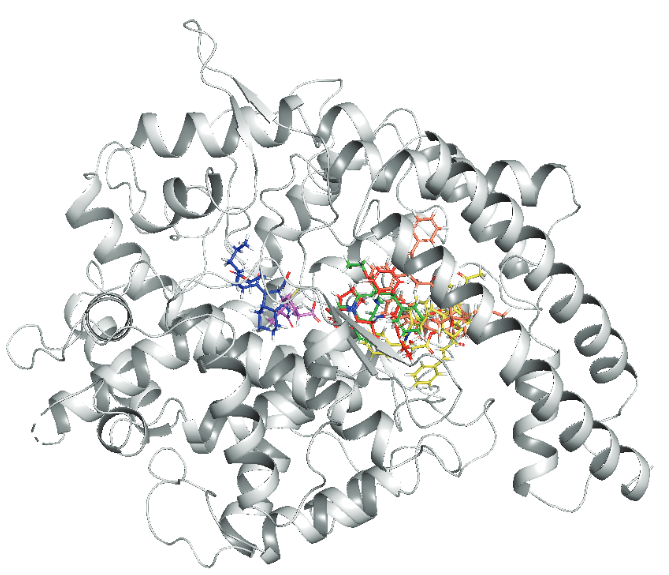
반면, PPAR에 대해서는 Rosiglitazone 또는 Balsalazide보다 더 우수한 도킹 점수를 보인 것은 없었다.
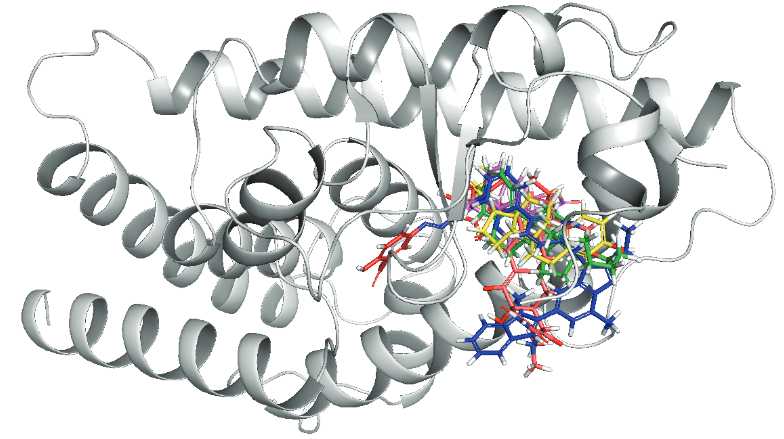
그러나 일부 화합물은 활성 부위에서 고유한 pharamcophoric interaction을 나타냈다.
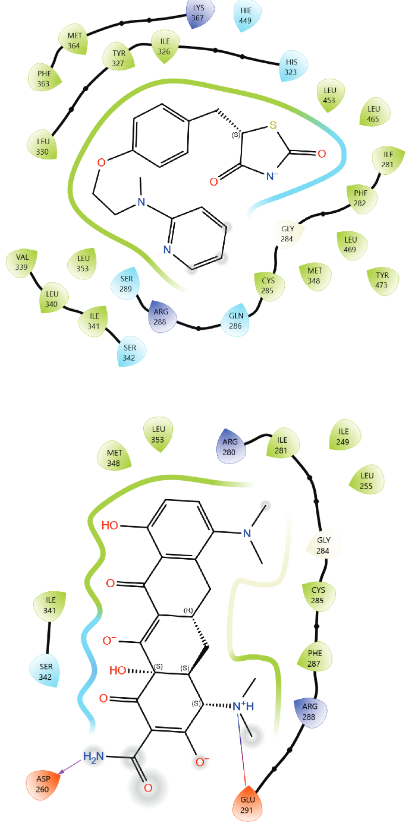
이는 P37231-165의 결합 방식을 보여주며, 이 화합물은 Rosiglitazone에 존재하지 않는 새로운 부분 구조를 포함하고 있어 전체 도킹 점수는 낮더라도 새로운 최적화 가능한 상호작용을 형성할 가능성이 있다.