A comprehensive survey of genome language models in bioinformatics
Introduction
지난 10년간 유전체학은 딥러닝의 발전에 힘입어 큰 변화를 겪었고, 변이 효과 예측, 후성유전적 궤적 모델링, 단일세포 오믹스 분석 같은 핵심 과제에서 전례 없는 성과를 보여주었다. DeepSEA나 Borzoi 같은 모델은 합성곱 신경망과 트랜스포머 기반 구조가 복잡한 조절 패턴을 해독하는 데 매우 강력하다는 점을 보여준다. 하지만 여전히 인간 유전체의 대부분을 차지하는 비암호화 영역의 기능을 이해하는 일과, 3차원 염색질 구조에 의해 영향을 받는 장거리 조절 상호작용을 포착하는 일은 큰 난제로 남아 있다. 이런 한계를 극복하기 위해 자연어처리에서 성공을 거둔 BERT, GPT 같은 대규모 언어 모델의 아이디어가 생물학으로 확장되었고, 특히 AlphaFold 같은 성과를 거치며 서열 기반 모델링과 표현 학습의 중요성이 더욱 부각되었다.
Landscape of gLMs
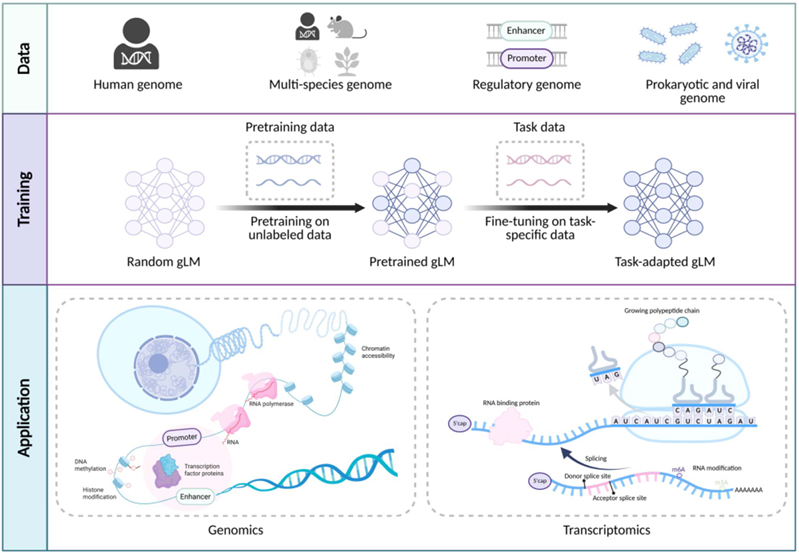
이런 흐름 속에서 DNA와 RNA 서열을 생물학적 텍스트로 간주해 장거리 의존성과 계층적 문맥을 학습하는 게놈 언어 모델(gLMs)이 등장했고, DNABERT나 Nucleotide Transformer 같은 모델은 조절 영역 분류, 기능 주석, 변이 효과 예측 등에서 성능 향상을 보여주었다. 그럼에도 불구하고 gLM을 효과적으로 개발하고 활용하기 위해서는 어떤 아키텍처를 선택할지, 어떤 방식으로 토큰화할지, 어떤 데이터로 사전학습할지, 그리고 어떻게 공정하고 엄밀하게 평가할지 같은 문제가 여전히 중요하다. 따라서 이 리뷰는 단백질 언어모델을 제외한 기초 gLM의 필요성, 설계와 구축 방식, 사전학습 전략, 평가 방법을 중심으로 정리하며, 마지막으로 남아 있는 핵심 과제와 향후 연구 방향까지 제시한다
Why genome language models
게놈 언어 모델(gLM)은 시퀀싱 데이터가 폭발적으로 증가하면서 기존의 딥러닝 모델이 유전체학의 복잡성을 충분히 처리하기 어려워진 한계를 해결하기 위해 등장했다. CNN이나 RNN 같은 전통적인 모델은 원래 컴퓨터 비전이나 짧은 텍스트 처리에 적합하게 설계되어 있어, 멀리 떨어진 enhancer와 promoter 사이의 장거리 상호작용처럼 유전체에서 중요한 긴 거리 의존성을 잘 포착하지 못한다. 또한 이런 모델들은 주로 수작업으로 만든 필터나 얕은 모티프 탐지에 의존하기 때문에, 단순히 모티프의 존재 여부만 파악할 뿐 그 모티프가 어떤 조절 문맥에서 기능하는지는 충분히 이해하지 못한다. 더 나아가 시퀀싱 비용이 계속 낮아지고 참조 데이터베이스가 수조 개의 염기로 커지면서, 특정 작업에만 맞춘 기존 모델이나 사람이 직접 설계한 특징들은 점점 한계에 부딪히고 있다.
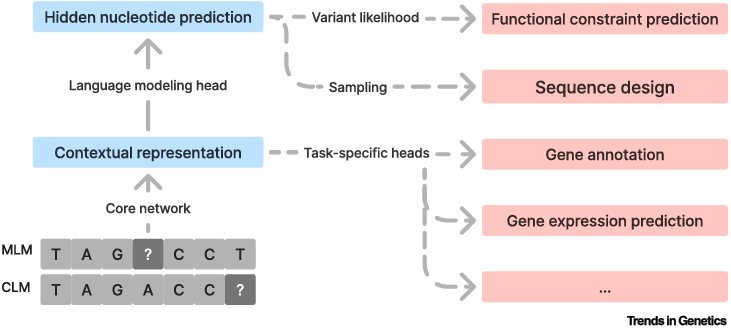
이러한 문제를 극복하기 위해 gLM은 Transformer, Hyena, Mamba 같은 최신 아키텍처를 활용해 국소적인 정보뿐 아니라 메가베이스 규모의 서열에서 나타나는 장거리 의존성까지 함께 학습하며, 마스킹된 토큰 예측이나 다음 토큰 예측 같은 자기지도학습을 통해 라벨이 없는 방대한 서열로부터 표현을 학습한다. 이 과정에서 모든 비라벨 뉴클레오타이드가 학습 신호로 활용되므로, gLM은 전체 팬게놈 수준의 데이터를 받아들여 종과 작업을 넘나드는 지식 전이를 가능하게 한다. 결과적으로 gLM은 기능 주석, 변이 효과 예측, 조절 요소 발견 같은 다양한 하위 과제에 유연하게 적용될 수 있는 범용 표현 학습 기반을 제공하며, 질병 변이 해석, 합성생물학, 정밀의학, 진화 연구 등 여러 분야에서 중요한 기반 도구로 자리잡고 있다.
Model architectures and tokenization strategies
Model architectures
Transformer encoder
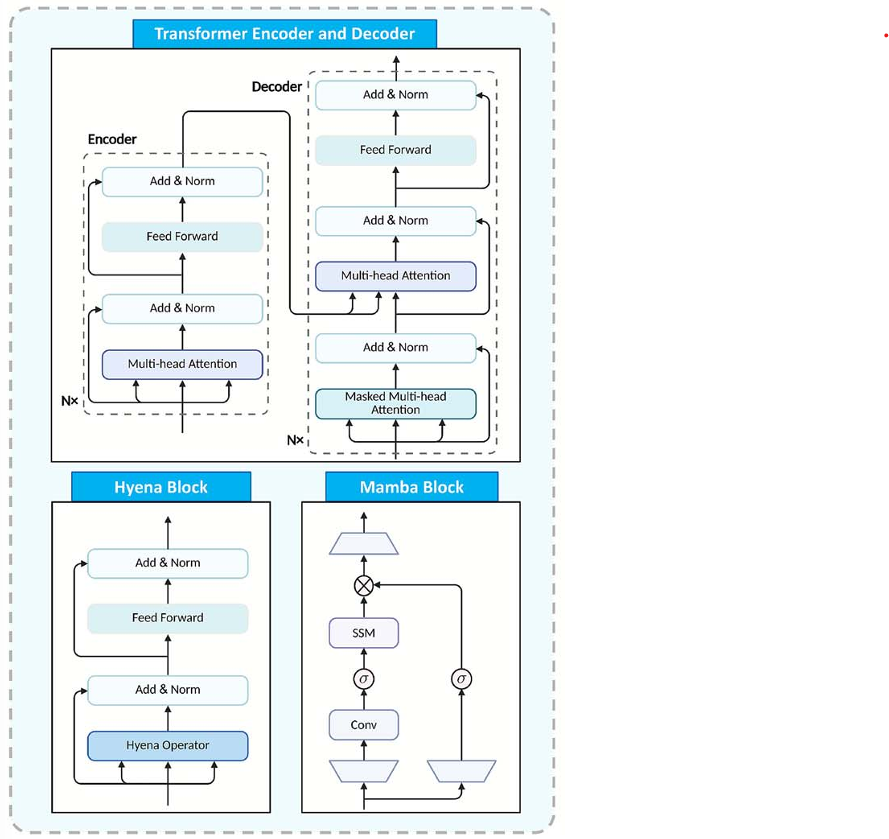
양방향 self-attention을 이용해 서열의 앞뒤 문맥을 동시에 반영하므로, 전체 서열의 정보를 통합해야 하는 분류의 작업에서 적합하다. Nucleotide Transformer와 DNABERT-2가 이런 방식에 해당하며, 긴 서열과 다양한 유전체 벤치마크에서 강한 성능을 보인다.
Transformer decoder
단뱡향 구조로, 실제와 비슷한 유전체 서열을 생성하거나 서열의 빈 부분을 채우는 생성형 작업에 잘 맞는다. 다만 일반적인 decoder는 긴 문맥을 다루는 데 계산 비용이 커서 한계가 있고, 이를 보완하기 위해 megaDNA처럼 계층적이거나 다중 스케일 메커니즘을 도입한 모델들이 등장했다.
Hyena based architectures
attention을 쓰지 않고 긴 convolution 연산과 gating을 이용해 매우 긴 범위의 의존성을 효율적으로 모델링한다. 유전체에서는 enhancer-promoter 상호작용이나 chromatin domain처럼 초장거리 관계가 중요하므로, HyenaDNA와 Evo 같은 모델이 이런 특성에 적합하다.
State Space Model based architectures
continuous-time dynamical system에서 아이디어를 얻은 구조로, 선형 시간 복잡도로 매우 긴 서열을 처리할 수 있다. 대표적으로 Caduceus는 Mamba를 확장해 양방향과 reverse-complement equivariance를 반영하며, 염색체 길이 수준의 DNA 서열도 적은 파라미터로 학습할 수 있다.
Sequence tokenization methods
연속적인 염기서열을 모델이 다룰 수 있는 이산 토큰으로 바꾸는 방법이다. 토큰 단위가 작을수록 원래 서열 정보를 더 정밀하게 보존하지만 입력이 길어지고, 반대로 단위가 클수록 입력은 작아지지많 세부 정보가 줄어든다.
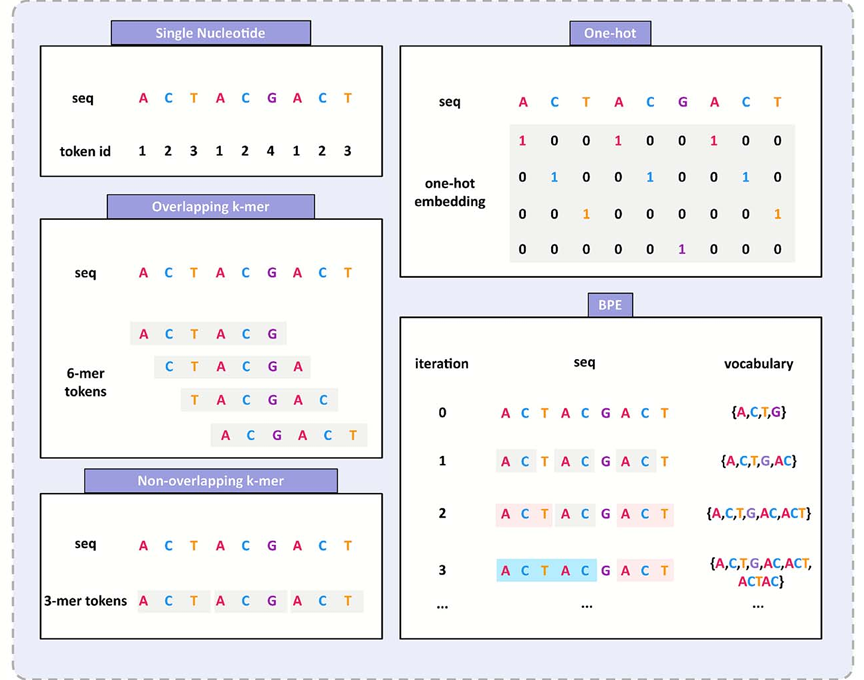
One-hot encoding
A,C,G,T를 각각 별도의 이진 벡터로 표현하는 방식으로, 정보 손실 없이 가장 원시적인 형태의 서열을 유지한다. 하지만 각 염기가 모두 별도 벡터가 되므로 입력 길이가 길어져 긴 유전체 영역을 다루기에는 계산 비용이 크다.
Single-nucleotide embedding
각 염기를 하나의 토큰으로 보고 이를 학습 가능한 밀집 벡터로 바꾸는 방식. SNP 영향 같은 염기 수준 변화를 직접 다루기 좋지만, 여전히 입력이 길고 더 높은 수준의 모티프 표현은 약화될 수 있다.
k-mer tokenization
연속된 k개의 염기를 하나의 토큰으로 묶는 방식으로, overlapping과 non-overlapping 두 가지가 있다. overlapping k-mer는 한 칸씩 이동하며 토큰을 만들기 때문에 미세한 위치 정보를 잘 보존하지만 입력이 매우 길어져 계산 비용이 크다. non-overlapping k-mer는 서열을 겹치지 않게 잘라 토큰 수를 줄여 더 긴 문맥을 볼 수 있게 하지만, 경계 부분의 정보가 흐려질 수 있다.
BPE and other subword methods
데이터에 자주 등장하는 염기 조합을 반복적으로 합쳐 가며 토큰을 만드는 방식으로 자주 나타나는 모티프나 반복 서열이 하나의 긴 토큰이 도리 수 있어 입력이 압축되고 계산이 빨라진다. 다만, 염기 수준의 해상도가 낮아질 수 있고, 말뭉치와 어휘 크기에 따라 결과가 달라질 수 있다는 한계가 있다.
Pretraining objectives and data resources
NLP와 마차간지로, gLM은 라벨이 없는 유전체 서열로부터 의미 있는 표현을 추출하기 위해 다양한 self-supervised 패러다임을 사용한다. 이러한 목적 함수는 DNA와 RNA의 구조적, 기능적, 진화적 특성을 포착하도록 설계되어 있으며, 이를 통해 다양한 하위 유전체 작업으로의 일반화를 가능하게 한다.
Pretraining paradigms and optimization strategies
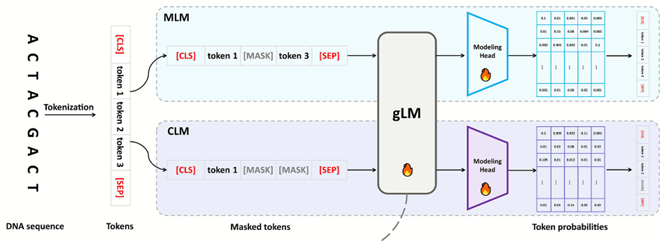
Masked language modeling
BERT로 알려진 양방향 사전학습 방식으로, 입력 토큰의 일부를 무작위로 가리고 주변 문맥으로부터 이를 예측하도록 학습하는 방법이다. 이 방식은 서열 전체를 동시에 보므로, 상류와 하류 문맥 모두에 의존하는 모티프와 신호를 잘 찾는 데 강하다. pretraining 과정에서 모델은 synonymous sequences pattern과 문법 규칙을 암묵적으로 학습하게 되고, 그 결과 생물학적으로 유사한 서열들이 임베딩 공간에서 서로 가깝게 군집되는 표현을 얻을 수 있다. 다만 표준 MLM은 서열에 대한 명시적인 방향을 생성 과정에서 정의하지 않으며, 각 마스크 위치를 문맥을 바탕으로 독립적으로 예측하기 때문에 순차적 의존성을 충분히 강조하지 못할 수 있다.
Causal language modeling
이전 토큰들만 보고 다음 토큰을 예측하도록 학습하는 단방향 방식이다. 토큰을 하나씩 생성할 수 있게 해주며, 서열에 대한 확률 분포를 학습한다. CLM이 갖는 장점은 다음과 같다.
1. autoregressive model은 훈련 데이터와 유사한 새로운 서열을 생성할 수 있어in siliico 서열 설계에 유용하다.
2. 서열을 순차적으로 입력하므로 이론적으로 매우 긴 서열도 다룰 수 있다.
3. 순차적 의존성과 뉴클레오타이드의 순서 제약을 직접적으로 학습한다.
반면, CLM은 과거 문맥에만 의존하므로, 순수한 예측 작업에서는 MLM보다 데이터 효율이 낮을 수 있고, motif classification 과제에서는 더 큰 모델이나 데이터가 필요하다.
Hybrid pretraining paradigms
여러 pretraining 목표를 결합하는 방식이다. 각 방법의 장점을 함께 활용하고, 학습 과정에 도메인 지식을 주입하는데 목적이 있다. hybird pretraining은 데이터 기반 학습과 도메인 지식을 결합해 생물학적 서열의 복잡성을 다루려는 방식이지만, 여러 손실 함수나 모달리티의 균형을 맞춰야 하므로 학습이 더 복잡해지고, 정제된 지식이나 데이터가 추가로 필요하다는 단점이 있다.
Pretraining datasets
| Category | Dataset | Scale | Description |
|---|---|---|---|
| 인간 게놈 및 변이 (Human genome and variation) | GRCh38 | 약 3.2 Gb | GRCh38은 Homo sapiens의 최신 기준 게놈 어셈블리로, Genome Reference Consortium에서 제공하는 염색체 수준의 유전체 서열이며 관련 보조 아카이브가 포함됨 |
| 1000 Genomes | 2504개 게놈, 88M 변이 | 다양한 인간 집단의 유전적 다양성을 포착하기 위해 설계된 공개 카탈로그 데이터셋으로, NCBI/BioC 프로젝트에서 제공 | |
| 종 간 게놈 (Cross-species genomes) | NCBI RefSeq | 19.6 Tb, >2.9B 서열 | 유전체, 전사체, 단백질 서열을 포함한 비중복(non-redundant) 데이터셋으로, NCBI가 국제 협력으로 구축 |
| UCSC | 100개 이상 어셈블리 | 다양한 척추동물 및 모델 생물의 게놈 어셈블리를 정렬 및 주석화하여 제공 | |
| Ensembl | 수백 개 게놈 | 척추동물과 일부 무척추동물의 게놈 어셈블리 및 주석 데이터를 통합 제공 | |
| 조절 및 기능 유전체 (Regulatory and functional genomics) | EPDnew | 약 30,000 프로모터 | 진핵생물 프로모터의 실험 기반 주석 데이터베이스로, 고처리량 전사 시작점(TSS) 데이터 기반 |
| DeepSEA | 약 4M × 1kb 서열 | 전사인자 결합 및 히스톤 변형 등 기능적 영향을 예측하기 위한 고정 길이 DNA 서열 데이터 | |
| ENCODE | - | 인간 및 마우스의 ChIP-seq, DNase-seq, ATAC-seq, RNA-seq 데이터를 통합한 기능 유전체 프로젝트 | |
| RNA 및 전사체 (RNA and transcriptomics) | RNAcentral | 23M 서열 | 주요 RNA 데이터베이스를 통합한 비암호화 RNA(ncRNA) 저장소 |
| Rfam | 3,932 RNA 패밀리 | 공통 구조 및 기능을 기반으로 RNA 패밀리를 분류한 데이터베이스 | |
| PanglaoDB | 400만+ 단일세포 | 인간 및 마우스 단일세포 RNA-seq 데이터와 세포 타입 주석 제공 | |
| 원핵생물, 바이러스 및 메타유전체 (Prokaryotic, viral, and metagenomic) | BV-BRC | 110M+ 유전자 | 세균 및 바이러스 병원체 데이터를 통합 제공하며 비교 분석 도구 포함 |
| OpenGenome | 80,000 게놈, 300 Gbp | 다양한 박테리아 및 고세균 게놈을 포함한 프로카리오트 및 파지 데이터 | |
| MGnify | 7.3M 컨티그, 32 Gbp | 다양한 환경의 메타유전체 데이터를 분석 및 재구성한 EMBL-EBI 리소스 | |
| Open MetaGenomic | 3.1 Tb, 3.3B CDS | JGI IMG/M 및 MGnify 데이터를 통합한 메타유전체 프로젝트 데이터 |
Evaluation settings, fine-tuning paradigms, downstream tasks, and benchmarking
Evaluation settings
gLM의 실용적 성능을 종합적으로 평가하려면 다양한 다운스트림 과제에서의 결과를 함께 살펴봐야 하며, 이를 위해 표준화된 평가 프로토콜이 중요하다. 일반적으로 평가 방식은 라벨이 충분한지, 그리고 목표 응용이 무엇인지에 따라 supervised, zero-shot, few-shot의 세 가지로 나뉜다.
supervised evaluation
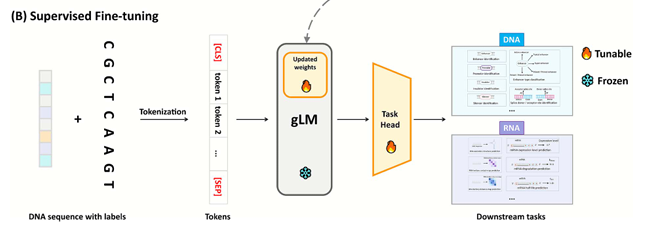
label이 있는 데이터로 모델을 과제별로 fine-tuning한 뒤, 프로모터 인식, splice site 예측, TF binding site 분류 같은 대표적인 유전체 과제에서 성능을 측정한다. 하지만 label이 부족한 상황이나 여러 task를 동시에 다뤄야 하는 경우에 한계가 있다.
Zero-shot evaluation
모델을 특정 과제에 맞게 추가 학습하지 않고 그대로 적용하는 방식이다. 이 경우 pretraining된 서열 표현 자체를 이용해 예측할 수 있는데, 특히 생성형 gLM은 서열의 likelihood를 계산할 수 있으므로 변이의 기능적 영향을 in silico로 평가하는 데 유용하다.
Few-shot evaluation
아주 적은 수의 label만 주어졌을 때 모델이 얼마나 잘 적응하는지를 본다. 이는 GPT-3 스타일의 in-context learning처럼 몇 개의 예시와 라벨을 프롬프트에 넣고 바로 예측하게 하거나, 매우 작은 데이터셋으로 제한된 fine-tuning을 수행하는 방식으로 이뤄진다.
Fine-tuning paradigms
gLM의 fine-tuning은 pretrained 지식을 유지하면서 특정 downstream task에 맞게 모델을 적응시키는 핵심 방법이다.
Full fine-tuning
모델의 모든 파라미터를 다운스트림 과제에 맞게 다시 학습하는 방식이다. 이 방법은 pretrained 모델을 일종의 초기값으로 사용해 전체 네트워크를 재조정하므로, 많은 벤치마크에서 매우 좋은 성능을 낸다. 하지만 이 방식은 수많은 파라미터를 모두 업데이트해야 하므로 메모리와 계산 비용이 크고, 특히 학습 데이터가 적을 때는 과적합 위험이 높다. 작은 데이터셋에서는 모델이 잡음까지 외워버려 사전학습 과정에서 얻은 일반적인 표현 능력을 잃을 수 있다.
Selective fine-tuning
일부 파라미터만 업데이트하는 방식이다. 이런 선택적 업데이트는 학습 가능한 파라미터 수를 크게 줄이면서도 꽤 강한 성능을 유지할 수 있다는 장점이 있다.
Parameter-efficient fine-tuning
기존 pretrained weight를 거의 건드리지 않고, 아주 적은 수의 추가 파라미터만 학습해 모델을 조정하는 방식이다. Adapter는 transformer 층 사이에 작은 신경망 모듈을 삽입하고, backbone은 고정한 채 adapter만 학습한다. 이렇게 하면 전체 모델에 비해 학습해야 할 파라미터가 훨씬 적어져 효율적이다. LoRA는 pretrained weight 자체를 직접 바꾸지 않고, 저랭크 분해 형태의 작은 업데이트 행렬을 각 층에 추가하는 방법이다. Prompt tuning은 모델 본체를 고정하고, 입력 앞에 붙이는 연속형 soft prompt를 학습하는 방식이다.
Taxonomy of downstreamtasks for gLMs
Regulatory element recognition
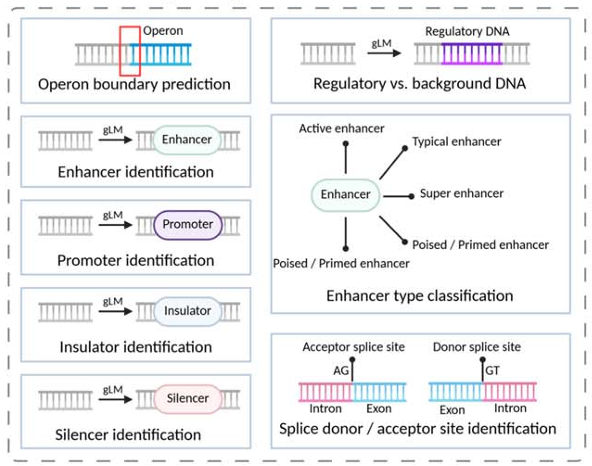
promoter, enhancer, silencer, insulator 같은 조절 요소를 서열로부터 식별하는 문제로, 보통 특정 위치를 중심으로 유전체 서열을 입력한 뒤 gLM이 만든 embedding을 linear head에 넣어 분류한다.
- DNABERT-2는 multi-species genome에 대해 BPE tokenizer를 사용하고 GUE benchmark에서 promoter와 enhancer 분류에 강한 성능을 보임
- NT 계열 모델도 promoter, enhance, UTR 등 다양한 유전체 요소를 잘 분리하는 표현을 학습
- SegmentNT는 U-Net 스타일 segmentation head를 붙여 gene annotation,splice site detection, regulatory element localization에서 높은 성능을 달성했다.
Quantitative regulatory activity prediction
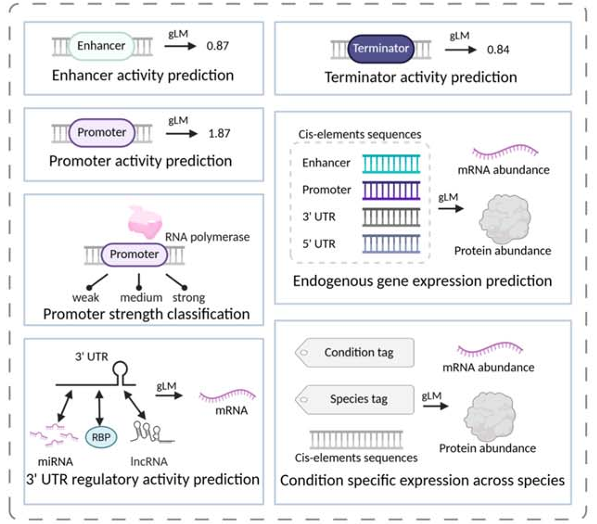
조절 서열이 실제로는 어느 정도의 발현이나 reporter activity를 유도하는지를 연속값으로 예측하는 과제. endogenous gene expression, enhancer activity, promoter strength, terminator activity,3' UTR regulatory activity 등이 대표적이다.
- Species LM은 여러 종의 유전체로 pretraining한 뒤 얕은 회귀모델과 결합해 promoter와 3'UTR activity를 예측했다
- AgroNT는 작물과 모델 식물 48종의 유전체로 학습해 promoter/terminator strength 및 tissue-specific expression 예측에서 뛰어난 성능을 보였다.
- regLM처럼 autoregressive DNA LM과 supervised orcale network를 결합해 yeast와 human cell에서 원하는 발현 수준의 cis-regulatory element를 설계하는 연구도 있다.
Variant effect prediction
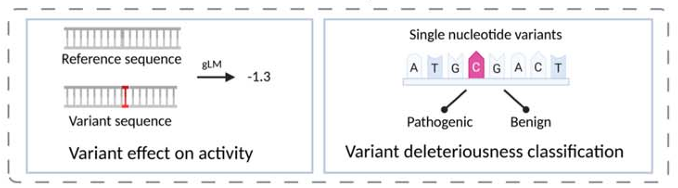
SNV나 작은 insertions and deletions가 유전자 조절이나 기능에 어떤 영향을 주는지 평가하는 문제다. 변이가 있는 서열과 없는 서열을 동일한 genomic context에서 비교해야 하므로 장거리 문맥이 중요하다.
- NT-Nucleotide : coding과 regulatory region전반에서 변이 영향을 예측하는 likelihood-based score를 제공한다
- GPN MSA : alignment-aware MLM으로 약 90억 개의 인간 SNV 점수를 미리 계산해 deleteriousness prediction에서 강한 성능을 보였다.
Chromatin and protein interaction modeling
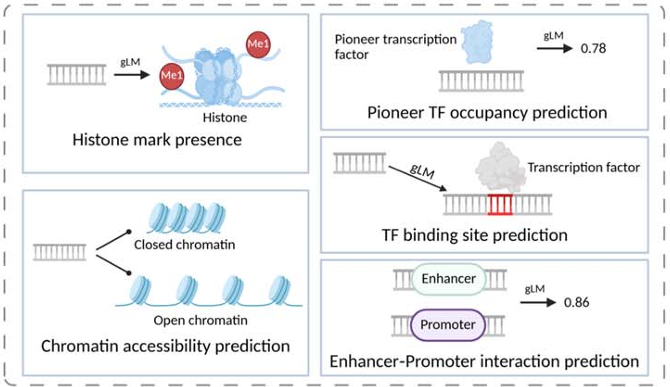
DNA-protein, ,RNA-protein 상호작용과 epigenetic state를 예측하는 문제이다. TF binding site, chromtain accessibility, histone mark, enhancer-promoter interaction 등이 포함된다.
Molecular modification prediction
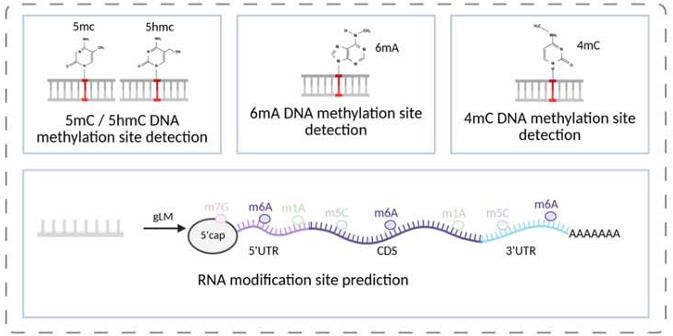
DNA나 RNA의 화학적 수식, 예를 들어 5mC, 6mA, 4mC, 5hmC, RNA m6A 등을 예측하는 과제이다. 이 문제는 단순 motif보다 더 미세한 서열 신호와 긴 문맥을 필요로 한다.
Taxonomic and gene classification
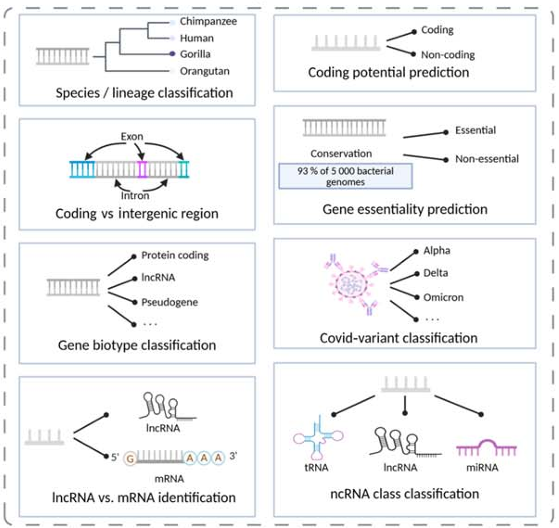
서열이 어떤 생물종에 속하는지, 혹은 유전체 / 전사체 수준에서 어떤 범주에 해당하는지를 분류하는 과제이다. 메타게놈 fragment를 species나 genus로 할당하거나, coding과 non-coding sequence를 구분하고, gene biotype이나 transcript annotation을 수행하는 것이 여기에 포함된다.
Generative sequence design
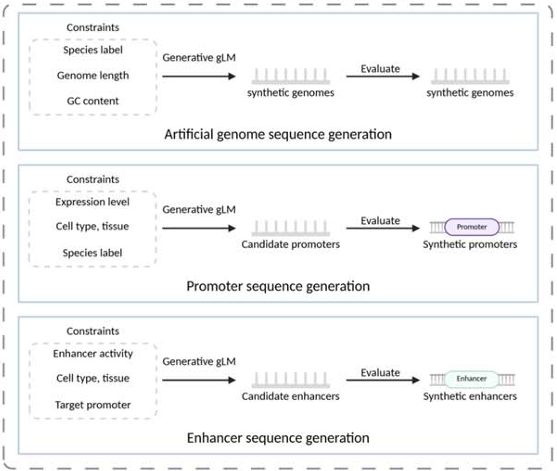
원하는 기능적 제약을 만족하는 새로운 DNA 또는 RNA 서열을 생성하는 과제다. 예를 들어 목표 종과 원하는 발현 수준을 지정하면, gLM이 조건 토큰을 받아 코돈 사용과 발현을 고려한 coding sequence를 autoregressive하게 생성할 수 있다.
RNA-specific structure and expression tasks
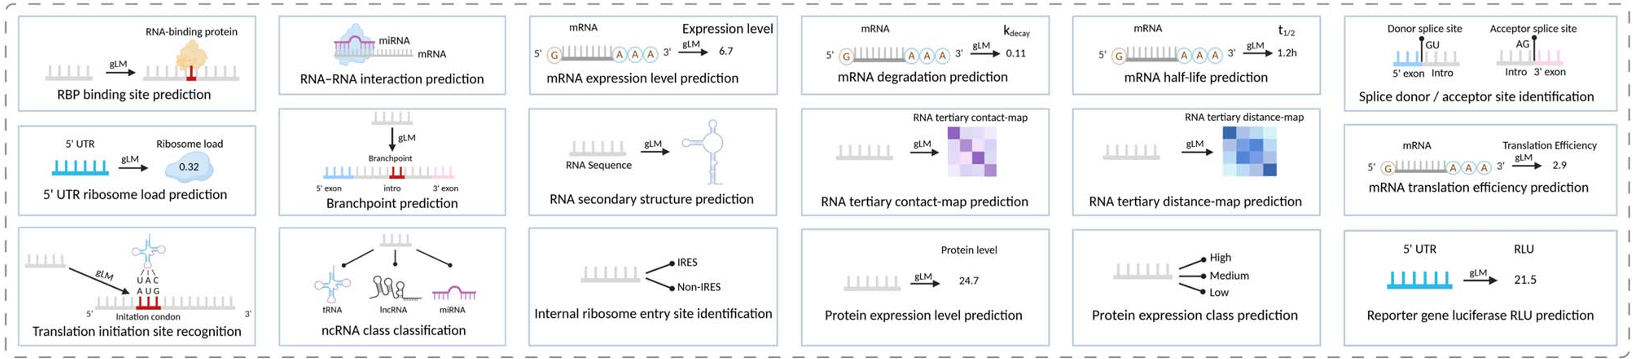
RNA의 접힘 구조와 발현 관련 특성을 예측하는 문제이다. 여기에는 secondary/tertiary structure, stability, 5' UTR ribosome load, translation efficiency 등이 포함된다. RNA gLM은 mRNA 5' UTR을 contextual embedding으로 바꾸고, regression head로 translation efficiency를 예측하거나, structured prediction head로 base-pair probability matrix와 dot-bracket 형태의 secondary structure를 출력할 수 있다.
Benchmarking and datasets
| 범주 | Benchmark | 과제 및 특징 | 주요 모델/경향 |
|---|---|---|---|
| 비부호화 조절 서열 및 변이 영향 | DART-Eval | - 규제 DNA의 유의미한 표현 학습 평가 - 규제 영역 및 배경 서열 구분, TF motif 민감도 평가, cell-type-specific regulatory activity 예측 등 5단계 과제 포함 | DNA LM이 규제 서열 및 변이 효과를 잘 학습하는지 평가 |
| BEND | - 실제 생물학적 과제 다룸 - gene finding, enhancer annotation, chromatin accessibility 등 7개 데이터셋 제공 | NT, DNABERT-2, GENA-LM: short-range 규제 과제에서 강점 | |
| GenBench | - Attention-based transformer, CNN, SSM 비교 - enhancer, promoter, splice site, TF binding 등 과제를 short-range와 long-range로 나누어 평가 | attention-based transformer가 short-range 과제에서 우수 | |
| Genomics LRB | - 장거리 문맥 모델링 능력 평가 - eQTL prediction, ClinVar와 OMIM 기반 pathogenic variant classification 등 9개 과제 포함 | long-range 문맥 모델링에 대한 gLM의 한계 및 필요성 강조 | |
| RNA 생물학 및 전사체 평가 | BEACON | - RNA folding의 물리적 원리와 서열 조절 문법 평가 - RNA 구조 분석, 기능 예측, engineering 응용 포함 | RNA 특화 모델이 RNA 구조와 서열 조절 문법을 잘 이해하는지 평가 |
| RNA sequence-related predictive benchmark | - ncRNA function classification, RNA modification site prediction 등 RNA 생애 전반의 서열 기반 예측 과제 모음 | RNA-FM, SpliceBERT, 3UTRBERT: RNA-related 과제에서 강력한 성능 | |
| 기능적 결과 평가 | COMET | - DNA, RNA, protein, cross-molecular context, multi-molecular interaction 포함 - 17개 multi-omics 과제 다룸 | multi-omics 모델이 통합 모델로서의 성능을 평가 |
| 일반 경향 | 모델 성능 | - 특정 모델이 모든 과제에서 최고는 아님 - NT, DNABERT-2, GENA-LM은 short-range 규제 과제에서 강하고, convolutional model은 quantitative/long-range 과제에서 우수함 | 특화 모델이 각 도메인에서 우수한 성능을 보임 |
| 도메인 특화 사전학습 | - RNA-FM, SpliceBERT, 3UTRBERT, RNAErnie는 RNA-related benchmark에서 매우 강함 - multi-omics 모델은 서열 간 상호작용이 중요한 과제에서 좋은 성능 보임 | 도메인 특화 모델이 성능 향상에 기여 | |
| 정밀한 quantitative 과제 | - sequence-to-signal regression, variant scoring 등에서 여전히 특화 모델이 우수함 | Enformer, CADD 등 특화 모델이 선도적 | |
| 장거리 문맥 및 분자 간 상호작용 | - GenBench, LRB, COMET의 long-range 과제에서 gLM의 한계 드러남 - 모델 크기나 context length를 늘리는 것으로는 장거리 추론 및 interaction modeling의 향상이 부족함 | gLM은 장거리 문맥과 분자 간 상호작용을 처리하기 위한 아키텍처 혁신이 필요 |
Challenges and future directions
| 구분 | 핵심 문제 | 현재 한계/원인 | 미래 방향 |
|---|---|---|---|
| Data | 데이터 부족과 품질 문제 | - 라벨된 DNA/RNA 데이터가 인간과 일부 모델 유기체에 편중되어 있어 종 간 일반화에 편향이 생김 - sequencing error, annotation inconsistency, batch effect 등의 기술적 잡음으로 신뢰도 높은 supervision과 표준화가 어려움 | - 더 넓은 종 커버리지 확보 - harmonized workflow 구축 - label sparsity를 완화할 few-shot learning 개발 |
| Model | 장거리 의존성 모델링과 계산 효율의 균형 | - 유전체는 수백 kb 이상의 문맥이 필요한데, standard transformer는 이를 감당하기 어렵고 계산 비용이 큼 | - Enformer, HyenaDNA, JanusDNA처럼 긴 context를 처리하는 효율적 구조 발전 - sparse attention, memory compression, distillation, pruning, quantization, hardware-algorithm co-design |
| Evaluation | 표준화된 benchmark와 metric 부족 | - NLP의 GLUE/SuperGLUE 같은 통합 평가 프레임워크가 DNA/RNA에는 없음 - 연구마다 데이터셋과 프로토콜이 달라 결과 비교가 어려움 - 종과 세포형 간 generalization도 충분히 평가되지 않음 | - 생물학적으로 의미 있는 표준 평가체계 구축 - cross-species 및 cross-cell-type generalization을 명시적으로 검증하는 프로토콜 마련 |
| Interpretability | 모델 내부 표현의 생물학적 해석 어려움 | - embedding이나 attention pattern이 생물학적 요소를 반영할 가능성은 있지만, 이를 일관되게 해석하고 기능과 연결하는 도구가 부족 - 일부 attention head는 enhancer나 promoter에 특화된 듯 보이지만 아직 충분히 검증되지 않음 | - 모델 내부 표현과 생물학 현상을 직접 연결하는 해석 도구 개발 - attention/embedding 분석의 생물학적 검증 강화 |
| User vs Developer | 사용자와 개발자 관점의 요구가 다름 | - 사용자에게는 기존 gLM을 어떻게 적용할지, 개발자에게는 어떻게 확장할지가 각각 다른 문제이며, 이를 함께 고려한 가이드가 부족함 | - 실사용 지침과 모델 개발 지침을 분리·체계화하여 적용성과 확장성을 동시에 높이는 방향 |