BIODISCOVERYAGENT
Yusuf Roohani, et all. "BIODISCVOERYAGENT : An AI AGNET For Designing Genetice Perturbation experiments" ICLR 2025
Introduction
Biomedicla research 분야에서 한 가지 핵심 과제는 약물이 결합했을 때 질변 표현형이 원하는 변화를 유도하는 단백질을 식별하는 것이다. 이러한 약물 타겟의 잘못된 식별은 clinical trials 실패의 주요 원인 중 하나이다.
CRISPR-based genetic perturbation은 단백질을 코딩하는 유전자를 repression 또는 activation하여 생성된 biological effect를 기반으로 약물 타겟을 식별한다. 하지만 모든 단일 유전자를 perturbing 하기에는 비용이 많이 든다. 일반적인 perturbation screen은 약 19,000개의 단백질 코딩 유전자를 perturb하지만, 실제로 desired 표현형을 보이는 유전자는 몇 개 ~ 수천 개 수준이다.
그래서 의미있는 표현형을 생성할 가능성이 높은 유전자를 우선적으로 선택하는 방법을 통해 실험을 전략적으로 설계하면 탐색 프로세스의 효율성을 향상시킬 수 있다. 최근 이를 위해 Bayesian optimization 알고리즘을 benchmark하였지만, 작은 데이터셋으로 학습되어야 하며, 해석이 어려운 bespoke ML model의 학습을 요구하며 scientific 문헌에 포함된 생물학적 사전지식을 활용할 수 없다는 한계를 가지고 있다.
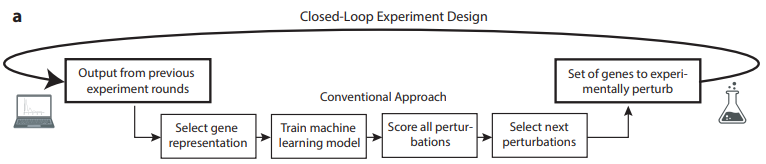
반면 LLMs는 scientific 문헌을 학습하였으므로 생물학적 지식을 가지고 있다고 볼 수 있다. 실제로 clinical 질의응답을 위한 information retrieval, clinical trials에서 환자 매칭, 유전자 조합 식별, 유전자 기능 예측, 유전자 발현 데이터를 활용한 세포 타입 annotation 같은 task에서 좋은 성능을 보였다.
LLM은 domain specific 지식과 실험 결과를 해석하고 추론하는 능력을 가지고 있다. 하지만 생물학적 contexts 전반에서 완전한 적용을 위해서는 문헌 외의 표와 같은 다른 데이터에 접근하는 능력, 생물학적 타당한 유전자 선택이 보장된 탐색 공간 제약, 여러 단계를 거친 실험 전략의 일관성 유지 능력, 의사결정 과정 해석 가능성, 사람 피드백을 반영할 수 있는 상호작용 구조를 포함해야 한다.
본 연구는 이러한 과제들을 일부 해결하기 위해 BioDiscoveryAgent를 제안한다.
Problem Fomulation
closed-loop 실험 설계 과제를 연구한다. Agent는 각 실험 라운드에서 어떤 유전자를 perturbation할지 결정하고, 그 결과를 이용하여 이후 라운드를 계획한다. 목표는 전체 실험 라운드 동안 발견되는 히트 유전자 또는 유전자 조합 수를 최대화하는 것이다. 두 가지 실험 환경에서 모델을 평가한다
1. Single-gene perturbation
각 라운드 마다 개의 유전자를 perturbation하고 선택된 개의 유전자 집합을 라고 한다. 각 유전자를 perturbation하여 표현형 반응()을 관찰한다. 다음 라운드에는 이전 라운드 에서 실험된 모든 유전자의 표현형 반응 정보를 사용한다. 마지막으로 라운드 후, total hit raio는 로 정의된다.
- : 인간의 단백질 코딩 유전자 집합
- : 유전자
- : 유전자 를 perturbation 시 효과
- 하나의 실험 라운드 : 유전자 집합을 perturbation한다. 이때 각 유전자는 서로 다른 세포에서 개별적으로 perturbation된다.
- goal : 인 유전자를 식별한다. (표현형에 대한 hit)
- : 로 실험을 누적해서 번까지 진행시 발견된 true hit 수
- : 로 전체 true hits의 개수를 의미한다.
2. Two-gene perturbation
유전자 쌍()을 예측하는 것으로 계산 공간이 로 증가하게 된다. 생물학에서 많은 perturbation이 단일 유전자가 아니라 gene interaction 때문에 나타나기 때문에 위 조건을 고려한것 같다. 유전자 쌍인 것만 다르지 나머지는 1과 동일하다.
BiodiscoveryAgent
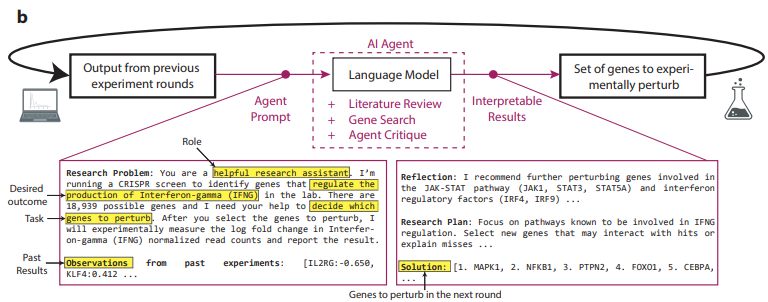
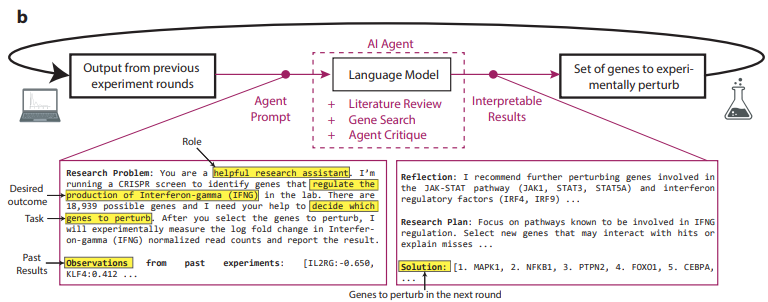
생물학적 환경에서 scientific 발견 과정을 자동화하기 위한 LLM을 사용하는 방법이다. 이는 과학 지식 접근, 가설 생성, 실험 계획 수립, 결과 해석을 포함한다.
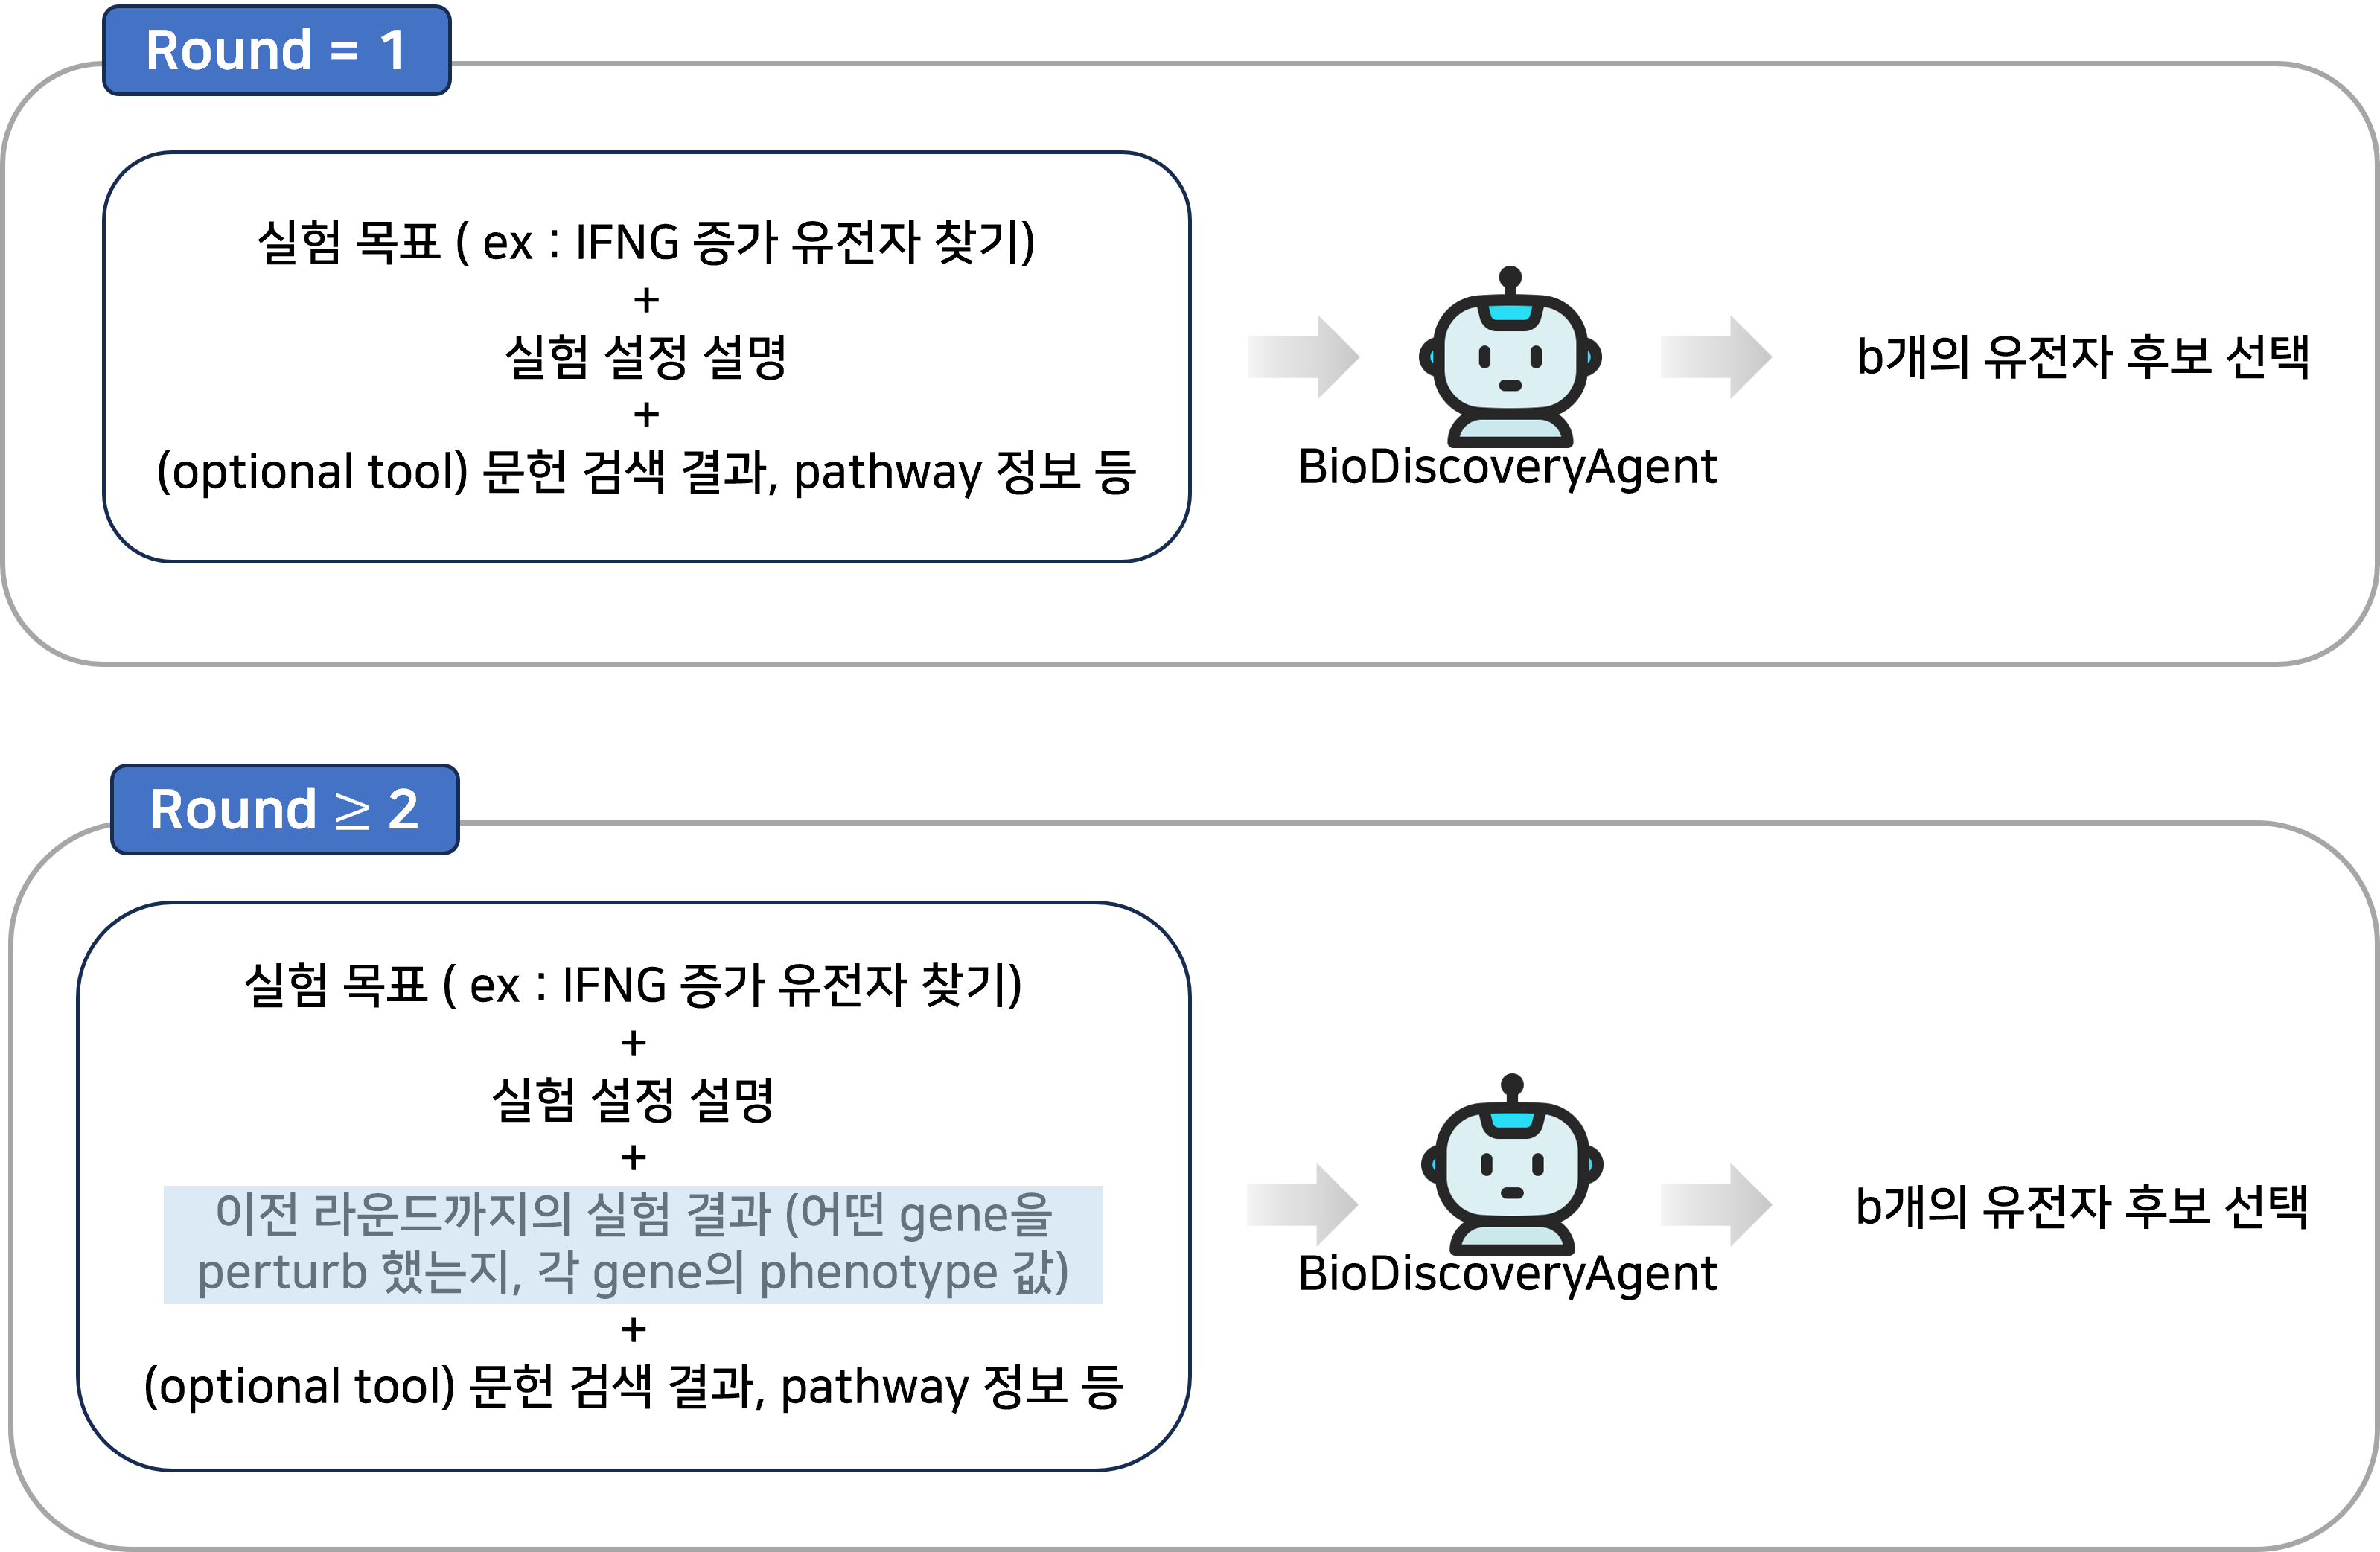
각 단계 마다 에이전트는 다음 단계에서 실험할 개의 유전자 묶음을 선택한다. 이때 에이전트는 다음 정보를 포함한 프롬프트를 입력으로 사용한다:
- 실험 설정에 대한 일반 정보
- 검증하려는 생물학적 가설 또는 연구 목표
- 이전 실험 라운드들에서 얻은 표현형 관측 결과
그리고 이 정보를 바탕으로 다음 라운드에서 perturb할 유전자들을 선택한다.
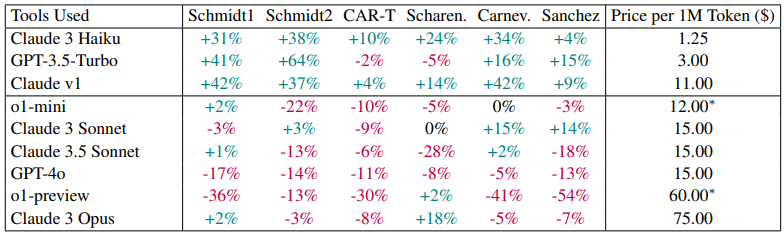
서로 다른 복잡도를 가진 9개의 대규모 언어 모델을 평가하였으며, 모델 파라미터 수를 알 수 없으므로 대리 지표로 토큰당 비용을 모델 크기로 사용하였다.
Processing gene list and experimental observations
perturbation할 유전자를 선택할 때 모든 유전자를 후보로 선택하거나 기존 지식을 기반하여 선택하여 유전자 목록을 좁히는 것을 피하고자 한다.
먼저 BioDiscoveryAgent는 생물학에 대한 포괄적인 이해를 자유롭게 활용하여 아무 제한 없이 유전자를 제안하도록 한다. 만약 유효하지 않거나 중복된 유전자 샘플링으로 인해 여러 번의 시도 이후에도 필요한 유전자 목록을 생성하지 못한 경우 남아 있는 모든 유전자 목록을 요약하여 프롬프트에 추가해 유전자 선택을 돕도록 한다. 실험 관측값이 모델의 문맥 길이를 초과하는 경우에도 동일한 요약 기법이 사용된다.
Agent Response Format
해석 가능성 확보와 에이전트의 사고 과정을 유도하기 위해 모든 플모프트에서 일관된 응답 형식을 정의하였다. 응답을 여러 부분으로 구조화하도록 지시하였다.(성찰, 연구 계획, 해결안)
연구 계획은 효과적인 계획 수립과 진행 상황 점검을 돕는다. 성찰과 연구 계획을 통해 모델은 특정 예측의 근거가 되는 추가적인 추론을 제공하며 이는 환각 또는 충분한 근거가 없는 예측을 배제하도록 한다.
AGENT Tools
Literature search
각 실험 주기마다 에이전트가 문헌을 검색하여 예측에 활용하도록 선택할 수 있다. 관련성 높은 문헌을 찾기 위해 PubMed API를 사용한다. 검색어는 에이전트가 직접 선택한다. 논문의 요약을 프롬프트에 첨부하고 이를 활용하여 추가로 perturbation할 유전자를 식별하면서 동시에 참고 문헌 인용을 유지한다.
Gene search based on biological database
이전 단계에서 찾은 hit와 유사한 생물학적 특성을 가진 다른 유전자를 찾을 수 있게 데이터베이스를 조회할 수 있도록 한다.
- Reactome 2022 데이터베이스에서 API를 호출하여 가장 관련성이 높은 생물학적 경로를 식별한다.
- 경로들에서 가장 자주 등장하는 상위 k개 유전자를 선택 후 프롬프트에 삽입한다.
hit genes ▶️ A, B, C
A - path1, B - path2, C - path3path1 - A, C, D
path2 - B
path3 - A, DA : 2, D : 2, B : 1, C : 1
top-k결과 A, D가 선택
AI critic
main 에이전트의 선택을 평가하도록 입력을 받아 오류를 식별하고 품질을 향상시킨다. 필요에 따라 일부 또는 전체 유전자를 변경하여 새로운 유전자 입합을 제안할 수 있다.
Result
BioDiscoveryAgent outperform baselines based on hit ratio for 1-gene perturbation experiments
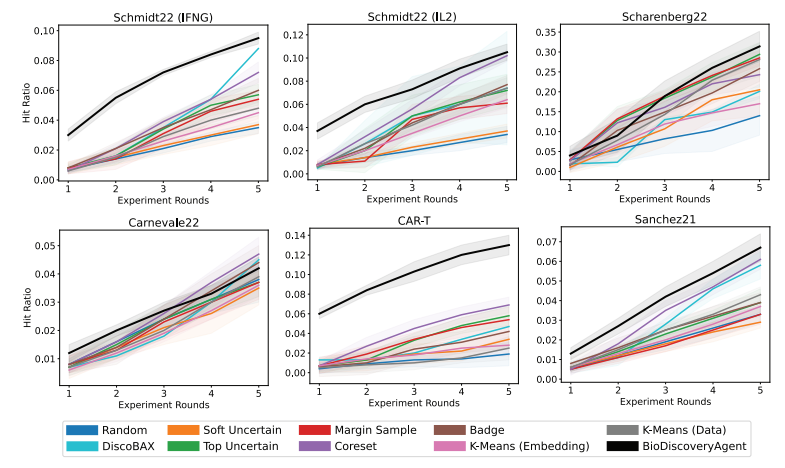
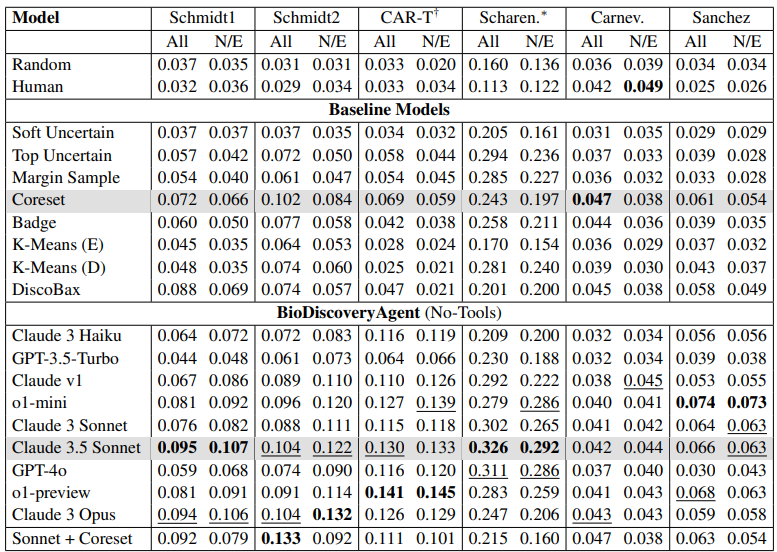
- tool없이 기본 agent로도 좋은 성능을 보여주었다
- 초기 라운드에서 성능 차이가 크다
- 비필수 유전자는 변화가 작아 예측이 어려울것 같지만 실제로 좋은 성능을 보여주었다
- 서로 다른 프롬프트와 실험 결과가 주어졌을 때 모델이 서로 다른 유전자를 예측하는 경향을 보인다.
BioDiscoveryAgent can guide 2-gene combinatorial perturbation experiments
2-gene 유전자 perturbation에서도 효과적으로 유도할 수 있음을 보여준다.
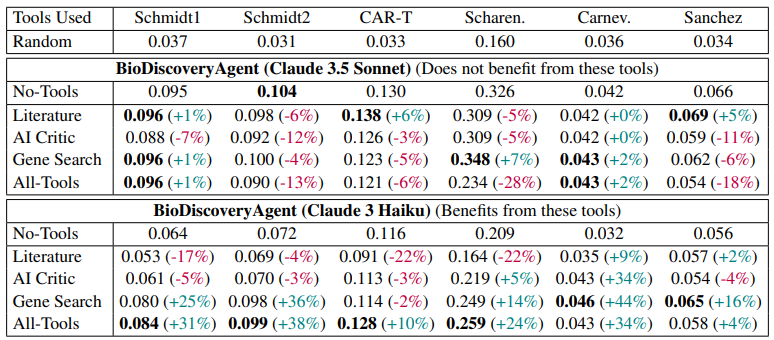
The performance of BioDiscoveryAgent can be augmented with tool-use, but the improvement varies by choice of LLM
literature search, gene search, AI critic 세 가지 tools를 사용하지 않거나, 하나만 사용하거나, 통합하여 사용했을 때 결과이다.
다양한 LLM에 대해 tools를 통합했을 때 영향을 추가로 평가하였다. 일부 모델에서는 성능이 증가하였고, 일부 모델에서는 성능이 감소하거나유의미한 변화가 보이지 않았다. 이는 모델 크기와 tool 활용 효과 사이에 잠재적인 관계가 있음을 시사한다.
상대적으로 작은 모델은 도구 기반 정보 검색의 도움을 크게 받는 반면, 큰 모델은 이미 학습된 내부 가중치를 통해 직접 활용할 수 있는 가능성이 있으므로 모델 간의 차이가 발생한다.
BioDiscoveryAgent accounts for prior knowledge and observations in decision-making
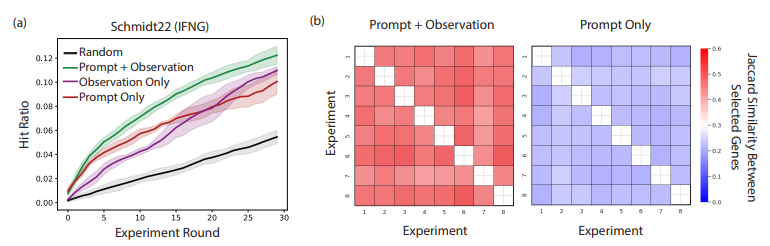
agent 의사결정에 사전 지식과 이전 실험 관측 결과가 각각 어떤 영향을 미치는지를 분석하였다.
- Prompt + Observation : 이전 실험 결과와 실험 목표에 대한 상세 정보 활용
- Prompt Only : 실험 목표 정보만 활용
- Observation Only : 이전 실험 결과만 활용
Prompt + Observation이 가장 좋은 성능을 보였다.
Prompt를 사용하는 방법들은 초기 실험 단계에서 사전 지식을 활용하지만, Observation을 사용한 경우 이러한 이점을 활용하지 못함을 보였으며, 초기 실험 단계에서 사전 지식의 중요성을 강조한다.
하지만, 실험이 진행될 수록 Observation Only가 Prompt Only보다 높은 성능을 보여주었다. 이는 agent가 관측 결과에 기반하여 점진적으로 적응할 수 있음을 보여준다.
또한 Observation을 포함하면 서로 다른 반복 실험 간 예측된 유전자 집합이 유사하게 나타남을 확인할 수 있었다.
Conclusion
BioDiscoveryAgent는 생물학 실험 설계를 지원하는 새로운 접근 방식으로, 기존의 획득 함수와 기계학습 모델 중심의 복잡한 다단계 파이프라인을 단일 프롬프트 기반 LLM 에이전트 구조로 단순화한다. 또한 각 단계에서 높은 해석 가능성을 제공하여 연구자가 모델의 예측 과정에 직접 참여하고 결과를 보완할 수 있도록 한다.
이 에이전트는 사전 생물학 지식을 활용하여 초기 실험 단계에서 발생하는 cold start 문제를 해결하며, 실험이 진행될수록 관측 데이터를 효과적으로 반영한다. 또한 과학 문헌과 표 형식 데이터 등 다양한 외부 정보원을 도구를 통해 통합함으로써 연구 속도를 높이는 지능형 연구 보조 시스템으로 기능할 수 있다.
다만 몇 가지 한계도 존재한다.
- 일부 세포 유형에서만 상대적으로 높은 성능을 보임
- 성능 향상 효과가 장기 실험보다 초기 실험 단계에서 더 큼
- 비텍스트 데이터 활용을 위한 도구 및 미세조정 기법 개선 필요
그럼에도 불구하고 BioDiscoveryAgent는 데이터가 적은 환경에서 성능 향상과 모델 해석 가능성 개선을 동시에 달성하는 보완적 실험 설계 방법을 제시한다. 특히 능동적 실험 설계에 대한 관심이 증가하는 상황에서, 언어 모델 기반 에이전트가 향후 생물학 실험 설계 시스템의 핵심 구성 요소로 발전할 가능성을 보여준다.