리눅스 시스템 기초 · 입문편 — 본문의 "N편"은 입문 과정 번호다. 번호별 글과 전체 250편 구성은 통합 로드맵에서 확인할 수 있다.
리눅스 시스템 기초 24 / 50 · Part 3. Linux 명령어 활용
실습 환경: 21편 실습용 샘플 로그 (secure,access_log)
이전 글: 23. head와 tail
1. 들어가며
21편부터 IP 집계에 sort | uniq -c | sort -rn을 계속 썼다. 이번 글은 이 패턴을 분해해서 각 단계가 데이터를 어떻게 바꾸는지 정리한다.
이 조합은 관제에서 "무엇이 가장 많은가"를 답하는 기본 도구다.
- 로그인 실패가 가장 많은 출발지 IP
- 가장 많이 시도된 계정명
- 가장 많이 요청된 URL, 가장 많은 응답 코드
- 시간대별 이벤트 분포
이 숫자들은 곧 탐지 규칙의 임계치 를 정하는 근거가 된다. "5분에 10회 이상 실패하면 경보" 같은 규칙은 평소 분포를 알아야 정할 수 있다.
2. 핵심 개념
2-1. sort
| 옵션 | 의미 | 예 |
|---|---|---|
| (없음) | 문자열 사전순 | |
-n | 숫자 크기순 | 9 < 10 |
-r | 역순 | |
-k2,2 | 2번째 필드만 기준 | |
-t: | 구분자를 :로 | /etc/passwd |
-u | 중복 제거 | |
-V | 버전·IP 자연 정렬 | 10.0.0.9 < 10.0.0.10 |
-h | 사람이 읽는 크기 (1K, 2M) | du -h 결과 |
2-2. uniq
| 옵션 | 의미 |
|---|---|
-c | 연속된 같은 줄의 개수를 앞에 붙임 |
-d | 2번 이상 연속된 줄만 |
-u | 한 번만 나온 줄만 |
-i | 대소문자 무시 |
uniq는 바로 이웃한 줄끼리만 비교한다. 파일 전체에서 같은 값을 세려면 먼저 sort로 같은 값을 붙여 놔야 한다.
2-3. 기본 패턴
[값 추출] | sort | uniq -c | sort -rn | head| 단계 | 역할 |
|---|---|
| 값 추출 | grep -o, awk, cut 으로 IP·계정·URL만 남김 |
sort | 같은 값끼리 붙임 |
uniq -c | 값별 개수 |
sort -rn | 개수가 큰 순서 |
head | 상위 N개 |
3. 동작 원리
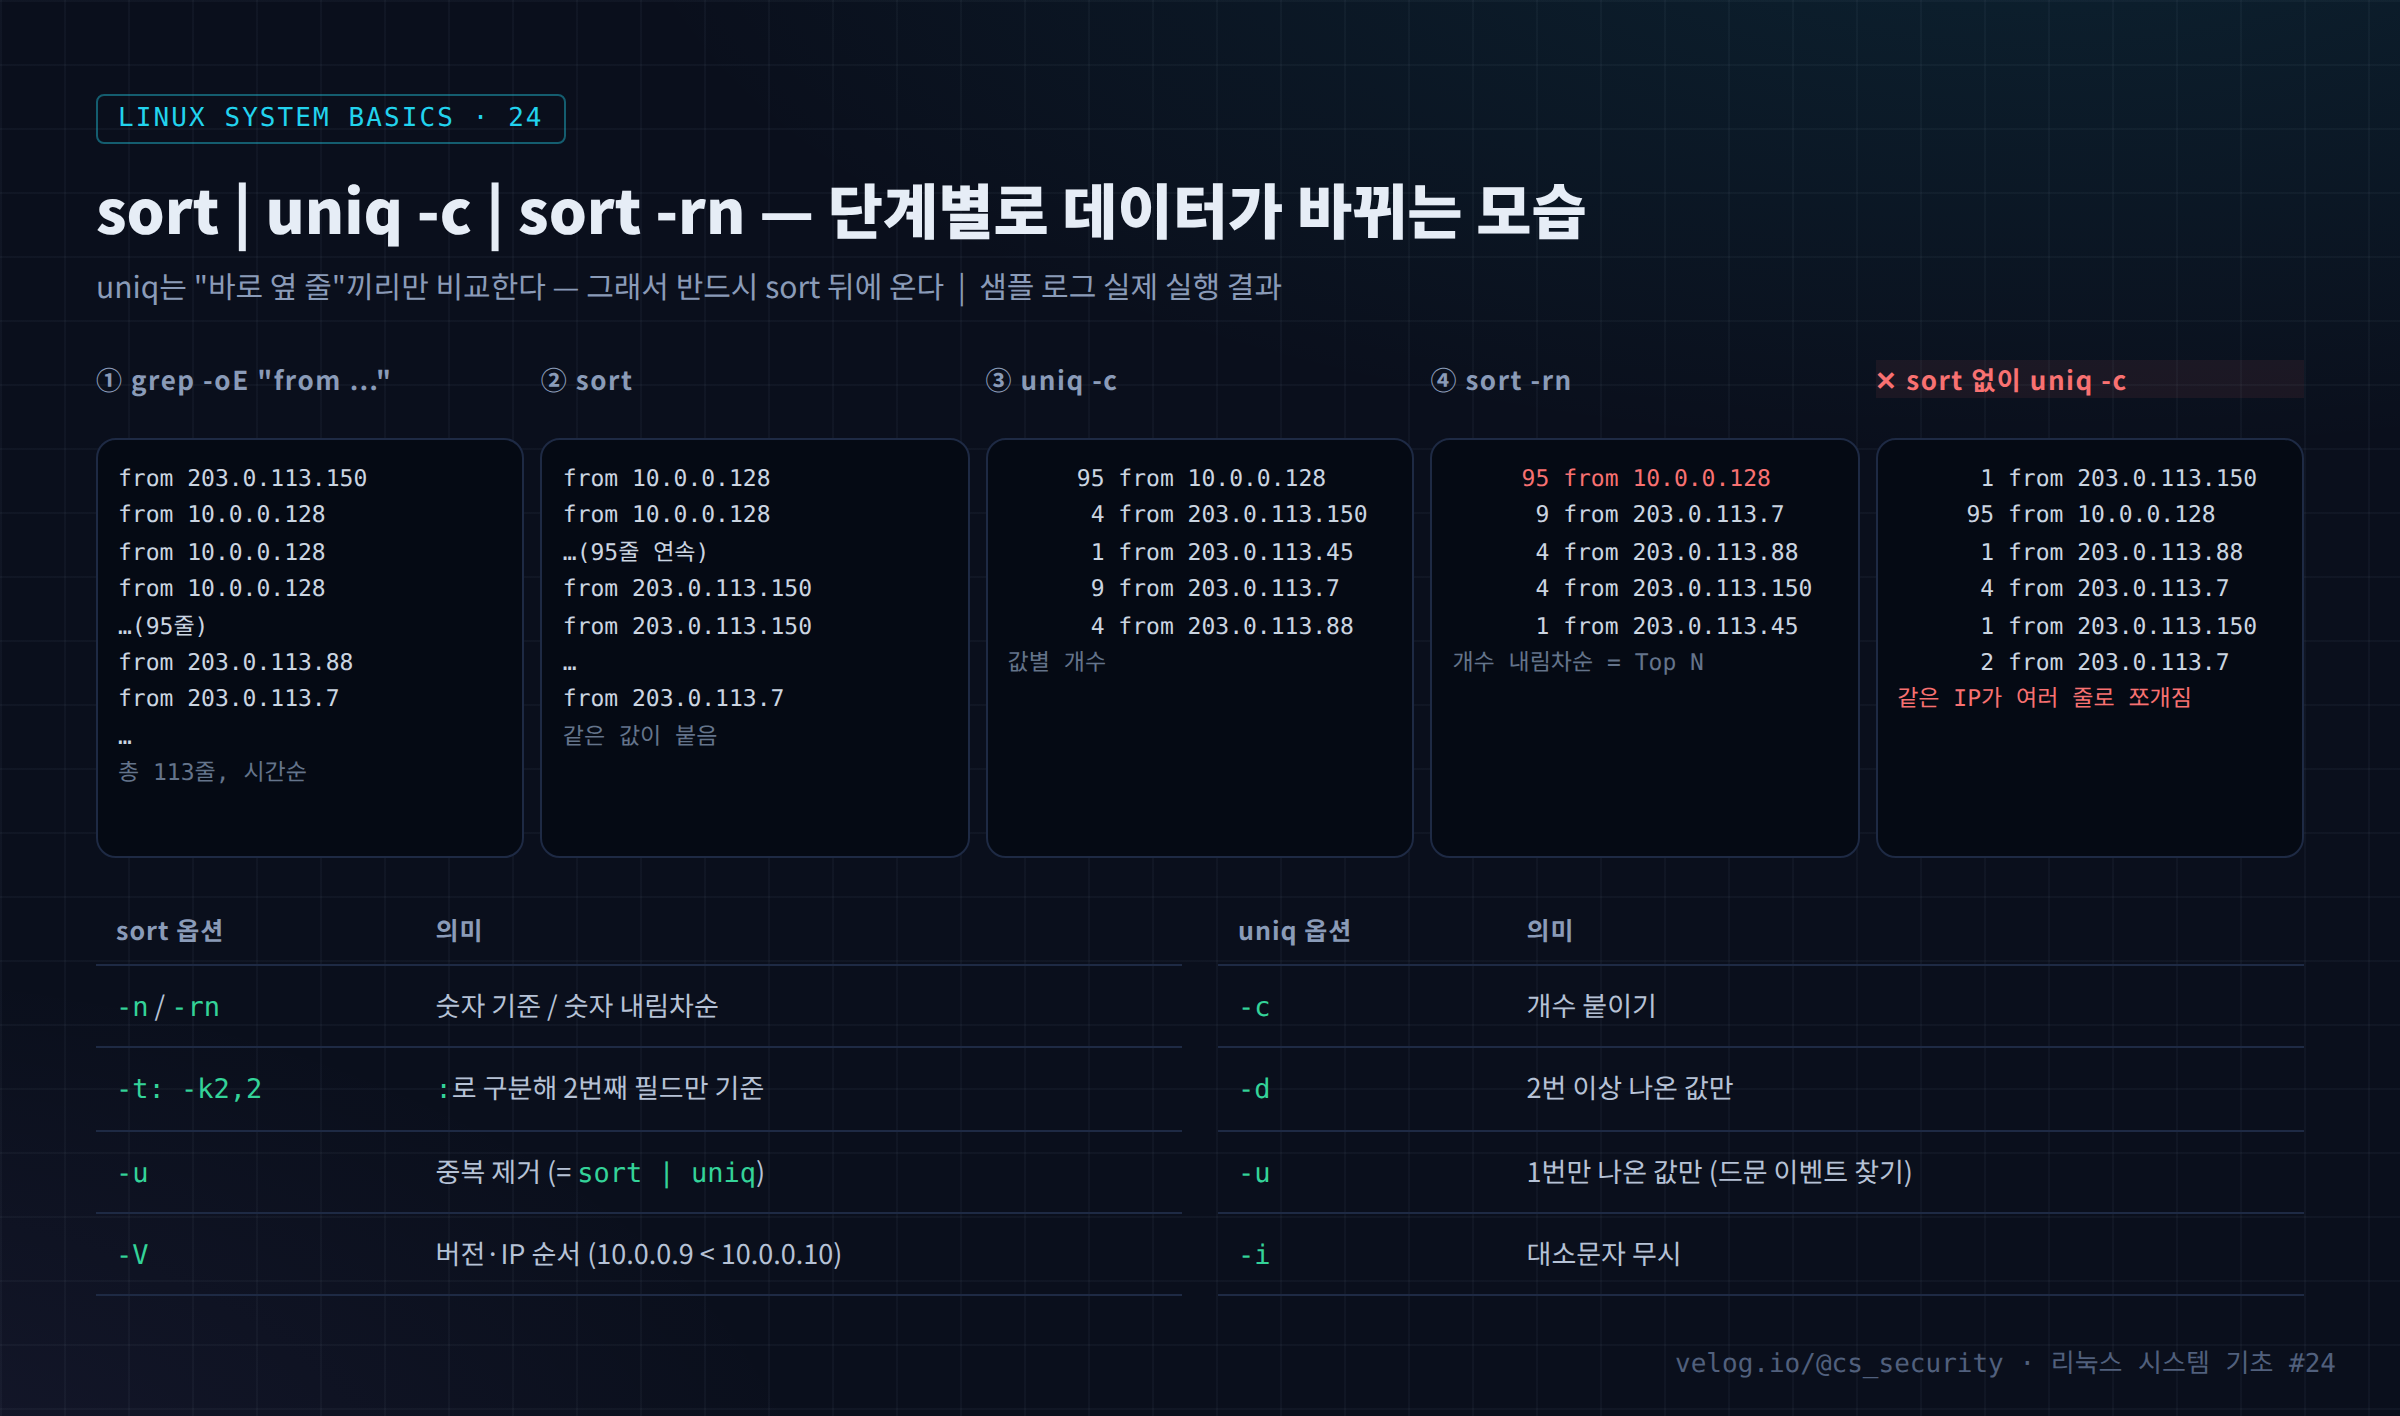
로그는 시간순 으로 쌓인다. 같은 IP의 이벤트가 여러 시간대에 흩어져 있으므로, 정렬 없이 uniq -c를 하면 같은 IP가 여러 조각으로 나뉘어 집계된다. 실제로 샘플 로그에서 정렬 없이 실행하면 다음처럼 203.0.113.150, 203.0.113.7이 여러 줄로 쪼개진다.
$ grep "Failed password" secure | grep -oE "from [0-9.]+" | uniq -c | head -6
      1 from 203.0.113.150
     95 from 10.0.0.128
      1 from 203.0.113.88
      4 from 203.0.113.7
      1 from 203.0.113.150
2 from 203.0.113.710.0.0.128만 한 덩어리로 보이는 이유는 이 IP의 공격이 02:10~02:19에 연속으로 일어났기 때문이다. 이것 자체가 "짧은 시간에 집중된 시도"라는 공격 특성을 보여준다.
4. 실습
cd ~/lab

# 1) 실패 출발지 Top N
grep "Failed password" secure | grep -oE "from [0-9.]+" | sort | uniq -c | sort -rn

# 2) 서로 다른 출발지 수
grep "Failed password" secure | grep -oE "from [0-9.]+" | sort -u | wc -l

# 3) 시간대별 실패 분포 (시각 필드의 '시'만)
grep "Failed password" secure | awk '{print substr($3,1,2)":00"}' | sort | uniq -c

# 4) 존재하지 않는 계정 시도 Top
grep -oE "Invalid user [a-z]+" secure | awk '{print $3}' | sort | uniq -c | sort -rn

# 5) 웹 응답 코드 분포
awk '{print $9}' access_log | sort | uniq -c | sort -rn

# 6) IP × 응답 코드 조합
awk '{print $1, $9}' access_log | sort | uniq -c | sort -k1,1nr | head -8

# 7) /etc/passwd를 UID 숫자 기준 정렬
sort -t: -k3,3n /etc/passwd | cut -d: -f1,3 | tail -5
5. 결과 분석
샘플 로그에 실행한 실제 결과다.
① 실패 출발지 Top N / 서로 다른 출발지 수
     95 from 10.0.0.128
      9 from 203.0.113.7
      4 from 203.0.113.88
      4 from 203.0.113.150
      1 from 203.0.113.45

5
전체 실패 113건 중 84%(95건)가 한 IP 에 집중되어 있다.
② 시간대별 분포
      1 01:00
     95 02:00
      2 03:00
      1 08:00
      1 09:00
      ...
      4 21:00
      1 23:00
평소에는 한 시간에 0~4건 수준(인터넷 스캐너)인데 02시에만 95건 이다. 이 분포가 탐지 임계치의 근거가 된다. 예를 들어 "평소 시간당 최대 4건 → 10분에 20건 이상이면 경보"처럼 정상 수준보다 충분히 높고, 공격은 확실히 잡는 값 을 정할 수 있다.
③ 웹 응답 코드 / IP × 응답 코드
    223 200
     30 404
      2 500

     58 10.0.0.57 200
     45 10.0.0.33 200
     43 10.0.0.34 200
     38 10.0.0.21 200
     36 10.0.0.10 200
     30 10.0.0.128 404
      3 10.0.0.128 200
2 10.0.0.128 500| 관찰 | 해석 |
|---|---|
| 404가 모두 10.0.0.128 | 존재하지 않는 경로를 대량 요청 → 디렉터리 스캔 |
| 500이 모두 10.0.0.128 | 서버 오류를 유발하는 입력 → SQL Injection 시도 가능성 (21편 결과와 일치) |
| 정상 사용자는 200만 | 일반 사용 패턴 |
6. 보안 관점
| 주의점 | 설명 | 방법 |
|---|---|---|
| 정렬 없이 uniq | 같은 값이 쪼개져 집계 왜곡 | 항상 `sort |
| 문자열 정렬로 숫자 비교 | 10이 9보다 앞에 옴 | -n, IP는 -V |
| Top만 보기 | 소수의 드문 이벤트 가 더 중요할 때가 있음 | `sort |
| 한 IP만 보기 | 공격자가 여러 IP로 분산하면 개별 IP는 적어 보임 | 계정별·시간대별로도 집계 |
| 시간 범위 무시 | 하루 합계만 보면 짧은 폭주가 묻힘 | 시간·분 단위 분포 |
특히 "적은 것이 이상한 경우" 를 기억해야 한다. 예를 들어 평소 한 번도 로그인하지 않던 계정의 성공 1건, 한 번만 요청된 수상한 URL 1건은 Top N 목록에는 나오지 않는다.
# 가장 드물게 요청된 URL (적은 순)
awk '{print $7}' access_log | sort | uniq -c | sort -n | head
7. SOC / 보안관제 활용
7-1. 집계 기반 탐지 규칙 설계
| 기준 데이터 | 집계 | 규칙 예 |
|---|---|---|
| 로그인 실패 | IP별·10분 단위 | 같은 IP 10분 20회 이상 |
| 계정 시도 | IP별 서로 다른 계정 수 | 같은 IP가 5개 이상 계정 시도 → 계정 대입(스프레이) |
| 웹 404 | IP별·분 단위 | 같은 IP 1분 30회 이상 404 → 스캔 |
| 웹 500 | URL별 | 특정 URL의 500 급증 → 입력값 공격 |
SIEM의 집계 쿼리(예: Kibana의 Terms 집계, Splunk의 stats count by)도 원리는 sort | uniq -c와 같다.
7-2. 분석 흐름
[Question] 이 서버에 대한 공격은 한 곳에서 왔는가, 여러 곳에서 왔는가?
   ↓
[집계]     출발지별 → 10.0.0.128 이 84%
           시간대별 → 02시 집중
           응답 코드별(웹) → 404·500 모두 같은 IP
   ↓
[판단]     단일 출발지의 SSH 무차별 대입 + 웹 스캔·공격 → 동일 공격자의 다단계 공격
   ↓
[Response] 해당 IP 차단, 임계치 기반 탐지 규칙 추가, 같은 IP의 다른 서버 기록 조회
8. 핵심 정리
- 기본 패턴: 값 추출 →
sort→uniq -c→sort -rn→head. uniq는 이웃한 줄끼리만 비교하므로 반드시sort뒤에 쓴다.- 숫자는
-n, IP는-V, 특정 필드는-t+-k로 정렬한다. - 시간대별 분포는 탐지 임계치의 근거 가 된다.
- Top N뿐 아니라 드문 값(
sort -n | head,uniq -u) 도 확인한다. - 출발지·계정·시간·응답 코드 등 여러 축으로 집계 해야 분산 공격을 놓치지 않는다.
9. 다음 글
다음 글 「25. cut과 awk」 에서는 이번 글에서 값 추출에 쓴 awk '{print $9}'를 제대로 다룬다. 필드 구분, 조건문, 연관 배열을 이용한 집계로 웹 로그의 필드를 해석하고 IP별 요청 수·전송량을 계산 하는 방법을 정리한다.
참고 자료
- sort(1) — https://man7.org/linux/man-pages/man1/sort.1.html
- uniq(1) — https://man7.org/linux/man-pages/man1/uniq.1.html
- GNU Coreutils — sort invocation — https://www.gnu.org/software/coreutils/manual/html_node/sort-invocation.html
