리눅스 시스템 기초 · 입문편 — 본문의 "N편"은 입문 과정 번호다. 번호별 글과 전체 250편 구성은 통합 로드맵에서 확인할 수 있다.
리눅스 시스템 기초 25 / 50 · Part 3. Linux 명령어 활용
실습 환경: 21편 실습용 샘플 로그 (secure,access_log)
이전 글: 24. sort와 uniq
1. 들어가며
24편까지는 grep으로 줄을 고르고, grep -o로 값을 뽑아 sort | uniq -c로 셌다. 그런데 로그의 특정 칸(필드) 을 기준으로 조건을 걸거나, 값을 더하고 평균을 내는 작업은 grep만으로 어렵다. 이때 쓰는 도구가 cut과 awk다.
cut: 구분자가 명확한 파일에서 특정 칸만 잘라내기 (/etc/passwd의 계정명·UID)awk: 필드 단위 조건 검사·계산·집계 가 가능한 작은 프로그래밍 언어
관제 관점에서 awk를 쓰면 다음과 같은 질문에 한 줄로 답할 수 있다.
- 응답 코드가 400 이상인 요청만, IP·URL과 함께 보여줘
- IP별 요청 수와 전송한 바이트 합계는?
- 한 IP가 서로 다른 계정을 몇 개 시도했나? (계정 대입 탐지)
- 02:15~02:25 사이의 로그만 잘라줘
2. 핵심 개념
2-1. cut
| 옵션 | 의미 | 예 |
|---|---|---|
-d | 구분자 (한 글자) | -d: |
-f | 필드 번호 | -f1,3,7, -f2-4 |
-c | 문자 위치 | -c1-15 (syslog 시각 부분) |
cut -d: -f1,3,7 /etc/passwd # 계정명:UID:쉘cut은 구분자가 정확히 한 글자이고 반복되지 않을 때 적합하다. 공백이 여러 개 이어지는 로그에는 맞지 않는다.
2-2. awk 기본 구조
awk [-F 구분자] '조건 { 동작 }' 파일| 요소 | 의미 |
|---|---|
$0 | 줄 전체 |
$1, $2 … | 1번째, 2번째 필드 (기본 구분: 연속 공백) |
$NF | 마지막 필드 |
NR | 현재 줄 번호 |
NF | 현재 줄의 필드 수 |
-F':', -F'"' | 구분자 지정 |
BEGIN { } | 입력을 읽기 전 1회 |
END { } | 입력을 다 읽은 뒤 1회 |
arr[key]++ | 연관 배열 — 키별 개수 세기 |
조건 부분에는 비교($9>=400), 정규식(/Failed/), 조합(&&, ||, !)을 쓸 수 있다.
3. 동작 원리
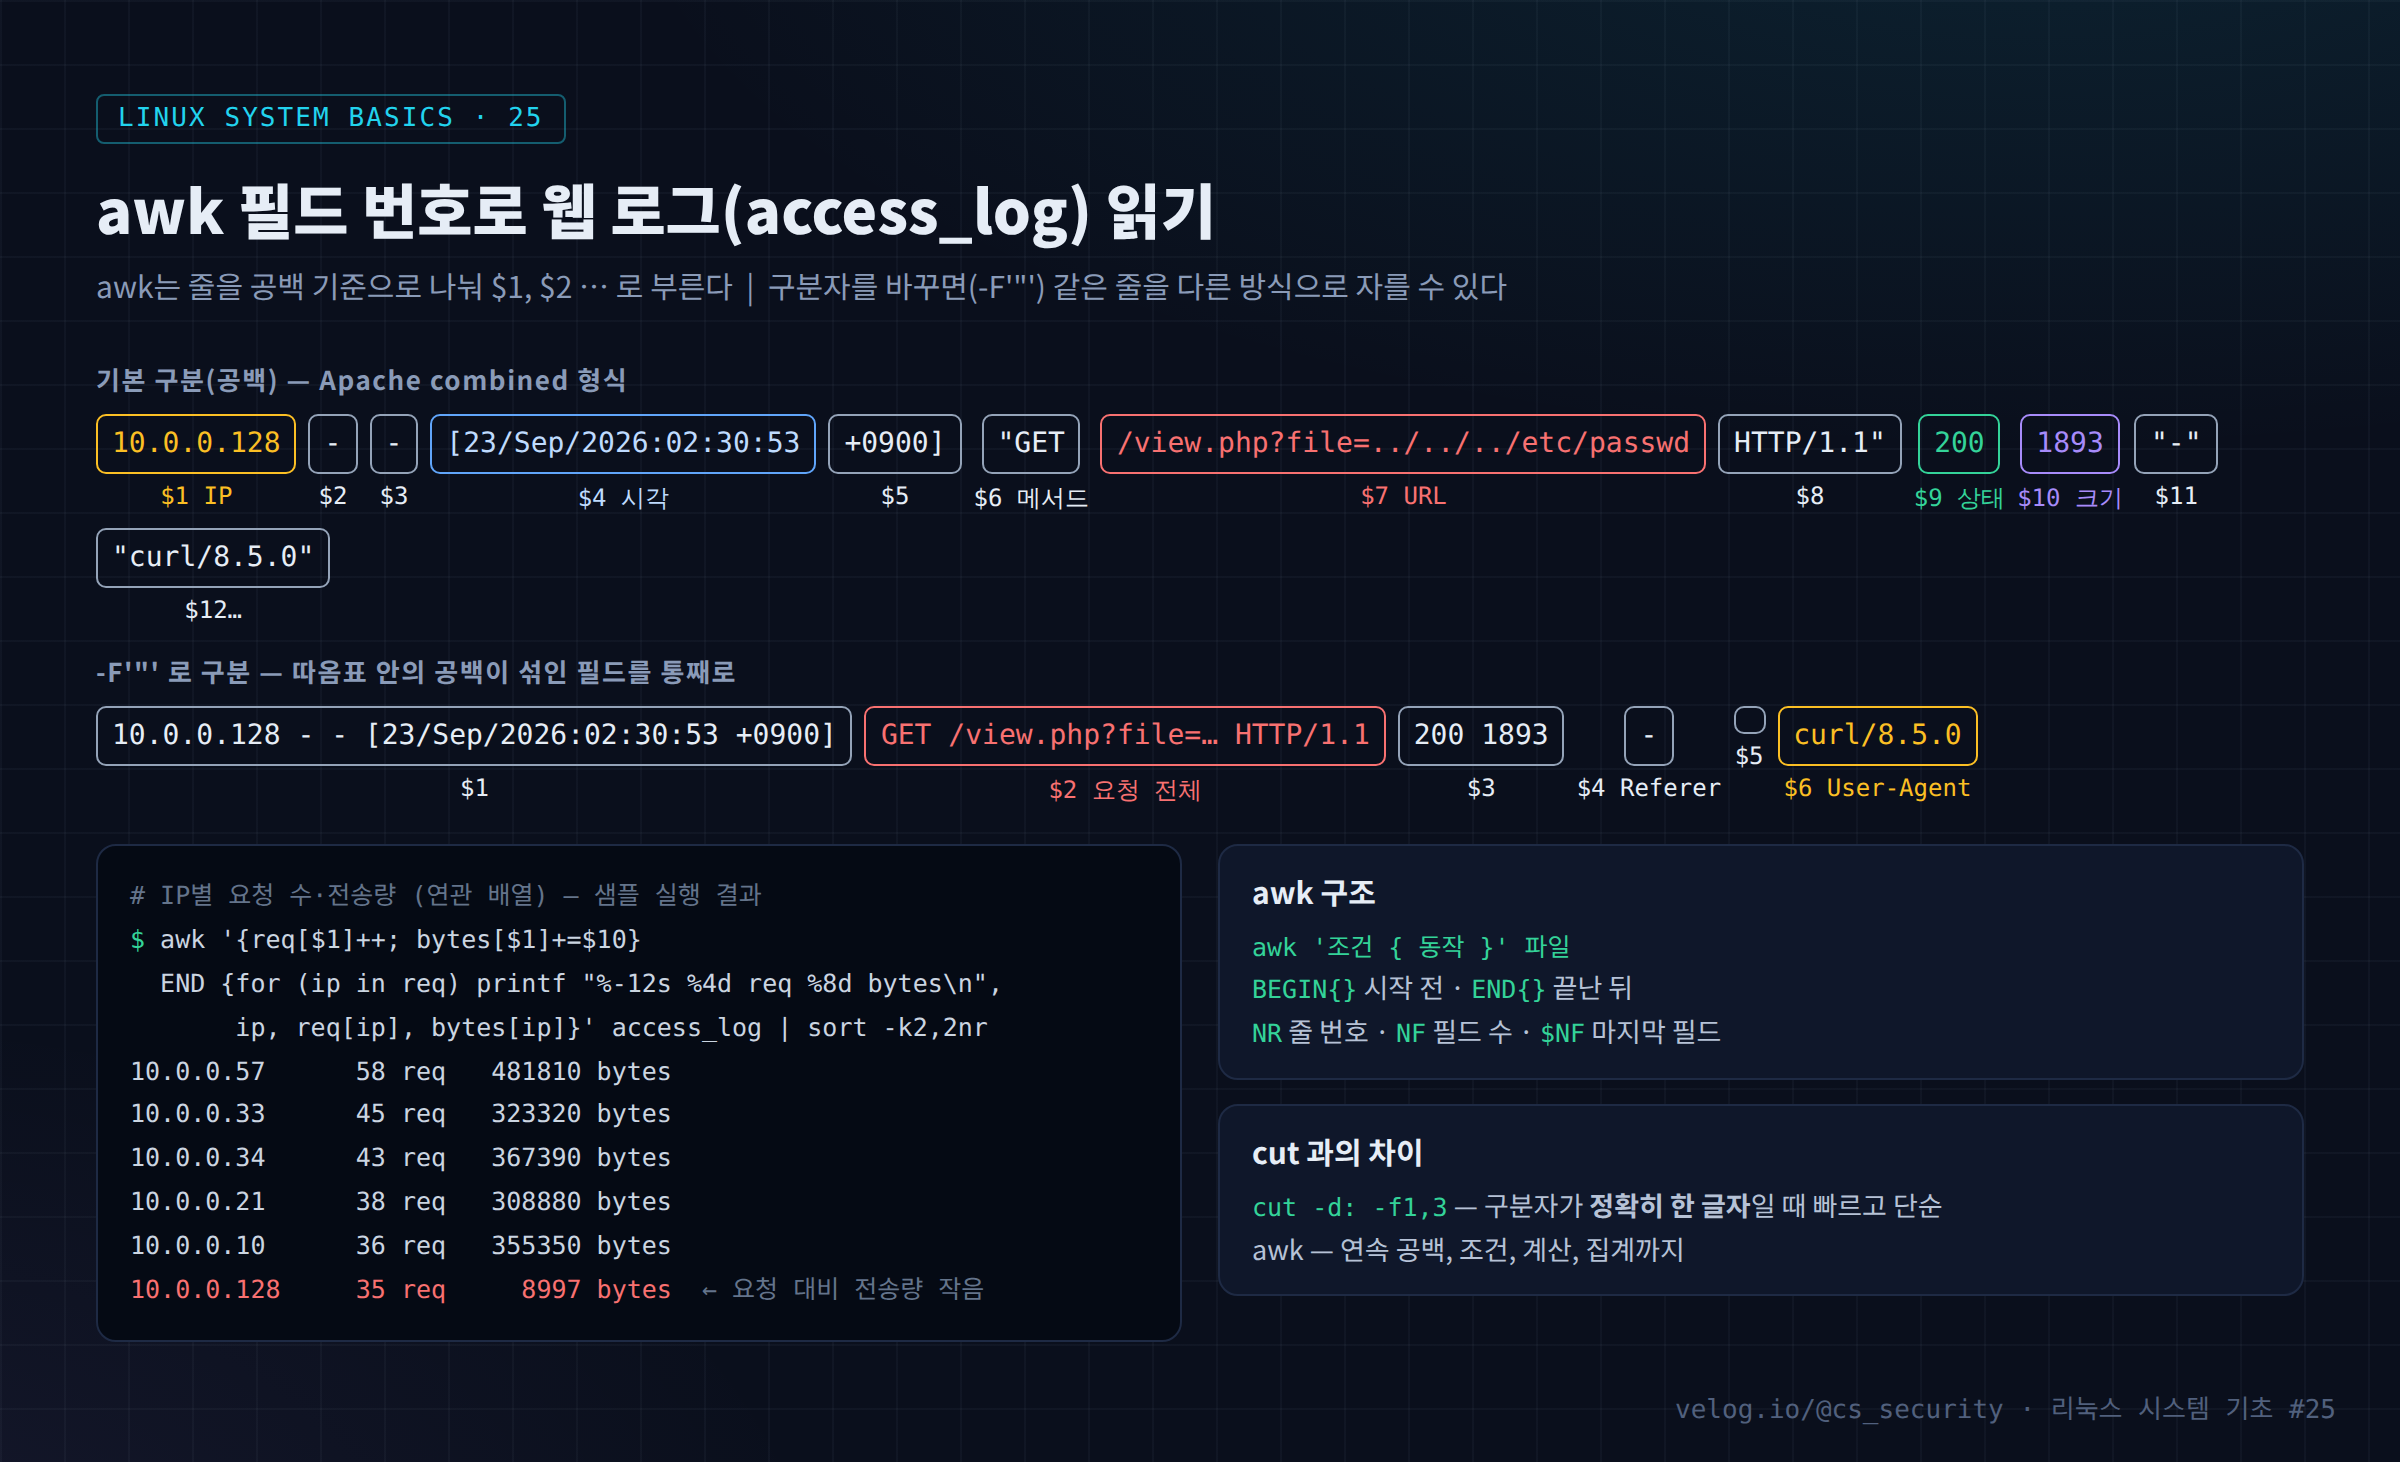
awk는 한 줄을 읽을 때마다 구분자로 잘라 $1 … $NF에 넣고, 조건이 참이면 동작을 실행한다. 모든 줄을 처리한 뒤 END 블록을 실행한다. 그래서 "줄마다 값을 누적하고, 마지막에 결과를 출력하는" 집계가 자연스럽다.
로그 분석에서 가장 먼저 할 일은 필드 번호 지도 를 만드는 것이다. 형식이 같은 로그라면 필드 번호도 같으므로, 한 번 확인해 두면 계속 쓸 수 있다.
head -1 access_log | awk '{for (i=1;i<=NF;i++) print i": "$i}'| 로그 | 자주 쓰는 필드 |
|---|---|
| Apache combined | $1 IP, $4 시각, $7 URL, $9 상태, $10 크기, -F'"'의 $6 User-Agent |
| RHEL secure (sshd) | $3 시각, $5 프로그램[PID], $6부터 메시지. Failed password for root from IP → $9 계정, $11 IP |
secure 로그는
invalid user가 끼면 필드 위치가 두 칸 밀린다. 이런 가변 형식에서는 "from" 다음 필드 처럼 기준 단어로 찾는 것이 안전하다.
4. 실습
cd ~/lab

# 1) 필드 번호 지도
head -1 access_log | awk '{for (i=1;i<=NF;i++) print i": "$i}'

# 2) 오류 응답만 (상태 400 이상)
awk '$9>=400 {print $1, $9, $7}' access_log | sort | uniq -c | sort -rn | head

# 3) IP별 요청 수 · 전송량
awk '{req[$1]++; bytes[$1]+=$10}
     END {for (ip in req) printf "%-12s %4d req %8d bytes\n", ip, req[ip], bytes[ip]}' access_log \
  | sort -k2,2nr

# 4) User-Agent 분포 (따옴표 구분)
awk -F'"' '{print $6}' access_log | sort | uniq -c | sort -rn

# 5) IP별 "서로 다른 계정" 시도 수 — 계정 대입(스프레이) 탐지
awk '/Failed password/ {
       for (i=1;i<=NF;i++) if ($i=="from") ip=$(i+1)
       user = ($9=="invalid") ? $11 : $9
       if (!seen[ip","user]++) n[ip]++
     }
     END {for (ip in n) print n[ip], ip}' secure | sort -rn

# 6) 시간 구간 자르기 (같은 날짜 안에서 시각 문자열 비교)
awk '$3>="02:15:00" && $3<="02:25:00" && !/Failed|Invalid/' secure
5. 결과 분석
샘플 로그에 실행한 실제 결과다.
① 오류 응답 (상위 6줄)
      6 10.0.0.128 404 /wp-login.php
      6 10.0.0.128 404 /phpmyadmin/
      6 10.0.0.128 404 /backup.zip
      6 10.0.0.128 404 /admin/
      6 10.0.0.128 404 /.git/config
      1 10.0.0.128 500 /board.php?id=1%27%20OR%20%271%27=%271
관리 페이지(/admin/, /phpmyadmin/), 설정 노출(/.git/config), 백업 파일(/backup.zip), CMS 로그인(/wp-login.php)을 같은 목록으로 반복 요청했다. 자동화된 취약점 스캐너의 전형적인 형태다.
② IP별 요청 수 · 전송량
10.0.0.57      58 req   481810 bytes
10.0.0.33      45 req   323320 bytes
10.0.0.34      43 req   367390 bytes
10.0.0.21      38 req   308880 bytes
10.0.0.10      36 req   355350 bytes
10.0.0.128     35 req     8997 bytes
정상 사용자는 요청당 수 KB를 받는데, 10.0.0.128은 요청 수에 비해 전송량이 매우 적다. 대부분 404 오류 페이지(196바이트)를 받았기 때문이다. "요청은 많은데 받은 데이터는 적다"는 것 자체가 스캔의 특징이다. 반대로 특정 IP의 전송량이 비정상적으로 크면 데이터 유출 을 의심한다.
③ User-Agent
    220 Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 Chrome/128.0 Safari/537.36
     35 curl/8.5.0
④ 서로 다른 계정 시도 수
8 10.0.0.128
4 203.0.113.7
3 203.0.113.88
3 203.0.113.150
1 203.0.113.45
10.0.0.128은 8개 계정 을 시도했다. 한 계정에 많이 시도하면 "무차별 대입(Brute Force)", 여러 계정에 조금씩 시도하면 "비밀번호 스프레이(Password Spraying)"에 가깝다. 이 IP는 두 방식을 모두 썼다.
⑤ 02:15~02:25 중 실패가 아닌 이벤트
Sep 23 02:19:21 rocky sshd[5224]: Accepted password for devuser from 10.0.0.128 port 51514 ssh2
Sep 23 02:19:21 rocky sshd[5224]: pam_unix(sshd:session): session opened for user devuser(uid=1001) by (uid=0)
Sep 23 02:21:21 rocky sudo[5233]:  devuser : user NOT in sudoers ; TTY=pts/1 ; PWD=/home/devuser ; USER=root ; COMMAND=/bin/bash
Sep 23 02:22:21 rocky su[5270]: pam_unix(su-l:auth): authentication failure; ...
Sep 23 02:22:21 rocky su[5270]: FAILED SU (to root) devuser on pts/1
6. 보안 관점
| 주의점 | 설명 | 방법 |
|---|---|---|
| 가변 필드 | invalid user, IPv6, 로그 형식 변경으로 필드 번호가 밀림 | 기준 단어로 찾기, 형식 확인 |
| 문자열 시각 비교 | $3>="02:15"는 같은 날짜 안에서만 유효 | 날짜가 걸치면 epoch 변환 |
| 로그 형식 커스터마이징 | 서버마다 LogFormat이 다를 수 있음 | httpd.conf의 LogFormat 확인 |
| 프록시 뒤 서버 | $1이 프록시 IP, 실제 IP는 X-Forwarded-For | 로그 형식에 XFF 추가 |
-로 기록된 크기 | 본문 없는 응답은 $10이 - | 합산 시 0으로 처리됨을 인지 |
7. SOC / 보안관제 활용
7-1. 자주 쓰는 awk 원라이너
# 웹: 상태 코드별 개수
awk '{c[$9]++} END {for (s in c) print s, c[s]}' access_log

# 웹: 분 단위 요청 수 (스캔·DoS 급증 확인)
awk '{print substr($4,2,17)}' access_log | sort | uniq -c | sort -rn | head

# 인증: 성공 로그인의 계정·IP·방식
awk '/Accepted/ {print $3, $9, $11, $7}' /var/log/secure

# 계정: UID 1000 이상 로그인 가능 계정
awk -F: '$3>=1000 && $7 !~ /nologin|false/ {print $1, $3, $7}' /etc/passwd
7-2. 분석 흐름
[Question] 10.0.0.128 은 웹에서 무엇을 했는가?
   ↓
[awk]      $9>=400 → 404 30건(관리·설정·백업 경로), 500 2건(SQLi 입력)
           요청 수 대비 전송량 → 스캔 특성
           User-Agent → curl (자동화 도구)
   ↓
[연결]     21·24편 SSH 결과와 합치면: 02:10 SSH 대입 → 02:19 로그인 성공 → 02:30 웹 스캔·공격
   ↓
[Response] IP 차단, 500 을 낸 board.php 입력값 검증, .git·backup 파일 노출 여부 점검
8. 핵심 정리
cut은 한 글자 구분자로 칸을 자를 때,awk는 조건·계산·집계가 필요할 때 쓴다.- awk는 줄을
$1 … $NF로 나누고,조건 { 동작 }을 줄마다 실행한 뒤END를 실행한다. - 분석 전에 필드 번호 지도 를 먼저 만든다 (
for (i=1;i<=NF;i++) print i, $i). - 연관 배열(
arr[key]++,sum[key]+=$n)로 IP별 요청 수·전송량·계정 수를 집계한다. - 가변 필드는 번호 대신 기준 단어(from 다음) 로 찾는다.
- "요청 많고 전송 적음 = 스캔", "여러 계정 소량 시도 = 스프레이" 같은 특성 지표 를 만들 수 있다.
9. 다음 글
다음 글 「26. sed 활용」 에서는 텍스트를 치환·삭제·추출하는 sed를 다룬다. 로그에서 특정 구간을 잘라내고, 보고서에 넣기 전에 비밀번호·개인정보를 마스킹 하는 방법, 그리고 sed -i를 증거 파일에 쓰면 안 되는 이유를 정리한다.
참고 자료
- awk(1p) / GNU Awk User's Guide — https://www.gnu.org/software/gawk/manual/gawk.html
- cut(1) — https://man7.org/linux/man-pages/man1/cut.1.html
- Apache HTTP Server — Log Files (Combined Log Format) — https://httpd.apache.org/docs/2.4/logs.html
