400건의 운영 데이터와 재채점 실험으로 찾은 입력 편향, 그리고 프롬프트 대신 입력을 고친 이야기
매일 아침 제 관심사(LLM, AI 에이전트, AX, 추론 최적화 등)에 맞는 기술 글 10개를 골라 메일로 보내주는 개인용 뉴스레터를 만들고 있습니다. 하루 300건 가까이 모은 글을 임베딩 관련도로 50건까지 줄이고, 이 50건은 LLM이 중요도·새로움·신뢰도를 1~10점으로 채점합니다. 지난 글에서는 이 신호들을 어떻게 합칠지를 다뤘고, 이번에는 한 단계 거슬러 올라가 그 신호가 애초에 어떻게 만들어지는지를 봤습니다.
8월 말부터 걸리는 게 있었습니다. 관심 있게 보던 기업 기술 블로그 글이 관련도는 높은데 LLM 채점에서 중요도와 새로움을 유독 낮게 받아, 정밀분석 후보에서 자꾸 떨어졌습니다. 그때는 후보를 고르는 공식에서 관련도 비중을 키워 턱걸이로 들여보냈습니다. 증상은 줄었지만 원인은 모르는 채였습니다.
8일 치 400건을 뜯어보니 원인은 단순했습니다. 문제의 기업 블로그 글들은 본문 없이 제목만 들어오고 있었습니다. 읽을 게 없으니 모델은 판단할 수 없다는 것을 낮은 점수로 적었습니다. 채점이 들쭉날쭉해서 생긴 일이 아닙니다. 오히려 아주 일관적이었습니다.
배경: LLM은 무엇을 보고 채점하나
하루 ~300건 수집
  → 임베딩 관련도(relevance) 상위 50건
  → LLM 1차 채점: 중요도·새로움·신뢰도 (저비용 모델, 50건 전부)
  → RRF(관련도×3 + LLM 점수 셋×1)로 상위 20건 → 플래그십 모델 정밀분석
  → 최종 10건(MUST READ) 메일 발송
1차 채점 프롬프트는 이게 전부입니다.
[system] 너는 AI/개발 기술 뉴스를 평가하는 애널리스트다. 주어진 글 하나를 읽고
         Importance(중요도), Novelty(새로움), Credibility(신뢰도)를 각각 1~10점으로
         채점하고 한 줄 평가 이유를 한국어로 작성해라.
[user]   제목: {title}
         출처: {source}
         본문 발췌: {본문 앞 1,500자}
몇 점이면 어떤 글인지 정한 채점 기준(루브릭)은 없습니다. 그리고 본문 발췌에는 수집기가 가져온 텍스트가 그대로 들어갑니다. 이 텍스트의 양이 출처마다 크게 다르다는 게 문제가 됐습니다.
발견 1: 세 점수는 거의 같이 움직인다
8일 치 400건에서 네 신호 사이의 순위 상관(Spearman)을 봤습니다. 관련도와 LLM 점수는 +0.16~+0.33으로 약하게만 엮이는데, 관심사에 맞는 글인지와 중요한 글인지는 원래 다른 질문이니 이건 괜찮습니다.
걸리는 건 LLM 점수 셋끼리입니다. 중요도~새로움 +0.83, 중요도~신뢰도 +0.69, 새로움~신뢰도 +0.61. 세 점수의 순위로 주성분을 뽑으면 첫 번째 성분 하나가 분산의 81%를 설명합니다. 서로 다른 세 관점에 가중치를 1씩 준다고 생각했지만, 세 점수는 생각보다 많은 정보를 중복해서 담고 있었습니다.
(점수가 몇 개 값에 몰려 있어 동점 처리가 순위를 흔드는 것 아닐까도 의심했지만, 주된 원인은 아니었습니다 — 부록.)
발견 2: 끌고 가는 건 출처가 아니라 본문이다
출처별로 나눠 보면 차이가 큽니다. arXiv는 초록이 중앙값 1,449자 들어오고 평균 중요도가 7.44입니다. Hacker News는 90%가 본문 없이 들어와 3.48, 기업 기술 블로그 모음은 100%가 본문 없이 들어와 3.43입니다. 출처라는 변수 하나가 중요도 점수 분산의 54%를 설명합니다(η²). 관련도로 같은 값을 재면 0.23입니다.
그렇다면 arXiv 논문이 Hacker News 글보다 평균 두 배 넘게 중요한 걸까요? 아니면 arXiv는 초록 1,400자가 들어오고 Hacker News는 제목만 들어오기 때문일까요? 본문 길이 구간으로 나누면 두 번째 설명 쪽이 유력해 보입니다.
| 본문 길이 | 건수 | 중요도 | 새로움 | 신뢰도 |
|---|---|---|---|---|
| 0자 | 118 | 3.25 | 4.16 | 2.65 |
| 1~199자 | 103 | 4.92 | 5.15 | 4.63 |
| 200~999자 | 86 | 5.93 | 6.38 | 5.58 |
| 1,000자 이상 | 93 | 7.38 | 7.87 | 6.14 |
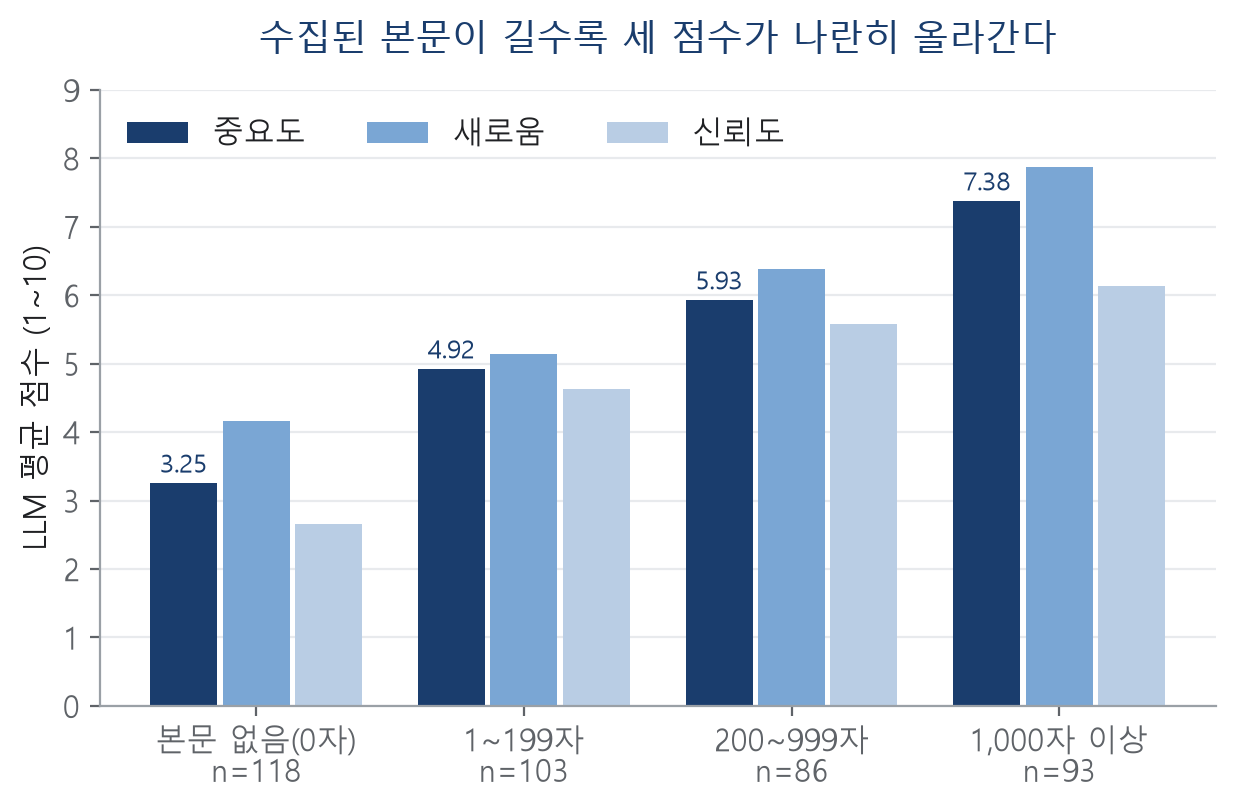
그림1. 본문 길이 구간별 평균 점수
세 점수가 한 방향으로 계단처럼 올라갑니다. 하루 50건 안에서 본문 길이와 점수의 순위 상관은 중요도 +0.64, 새로움 +0.65, 신뢰도 +0.70입니다. 같은 50건에서 본문 길이와 임베딩 관련도의 상관은 +0.04입니다. 이런 경향은 임베딩 관련도에서는 거의 관찰되지 않았고, LLM 채점에서 뚜렷하게 나타났습니다. 채점 이유에도 흔적이 남아 있습니다. 400건 중 58%가 본문·발췌·근거가 부족하다고 적었고, Hacker News는 92%, 기업 블로그 모음은 100%였습니다. 모델도 판단할 재료가 없다는 걸 알고 있었습니다.
다만 여기까지는 관찰입니다. arXiv 논문이 원래 알찬 글이라 초록도 길고 점수도 높은 것일 수 있습니다. 본문이 점수를 움직인다고 말하려면 같은 글에서 본문만 빼봐야 합니다.
실험: 같은 글에서 본문만 빼보기
LLM 점수를 믿을 수 있냐는 질문은 둘로 나뉩니다. 같은 글을 다시 채점하면 같은 점수가 나오는가(일관성), 그리고 그 점수가 재려던 것을 재고 있는가(타당성). 이번에 문제가 된 건 타당성의 문제였습니다.
본문이 200자 이상인 글 40건(arXiv 25건, GeekNews 15건)을 네 가지 조건으로 다시 채점했습니다. 운영과 똑같은 입력으로 두 번(A1·A2), 본문을 뺀 입력(B), 출처 줄을 뺀 입력(C). 운영과 같은 모델, 같은 프롬프트로 160번 호출했습니다.
| 중요도 | 새로움 | 신뢰도 | |
|---|---|---|---|
| 같은 입력 두 번: 점수 완전히 같음 | 70% | 75% | 72% |
| 같은 입력 두 번: ±1 이내 | 100% | 100% | 100% |
| 본문 제거 (B − A) | −1.75 (−2.17 ~ −1.35) | −1.52 (−1.95 ~ −1.12) | −2.01 (−2.50 ~ −1.54) |
| 출처 제거 (C − A) | +0.15 (+0.05 ~ +0.25) | −0.07 (−0.26 ~ +0.09) | +0.04 (−0.17 ~ +0.26) |
괄호 안은 부트스트랩 95% 신뢰구간입니다.
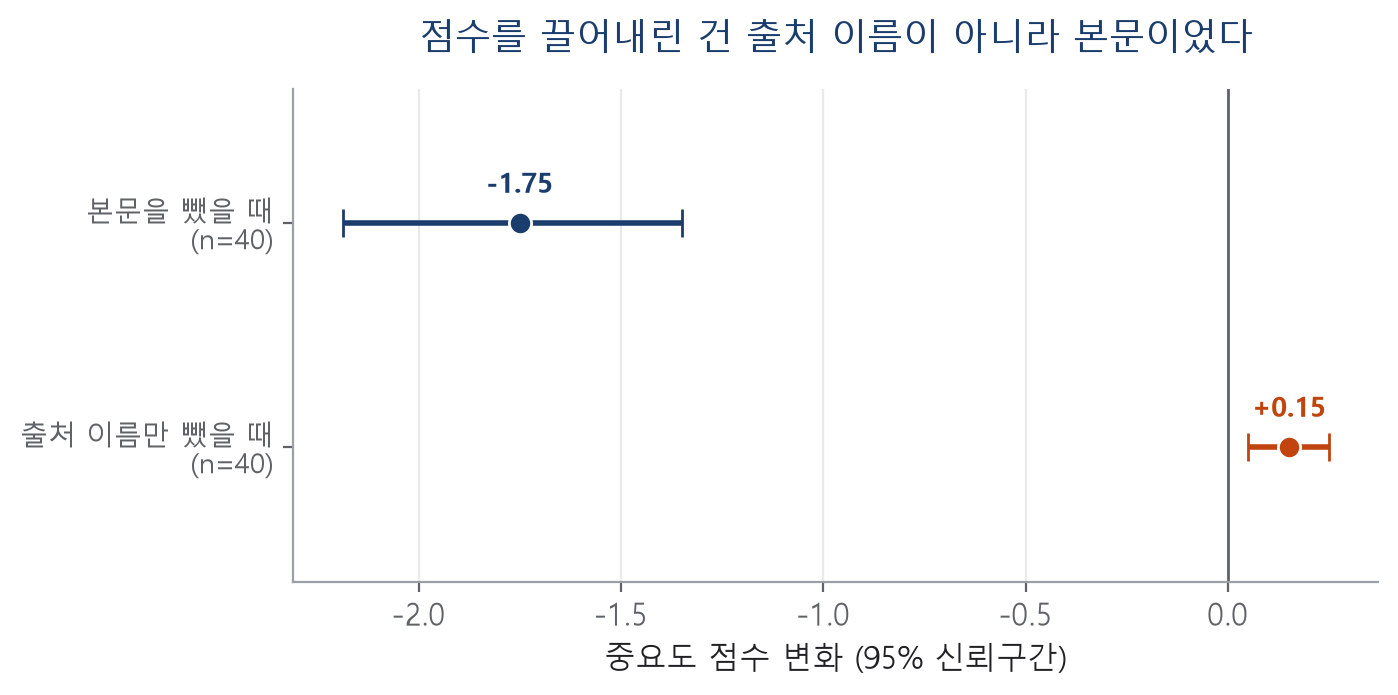
그림2. 본문 제거와 출처 제거 효과
재호출에 따른 변동은 작았습니다. 같은 입력을 두 번 넣으면 70~75%는 점수가 똑같았고 나머지도 전부 1점 차이 안이었습니다. 본문을 빼면 중요도가 평균 1.75점 떨어졌습니다. 재호출 변동(평균 0.30점)의 약 6배이고, 40건 중 절반은 2점 이상 떨어졌습니다. 출처 이름의 직접 효과는 그에 비해 아주 작았습니다. 출처 줄을 지워도 0.15점 움직였을 뿐입니다. 이 표본이 arXiv와 GeekNews뿐이라 모든 출처의 이름 효과를 부정할 수는 없지만, 관찰된 출처별 격차의 주된 원인으로는 출처 이름보다 들어오는 본문 정보의 차이가 유력해 보입니다.
본문을 뺐을 때 모델이 쓴 이유를 보면 무슨 일이 일어나는지 보입니다.
Anubis에 WebAssembly를 탑재하기까지 1년이 걸렸다 (GeekNews) — 중요도 6 → 2
"본문 내용과 근거가 제공되지 않아 기술적 중요성·새로움을 판단하기 어렵고, 출처만으로는 주장과 1년의 개발 과정에 대한 신뢰도를 검증할 수 없다."
모델은 "판단하기 어렵다"고 말합니다. 그런데 점수 칸에는 '모름'이 없으니, 판단하기 어렵다는 걸 낮은 점수로 적습니다. 발견 1에서 세 점수가 같이 움직였던 것도 여기서 상당 부분 설명됩니다. 본문이 없으면 세 점수가 한꺼번에 내려가니까요. 실제로 본문이 온전한 이 40건만 놓고 보면 첫 번째 주성분의 설명력은 81%가 아니라 52%였습니다.
짚어둘 것은, 이 실험이 바꾼 게 글자 수가 아니라 본문 정보의 유무라는 점입니다.
그 모델만 그런 것 아닐까요? 당연히 나올 질문이라, 같은 표본을 같은 프롬프트로 회사 두 곳의 저가·플래그십 모델에 각각 돌려봤습니다. 네 모델 모두 본문을 빼면 중요도가 내려갔고, 신뢰구간은 어느 것도 0을 넘지 않았습니다(−0.72에서 −1.75까지). 다만 크기는 모델마다 두 배 넘게 달랐고, 어떤 모델은 이 프롬프트로 중요도를 아예 구분하지 못했습니다. 이 비교는 다음 글에서 따로 다뤄보겠습니다.
적어도 모델 성능 등급만의 문제는 아니었습니다.다만 효과의 크기는 모델마다 달랐고, 어떤 모델은 거의 같은 점수만 반복했습니다. 따라서 이 현상은 불완전한 입력을 1~10점으로 강제 변환하는 방식과 모델별 점수 사용 특성이 함께 작용한 결과로 보는 편이 맞아 보입니다. '모름'을 선택할 수 없다고 해서 반드시 낮은 점수로 가는 것은 아니었습니다.
그래서 실제로 무엇을 놓쳤나
관련도가 비슷한 글끼리 비교했습니다. 날마다 관련도 상위 25%, 그러니까 제 관심사에 가장 가까운 글만 모았습니다. 본문이 있던 73건은 정밀분석에 96%, MUST READ에 74% 들어갔습니다. 본문이 없던(50자 미만) 31건은 77%와 52%였습니다. 관심사에 똑같이 가까워도 본문이 없으면 MUST READ에 들 확률이 74%에서 52%로 떨어진 겁니다. 8월에 기업 블로그 글이 자꾸 떨어지던 것도 이것이었습니다. 그 글들은 국내 기업 기술 블로그를 모아주는 피드로 들어오는데, 이 피드는 매번 본문 없이 제목과 링크만 보내줍니다.
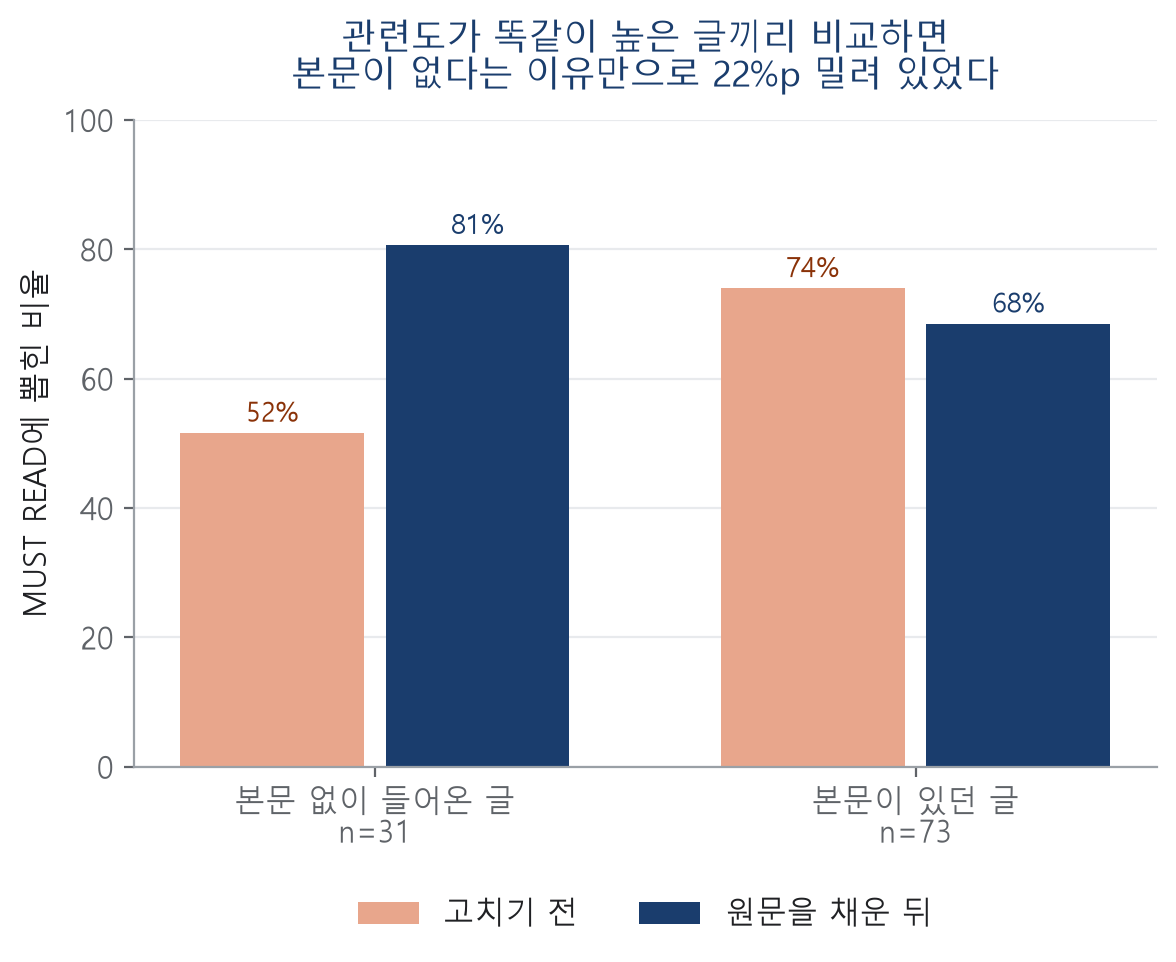
그림3. 본문 유무별 MUST READ 진입률
들어간 글에도 문제가 있었습니다. 8일 동안 MUST READ 80건 중 17건(21%)이 본문이 빈 채로 정밀분석에 들어갔습니다. 메일에 실린 요약이 사실은 제목만 보고 쓴 글이었던 셈입니다.
프롬프트로 고쳐보려다 실패한 이야기
가장 먼저 떠오른 해결책은 프롬프트였습니다. 점수대별 채점 기준을 넣고, 마지막에 이렇게 못 박았습니다.
발췌가 짧거나 일부만 주어졌다는 이유로 Importance와 Novelty를 낮추지 마라 —
두 점수는 글이 다루는 내용 자체로 판단하고, 근거가 부족하다는 판단은
Credibility에만 반영해라.
운영에 넣기 전에 검증했습니다. arXiv 25건의 초록을 약 1,400자에서 200자로 잘라, 기존 프롬프트와 새 프롬프트가 각각 얼마나 흔들리는지 봤습니다(130회 호출).
| 초록을 200자로 잘랐을 때 | 중요도 | 새로움 | 신뢰도 |
|---|---|---|---|
| 기존 프롬프트 | −0.50 | −0.56 | 0.00 |
| 새 프롬프트 | −0.52 | −0.50 | −2.36 |
지시는 전혀 먹히지 않았습니다(−0.50 → −0.52). 대신 전에는 초록을 잘라도 꿈쩍 않던 신뢰도가 2.36점이나 떨어지게 됐습니다. 편향이 사라진 게 아니라 신뢰도로 옮겨 붙은 겁니다. 세 점수도 오히려 더 뭉쳤습니다(첫 번째 주성분 52% → 71%). 이 프롬프트는 버렸습니다.
대신 여기서 중요한 걸 하나 알게 됐습니다. 같은 25건에서 초록을 200자로 줄였을 때는 중요도가 0.50점 떨어졌지만, 본문을 통째로 뺐을 때는 1.74점 떨어졌습니다. 손해의 대부분은 본문이 '짧아서'가 아니라 '없어서' 생깁니다. 그렇다면 없는 정보를 없는 대로 판단해 달라고 모델에게 부탁할 게 아니라, 정보를 채워주면 됩니다. 채울 수 없으면 판단을 시키지 않으면 되고요.
입력을 고치다: 본문을 가져오고, 못 가져오면 '모름'
1. 원문 링크에서 본문을 가져온다. 관련도 필터를 통과한 50건 중 본문이 1,000자 미만인 글은 링크를 따라가 페이지를 받아옵니다. 논문 페이지의 citation_abstract 메타 태그, <article>·<main> 안의 문단과 목록, 페이지 전체의 <p> 순서로 찾습니다. 표준 라이브러리 HTMLParser만 쓰고, 타임아웃과 응답 크기 상한을 둬서 느린 페이지 하나가 파이프라인을 붙잡지 못하게 했습니다.
기준을 200자가 아니라 1,000자로 잡은 이유도 있습니다. 200자 미만만 가져오면 본문이 없던 글은 원문 수천 자를 새로 얻고 200자 남짓한 요약만 있던 GeekNews 글은 그대로 남아, 불균형이 방향만 바꿔 다시 생깁니다.
2. 그래도 본문이 200자 미만이면 채점하지 않는다. LLM에 보내지 않고, 원문을 가져오지 못해 채점하지 않았다고만 남깁니다. 정밀분석도 건너뛰고 메일에는 링크에서 직접 확인해 달라고 적습니다. 제목만 보고 쓴 요약보다 "요약하지 않았다"가 정직합니다.
3. 없는 점수는 꼴찌가 아니라 가운데 순위로 친다. RRF는 순위를 쓰기 때문에 점수가 없는 글을 몇 위로 칠지 정해야 합니다.
def _rank_within(rows, key):
    scored = [r for r in rows if key in (r.scores or {})]
    ordered = sorted(scored, key=lambda r: r.scores[key], reverse=True)
    ranks = _ranks_with_ties_shared(ordered, key)   # 동점은 평균 순위를 나눠 갖는다
    middle = (len(ordered) + 1) / 2
    for row in rows:
        ranks.setdefault(row.id, middle)  # 채점 안 된 글 = 채점된 글들의 가운데 순위
    return ranks
꼴찌로 치면 '모름'을 '나쁨'으로 취급하게 됩니다. LLM이 하던 실수를 코드에서 반복하는 셈입니다. 1위로 치면 반대로 부풀립니다. 가운데 순위는 결측을 극단적으로 벌주지도 보상하지도 않으려고 고른 값입니다. 완전한 중립은 아니어서, 이 선택이 맞는지는 따로 확인할 대상으로 남겨뒀습니다(부록).
고친 뒤: 같은 400건을 다시 돌리고, 9일을 더 돌려봤습니다
먼저 날짜를 고정했습니다. 날짜별로 전후 평균만 비교하면 그사이 뉴스 구성이 바뀐 효과가 섞이니까요. 9/3~9/11의 400건을 그대로 두고 입력만 바꿔 다시 돌렸습니다(243회 호출). 기존 점수를 넣고 랭킹 코드를 돌리면 8일 치 Top 20과 MUST READ가 운영 결과와 한 건도 다르지 않았고, 며칠 사이 모델이 달라진 효과도 평균 −0.03점으로 작았습니다. 그러니 아래 차이는 입력을 바꾼 효과로 봐도 됩니다.
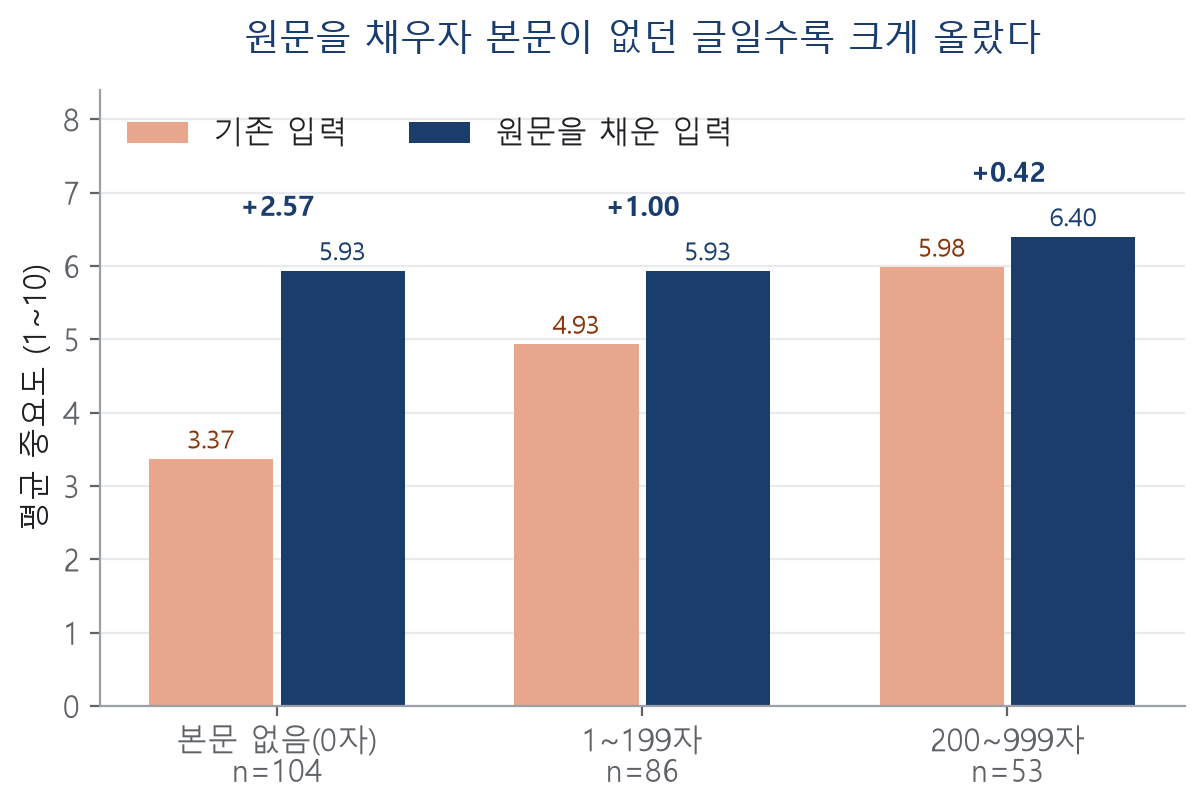
원문은 307건 중 243건에서 받아왔고, 끝내 200자를 못 넘긴 31건은 채점하지 않았습니다. 원래 본문이 없던 글일수록 많이 올랐습니다.
| 원래 본문 | 건수 | 중요도 | 새로움 | 신뢰도 |
|---|---|---|---|---|
| 0자 | 104 | 3.37 → 5.93 (+2.57) | 4.30 → 6.38 (+2.09) | 2.73 → 5.97 (+3.24) |
| 1~199자 | 86 | 4.93 → 5.93 (+1.00) | 5.20 → 6.05 (+0.85) | 4.43 → 4.81 (+0.38) |
| 200~999자 | 53 | 5.98 → 6.40 (+0.42) | 6.49 → 6.66 (+0.17) | 5.45 → 5.42 (−0.04) |
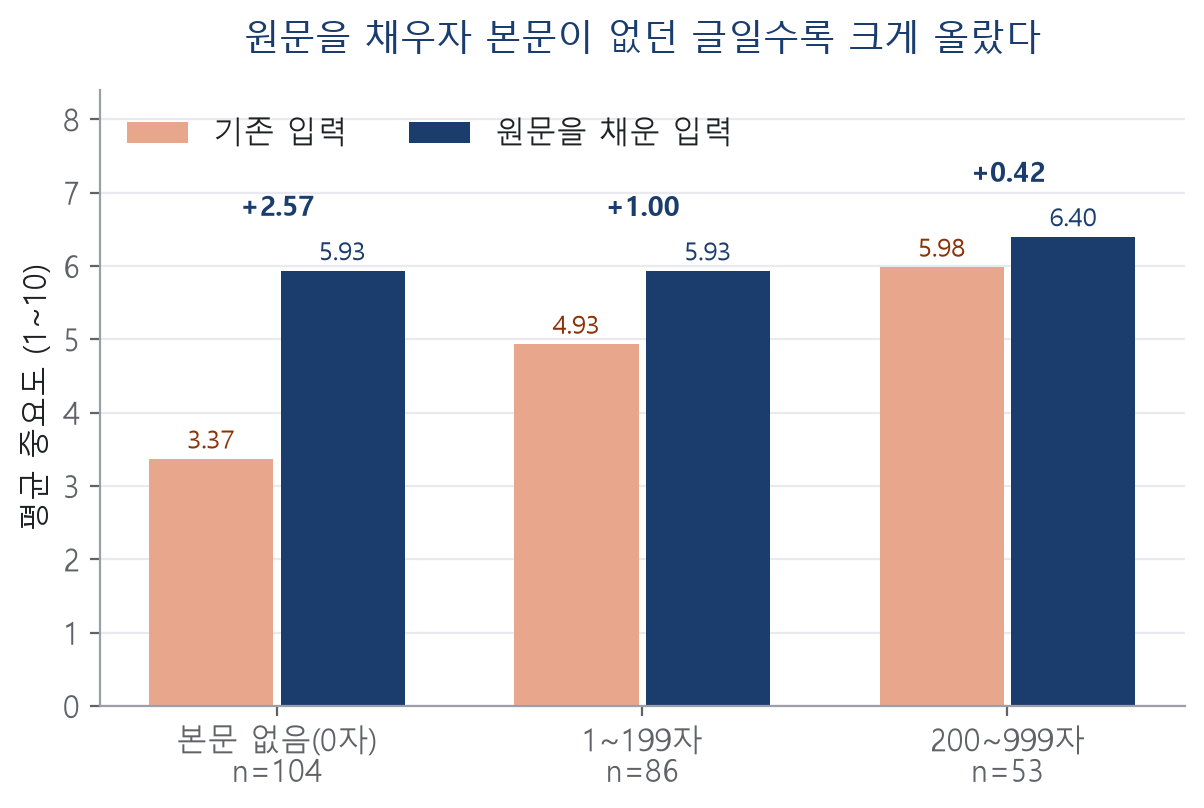
그림4. 원래 본문 길이별 중요도 변화
두 실험에서 본 것과 같은 모양입니다. 없던 본문이 생기는 효과는 크고, 짧던 본문이 길어지는 효과는 작습니다.
그다음은 실제 운영입니다. replay는 같은 글을 다시 돌린 것이고, 운영은 매일 새 글로 도는 것입니다. 고친 코드로 9일(2026-09-14~09-22), 450건이 지나갔습니다.
| 지표 | 고치기 전 | replay가 예측한 값 | 실제 운영 9일 |
|---|---|---|---|
| 기업 블로그 모음 평균 중요도 | 3.43 | 6.35 | 7.00 |
| Hacker News 평균 중요도 | 3.48 | 5.84 | 6.18 |
| (비교) arXiv 평균 중요도 | 7.44 | 7.46 | 7.28 |
| 원래 본문 길이 ~ 중요도 상관 | +0.64 | +0.19 | +0.23 |
| 원래 본문 길이 ~ 신뢰도 상관 | +0.70 | +0.02 | +0.17 |
| 세 점수 첫 번째 주성분 | 81% | 60% | 56% |
| 출처가 설명하는 중요도 분산 (η²) | 0.54 | 0.24 | 0.18 |
| MUST READ 중 제목만 보고 쓴 요약 | 21% | 0% (설계상) | 0% |
모든 점수를 일괄적으로 올린 것은 아닙니다. 원래 초록이 충분했던 arXiv의 중요도는 7.44에서 7.28로 거의 그대로였고, 본문이 비어 있던 소스에서만 큰 변화가 났습니다. 기업 블로그 모음은 3.43에서 7.00으로, Hacker News는 3.48에서 6.18로 올랐습니다. 출처가 점수를 설명하는 정도는 0.54에서 0.18로 내려와, 임베딩 관련도(0.23)보다도 낮아졌습니다. 세 점수도 덜 뭉쳤습니다. 풀의 평균 본문 길이는 604자에서 2,610자가 됐고, 하루 평균 33건의 원문을 새로 가져옵니다. 끝내 본문을 못 구해 채점하지 않는 글은 하루 2~3건(5%)입니다. 즉 수정 효과는 전체 점수의 일괄 상승이라기보다, 입력 정보가 부족했던 소스에 집중됐습니다.
관련도가 비슷한 글끼리 보면 격차가 크게 줄었습니다. replay 기준으로 관련도 상위 25%에서 본문 없던 글의 MUST READ 진입률이 52%에서 81%가 됐습니다. 본문이 있던 글은 74%에서 68%가 됐으니 수치로는 순서가 뒤집혔지만, 31건 대 73건이라 의미 있는 차이로 보기는 어렵습니다(순열 검정 p=0.24). 고치기 전의 22%p 차이는 우연으로 보기 어려운 수준이었습니다(p=0.04). 하루 평균 3.6자리가 바뀌었고, 관련도 하위 절반에서 MUST READ에 들던 글은 3건에서 0건이 됐습니다.
한 가지는 예측과 달랐습니다. 새로움과 본문 길이의 상관은 replay의 +0.32에서 실제 운영에서는 +0.53으로 높아졌습니다. 이 값이 남은 입력 편향 때문인지, arXiv처럼 긴 초록을 가진 글이 실제로 더 새로운 경향 때문인지는 현재 데이터만으로 구분할 수 없습니다.
아직 남은 것
- 편향이 다 사라지진 않았습니다. 운영 9일 기준으로 원래 본문 길이와의 상관이 중요도에 +0.23, 새로움에 +0.53 남아 있습니다.
- 점수 편향이 줄었다고 추천이 좋아졌다는 뜻은 아닙니다. 이번 비교가 보여주는 건 점수가 본문 유무에 덜 끌려가게 됐다는 것까지입니다. 바뀐 자리가 실제로 더 읽을 만한 글인지는 제가 직접 라벨을 붙인 평가셋으로 Precision@10·nDCG@10을 재봐야 알 수 있습니다.
- 표본과 방법이 제한적입니다. 통제 실험은 40건, arXiv와 GeekNews만 썼습니다. Hacker News처럼 원래 본문이 없던 출처는 뺄 본문이 없어 실험에 넣지 못했고, 글자 수 자체의 효과도 가르지 못했습니다.
- 방향은 네 모델에서 같았지만 크기는 제 모델의 것입니다. 이 글의 −1.75 같은 숫자는 제 시스템이 쓰는 모델의 숫자입니다(모델별 비교는 다음 글에서). 프롬프트도 한국어 하나뿐이고, 모델은 이름이 같아도 언제든 바뀝니다. 며칠 사이의 변화는 −0.03점으로 작았지만 몇 달 뒤를 보장하지는 않습니다.
- 본문 가져오기는 휴리스틱입니다. 자바스크립트 렌더링, 페이월, 봇 차단은 넘지 못하고, 소스 하나가 막히면 그 소스만 짧은 본문으로 채점되는 불균형이 방향만 바꿔 생깁니다. 기존 요약에 원문을 이어 붙이는 방식이라 같은 내용이 두 번 들어갈 수도 있습니다.
배운 것
일관적이라고 해서 맞는 것은 아니다. 같은 입력에는 늘 1점 차이 안의 점수를 줬지만, 그 점수는 글의 중요도만큼이나 주어진 정보의 양을 반영하고 있었다.
LLM은 '모르겠다'를 '낮다'로 적는다. 채점 이유에는 판단할 근거가 없다고 쓰면서 점수는 낮게 매겼다. 점수 칸에 '모름'이 없으면 정보 부족이 점수에 섞여 들어간다. 내가 쓰는 모델에서는 그게 주로 낮은 점수로 나타났다.
프롬프트로 안 고쳐지는 건 입력으로 고친다. "짧다고 깎지 마라"는 지시는 먹히지 않았고, 편향을 다른 점수로 옮겨 놓았을 뿐이다. 프롬프트로 맞춘 수정은 모델이 바뀔 때마다 다시 맞춰야 한다. 네 모델이 같은 방향으로 흔들렸지만 크기는 제각각이었고, 한 모델은 같은 프롬프트로 점수를 구분조차 못 했다. 입력을 채우는 수정은 그 모두에 그대로 쓰인다.
지난 글이 신호를 어떻게 합칠지에 대한 이야기였다면, 이번 글은 그 신호가 어떻게 만들어지는지에 대한 이야기였습니다. 8월에 기업 블로그 글이 떨어졌을 때 저는 합치는 공식을 고쳤고, 증상은 줄었지만 원인은 그대로였습니다. 출처 탓인지 본문 탓인지는 운영 데이터를 아무리 들여다봐도 가를 수 없었고, 같은 글에서 하나씩 빼보는 실험이 갈라줬습니다.
코드는 GitHub에 있습니다. 본문 가져오기는 backend/app/pipeline/fetch_body.py, 결측 처리는 backend/app/pipeline/rank.py입니다.
※ 본문의 replay는 당시 운영값인 관련도 가중치 3으로 재현했습니다. 이후 별도 평가를 거쳐 운영값은 바꿨고, 그 과정은 다음 글에서 다룹니다.
부록: 추가로 확인한 것
- 동점 처리. 하루 50건 중 98%가 다른 글과 점수가 같습니다. 당시 코드는 동점이면 입력 순서, 그러니까 임베딩 필터가 뱉은 순서대로 순위를 줬습니다. 평균 순위로 바꾸면 Top 20이 하루 평균 0.4자리, 무작위로 섞으면 0.9자리 바뀝니다. 주된 원인은 아니었지만 설명할 수 없는 요인이라 글을 쓴 뒤 평균 순위로 바꿨습니다. 위 수치는 바꾸기 전 코드로 잰 것입니다.
- 커뮤니티 반응. 중요도와 Hacker News 추천 수의 순위 상관은 +0.17, GitHub 스타 수와는 +0.08입니다. 두 출처 모두 본문 없이 들어오던 글이 많아 해석하기는 어렵습니다.
- 가운데 순위가 완전한 중립은 아닌 이유. RRF 기여 1/(k+순위)는 순위가 내려갈수록 완만하게 줄어서, 가운데 순위의 기여는 채점된 글들의 평균보다 낮습니다. k=60, 50건 기준 약 3%입니다.
- 버린 프롬프트의 부작용. 신뢰도의 재호출 일치율도 72%에서 57%로 떨어졌습니다.