Tech-Radar
1.RRF로 추천 랭킹을 "더 공정하게" 바꿨더니 오히려 나빠졌다
LLM·AI 글을 매일 수집해 상위 10개를 추천하는 개인 뉴스레터를 만들었습니다. RRF 적용 후 무관한 글이 상위권에 오른 원인과 수정 과정을 정리했습니다.
2026년 9월 7일
2.LLM 채점은 '모르겠다'를 '낮다'로 적는다
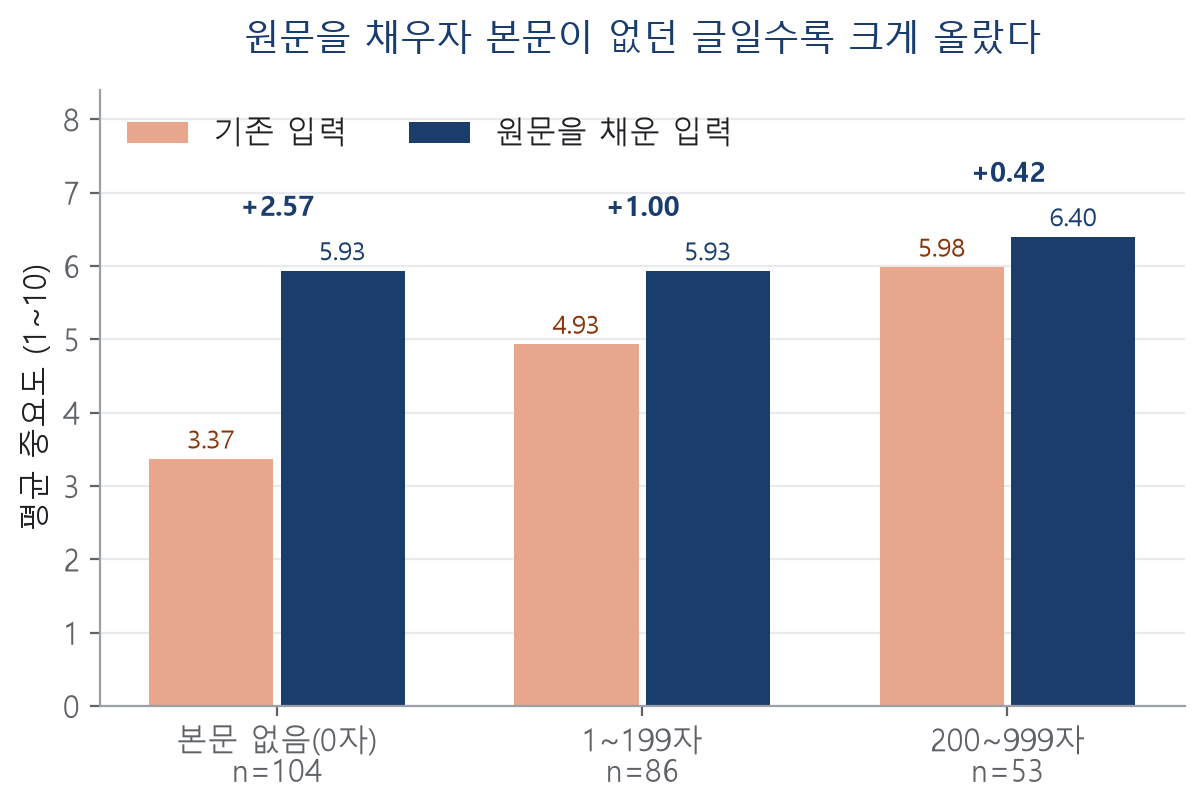
매일 아침 기술 글 10개를 골라주는 개인 뉴스레터에서 LLM이 매긴 점수 400건을 뜯어봤습니다. 모델은 흔들리지 않았고, 대신 판단할 본문이 없을 때 그 사실을 낮은 점수로 적고 있었습니다. 프롬프트로 고치려다 실패하고 입력을 고친 기록입니다.
2026년 9월 22일
3.같은 프롬프트를 다섯 모델에 넣었더니 실패 방식이 달랐다
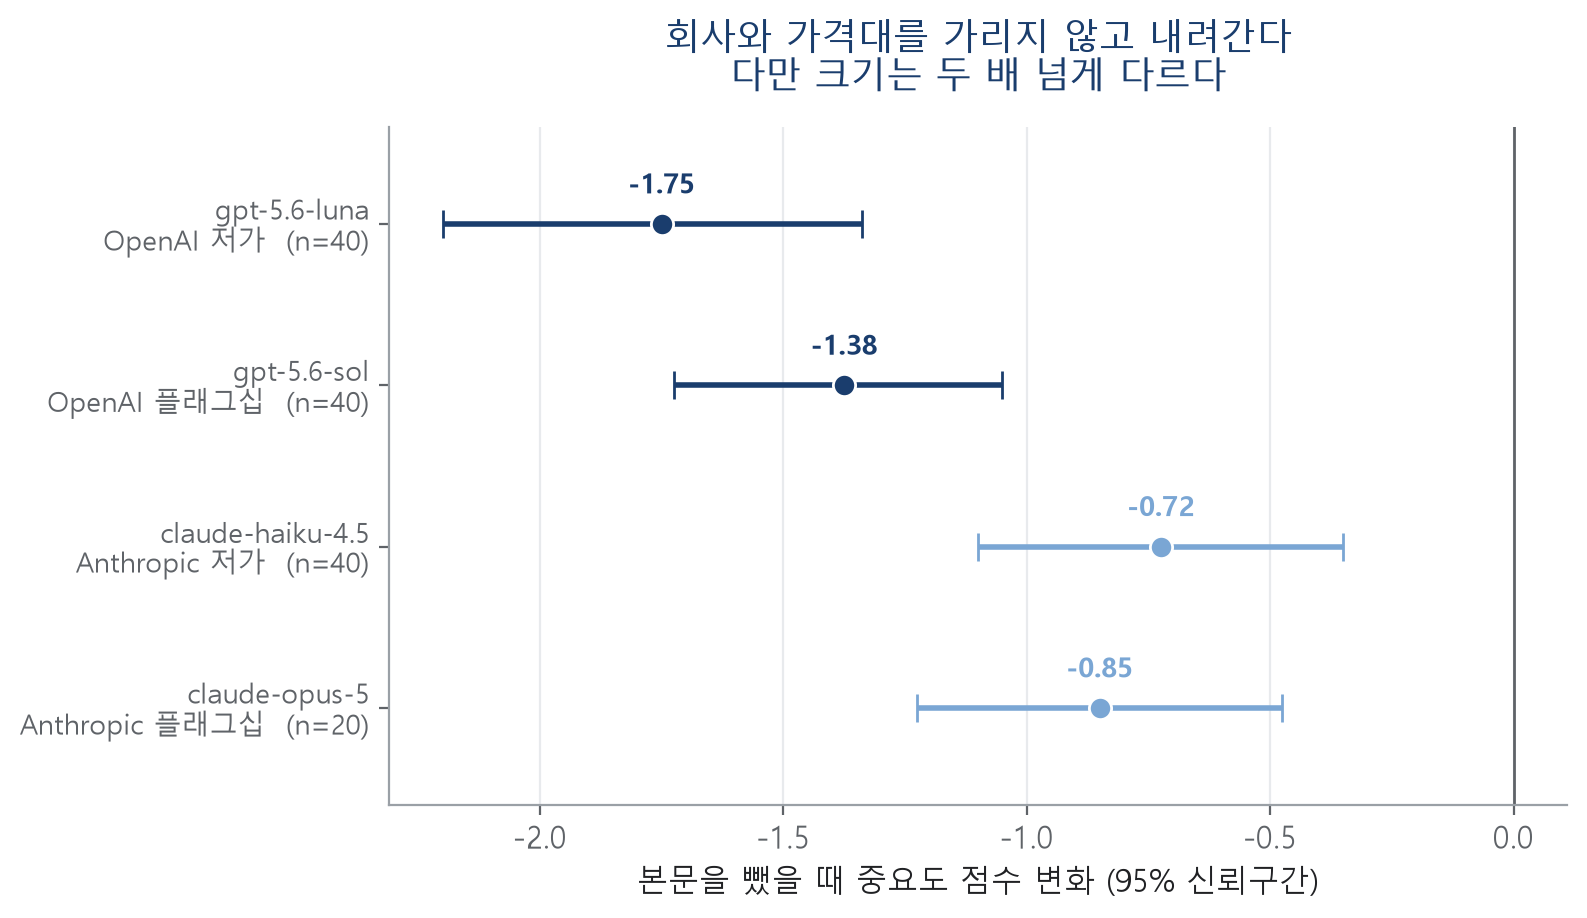
같은 채점 프롬프트를 다섯 LLM에 적용해 보니, 네 모델은 본문이 없을 때 중요도를 낮췄지만 하락폭은 달랐고 한 모델은 모든 글에 8점을 줬습니다. 모델 교체만으로는 해결되지 않았고, 입력을 보강하거나 정보가 없으면 채점하지 않는 설계가 더 안정적이었습니다.
2026년 9월 23일
4.추천을 고치는 걸 멈춘 이유
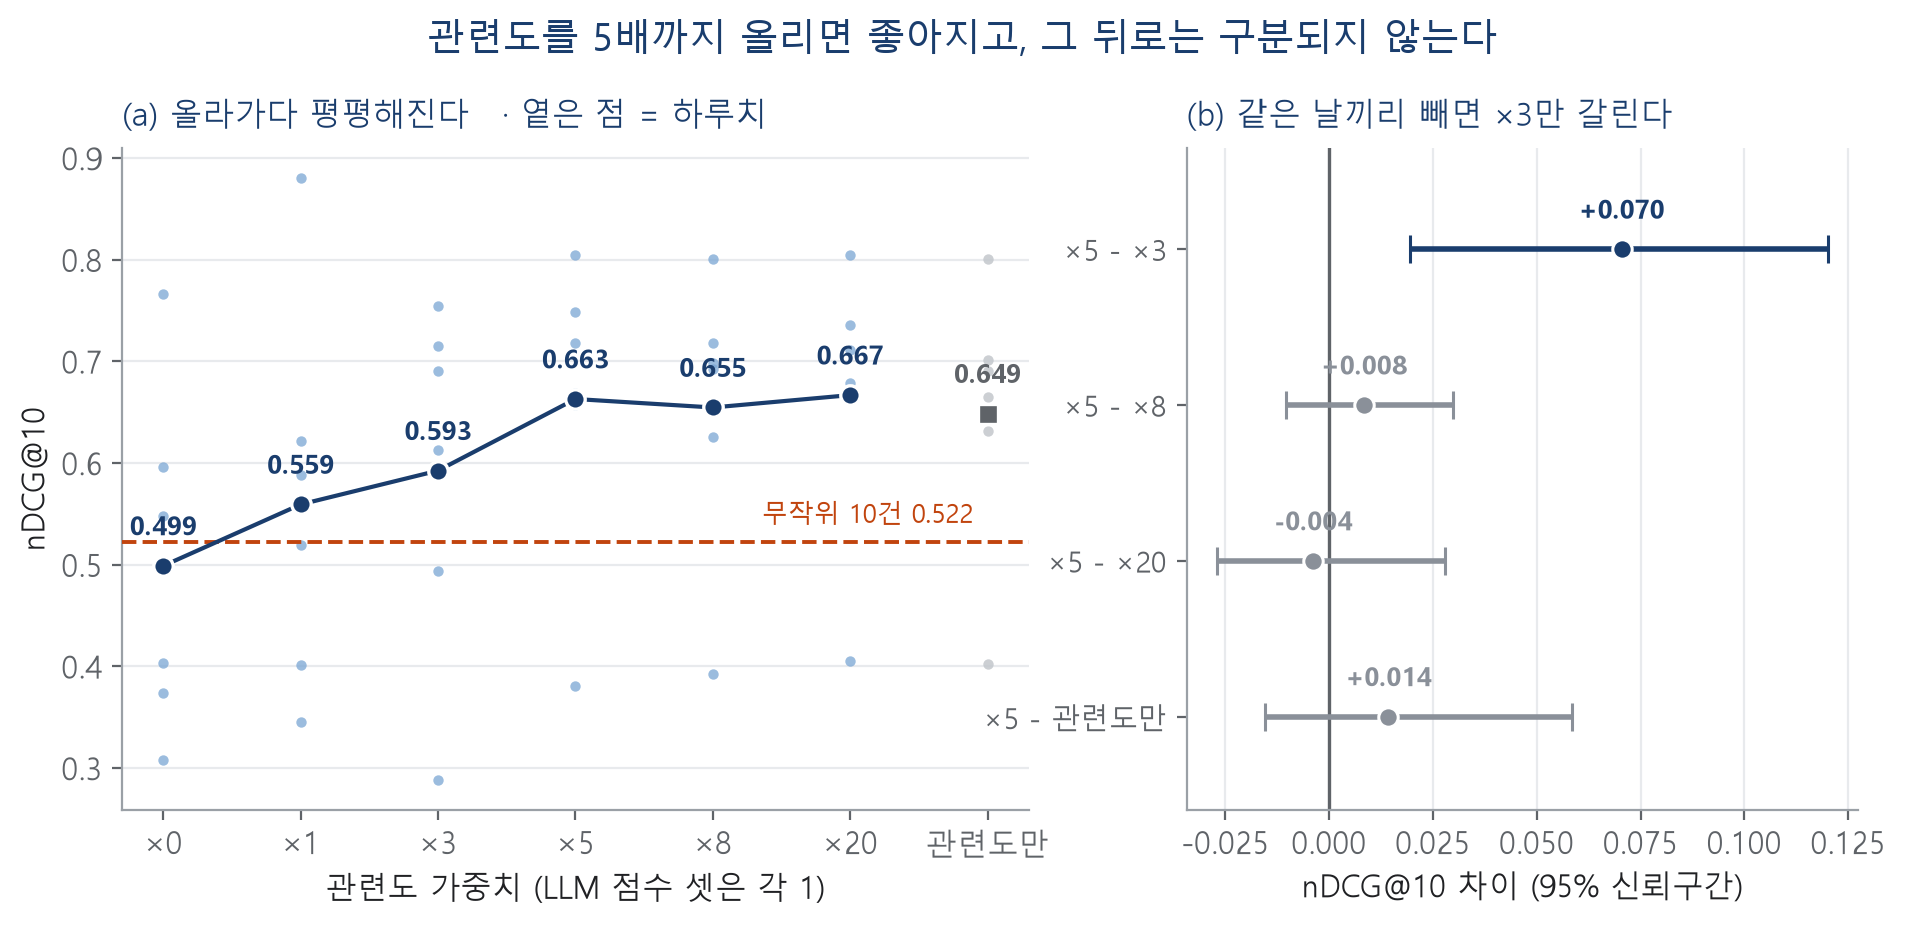
제가 만든 추천이 실제로 좋은지 6일 300건에 직접 라벨을 붙여 재봤습니다. LLM 점수만 쓰면 무작위보다 낮았고, 관련도 가중치는 5배 위로 올려도 차이를 구분할 수 없었습니다. 가중치보다 먼저 고쳐야 할 곳은 따로 있었습니다.
2026년 9월 30일