매번 해야지 해야지라고만 했던 논문 구현을 해보려고 한다. 처음에는 비교적 쉬운 논문으로 구현이 어떻게 이루어지는지 알아보기 위해 SRCNN을 골랐다. 이전에 내가 논문을 읽고 정리했던 글은 아래 링크에 있다.
Image Super Resolution Using Deep Convolutional Networks - SRCNN
1. 구현 전
1) 계획
구현하기 전에 대략적으로 어떤 방식으로 구현할 지 생각해 보았다. 처음 논문을 구현하는 것이다 보니 일단 아래와 같은 파일 구조로 만드려고 생각하고 있다.
- model : 모델의 구조나 필요한 기능들로 구성된 모듈
- evaluation : test data를 가지고 모델의 성능을 평가하기 위한 모듈
- data : 데이터를 train과 test set으로 나누고, 이를 로드하는 모듈
2) 모델 스펙
모델을 구현하기 전에 필요한 스펙을 정리해보겠다.
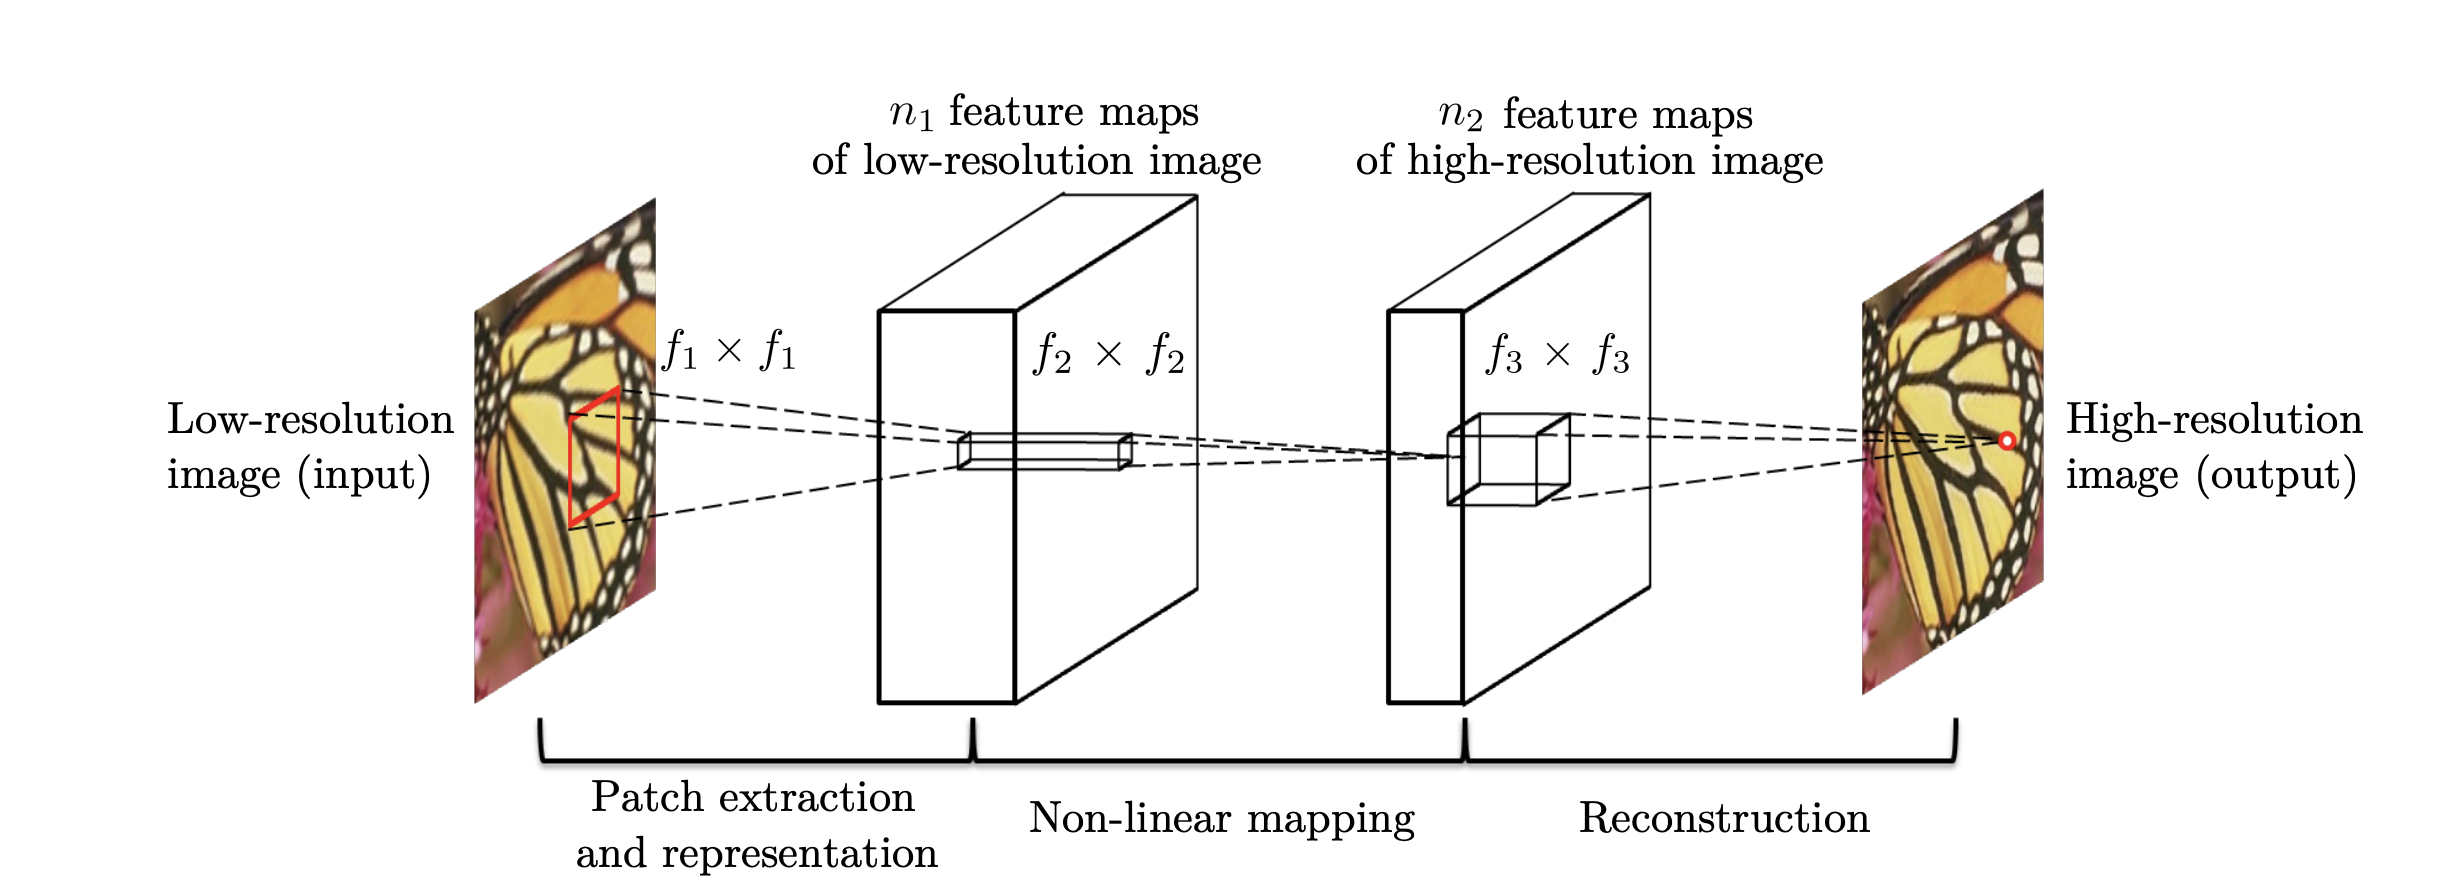
일단 모델의 구조는 위의 사진과 같다. Patch Extraction & Representation -> Non-linear Mapping -> Reconstruction의 단계를 거치게 된다. 먼저, 는 LR image를 bicubic upsampling을 의미한다는 것을 짚고 넘어가자. 논문에서는 이러한 를 low resolution이라고 표현한다. SRCNN의 목적은 를 목적으로 한다. LR image를 원본 HR 이미지와 최대한 비슷하게 복원하는 것이다.
i. Layer 1
첫 번째 layer인 patch extraction & representation layer의 식은 아래와 같다.
이때, 는 ReLU를 의미하고, 은 각각 weight와 bias를 뜻한다.
: 크기의 filter 개.
-> 이때, 는 채널 수, 은 filter의 크기
: 차원의 벡터.
ii. Layer 2
두 번째 layer인 Non-linear Mapping layer의 식은 아래와 같다.
마찬가지로
: 크기의 filter 개.
-> 이때, 는 채널 수, 은 filter의 크기
: 차원의 벡터.
iii. Layer 3
세 번째 layer인 Reconstruction layer의 식은 아래와 같다.
마찬가지로
: 크기의 filter 개.
-> 이때, 는 채널 수, 은 filter의 크기
: 차원의 벡터.
각 layer는 위와 같은 구성을 갖는다.
3) Training
이제 training 시의 세팅에 대해서 알아보자.
Loss Function
Loss Function으로 MSE(Mean Squared Error)를 사용한다. 식은 아래와 같다.
이때, 은 training sample 수를 의미한다.
Optimization
기본적인 SGD를 사용하고, 그 식은 아래와 같다.
- ( : learning rate)
weight matrix의 초기화는 Gaussian Distribution 에서 random하게 뽑고, bias=0으로 설정한다. learning rate는 layer 1, layer 2에 대해서는 , layer 3에 대해서는 로 설정한다.
Image Setting
먼저 우리가 훈련에 사용할 이미지가 어떻게 만들어지는지를 알아보자. 일단 training image를 의 크기로 random하게 crop한다. 이것이 Ground Truth image 가 된다. 여기서 LR image 를 만들기 위해 에 gaussian kernel을 이용해 blur를 먹이고, (1/upscaling factor)로 downsampling 해 준다. 이것이 LR image 이 된다. 그러나 논문에서는 이를 다시 upscaling(bicubic interpolation을 사용한다.)한 이미지를 로 표현한다. 따라서 네트워크의 input으로 들어가는 것은 upsampling된, 즉 HR image와 크기가 똑같은 upsampled LR image인 것이다.
Conv Layer
다음은 conv layer에 대한 이야기이다. padding=0 으로 세팅하고, network output의 크기는 이다. 나중에 네트워크를 다 구현하고 제대로 했는지 검토할 때 output의 크기가 이대로 나왔는지 알아보기 위해 사용하면 좋을 것 같다.
4) Experiment
이제 구현에 필요한 구체적인 숫자들을 살펴보자.
- : 채널은 한 개만 사용하며, 이는 Y channel이다. PSNR이나 SSIM을 계산할 때도 하나의 channel에 대해서만 계산한다.
- upsampling factor = 3
Dataset은 91-image dataset과 ImageNet 2013을 주로 사용했는데, ImageNet은 비용이 너무 많이 들어 사용하기 힘들고, 91-image를 가지고 구현을 진행해야 할 것 같다. 또, Set5, Set14을 validation set으로 사용한다. 잠시 dataset에 들어 있는 이미지 개수를 보자. 이고, stride = 14로 놓고 original image에서 추출하면 총 24800개의 이미지가 나온다.
5) Evaluation
baseline은 이전의 방법론인 sparse coding method로, PSNR = 31.42dB를 가진다. 저자들이 구현한 모델의 91-image dataset에서의 성능은 32.39dB이다. 내가 구현한 모델에서도 이 근처의 값이 나오는지 확인해야 한다. 또 하나 신경 써야 할 것은 Evaluation time이다.
2. 내가 구현해 볼 실험들
일단 기본적으로 91-image dataset + SRCNN을 가지고 실험을 진행한다. 따라서 가장 먼저 구현할 것은 PSNR이 32.39dB과 비슷한 수치가 나오는 지이다. 두 번째로는 논문에서 filter의 사이즈에 따른 성능을 비교한 실험을 구현해보려고 한다. 이렇게 하고 나서 내가 이 논문에 관해 느끼는 바를 정리하고 분석해보려고 한다.