이번에는 표준화에 이어 정규화에 대해 말하고자 합니다~!
데이터 정규화란?
데이터 정규화란 무엇일까요? 머신러닝에 사용되는 데이터는 그 값이 너무 크거나 작지 않고 적당한 범위에 있어야 모델의 정확도가 높아집니다.
아래 수식처럼 변수 x의 원래 값에서 x의 최솟값을 뺀 값을 x의 최댓값과 최솟값의 차이로 나눈 값으로 계산할 수 있습니다.
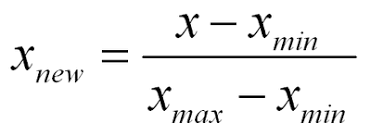
▶ 언제 사용할까?
ex)
a : 하나의 x변수가 금액을 나타내는 변수 0 ~ 20000원
b : 하나의 x변수가 거리를 나타내는 변수 1 ~ 2000km
로 주어질 경우 이 변수를 동일한 크기(단위)인 0~1사이로 변환하는 것입니다.
하지만, 기호에 따라 1~10까지 스케일링을 해도 괜찮습니다. 원하는 범위를 지정하여 스케일링할 수 있습니다.
▶ 특징
① 정규화를 통해 변수들을 일정범위 내로 좁혀 평등한 범위 내에서 관찰 및 학습 가능
② 하지만 minmax scaler는 0 ~ 1 같은 분류문제에서는 효과가 좋지 않고 회귀문제 해결 시 더 적합한 스케일링 방법
▶ 실습
minmaxscaler : 데이터의 값을 0~1사이로 정규화 시키기 위해 minmaxscaler를 활용합니다.
(만약 음수가 있을경우 -1 ~ 1사이로 변환해줍니다.)
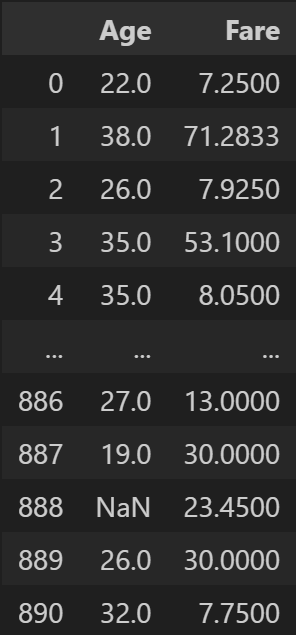
c = titanic_df[['Age', 'Fare']]

from sklearn.preprocessing import MinMaxScaler

scaler = MinMaxScaler()

train_minmax = scaler.fit_transform(c)
train_minmax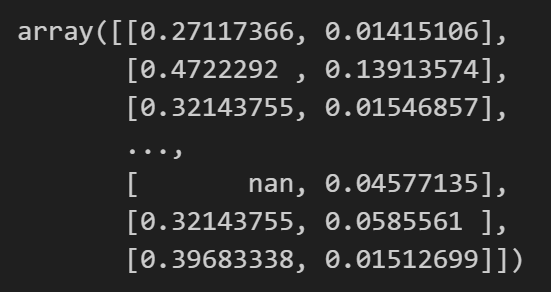
titanic 데이터의 age와 fare를 활용해 예시문을 작성했습니다.
minmax scaler는 sklearn에서 import를 해와야 하며 fit_transform() 함수를 활용하여 scaling시켜줍니다.
pd.DataFrame(train_minmax, index = c.index, columns = c.columns)이후에는 해당 코드를 통해 데이터프레임 형태로 만들어주면 결과는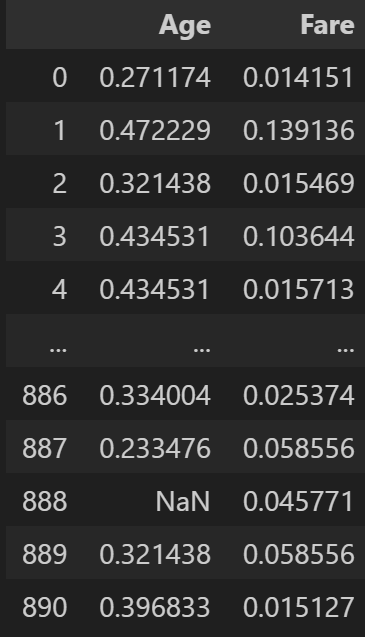
다음과 같이 나오게 됩니다.
5줄 요약
1. minmax scaler는 0~1사이로 값의 범위를 평등하게 해주는 것
2. 분류문제 해결 시는 효과적이지 않지만 회귀문제에서는 효과적
3. 실제로 데이터를 여러 개 불러와서 분석을 진행할 때 많이 썼던 정규화방법

데이터로 마케팅을 해보고 싶습니다~ 데이터 분석가도 좋아요!!
유용한 정보 감사합니다.
YJ_Slog님을 캐스팅하도록 하겠습니다.