실습 데이터 : load_breast_cancer
안녕하세요 여러분 이번에 새롭게 데이터분석 및 마케팅 데이터 마케팅을 공부하며 글을 작성해보려 합니다. 유용한 정보 많이 얻어가시고 같이 공부하면 좋을 것 같아요!
데이터 스케일링
데이터 스케일링이란 서로 다른 변수의 값 범위를 일정한 수준으로 맞추는 작업을 얘기합니다. 그리고 또한 해당 작업은 값을 조정하는 것이기 때문에 수치형에만 적용을 해야합니다!
언제 사용할까?
ex)
X1은 값이 0~100사이
X2는 값이 1000 ~ 10000사이
Y는 1000 ~ 10000사이라면 X1은 Y에 큰 영향을 안 끼칠 수 있습니다. 이 때 모든 값들을 동일한 범위내로 만들어주고 싶을 때 스케일링 작업을 해준다고 생각하시면 좋을 것 같아요!
여기에는 표준화와 정규화 방법이 있는데 각각에 대해 한번 보겠습니다.
🟢 표준화 : 평균을 0, 표준편차를 1로 변환하여 데이터를 조정하는 것을 의미
🔴 정규화 : 데이터를 특정범위로 변환하여 범위를 일치시키는 작업을 의미
그렇다면 데이터 스케일링 中 🟢표준화에는 어떤 종류가 있을까요?
한번 종류별로 알아봅시다!
표준화
※ Standard Scaler
첫번째는 가장 많이 사용되는 Standard Scaler입니다.
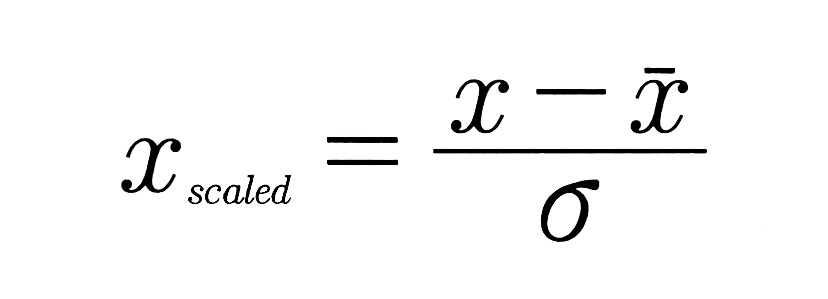
해당 식은 Z표준화라고 하는 식이며, 스탠다드 스케일링은 가장 많이 사용되는 표준화 방법 중 하나인데요.
사이킷런 데이터셋 중 load_breast_cancer 데이터를 활용해 간단한 표준화 예시를 들어볼게요!
예시 : load_breast_cancer
from sklearn.datasets import load_breast_cancer

cancer = load_breast_cancer()
caner 변수에 데이터를 로드합니다.
data = pd.DataFrame(data = cancer.data, columns = cancer.feature_names)

data['target'] = cancer.target
data['target']

data
데이터프레임형태로 바꿔준 뒤, 각 컬럼들에 대한 시각화를 해봤는데요

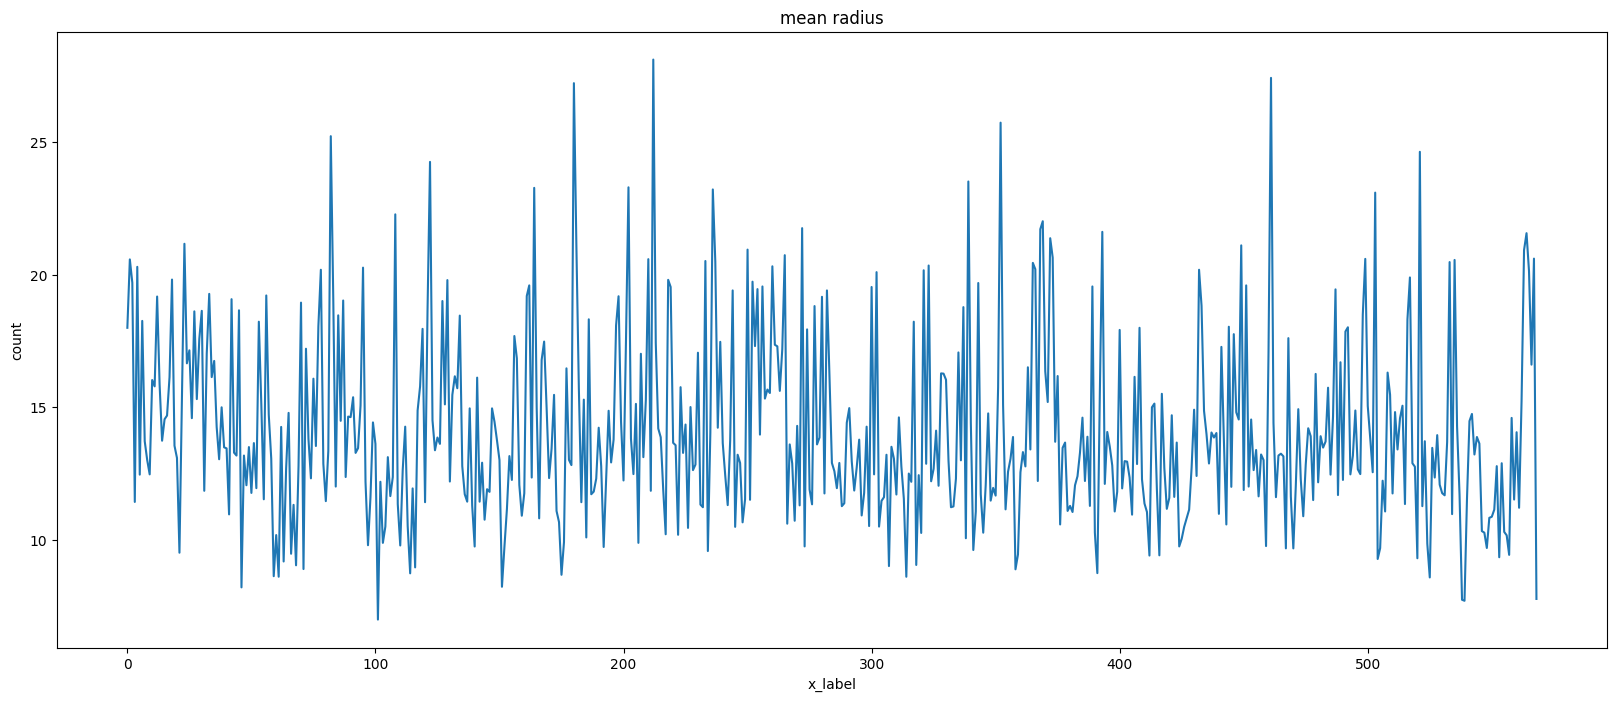
주로 이러한 형태를 지닌 그래프인데요.
이를 표준화를 하면
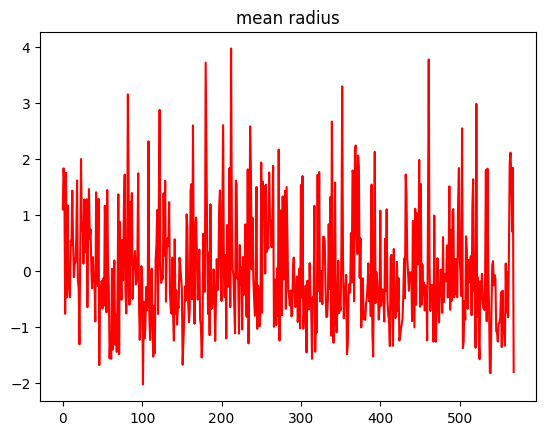
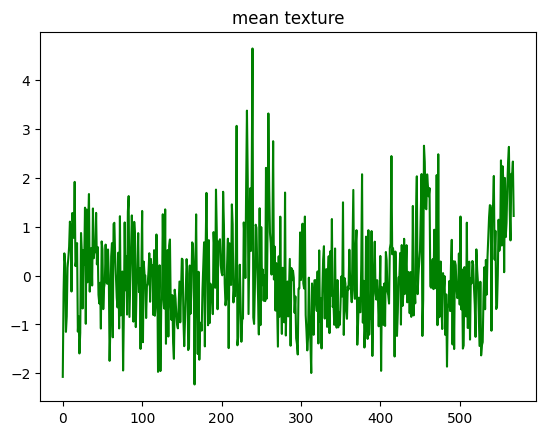
다음과 같습니다. 변화를 아시겠나요?
y축이 평균이 0을 기준으로 표준화된 것을 볼 수 있습니다.
파이썬에서 표준화를 하기 전 주의사항이 있습니다. 바로 fit을 진행해야한다는 것인데요!
from sklearn.preprocessing import StandardScaler

# StandardScaler 인스턴스 생성
std = StandardScaler()

# 먼저 fit을 통해 데이터를 학습시킴
std.fit(data[['mean radius']])  # 데이터는 2D 형태로 전달되어야 함

# 데이터를 변환하여 표준화
r = std.transform(data[['mean radius']])

# 결과 출력
plt.plot(r, color = 'red')
다음과 같이 fit을 한 뒤, 이를 표준화시켜줘야 합니다.
실제로 스케일링을 했을 때와 안 했을 때 모델의 성능 또한 다른데요
X_train, X_test, y_train, y_test = train_test_split(cancer.data, cancer.target, test_size = 0.2, random_state=42, shuffle = False)
dtc = DecisionTreeClassifier()
dtc.fit(X_train, y_train)
print('모델 정확도 : ', round(dtc.score(X_test, y_test), 4))
스케일링을 안 했을 때의 결과는 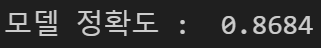
했을 때의 결과는
from sklearn.preprocessing import StandardScaler

std = StandardScaler()
std.fit(X_train)
X_train_scaled = std.transform(X_train)
X_test_scaled = std.transform(X_test)
dtc.fit(X_train_scaled, y_train)
print('모델의 정확도 :', round(dtc.score(X_test_scaled, y_test), 4))
다음과 같습니다 > 성능 차이가 보여지나요? 또한 각각에 대해 히스토그램 시각화를 진행하게 될 경우


평균 0을 기준으로 1~4 시그마 정도씩 그래프가 그려지는 모습을 볼 수 있습니다.
5줄 요약
1. 표준화는 평균 0, 표준편차 1의 범위로 데이터를 표준에 맞게 통일시키는 것
2. 데이터마다 값이 다르기 때문에 y축, 즉 값을 일정범위에 일치시켜주고 싶을 때 사용
3. 모델을 학습시키기 전에 사용을 하며 범위가 비슷하면 모델이 학습을 할 때 더 잘 할 수 있기에 이를 활용한다.
4. data[['mean texture']]와 같이 2차원 형태의 구조에서 활용가능하다.
5. 반드시 fit을 해준 뒤, 활용해야한다.
