안녕하세요! 이제 슬슬 머신러닝에 대해 적어보고자 합니다. 여러가지 공부를 하느라 오랜만에 적는 글인데 다시 한번 핵심만 쏙쏙 적어보도록 할게요!
1. k-최근접 이웃이란?
k 최근접 이웃을 알기 전에 우선 회귀라는 단어에 대해 알고 넘어가보려고 해요!
1-1. 회귀란?
머신러닝에는 대표적인 3가지 학습방법?모델링방법?이 있습니다.
① 지도학습
② 비지도학습
③ 강화학습
그 중 지도학습에는 두가지가 있습니다. 바로 분류와 회귀입니다.
이 중 우리는 오늘 회귀에 대해 알고자 하는데요.1-2. 회귀의 의미
회귀에는 2가지 의미가 있습니다.
① 회귀란 어떤 임의의 숫자를 예측하는 문제입니다.
② 두 변수간 상관관계를 분석하는 방법도 회귀의 의미입니다.
2. k-최근접 알고리즘
정의
: k-NN알고리즘이란
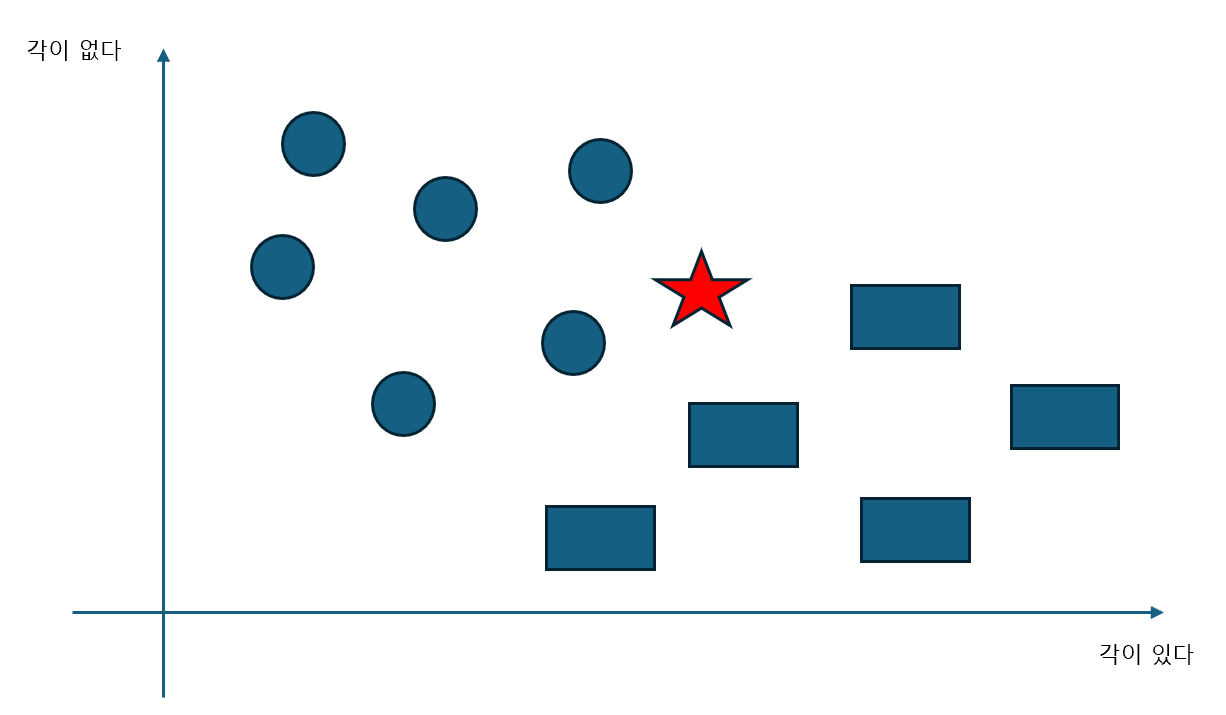
원형이 짜장 사각형이 짬뽕이라고 생각해봅시다.
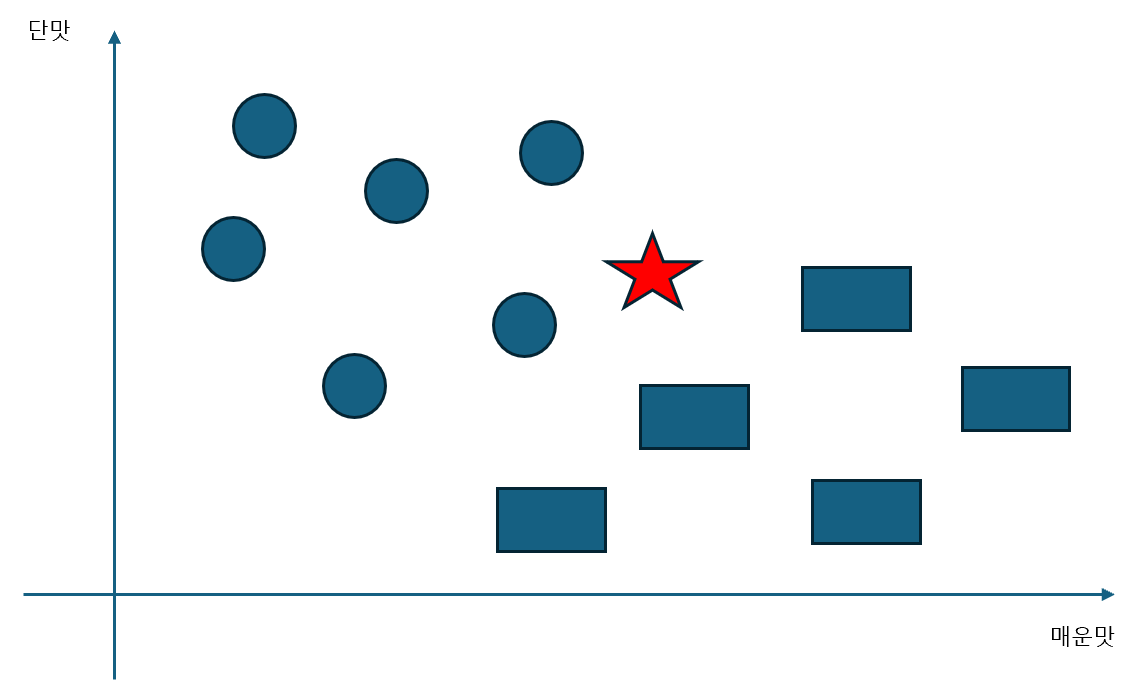
위 별이 (짜장)인지 (짬뽕)인지 한번 보겠습니다.y축은 단맛 선호 x축은 매운맛 선호라고 봤을 때 단맛을 선호할 수록 짜장을 매운맛을 선호할수록 짬뽕을 선호한다고 볼 수 있을 것입니다.
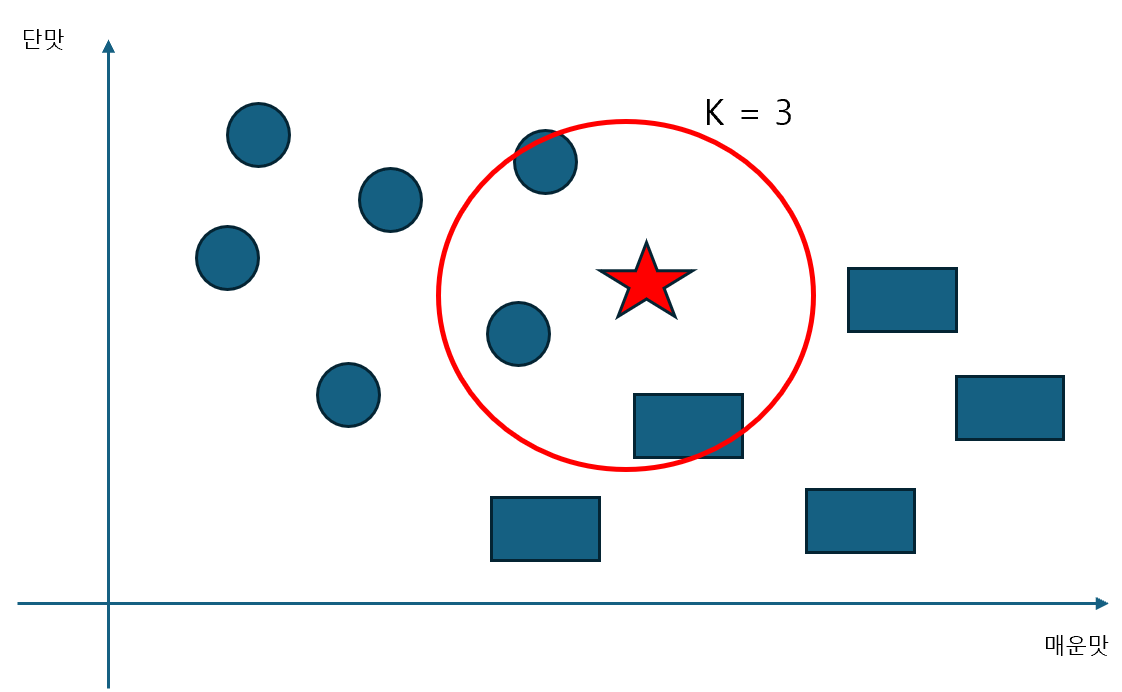
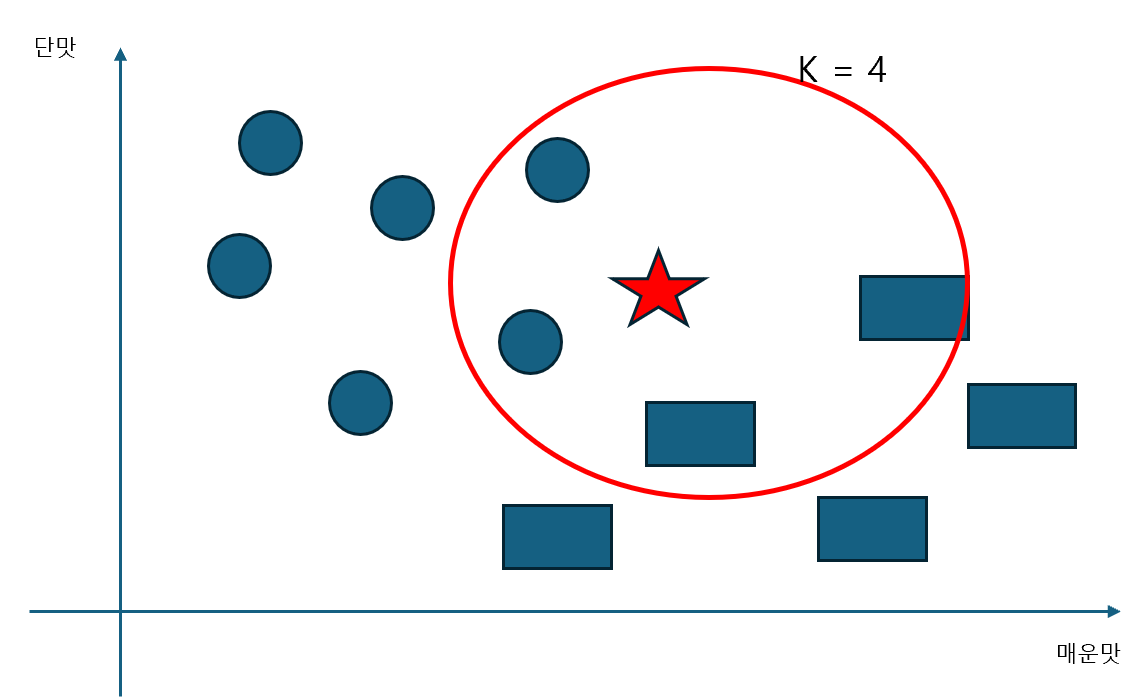
이제 K-NN알고리즘을 이용해 인접한 3개의 데이터를 찾아보겠습니다. 짜장 2개가 묶인 것을 볼 수 있는데요. 그럼 이 별은 짜장이 될 것입니다.하지만 4개일 때는 어떨까요?
4개일 때는 뭐가 뭔지 모르겠습니다. 짜장일수도 있고 짬뽕일 수도 있어요. 이와 같이 k를 설정해 거리 기준 인접한 분류형태가 되는 것이 K-NN입니다.2-1. 장점 / 단점
장점
① 단순하고 효율적이다
② 훈련이 빠르고 수치기반 데이터에서 성능이 우수하다.단점
① 적절한 K의 선택이 필요하다(중복되면 애매해질 수 있다.)
② 데이터가 많을 수록 분류 단계가 느리다.
3.K-NN회귀는?
바로 x를 활용해 y를 예측하는 것입니다.
해당 k-최근접 이웃 알고리즘을 사용해 회귀 문제를 푸는데요,
가장 가까운 이웃 샘플을 찾고 이 샘들들의 타깃값을 평균하여 예측으로 삼는 것이 K-NN회귀입니다.예시
perch_length = np.array([8.4, 13.7, 15.0, 16.2, 17.4, 18.0, 18.7, 19.0, 19.6, 20.0, 21.0,
       21.0, 21.0, 21.3, 22.0, 22.0, 22.0, 22.0, 22.0, 22.5, 22.5, 22.7,
       23.0, 23.5, 24.0, 24.0, 24.6, 25.0, 25.6, 26.5, 27.3, 27.5, 27.5,
       27.5, 28.0, 28.7, 30.0, 32.8, 34.5, 35.0, 36.5, 36.0, 37.0, 37.0,
       39.0, 39.0, 39.0, 40.0, 40.0, 40.0, 40.0, 42.0, 43.0, 43.0, 43.5,
       44.0])
perch_weight = np.array([5.9, 32.0, 40.0, 51.5, 70.0, 100.0, 78.0, 80.0, 85.0, 85.0, 110.0,
       115.0, 125.0, 130.0, 120.0, 120.0, 130.0, 135.0, 110.0, 130.0,
       150.0, 145.0, 150.0, 170.0, 225.0, 145.0, 188.0, 180.0, 197.0,
       218.0, 300.0, 260.0, 265.0, 250.0, 250.0, 300.0, 320.0, 514.0,
       556.0, 840.0, 685.0, 700.0, 700.0, 690.0, 900.0, 650.0, 820.0,
       850.0, 900.0, 1015.0, 820.0, 1100.0, 1000.0, 1100.0, 1000.0,
       1000.0])
다음과 같이 농어의 무게와 크기가 있을 때 회귀모델을 활용할 수 있습니다.
이 데이터들을 통해 모델을 학습시킵니다.
코드는 아래와 같습니다.
from sklearn.model_selection import train_test_split

train_input, test_input, train_target, test_target = train_test_split(perch_length, perch_weight, random_state=42)

train_input = train_input.reshape(-1,1)
test_input = test_input.reshape(-1,1)
print(train_input.shape, test_input.shape)

from sklearn.neighbors import KNeighborsRegressor

knr = KNeighborsRegressor()
knr.fit(train_input, train_target)

from sklearn.metrics import mean_absolute_error

test_prediction = knr.predict(test_input)

mae = mean_absolute_error(test_target, test_prediction)
mae
무게와 길이에 따른 농어 예측입니다. 이 같은 모델을 회귀모델이라고 합니다.
오늘은 k-nn회귀에 대해 알아봤습니다!
읽어주셔서 감사합니다~!
