안녕하세요! 이번에는 랜덤포레스트라는 모델에 대해 알아보고자 합니다. 앙상블 기법 중 하나인 이 랜덤포레스트를 어렵지만 같이 볼까요?
1. 앙상블이란?
정의
여러개의 개별 모델을 조합하여 최적의 모델로 일반화 하는 방법을 앙상블 기법이라고 합니다.
앙상블 기법은 여러 모델의 예측 결과를 합쳐 더 나은 예측을 하도록 합니다. 핵심은 여러 모델들이 서로 다른 방식으로 학습해야 한다는 것입니다.
종류
1. 배깅(부트스트랩)
: 배깅은 데이터의 여러 부분집합을 샘플링하여 각각의 모델을 독립적으로 학습시킨 후, 그 예측 결과를 평균하거나 다수결을 통해 결합하는 방법
모델 종류 : 랜덤 포레스트(Random Forest)2. 부스팅
: 이전 모델이 잘못 예측한 데이터를 다음 모델이 더 잘 예측하도록 학습하는 방식입니다. 모델들이 순차적으로 학습하여, 이전 모델의 오류를 보정
모델 종류 : Gradient Boosting, XGBoost, LightGBM
3. 스태킹
: 여러 개의 다른 모델들을 학습시키고, 그 모델들의 예측을 다시 다른 모델(보통 메타모델)에 넣어서 최종 예측을 만드는 방법
앙상블 기법의 종류는 다음과 같이 3개가 있으며 그 중 오늘은 배깅 기법을 통한 모델인 랜덤포레스트에 대해 알아보겠습니다.
2. 랜덤포레스트
정의
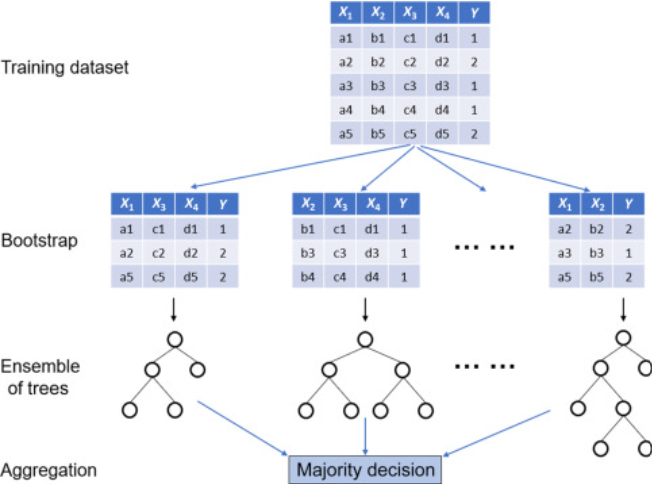
배깅(Bagging) 기법을 기반으로 한 앙상블 학습 알고리즘입니다. 여러 개의 결정 트리(Decision Tree)를 생성하여, 각 트리의 예측을 종합함으로써 최종 예측을 도출하는 모델입니다.
과정
데이터 샘플링
: 부트스트랩 샘플링을 통해 샘플을 추출합니다. 이를 통해 여러 개의 훈련샘플 집합을 형성합니다. 이때 부트스트랩은 중복이 가능한 복원추출이므로 샘플링한 부분집합에 중복된 값이 들어갈 수 있습니다.결정트리 학습
: 랜덤포레스트는 각 샘플에 대해 결정트리를 학습시킵니다. Decision Tree라고도 하는 이 모델링은 다음 챕터에서 다루어보도록 하겠습니다^^예측 결과 결합
: 모든 결정트리가 학습을 마치고 나면 각 트리의 예측을 결합합니다.
랜덤포레스트에서는 분류와 회귀 두개가 다 되는데
- 분류
: 분류의 경우 다수결 투표 방식으로 각 트리가 예측한 결과 중 가장 많이 나온 클래스를 최종 예측값으로 결정합니다.- 회귀
: 각 트리의 예측값을 내어 최종 예측값을 도출합니다.
다음과 같은 과정으로 모델이 학습됩니다.
장점
- 과적합 방지
: 대부분의 앙상블 모델 기법은 과적합을 방지합니다. 랜덤포레스트도 기반이 되는 결정트리라는 모델을 학습에 활용하는데 이 모델은 노드를 최적화 하는 특징으로 가지가 뻗는 경향이 있어 과적합될 위험이 있습니다.
- 특징 중요도 평가
: 랜덤 포레스트는 각 특징이 모델에 얼마나 중요한지 평가할 수 있는 기능이 있습니다. 특징 중요도를 계산하여, 모델에 가장 큰 영향을 미치는 변수를 파악할 수 있습니다.
단점
- 해석의 어려움
: 여러개의 트리를 결합한 것이므로 최종 모델이 결과를 어떻게 도출했는지 해석의 어려움이 존재합니다.
- 메모리 사용
: 여러 개의 결정 트리를 학습시키기 때문에, 메모리 사용량이 많을 수 있습니다. 특히 데이터가 클 경우 메모리 부담이 커질 수 있습니다.
파라미터
rf_model = RandomForestClassifier(
    n_estimators=200,      # 200개의 트리 사용
    max_depth=10,          # 트리의 최대 깊이를 10으로 제한
    min_samples_split=4,   # 분할을 위한 최소 샘플 수를 4로 설정
    min_samples_leaf=2,    # 리프 노드에 최소 2개의 샘플이 있도록 설정
    max_features="sqrt",   # 각 트리가 사용할 특징의 개수를 sqrt(n_features)로 설정
    bootstrap=True,        # 부트스트랩 샘플링 사용
    n_jobs=-1,             # 모든 코어를 사용하여 병렬 처리
    random_state=42        # 결과의 재현을 위해 난수 시드 설정
)
여기서 리프 노드란 더 이상 분할되지 않는 노드로, 최종 예측 결과를 담고 있는 부분,
n_jobs는 cpu코어를 몇개 사용할지 입니다. -1은 전부다 1은 1개의 코어만 이런식인거죠~^^
feature란 랜덤 포레스트는 각 트리마다 전체 특성 중 일부를 랜덤하게 선택하여 분할을 만듭니다. 이때 고려할 그 특성(feature)들의 수를 max_features에서 몇개를 선택할지를 쓴 것입니다.
오늘은 여기까지 랜덤포레스트 모델에 대해 알아봤습니다. 간단한 난이도 있는 개념이니 꼭 숙지하시면 좋을 것 같아요! 다음번에는 의사결정트리로 돌아오겠습니다! 감사합니다~
