뒤처지지 않고자 AI와 함께 팔자에도 없던 로보틱스 논문 목록을 훑어봤는데, WAM이라는 약자가 나왔다.
이건 얼마 전에 유튜브에서도 본 듯한 World Action Model이었다.
2월에 나온 DreamZero가 이 이름을 퍼뜨렸는데, 지금은 이미 그 다음 얘기가 한참 진행 중이다.
8월 27일에 Riemann-1.0이 나왔고, 9월 8일에 SyncWorld가 나왔다.
둘 다 WAM인데 접근 방식이 꽤나 다르다.
이 글에선 그 두 개를 대략적으로 정리해보고자 한다.
AI 도움도 받아가면서.. 적당히 이해한 선까지만 써본다.
WAM이 뭔데
VLA는 observation을 받아서 action을 뱉는다.
그게 뭐냐면 VLA는 카메라로 본 이미지, 로봇의 현재 상태, 사람의 명령 같은 정보를 받아서 다음에 어떤 동작을 해야 할지 바로 예측한다.
WAM은 거기에 하나를 더 붙인다.
action을 뱉기 전에 "이 action을 주면 화면이 어떻게 변할까"를 같이 만든다.
VLA처럼 동작만 정하는 게 아니라, "이렇게 움직이면 다음 장면은 어떻게 바뀔까"까지 같이 예측한다는 것이다.
5월 서베이는 이걸 future states와 actions의 joint distribution을 모델링하는 모델이라고 정리한다.
그냥 대충 미래의 상태와 행동을 함께 예측하는 모델이라는 것이다.
미래를 상상하면 로봇의 행동을 정하는 policy가 좋아진다는 게 전제다.
행동하기 전에 그 결과를 미리 상상할 수 있으면, 더 나은 행동을 고를 수 있을 것 같다.
근데 이 전제는 계속 두들겨 맞았다
3월 Fast-WAM은 제목부터 질문이다.
정말 test-time에 미래를 상상해야 하냐고 묻는다.
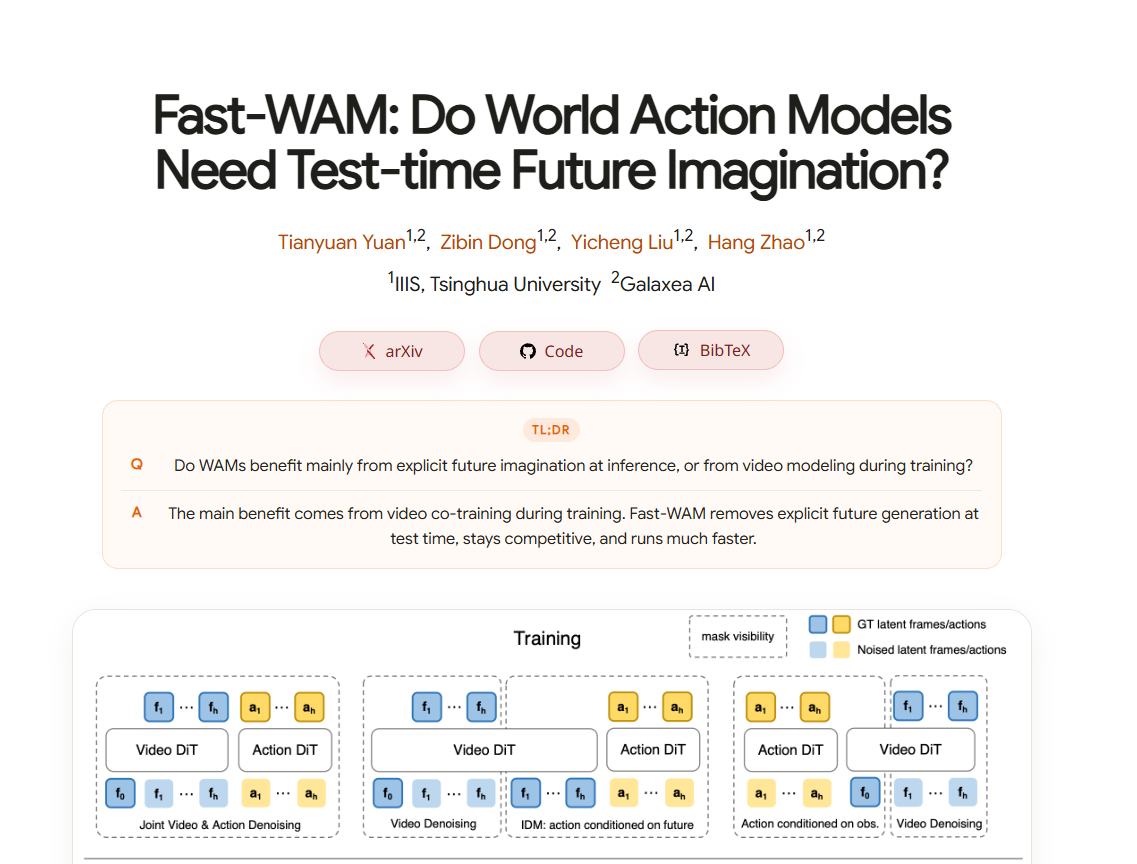
결과는 inference 때 미래 생성을 통째로 빼도 성능이 거의 안 떨어졌다.
반대로 학습할 때 video co-training을 빼면 성능이 크게 떨어졌다.
쉽게 말하면 미래를 예측하는 법을 배우는 건 도움이 되는데, 실제로 움직일 때마다 미래를 직접 상상할 필요는 없을 수도 있다는 것이다.
2월엔 미래를 상상하는 게 핵심이라고 했는데, 여기 3월 논문엔 굳이 매번 상상할 필요는 없던데요?가 나온 셈이다.
6월엔 그래서 WLA가 미래 예측을 아예 스위치로 만들었다.
평소엔 꺼놓고 바로 움직이다가, 계산할 여유가 있을 때만 미래를 예측한다.
8월에 나온 논문에는 아예 실전 배포 이야기가 나왔다.
카메라로 본 시점, 모델이 예측한 시점, 실제 로봇이 움직인 시점이 조금씩 어긋나는 게 문제라는 것이다.
한 번에 여러 action을 묶어서 예측하는 action chunk도 경계에서 움직임이 끊길 수 있는데,
앞뒤를 적당히 섞는 것만으로는 해결이 안 된다고 한다.
Riemann-1.0, policy랑 시뮬레이터를 한 몸으로
Riemann-1.0은 하나의 모델이 robot policy랑 world simulator 역할을 동시에 한다.
카메라 이미지랑 로봇 상태를 보고 먼저 다음 action을 예측한다.
그리고 그 action을 했을 때 화면이 어떻게 바뀔지도 이어서 예측한다.
여기서 매번 실제 카메라 화면을 다시 넣어주면 로봇을 실제로 움직이는 policy가 된다.
반대로 자기가 예측한 다음 화면을 계속 다시 넣어주면 이는 시뮬레이터가 된다.
모델은 똑같은데, 실제 화면을 계속 보여주느냐 상상을 계속 이어가느냐만 다르다.
이게 데이터가 진짜 많다.
20만 시간이 넘는다고 한다.
대충 계산해도 22년짜리가 넘는다.
| 벤치마크 | 성공률 |
|---|---|
| RoboTwin2.0 | 94.3% |
| LIBERO | 99.0% |
| RoboCasa-365 | 62.6% |
| 실기 long-horizon | 85.0% |
물론 성공률은 대단하지만, 전부가 논문 자체 평가다.
그리고 LIBERO 99.0%는 좀 그렇긴 하다.
이쯤이면 이 벤치마크는 수명이 다한 것 같다.
SyncWorld, action은 픽셀에서 공용어가 아니다
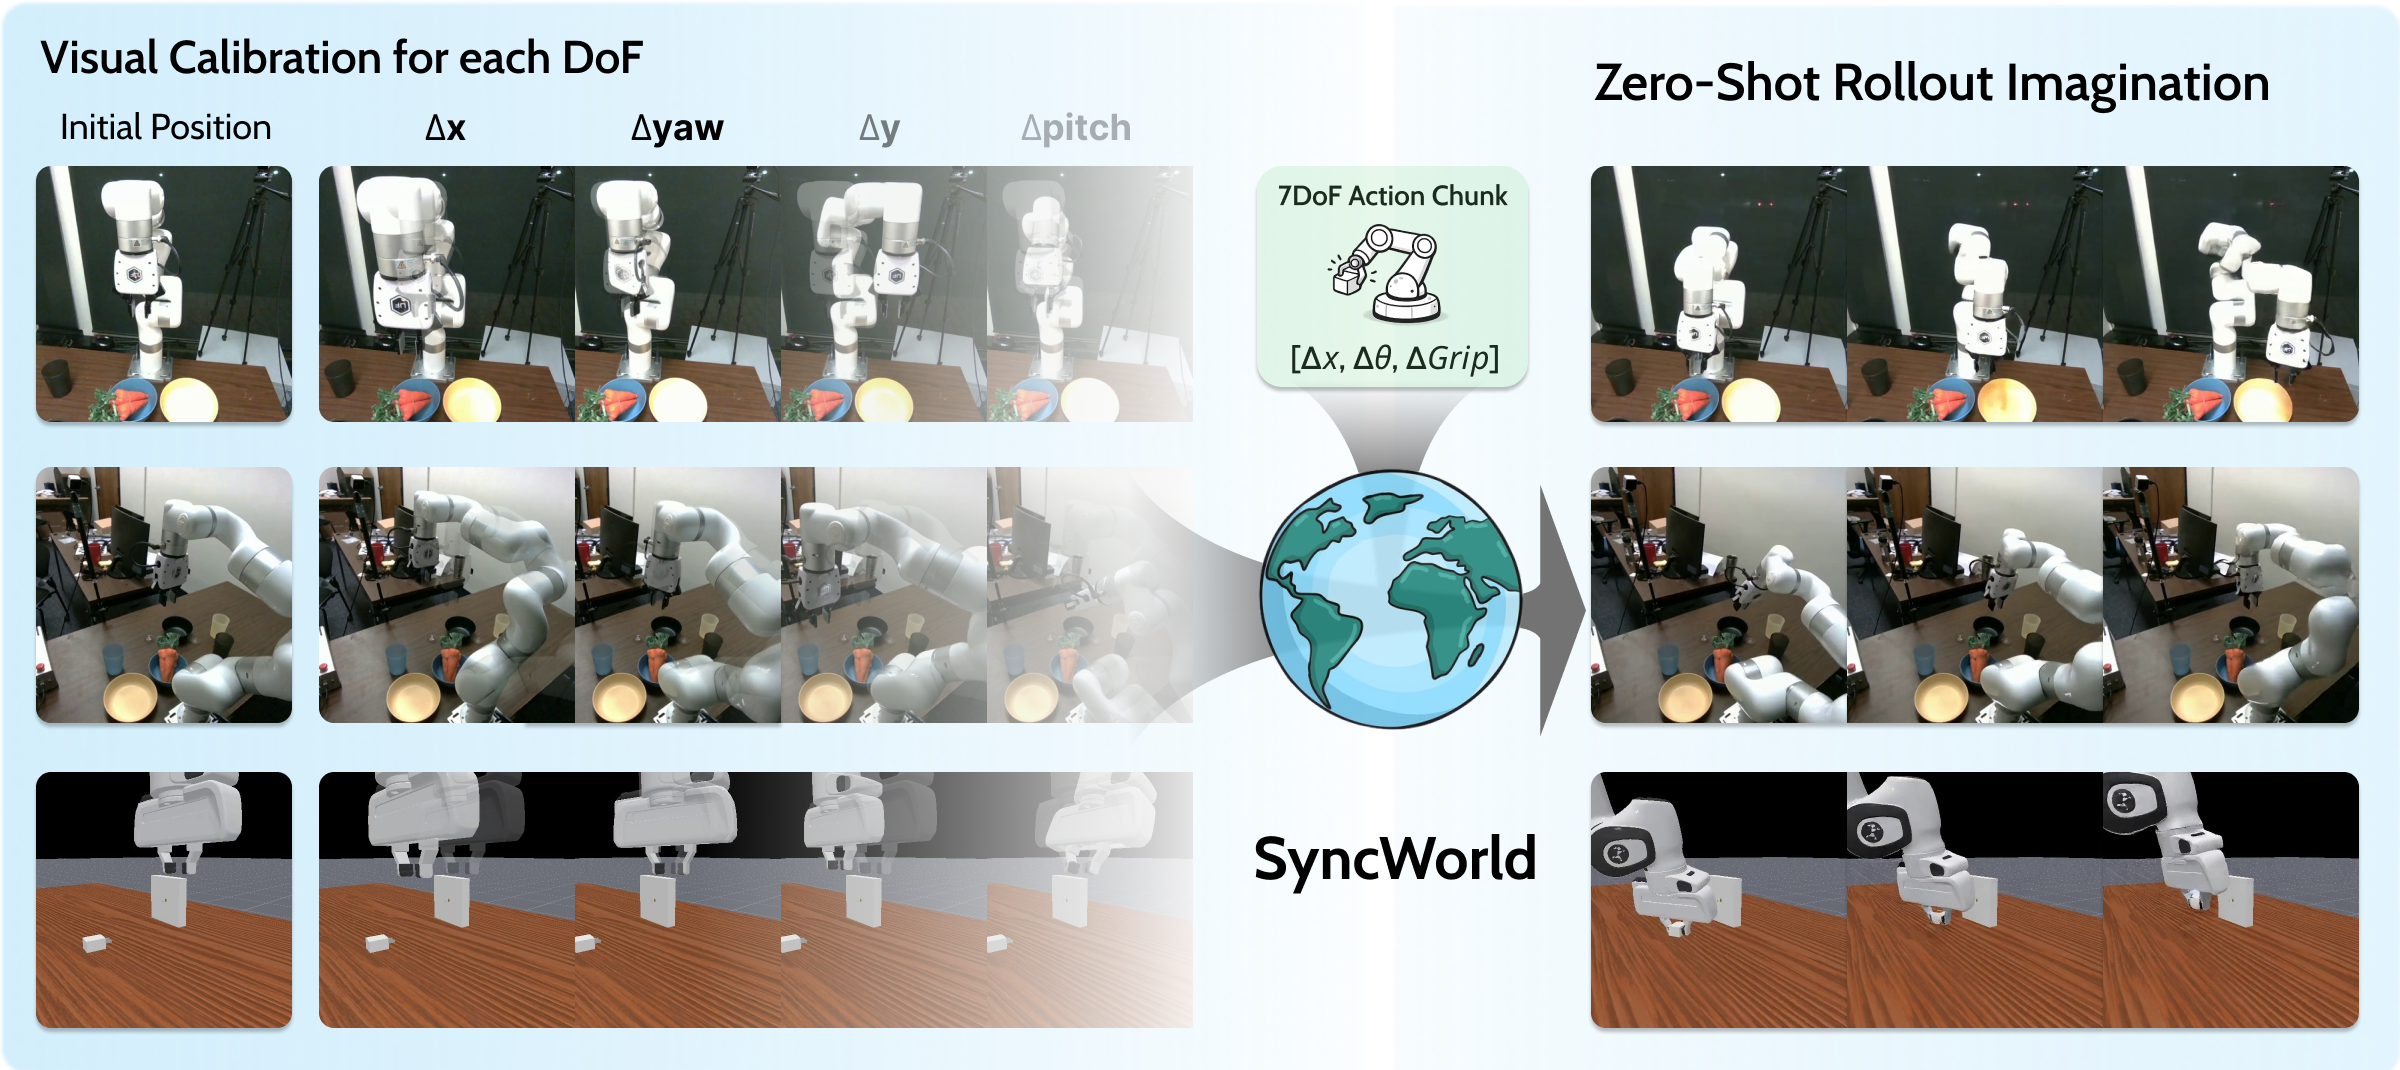
문제 제기가 아주 단순하다.
똑같은 숫자로 된 action이라도 카메라 위치나 로봇이 바뀌면 화면에서는 전혀 다르게 보인다.
그러니까 여러 환경 데이터를 섞어 학습하면 서로 충돌하는 supervision이 들어간다.
보통은 새 환경에서 fine-tuning을 한다.
SyncWorld는 대신 아주 짧은 visual calibration episode를 context로 준다.
6개 자유도를 각각 양방향으로 한 번씩 움직였다가 제자리로 돌아오는 영상이다.
총 12개 짧은 구간을 비디오 앞에 붙인다.
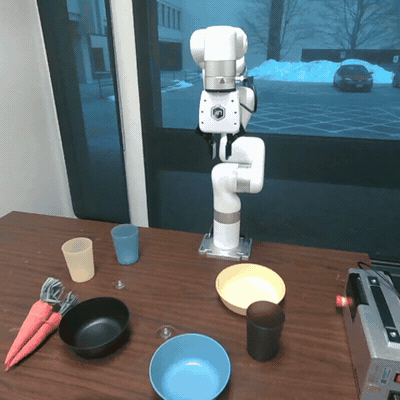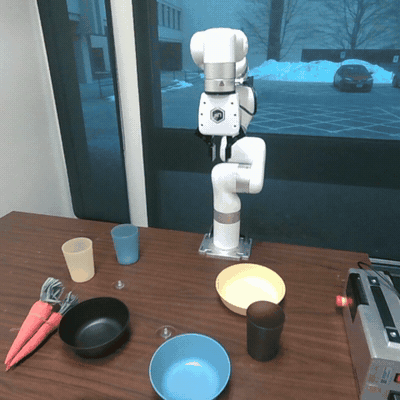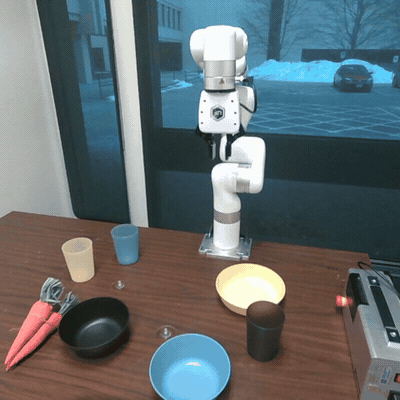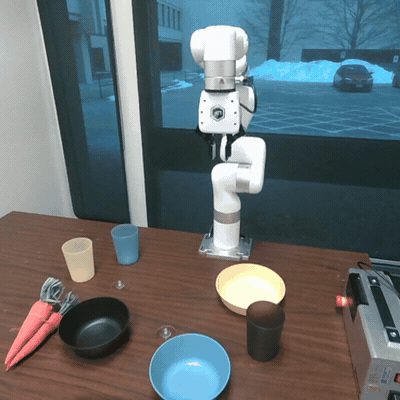
대충 설명하자면 로봇이 준비운동을 하는 것이다.
쭉 폈다가 제자리, 옆으로 갔다가 제자리.
그걸 찍어서 모델한테 보여주는 거다.
딱 이것만 보고 처음 보는 환경에서 추가적인 학습 없이 시뮬레이터로 동작한다.
심지어 실제 로봇 실험에서는 학습 때 본 적 없는 xArm에도 적용했다고 한다.
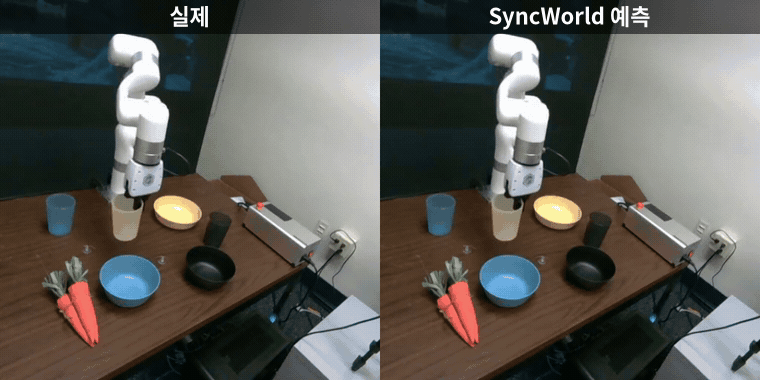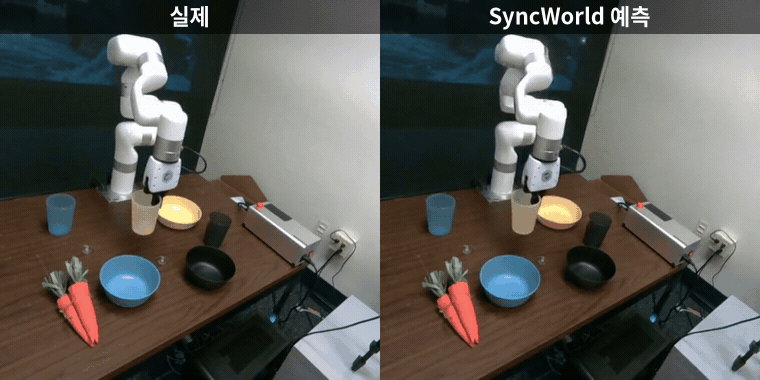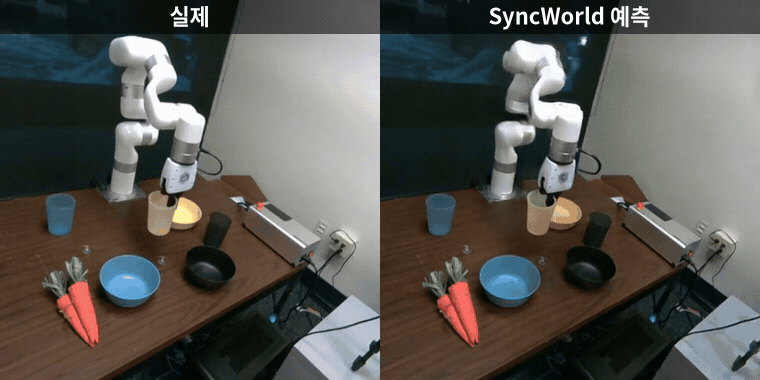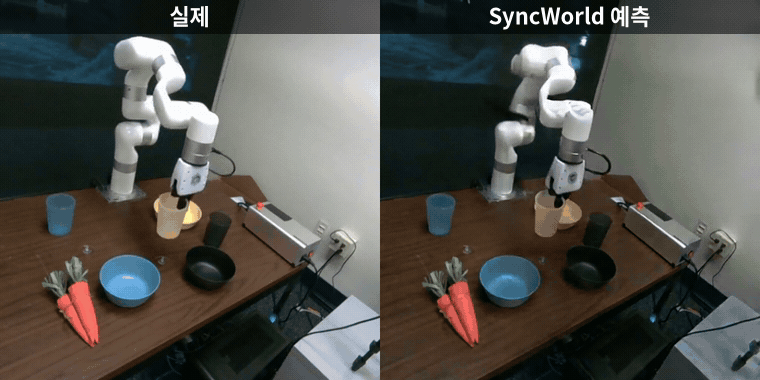
학습 때 본 적 없는 로봇이라는데 왼쪽이랑 오른쪽이 거의 똑같이 움직인다.
그리고 이 시뮬레이터로 rollout을 돌려서 추가 학습 없이 policy까지 개선했다고 한다.
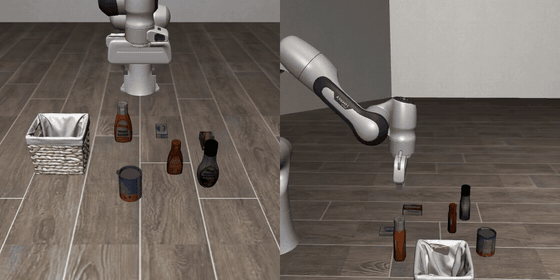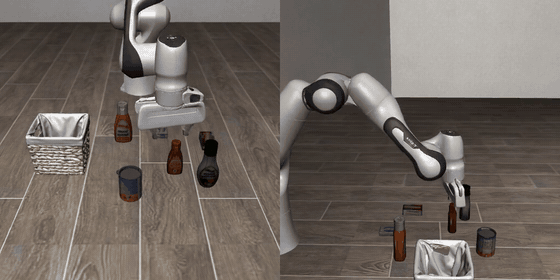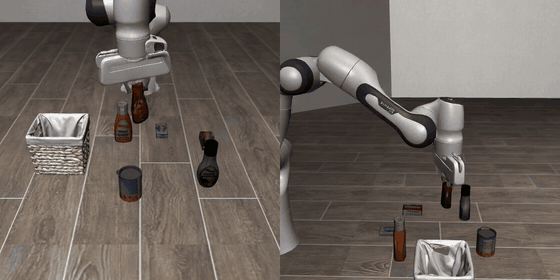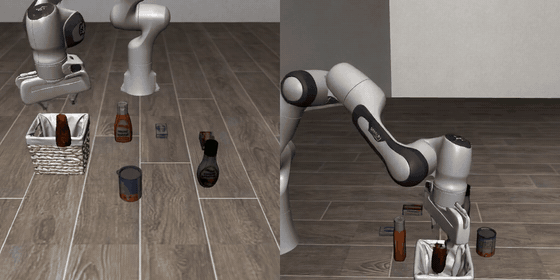
action 후보를 여러 개 뽑고, 각각 어떻게 될지 상상해본 다음, 제일 나아 보이는 걸 고르는 식이다.
LIBERO에서 52~56%짜리가 58~72%까지 올라갔는데, 진짜 시뮬레이터를 쓴 상한선이 60~80%라고 한다.
이렇게 보면 정말 괜찮은 방식이어 보인다.
이 둘을 같이 보면
Riemann은 policy랑 시뮬레이터를 하나로 합친다.
그리고 학습에 20만 시간이 넘는 데이터를 썼다..
이걸 가진 쪽만 할 수 있는 접근이다.
SyncWorld는 시뮬레이터를 policy에서 떼어내서 범용 부품으로 만든다.
대신 짧은 calibration 영상만으로 새 로봇에도 적용하는 모습을 보여준다.
하나는 합치는 쪽이고, 다른 하나는 따로 떼어 여기저기 갖다 쓰는 쪽이다.
로봇에 갖다 붙이는 걸 상상하기엔 SyncWorld 쪽이 훨씬 직관적으로 와닿았다.
마무리
반년 사이에 내가 모르고 있던 곳에서 이런 논의가 계속 오갔다는 게 참 신기하다.
2월엔 그냥 로봇도 예측을 해보면 어떨까? 미래를 상상한다는 신기한 얘기였는데,
3월엔 굳이 안 해도 된다는 논문이 나오고, 9월엔 상상하는 부분만 따로 떼서 부품처럼 쓰고 있다.
내가 로봇을 다룬다곤 해도 막 연구하는 전문가가 아니라서 상세한 논문 분석이나 벤치마크 해석은 좀 자신 없다.
그래도 로봇마다 다른 좌표계랑 카메라를 어떻게 맞출 거냐는 문제는 결국 안 사라진다는 것 정도는 남는 것 같다.
SyncWorld는 그 문제를 사람이 아니라 모델한테 넘긴 셈이다.
이것도 완벽하진 않겠지만..
끗
출처:
- Fast-WAM: Do World Action Models Need Test-time Future Imagination?
- World Action Models: The Next Frontier in Embodied AI
- World-Language-Action Model
- World Action Models in Real Time
- Riemann-1.0: An Embodied World Action Model for Physical AI
- SyncWorld: Visual Calibration Enables World Models as Zero-Shot Simulators
본문 GIF는 SyncWorld 논문(arXiv:2609.09155, CC BY 4.0)과 프로젝트 페이지의 데모 영상에서 가져왔다.