정의
- 그래프 : node(vertex)와 edge 로 이루어진 자료구조
- degree: 한 node에 대해 edge 로 연결된 이웃한 node의 개수
- directed graph 일 때 outdegree, indegree - cyclic graph / acyclic graph
- complete grapg: 서로 다른 모든 노드 쌍이 연결된 그래프
- connected graph: 임의의 두 노드 사이에 경로가 항상 존재하는 그래프
- simple graph: 두 노드 사이의 edge가 1개 이하이고 loop가 존재하지 않는 그래프
- loop: 자기 자신에게 돌아오는 edge
표현법
인접행렬
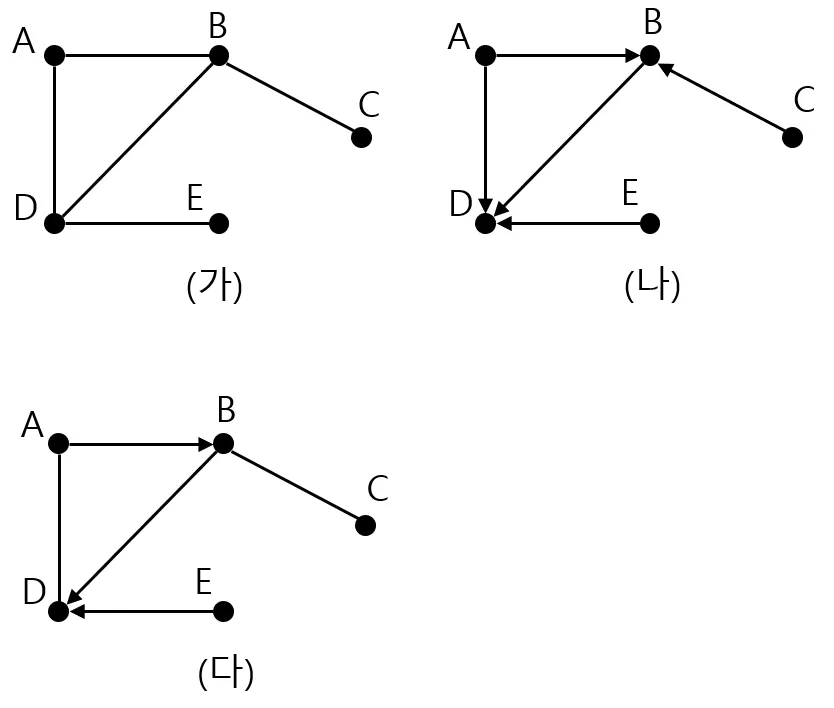
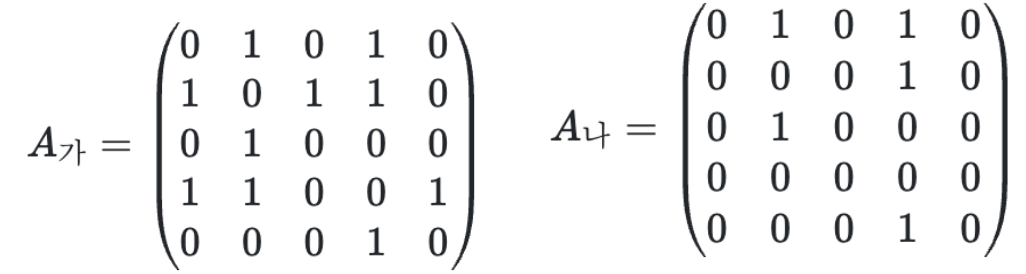
- O(V^2)의 공간
A23 = 1: 2번 node에서 3번 노드로 가는 edge- 무방향 그래프의 인접행렬은 항상 대칭행렬 (A12 = A21)
- 인접행렬의 모든 성분의 합은 그래프 edge 의 개수와 같음.
- 무방향 edge는 양쪽이므로 edge 2개로 간주됨 - 보통 관례적으로 1-indexed 로 번호 붙임
인접 리스트
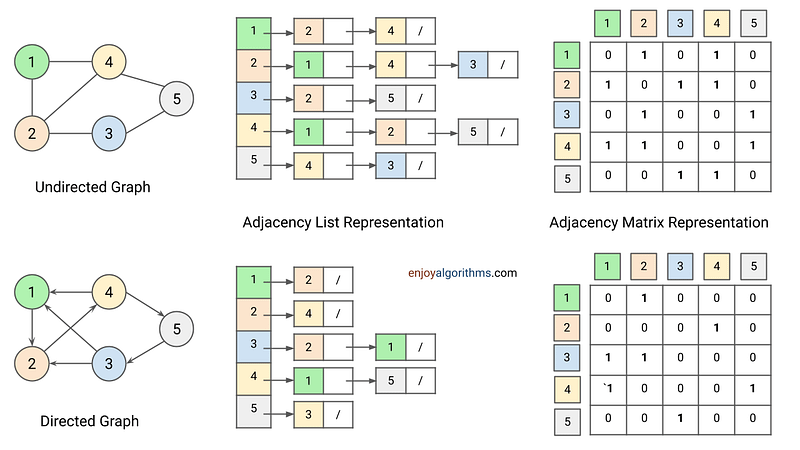
- edge 개수가 적을 때 인접 행렬보다 공간 절약 가능
- O(V+E) 의 공간
- V개의 리스트 만들어서 각 리스트에 해당 V 노드와 연결된 노드 넣기
- 방향 그래프의 경우, out-edge 로 연결된 노드만 넣으면 됨
- 원소의 개수의 총합은 방향 그래프일 때 E개, 무방향 그래프일 때 2E개
- 진짜 연결 리스트인 STL list 쓰기보다는 그냥 vector로 구현하는게 편함
정리
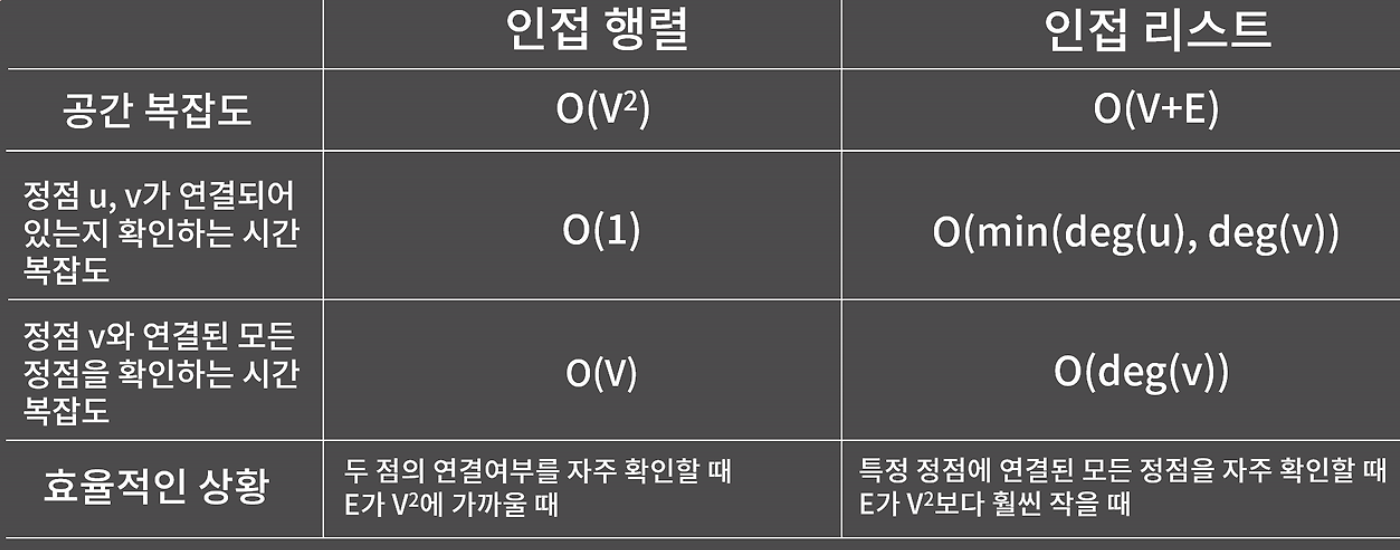
- 인접 행렬
- 두 점의 연결 여부를 많이 확인할 때
- edge의 개수가 V^2에 가까울 때 - 인접 리스트
- 특정 노드에 연결된 모든 노드를 자주 확인할 때
- edge의 개수가 V^2보다 훨씬 적을 때 - 경로 알고리즘(BFS, DFS 등)은 특정 정점에 연결된 모든 정점을 확인하는 작업이 자주 → 인접 리스트 사용이 많음
- but 입력 자체가 인접 행렬 느낌이거나 V가 많아 구현의 편의를 위해서 혹은 플로이드 알고리즘(최단 거리) 사용시 → 인접 행렬이 유용할 수도 있음
BFS
- BFS: 그래프에서 너비(breadth)를 우선적으로 방문하는 알고리즘
- queue에서 노드 꺼내서 해당 노드와 연결된 모든 노드에 대해: 방문하지 않았다면 방문 표시 남김 + 큐에 넣기
- 참고) 다차원 배열에서는 상하좌우 인접칸 확인함
- 모든 정점에 큐에 한번씩 들어가므로: 인접 리스트에서는 O(v+e), 인접 행렬에서 O(v^2)
DFS
- DFS: 그래프에서 depth를 우선적으로 방문하는 알고리즘
- stack에서 노드 꺼내서 해당 노드와 연결된 모든 노드에 대해: 방문하지 않았다면 방문 표시 남김 + 큐에 넣기
- 참고) 다차원 배열에서는 상하좌우 인접칸 확인함
- 모든 정점에 스택에 한번씩 들어가므로: 인접 리스트에서는 O(v+e), 인접 행렬에서 O(v^2)
- 참고) dfs 고유 성질 이용하는 문제: cycle detection, SCC, BCC, 오일러 경로
재귀
1. 재귀(Recursion)를 이용한 DFS
- 재귀 호출을 사용하여 함수 호출 스택(Call Stack)을 이용
*std::stack같은 자료구조(명시적 스택)를 쓰지 않고 OS와 CPU가 내부 메모리의 Call Stack을 자동으로 사용함: 메모리 관리는 OS가 알아서 함 - 방문하지 않은 인접 노드를 만날 때마다 재귀 함수를 호출
- stack 메모리의 제한이 작은 경우 재귀 구현이 어려움 (stack overflow) → 비재귀(
std::stack) 사용
#include <iostream>
#include <vector>

using namespace std;

// 전역 변수로 관리
const int MAX = 1001;
vector<int> adj[MAX]; // 인접 리스트
bool visited[MAX];    // 방문 여부 배열

// 재귀 방식을 이용한 DFS
void dfs_recursive(int here) {
    // 1. 현재 노드 방문 처리
    visited[here] = true;
    cout << here << " ";

    // 2. 인접한 노드들을 순회하며 방문하지 않은 곳 탐색
    for (int next : adj[here]) {
        if (!visited[next]) {
            dfs_recursive(next);
        }
    }
}
2. 비재귀(Stack)를 이용한 DFS
std::stack사용 (bfs에서 queue 자리 대신 stack 사용하면 dfs 됨)- 스택의 LIFO 특성을 이용하며, 재귀 호출로 인한 스택 오버플로우 위험을 방지할 수 있음
- 스택에서 값을 뽑은 후 방문 여부를 true로 만듦 → 연결된 노드를 보는 작업이 각 정점마다 최대 1번씩만 해서 < 연결된 정점을 보는 작업을 각 정점마다 여러 번 진행하는 방식>보다 시간복잡도가 개선됨: O(v+e)
#include <iostream>
#include <vector>
#include <stack>

using namespace std;

// 전역 변수로 관리
const int MAX = 1001;
vector<int> adj[MAX]; // 인접 리스트
bool visited[MAX];    // 방문 여부 배열

// 비재귀(명시적 스택)를 이용한 DFS
void dfs_non_recursive(int start) {
    stack<int> s;
    // 시작 노드를 스택에 넣고 출발
    s.push(start);

    while (!s.empty()) {
        int here = s.top();
        s.pop();

        // 이미 방문한 노드라면 건너뜀
        if (visited[here]) continue;

        // 1. 현재 노드 방문 처리
        visited[here] = true;

        // 2. 인접한 노드들을 스택에 푸시
        for (auto next: adj[here]) {
            if (!visited[next]) {
                s.push(next);
            }
        }
    }
}
기록하는 블로그
tree = directed acyclic graph