[논문 리뷰] Analyzing Multi-Head Self-Attention: Specialized Heads Do the Heavy Lifting, the Rest Can Be Pruned
Analyzing Multi-Head Self-Attention: Specialized Heads Do the Heavy Lifting, the Rest Can Be Pruned(https://aclanthology.org/P19-1580.pdf)
트랜스포머 속 엘리트 20%를 찾아내는 수학적 인사고과
48개의 어텐션 헤드 중 38개를 잘라내도 번역 품질이 거의 그대로라는 충격적인 사실.
ACL 2019 | Elena Voita et al. (Yandex, University of Amsterdam, University of Edinburgh)
목차
- 서론
- Background
- Problem Definition
- Proposed Method / Approach
- Experiments & Results
- Discussion
- My Insights
- Summary
1. 서론
이 논문은 기계 번역 분야의 핵심인 트랜스포머(Transformer) 모델이 '생각보다 게으르다' 는 충격적인 사실을 밝혀낸 연구입니다.
트랜스포머는 여러 개의 헤드(Head)를 동시에 사용하는 '다중 헤드 어텐션(Multi-head Attention)' 덕분에 강력한 성능을 내는 것으로 알려져 왔습니다. 하지만 이 논문은 놀랍게도 그 많은 헤드 중 실제로 번역을 캐리하는 엘리트 헤드는 20%에 불과하고, 나머지 80%는 없어도 그만인 무임승차자라는 것을 입증했습니다.
저는 거대한 인공지능 내부를 현미경처럼 들여다보고, 나아가 수학적인 방법으로 불필요한 부품을 시원하게 잘라내는 이 논문의 접근 방식에 큰 매력을 느꼈습니다. 이 글을 통해 인공지능이 내부적으로 언어를 어떻게 이해하는지, 그리고 어떻게 하면 이 거대한 모델을 똑똑하고 가볍게 다이어트시킬 수 있는지 함께 파헤쳐 보겠습니다.
2. Background
논문을 제대로 이해하기 위해 알아야 할 필수 개념들을 가볍게 짚고 넘어가 봅시다.
트랜스포머(Transformer)와 어텐션(Attention)
오늘날 ChatGPT를 비롯한 대부분의 AI 모델을 지탱하는 핵심 기술입니다. 번역을 할 때 문장의 모든 단어에 집중하는 것이 아니라, 현재 번역할 단어와 '가장 관련이 깊은 단어'에만 집중(Attention)하는 기술입니다.
"I ate a delicious apple"을 번역할 때 'apple'을 번역하는 순간에는 'ate'나 'delicious'에 강한 어텐션을 주는 방식입니다.
수식으로 표현하면 다음과 같습니다.
다중 헤드 어텐션 (Multi-head Attention)
한 명의 똑똑한 전문가 대신, 여러 명의 전문가(Head)를 두어 동시에 문장을 분석하게 하는 방식입니다.
| 이유 | 설명 |
|---|---|
| 다양한 관점 확보 | 문법 전문가, 의미 전문가 등 여러 시각에서 문장을 입체적으로 이해 |
| 표현력 향상 | 단일 헤드 대비 거의 1 BLEU 포인트 이상의 성능 향상 |
| 구조 | 트랜스포머는 보통 한 층에 8개 헤드 × 6개 층 = 총 48개 헤드 |
모델 경량화 (Pruning, 가지치기)
학습이 끝난 인공지능 모델에서 불필요한 파라미터(신경망의 연결선)를 잘라내어 모델의 크기를 줄이고 속도를 높이는 기술입니다.
AI 모델이 점점 거대해지면서 스마트폰 같은 작은 기기에 넣거나 서버 유지비를 줄이기 위해 '다이어트'가 필수가 되었습니다.
비전공자를 위한 요약
기존에는 "트랜스포머는 여러 명의 전문가(헤드)가 토론해서 번역을 잘한다!"라고 믿어왔습니다. 그런데 이 논문은 "진짜 다 일하는 거 맞아? 노는 전문가가 더 많은 거 아니야?" 라는 합리적인 의심에서 출발합니다.
3. Problem Definition
이 논문이 꼬집는 핵심 문제는 "우리는 다중 헤드 어텐션의 내부를 너무 모른다" 는 것입니다.
기존 방식의 한계
기존 연구자들은 "이 모델이 번역을 잘하네? 여러 헤드가 각자 잘 협력했겠지!"라고 뭉뚱그려 생각했습니다. 기껏 분석을 해도 수십 개 헤드의 점수를 그냥 평균 내버렸죠.
이는 마치 조별 과제에서 A+를 받았다고 조원 5명 모두가 열심히 했다고 착각하는 것과 같습니다.
이 논문이 해결하려는 3가지 질문
| 질문 | 조별 과제 비유 |
|---|---|
| 48명의 헤드 중 진짜 기여한 에이스는 누구인가? | 밤새워 자료 조사한 조원은 누구인가? |
| 그 에이스는 구체적으로 어떤 역할을 맡았는가? | PPT 담당인가, 발표 담당인가? |
| 무임승차자를 빼버려도 여전히 A+를 받을 수 있는가? | 이름만 올린 조원을 제거해도 결과물이 나오는가? |
이 문제를 해결하면 얻는 것
- 블랙박스였던 AI의 내부 작동 방식을 투명하게 이해할 수 있습니다. (설명 가능성)
- 무임승차자를 제거하여 AI를 훨씬 가볍고 빠르게 만들 수 있습니다. (경량화)
4. Proposed Method / Approach
저자들은 이 문제를 해결하기 위해 '분석'과 '제거'라는 투 트랙(Two-track) 전략을 사용했습니다.
전체 구조: 에이스 찾기 → 역할 분석 → 부드럽게 해고하기
- LRP(역추적) 알고리즘으로 에이스 찾기 — 번역 결과물에서 거꾸로 추적해 올라가며, 어떤 헤드가 가장 큰 수학적 기여를 했는지 점수를 매깁니다.
- 에이스의 특기 파악하기 — 점수가 높은 헤드들이 문장을 볼 때 어디에 집중하는지 분석합니다. 논문은 총 3가지 주특기를 발견했습니다.
- 부드러운 스위치 달아주기 (Hard Concrete) — 모델의 각 헤드에 확률적으로 작동하는 '스위치'를 답니다.
- 벌점 주며 다시 학습시키기 — 켜져 있는 스위치가 많을수록 모델에게 벌점( 페널티)을 주며 학습을 시킵니다. 그러면 모델은 벌점을 안 받으려고 스스로 안 쓰는 헤드의 스위치를 꺼버립니다.
발견된 3가지 엘리트 헤드 유형
| 헤드 유형 | 역할 | 특징 |
|---|---|---|
| 위치 헤드 (Positional) | 바로 인접한 단어 보기 | 90% 이상의 확률로 ±1 위치 단어에 집중 |
| 문법 헤드 (Syntactic) | 주어-동사, 목적어 등 문법 관계 파악 | nsubj, dobj, amod, advmod 관계 탐지 |
| 희귀 단어 헤드 (Rare words) | 문장 내 가장 생소한 단어에 집중 | 1층에 위치, LRP 기여도 압도적 1위 |
핵심 아이디어 직관적 이해 💡
🍲 비유 1: 역추적 기여도 (LRP)
식당에서 엄청 맛있는 찌개가 나왔습니다. 주방장(LRP)이 레시피를 거꾸로 짚어보며 고기 50%, 마늘 30%, 파 20%의 지분으로 맛이 났다는 걸 정확한 숫자로 계산해 내는 것과 같습니다.
💡 비유 2: 부드러운 스위치 (Hard Concrete 완화)
방에 전등이 몇 개 켜졌는지 세서 전기세를 매겨야 합니다. 그런데 컴퓨터는 '켜짐(1)'과 '꺼짐(0)'처럼 계단식으로 확 꺾이는 그래프는 학습을 못 합니다 (미분 불가). 그래서 조광기(다이얼)처럼 "이 전구는 빛이 80% 켜져 있으니 0.8개로 쳐줄게" 라고 부드러운 확률 곡선으로 바꿔준 수학적 꼼수입니다. 덕분에 컴퓨터가 스스로 잉여 헤드의 다이얼을 서서히 줄여 끌 수 있게 되었습니다.
📊 Figure 1: LRP 기여도, Confidence, 헤드 기능 시각화
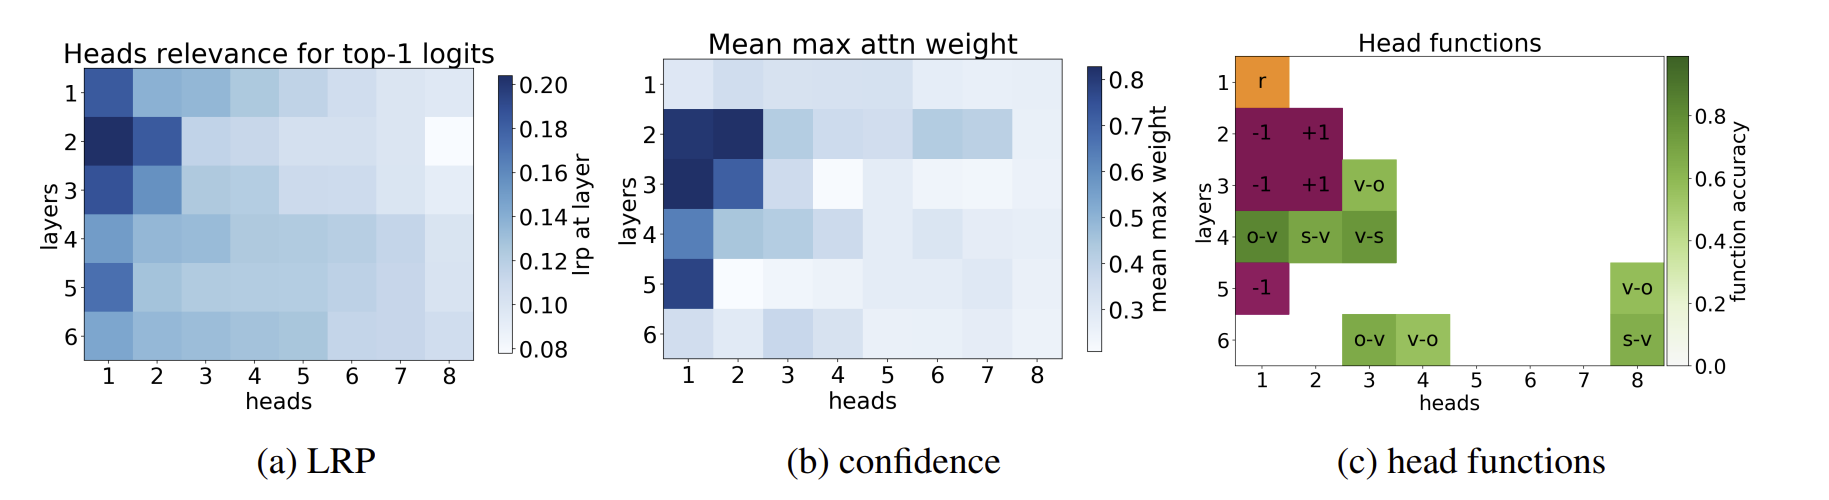
- 이 그림이 보여주는 것: 각 레이어별로 헤드의 LRP 기여도 순위, 확신도(Confidence), 그리고 위치/문법/희귀 단어 등 기능 유형을 색상으로 나타낸 히트맵
- 핵심 메시지: LRP 점수가 높은 헤드와 Confidence가 높은 헤드가 상당 부분 일치하며, 이들은 대부분 위치 헤드(보라색)나 문법 헤드(초록색)에 해당합니다.
내가 이해한 포인트
"중요한 헤드는 자기가 봐야 할 단어를 확신 있게 본다"는 것이 수치로도 증명됩니다. 특히 1층의 희귀 단어 헤드는 LRP 기여도가 압도적인 1위지만 Confidence는 오히려 낮습니다. 어려운 단어를 찾느라 여러 단어를 넓게 훑기 때문입니다. 이 예외 케이스가 모델을 더 입체적으로 이해하게 해줬습니다.
📊 Figure 2 (핵심): 헤드 제거 비율에 따른 BLEU 점수 변화
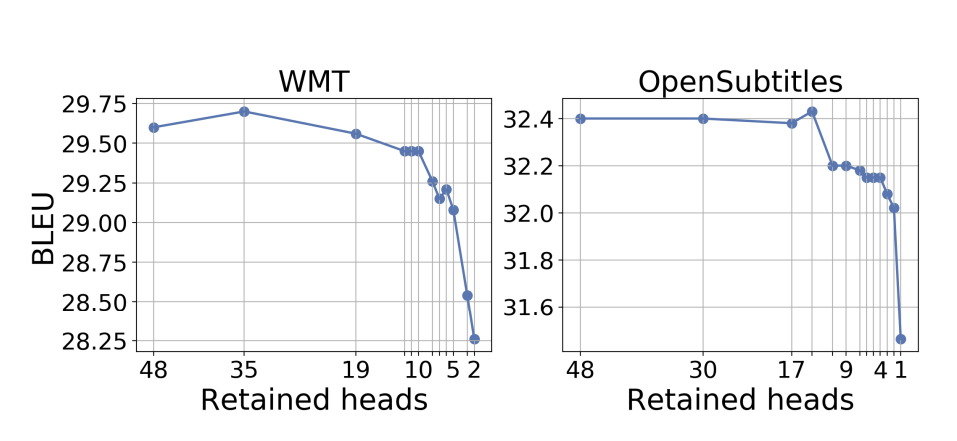
- 이 그림이 보여주는 것: 헤드를 하나씩 제거해 나갈 때 번역 품질(BLEU 스코어)이 어떻게 변하는지 보여주는 핵심 그래프
- 실험 설정: X축은 '남은 인코더 헤드의 수', Y축은 '번역 품질 점수(BLEU)'. EN-RU(영어→러시아어) 기준
- 핵심 메시지: WMT 데이터 기준 48개 중 38개를 제거해도 BLEU 하락이 고작 0.15점이며, OpenSubtitles 데이터에서는 44개를 제거(4개만 남겨도) BLEU 하락이 0.25점에 불과합니다.
내가 이해한 포인트
그래프의 선이 초반에는 평행하게 쭉 유지되다가, 헤드를 80% 이상 쳐내는 극후반부에 가서야 점수가 뚝 떨어집니다. 이는 모델 내부에 잉여 부품이 상상 이상으로 많았다는 결정적 증거입니다. 무거운 트랜스포머 모델을 훨씬 가볍게 만들 수 있다는 실질적인 희망을 보여주는 데이터입니다.
5. Experiments & Results
저자들은 자신들의 가설을 증명하기 위해 치밀한 실험을 설계했습니다.
| 실험 항목 | 내용 |
|---|---|
| 언어 조합 | 영어→러시아어, 영어→독일어, 영어→프랑스어 (3가지 어순 패턴) |
| 데이터 도메인 | WMT(딱딱한 뉴스 기사) + OpenSubtitles(부드러운 영화 자막) |
| 학습 데이터 규모 | 250만 문장 쌍 (언어쌍별 동일하게 통제) |
평가 지표
- LRP 기여도 점수 — 수학적으로 얼마나 기여했는가?
- 문법 정확도 — 헤드가 짚어낸 단어 관계가 실제 언어학적 문법과 얼마나 일치하는가?
- BLEU 스코어 — 최종 번역된 문장이 사람이 보기에 얼마나 자연스러운가?
결과 요약
인코더 헤드의 80%를 제거해도 성능이 그대로 유지되었습니다.
끝까지 살아남은 20%의 에이스 헤드들은 정확히 '인접 단어 보기', '문법 구조 파악', '희귀 단어 집중' 이라는 확실한 자기 전공을 가지고 있었습니다.
또한 디코더에서 인코더를 참조하는 디코더-인코더 어텐션 헤드(번역의 생명줄) 는 자르려고 하면 성능이 확 떨어지며 강하게 저항했습니다. 반대로 인코더 자기 어텐션 헤드가 가장 먼저 제거되었습니다.
6. Discussion
✅ 이 방법의 장점
- 이중 교차 검증의 논리적 완벽함 — 단순히 "얘가 중요하다"라고 관찰하는 데 그치지 않고, "진짜? 그럼 걔 빼고 다 지워볼게. 봐, 진짜 얘네만 일하잖아!"라며 LRP 분석과 실제 가지치기 실험으로 두 번 검증했습니다.
- Fine-tuning 방식의 우월성 — 처음부터 적은 헤드로 학습한 모델보다, 큰 모델을 충분히 학습시킨 후 가지치기한 모델이 항상 더 높은 성능을 보였습니다.
❌ 설계상의 트레이드오프
- 이중 학습 비용 — 모델을 가볍게 만들기 위해 이미 다 학습된 모델에 스위치를 달고 다시 한번 무거운 파인튜닝을 돌려야 합니다. 최종 결과물은 가볍지만 그 과정에서 서버 비용과 시간이 이중으로 드는 딜레마가 있습니다.
- 영어 문법 중심의 한계 — 영어를 기준으로만 분석을 진행했습니다. 한국어나 일본어처럼 어순이 완전히 뒤집히는 SOV 언어에서도 똑같은 엘리트 헤드들이 등장할지는 아직 미지수입니다.
💡 개선 가능한 방향
가지치기를 언어쌍과 도메인에 맞게 동적으로 설정하는 '어댑티브 가지치기' 를 도입한다면, 한국어-영어처럼 어순이 극단적으로 다른 언어쌍에서도 더 정교한 엘리트 헤드 분석이 가능할 것으로 보입니다.
7. My Insights
새롭게 알게 된 점
딥러닝이 아무리 블랙박스라고 해도, 그 안에는 결국 '주어-동사를 찾는 녀석', '제일 어려운 단어를 고민하는 녀석' 처럼 인간의 언어 처리 방식과 놀랍도록 닮은 특화된 요원들이 존재한다는 사실이 소름 돋게 신기했습니다.
기존 생각이 바뀐 부분
왜 미분 불가능한 꺾인 선을 부드러운 확률 곡선(Hard Concrete)으로 펴줘야 하는지, 그 수학적 꼼수의 필요성을 완벽히 이해했습니다.
컴퓨터에게 "너 해고야!"라고 갑자기 통보하는 게 아니라 "너 성과가 안 좋으니 월급을 10%씩 줄일 거야"라고 서서히 압박해서 스스로 나가게 만드는 과정이 핵심이었습니다.
어디에 응용할 수 있을까?
이 기법은 번역기뿐만 아니라, 거대한 생성형 AI(LLM)를 스마트폰에 욱여넣기 위한 '온디바이스 AI(On-device AI)' 최적화 기술에 핵심 아이디어로 쓰일 수 있겠다고 생각했습니다. 어떤 헤드가 진짜 일하는지 먼저 파악하고 나서 모델을 설계한다면, 처음부터 훨씬 효율적인 경량 아키텍처를 만들 수 있을 것입니다.
8. Summary
| 항목 | 내용 |
|---|---|
| 핵심 문제 | 다중 헤드 어텐션에서 진짜 번역에 기여하는 헤드는 누구이고, 안 쓰는 헤드는 어떻게 안전하게 잘라낼 수 있는가? |
| 해결 방법 | LRP 알고리즘으로 에이스를 찾고, Hard Concrete 분포 기반 완화 스위치로 잉여 헤드가 스스로 꺼지도록 유도 |
| 핵심 기여 | 전체 48개 헤드의 약 20%(10개)만 위치·문법·희귀 단어를 전담하는 엘리트이며, 나머지 80%(38개)를 제거해도 BLEU 하락 0.15점에 불과함을 증명 |
| 가장 인상 깊었던 점 | 가설(얘가 에이스다)을 세우고, 물리적 실험(얘네 빼고 다 지워봄)으로 완벽하게 입증한 LRP 분석 + 가지치기 이중 교차 검증 구조 |
| 아쉬운 점 | 영어 중심의 분석으로, 한국어·일본어 등 어순이 극단적으로 다른 언어에서도 같은 결과가 나올지 검증되지 않음 |
| 확장 방향 | 온디바이스 AI 경량화, LLM 구조 설계 최적화, 그리고 하드웨어 단의 실질적 연산 속도 향상에 대한 추가 연구 |
🧠 이 논문을 한 문장으로 말하면?
트랜스포머의 48개 헤드 중 80%는 무임승차자였으며, LRP로 에이스를 찾아내고 Hard Concrete로 잡연을 해고하는 이중 전략으로 AI 내부의 블랙박스를 걷어낸 혁신적인 분석 연구다.
