좋은 아침입니다.
Continuous Batching은 GPU의 빈자리를 계속 새로운 요청으로 채워 여러 요청을 효율적으로 처리하는 방법이었습니다.
하지만 Batch를 효율적으로 구성하더라도 LLM이 토큰을 하나씩 순차적으로 생성한다는 문제는 그대로 남아 있습니다.
큰 모델은 새로운 토큰을 생성할 때마다 반복적으로 연산해야 하며, 이 과정은 LLM의 추론 속도를 느리게 만듭니다.
이번 글에서는 작은 모델이 여러 토큰을 먼저 생성하고, 큰 모델이 이를 검증하여 추론 속도를 높이는 Speculative Decoding에 대해 알아보겠습니다.
Autoregressive Decoding의 문제점
LLM은 이전에 생성된 토큰을 바탕으로 다음 토큰을 하나씩 생성합니다.
이를 Autoregressive Decoding이라고 합니다.
1. 입력 문장 처리

2. 다음 토큰 1개 생성

3. 생성된 토큰을 입력에 추가

4. 다음 토큰 1개 생성

5. 문장이 끝날 때까지 반복
예를 들어 다음 문장을 생성한다고 가정하겠습니다.
오늘

오늘 날씨는

오늘 날씨는 정말

오늘 날씨는 정말 좋습니다
각 토큰은 이전 토큰이 생성된 후에야 생성할 수 있습니다.
따라서 여러 토큰을 완전히 동시에 생성하기 어렵고 토큰마다 큰 모델의 연산을 반복해야 합니다.
토큰 1개 생성
-> Target Model 1회 실행

토큰 5개 생성
-> Target Model 5회 실행
모델이 클수록 한 번의 연산에 필요한 시간도 증가하기 때문에 이러한 순차적인 생성 과정은 추론 속도를 저하시키는 원인이 됩니다.
Speculative Decoding
Speculative Decoding은 작은 모델이 여러 개의 토큰 후보를 먼저 생성하고, 큰 모델이 후보들을 한 번에 검증하는 방법입니다.
이때 작은 모델을 Draft Model, 큰 모델을 Target Model이라고 합니다.
Draft Model
-> 여러 토큰 후보 생성


Target Model
-> 후보 토큰들을 검증
Draft Model은 크기가 작기 때문에 Target Model보다 빠르게 토큰을 생성할 수 있습니다.
Target Model은 Draft Model이 생성한 후보를 확인하고, 사용할 수 있는 토큰은 최종 결과에 추가합니다.
이를 통해 Target Model을 토큰마다 실행하는 대신, 한 번의 실행으로 여러 후보 토큰을 검증할 수 있습니다.
Speculative Decoding은 Target Model의 출력 분포를 유지하면서 여러 토큰을 병렬로 검증하여 Autoregressive Decoding을 가속하는 방법으로 제안되었습니다.
Draft Model과 Target Model
Draft Model
Draft Model은 여러 개의 토큰 후보를 빠르게 생성하는 작은 모델입니다.
Target Model보다 정확도는 낮을 수 있지만, 크기가 작기 때문에 토큰을 빠르게 생성할 수 있습니다.
입력

-> Draft Model

-> 후보 토큰 여러 개 생성
Draft Model의 역할은 최종 답변을 결정하는 것이 아닙니다.
Target Model이 선택할 가능성이 높은 토큰을 미리 제안하는 역할을 합니다.
Target Model
Target Model은 실제로 사용하려는 큰 언어 모델입니다.
Draft Model이 생성한 토큰 후보가 Target Model의 예측과 일치하는지 검증합니다.
Draft Model의 후보 토큰

-> Target Model로 검증

→-> 승인 또는 거절
최종 출력은 Target Model을 기준으로 결정됩니다.
따라서 Draft Model의 예측이 잘못되더라도 그대로 최종 결과에 사용되지는 않습니다.
Speculative Decoding의 동작 방식
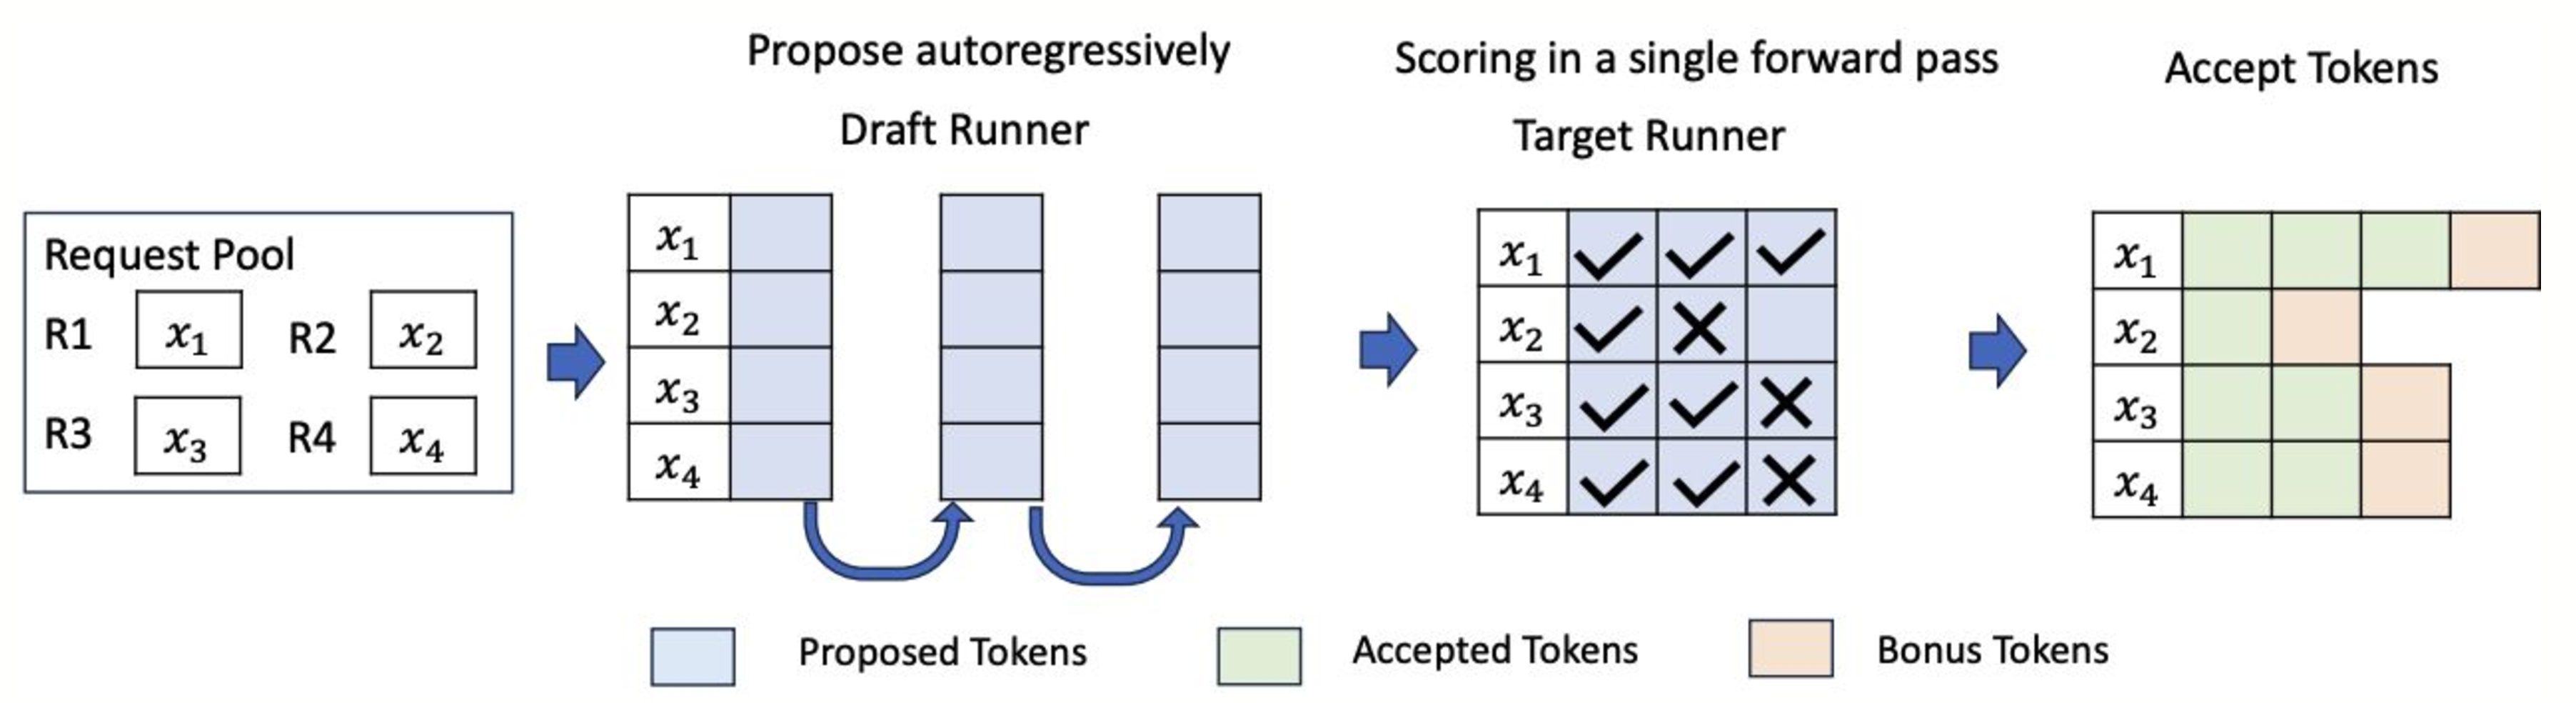
먼저 Draft Model이 현재 입력을 바탕으로 여러 개의 토큰 후보를 생성합니다.
입력 문장 : 오늘 날씨는

Draft Model의 후보:
정말 -> 좋을 -> 것 -> 같습니다
이후 Target Model은 입력 문장과 후보 토큰을 함께 전달받아 각 위치의 토큰을 검증합니다.
1. Draft Model이 후보 토큰 생성

2. 후보 토큰을 Target Model에 전달

3. Target Model이 각 토큰 검증

4. 승인된 토큰을 최종 결과에 추가

5. 거절된 토큰 이후의 후보는 제거

6. 다시 후보 토큰 생성
예를 들어 Target Model의 검증 결과가 다음과 같다고 가정하겠습니다.
정말 -> 승인

좋을 -> 승인

것 -> 거절

같습니다 -> 제거
처음 두 토큰은 Target Model의 예측과 일치하므로 최종 결과에 추가됩니다.
하지만 세 번째 토큰이 거절되면 그 이후의 후보도 제거됩니다.
뒤의 토큰은 거절된 토큰을 기준으로 생성되었기 때문입니다.
최종 승인

오늘 날씨는 정말 좋을
이후 Target Model의 결과를 바탕으로 다시 Draft Model이 새로운 후보를 생성합니다.
Hugging Face에서는 이러한 방식을 Assisted Decoding이라고 하며, 작은 Assistant Model이 후보를 생성하고 Main Model이 한 번에 검증하는 방식으로 설명합니다.
토큰 검증
Draft Model이 생성한 모든 토큰을 그대로 사용하면 Target Model과 다른 결과가 생성될 수 있습니다.
따라서 Speculative Decoding에서는 Target Model이 후보 토큰을 검증합니다.
Greedy Decoding에서는 Draft Model이 선택한 토큰과 Target Model이 선택한 토큰을 비교할 수 있습니다.
Draft Model: 정말

Target Model: 정말

-> 승인
두 모델이 다른 토큰을 선택하면 해당 후보는 거절됩니다.
Draft Model: 매우

Target Model: 정말

-> 거절
Sampling을 사용하는 경우에는 단순히 두 토큰이 같은지만 확인하지 않고, Draft Model과 Target Model의 확률을 이용한 승인 규칙을 사용합니다.
이를 통해 Speculative Decoding은 단순한 근사 방법이 아니라 Target Model의 출력 분포를 유지할 수 있습니다.
Speculative Decoding이 빨라지는 이유
기존 방식에서는 Target Model이 토큰을 하나씩 생성합니다.
[기존 Decoding]

Target Model 실행
-> 토큰 1개 생성

Target Model 실행
-> 토큰 1개 생성

Target Model 실행
-> 토큰 1개 생성
Speculative Decoding에서는 Draft Model이 여러 개의 후보를 빠르게 생성하고, Target Model이 후보들을 한 번에 검증합니다.
Speculative Decoding

Draft Model
-> 후보 토큰 여러 개 생성

Target Model
-> 후보 토큰들을 한 번에 검증
Draft Model이 생성한 후보가 많이 승인되면 Target Model을 한 번 실행하여 여러 토큰을 최종 결과에 추가할 수 있습니다.
Target Model 1회 실행

-> 토큰 3개 승인

-> 최종 결과에 토큰 3개 추가
따라서 비싼 Target Model의 실행 횟수를 줄일 수 있습니다.
다만 속도 향상 정도는 Draft Model이 생성한 후보가 얼마나 많이 승인되는지에 따라 달라집니다.
Acceptance Rate
Acceptance Rate는 Draft Model이 생성한 후보 중 Target Model에 의해 승인된 토큰의 비율을 의미합니다.
후보 토큰 4개 생성

승인된 토큰 3개

Acceptance Rate = 75%
Acceptance Rate가 높으면 한 번의 Target Model 실행으로 여러 토큰을 추가할 수 있습니다.
Acceptance Rate가 높을 때
Draft Model과 Target Model의 예측이 비슷합니다.
한 번에 승인되는 토큰이 많아지기 때문에 Target Model의 실행 횟수를 줄일 수 있습니다.
따라서 Speculative Decoding의 속도 향상도 커질 수 있습니다.
Acceptance Rate가 낮을 때
Draft Model의 후보가 자주 거절됩니다.
Draft Model이 후보를 생성하는 비용은 발생하지만 실제로 사용되는 토큰은 적어집니다.
따라서 Speculative Decoding의 효과가 작아지거나, 경우에 따라 추가 비용이 발생할 수 있습니다.
Speculative Decoding의 장단점
장점
Speculative Decoding은 작은 Draft Model을 사용하여 여러 토큰 후보를 빠르게 생성합니다.
Target Model은 후보 토큰들을 한 번에 검증할 수 있기 때문에 비싼 Target Model의 반복 실행 횟수를 줄일 수 있습니다.
Acceptance Rate가 높으면 한 번의 검증으로 여러 토큰을 최종 결과에 추가할 수 있습니다.
또한 적절한 승인 및 보정 과정을 사용하면 기존 Target Model의 출력 분포를 유지할 수 있습니다.
모델을 다시 학습하지 않고도 적용할 수 있는 방식이 존재한다는 장점도 있습니다.
단점
Draft Model을 추가로 실행해야 하므로 항상 속도가 빨라지는 것은 아닙니다.
Draft Model이 너무 크면 후보 토큰을 생성하는 데 많은 시간이 필요합니다.
반대로 Draft Model의 성능이 너무 낮으면 후보 토큰이 자주 거절되어 Acceptance Rate가 낮아질 수 있습니다.
또한 Target Model과 함께 Draft Model도 메모리에 올려야 하므로 추가적인 GPU 메모리가 필요할 수 있습니다.
실제 속도 향상은 모델의 크기, Draft Model과 Target Model의 조합, 하드웨어와 요청 형태에 따라 달라질 수 있습니다.
요약
이번 글에서는 Speculative Decoding에 대해 알아보았습니다.
핵심 내용을 정리하면 다음과 같습니다.
-
Autoregressive Decoding은 이전 토큰을 바탕으로 다음 토큰을 하나씩 생성합니다.
-
토큰을 생성할 때마다 큰 Target Model을 반복해서 실행해야 합니다.
-
Speculative Decoding은 작은 Draft Model과 큰 Target Model을 함께 사용하는 방법입니다.
-
Draft Model은 여러 개의 토큰 후보를 빠르게 생성합니다.
-
Target Model은 Draft Model이 생성한 후보 토큰들을 한 번에 검증합니다.
-
승인된 후보 토큰은 최종 결과에 추가됩니다.
-
특정 토큰이 거절되면 해당 토큰 이후에 생성된 후보도 제거됩니다.
-
Acceptance Rate는 Draft Model의 후보가 Target Model에 의해 승인되는 비율입니다.
-
Acceptance Rate가 높을수록 한 번에 추가되는 토큰이 많아져 속도 향상도 커질 수 있습니다.
-
Draft Model이 너무 크거나 Acceptance Rate가 낮으면 속도 향상 효과가 줄어들 수 있습니다.
-
Speculative Decoding은 적절한 검증 과정을 통해 Target Model의 출력 분포를 유지할 수 있습니다.
-
Continuous Batching은 여러 요청의 처리를 최적화하고, Speculative Decoding은 하나의 요청에서 토큰 생성을 최적화합니다.
다음 글에서는 지금까지 알아본 추론 최적화 기술을 실제 서비스에서 사용하는 LLM Serving에 대해 알아보겠습니다.
LLM Serving은 모델을 서버에 배포하고, 여러 사용자의 요청을 효율적으로 처리하여 생성된 결과를 전달하는 과정입니다.
부족한 글 읽어주셔서 감사합니다.
틀린 내용이나 피드백은 댓글로 남겨주시면 감사하겠습니다.
감사합니다.