좋은 아침입니다.
Vector Database에는 문서의 Embedding Vector와 원본 Chunk가 저장되어 있습니다.
사용자의 질문이 들어오면 저장된 문서 중 질문과 관련된 문서를 찾아 LLM에 전달해야 합니다.
하지만 처음 검색된 문서의 순서가 항상 질문에 답하기 좋은 순서인 것은 아닙니다.
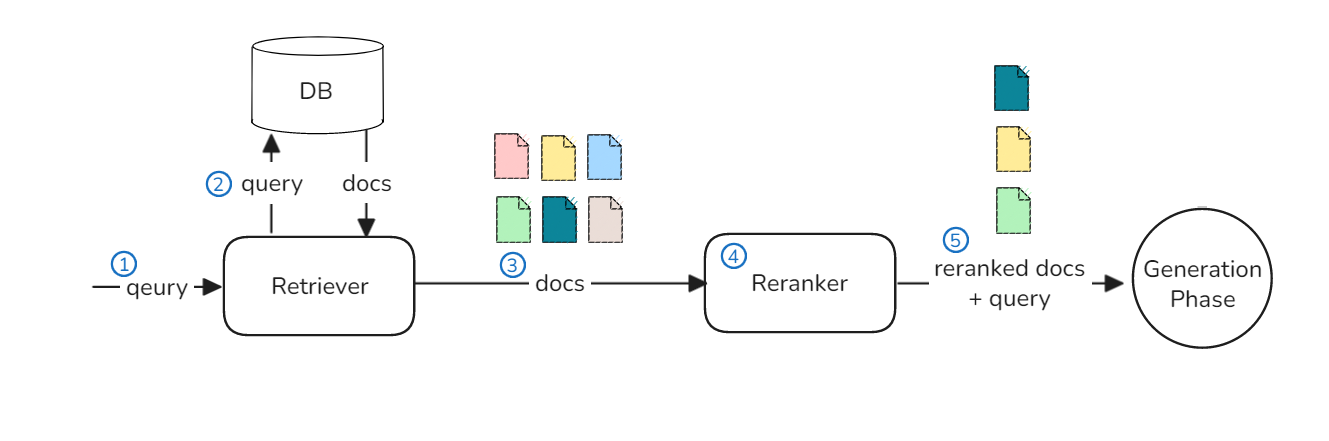
이번 글에서는 관련 문서를 검색하는 Retriever와 검색된 문서의 순서를 다시 정렬하는 Reranker에 대해 알아보겠습니다.
Retriever
Retriever는 사용자의 질문과 관련된 문서를 검색하는 구성 요소입니다.
Retriever는 답변을 직접 생성하지 않고, LLM이 답변을 생성할 때 참고할 문서를 가져옵니다.
예를 들어 사용자가 다음과 같이 질문했다고 가정하겠습니다.
"연차를 사용하려면 어떤 절차가 필요한가요?"Retriever는 저장된 문서에서 질문과 관련된 문서를 검색합니다.
검색된 문서

1. 연차 신청 방법

2. 연차 승인 절차

3. 연차 사용 가능 기간
이처럼 Retriever는 많은 문서에서 답변에 필요한 문서 후보를 빠르게 찾는 역할을 합니다.
Dense Retriever에서는 질문과 문서를 각각 Vector로 변환하고, 두 Vector의 유사도를 이용해 관련 문서를 검색할 수 있습니다.
Retriever의 동작 방식
Retriever의 동작 과정은 다음과 같습니다.
1. 사용자의 질문 입력

2. 질문을 검색 가능한 형태로 변환

3. 저장된 문서 검색

4. 관련성이 높은 문서 후보 선택

5. 원본 Chunk와 Metadata 반환
Retriever는 Vector Search만 사용하는 것은 아닙니다.
Keyword Search, Vector Search 또는 두 방법을 함께 사용하여 문서를 검색할 수 있습니다.
이번 글에서는 Embedding Vector를 이용하는 Dense Retriever를 기준으로 알아보겠습니다.
Bi-Encoder
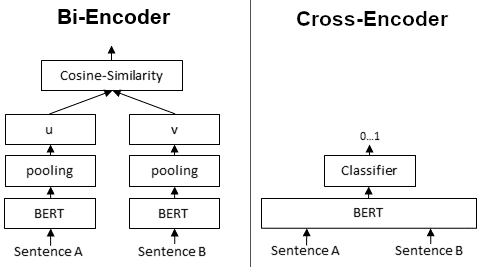
Dense Retriever에서는 일반적으로 Bi-Encoder 구조를 사용할 수 있습니다.
Bi-Encoder는 질문과 문서를 서로 독립적으로 처리합니다.
질문 Vector와 문서 Vector가 만들어지면 두 Vector의 유사도를 계산합니다.
질문 Vector + 문서 Vector -> 유사도 검색 문서 Vector는 미리 생성하여 저장할 수 있습니다.
사용자의 질문이 들어오면 질문 Vector만 새롭게 생성한 뒤 저장된 문서 Vector와 비교하면 됩니다.
따라서 많은 문서에서도 비교적 빠르게 검색할 수 있습니다.
Dense Passage Retrieval에서도 질문과 문서를 각각 인코딩하는 Dual-Encoder 구조를 사용하여 관련 Passage를 검색했습니다.
Retriever의 한계
Retriever는 많은 문서에서 관련성이 높은 후보를 빠르게 찾을 수 있습니다.
하지만 질문과 문서를 각각 하나의 Vector로 표현하기 때문에 두 문장 사이의 세부적인 관계를 충분히 확인하지 못할 수 있습니다.
예를 들어 다음과 같은 문서가 검색되었다고 가정하겠습니다.
질문 :  "연차 신청 후 누구의 승인을 받아야 하나요?"


문서 A : "연차는 사내 시스템에서 신청합니다."


문서 B : "연차는 팀장의 승인을 받은 후 사용할 수 있습니다."


문서 C : "연차 신청 내역은 사내 시스템에서 확인할 수 있습니다."
세 문서 모두 연차와 관련되어 있습니다.
하지만 질문에 직접 답할 수 있는 문서는 문서 B입니다.
Retriever의 검색 결과에서는 문서 A나 문서 C가 더 높은 순서에 위치할 수도 있습니다.
의미적으로 비슷한 문서를 찾는 것과 질문에 직접 답할 수 있는 문서를 찾는 것은 완전히 같지 않습니다.
이러한 검색 결과의 순서를 다시 판단하기 위해 Reranker를 사용할 수 있습니다.
Reranker
Retriever는 많은 문서 중에서 질문과 관련된 문서 후보를 빠르게 검색합니다.
하지만 검색된 문서의 순서가 항상 질문에 답하기 적합한 순서인 것은 아닙니다.
Reranker는 Retriever가 가져온 각 문서를 질문과 다시 비교하여 관련성 점수를 계산하고, 점수가 높은 순서대로 문서를 재정렬합니다.
Retriever가 검색한 문서 :
1. 문서 A
2. 문서 B
3. 문서 C

    ↓

Reranker가 질문과 각 문서를 다시 평가

    ↓

재정렬된 문서 :
1. 문서 B
2. 문서 A
3. 문서 C
Retriever가 전체 문서에서 후보를 빠르게 좁힌다면, Reranker는 선택된 후보만 더 자세히 평가합니다.
이를 통해 모든 문서를 정밀하게 비교하는 비용은 줄이면서, LLM에 질문과 더 관련된 문서를 전달할 수 있습니다.
이처럼 Retriever로 문서 후보를 검색한 뒤 Reranker로 순서를 다시 정렬하는 방식을 Retrieve & Re-Rank라고 합니다.
Cross-Encoder
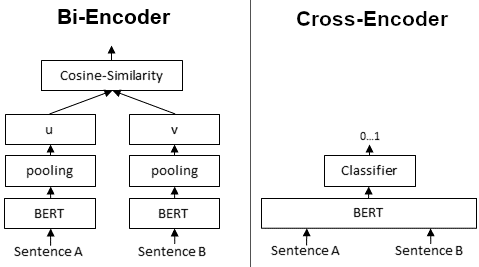
Reranker에는 Cross-Encoder가 주로 사용됩니다.
Cross-Encoder는 질문과 문서를 따로 처리하지 않고 하나의 입력으로 함께 처리합니다.
질문 + 문서 -> Cross-Encoder -> 관련성 점수예를 들어 질문과 각 문서를 다음과 같이 함께 입력합니다.
[입력 1]
질문: 연차 신청 후 누구의 승인을 받아야 하나요?
문서: 연차는 사내 시스템에서 신청합니다.


[입력 2]
질문: 연차 신청 후 누구의 승인을 받아야 하나요?
문서: 연차는 팀장의 승인을 받은 후 사용할 수 있습니다.
Cross-Encoder는 질문과 문서의 단어들이 서로 어떤 관계를 가지는지 함께 확인한 뒤 관련성 점수를 출력합니다.
문서 A: 0.63
문서 B: 0.94
문서 C: 0.58
이 점수를 기준으로 문서의 순서를 다시 정렬합니다.
Cross-Encoder는 질문과 문서를 동시에 입력받아 관련성 점수를 계산하기 때문에 Bi-Encoder보다 세부적인 관계를 확인할 수 있습니다. 하지만 모든 질문과 문서 조합을 각각 계산해야 하므로 많은 문서 전체를 검색하는 용도로는 느릴 수 있습니다.
Retriever와 Reranker의 동작 과정
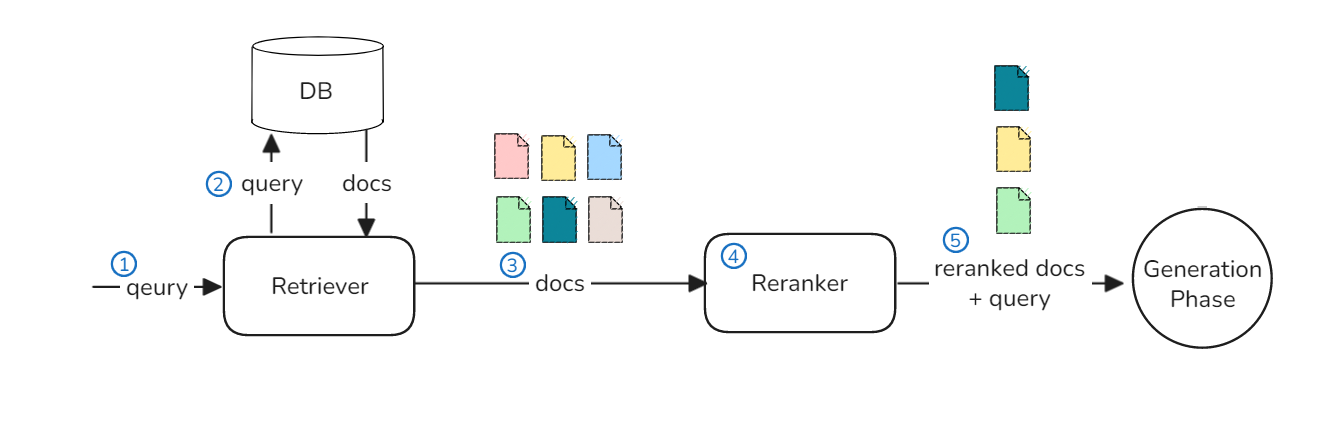
Retriever와 Reranker를 함께 사용하는 과정은 다음과 같습니다.
1. 사용자의 질문 입력

2. Retriever가 관련 문서 후보 검색

3. 질문과 각 후보 문서를 Reranker에 입력

4. Reranker가 관련성 점수 계산

5. 점수를 기준으로 문서 순서 재정렬

6. 상위 문서를 LLM에 전달

7. LLM이 검색된 문서를 바탕으로 답변 생성
예를 들어 Retriever가 20개의 문서 후보를 검색할 수 있습니다.
Reranker는 20개의 문서를 다시 평가한 뒤, 가장 관련성이 높은 3개의 문서를 LLM에 전달합니다.
1. 전체 문서

2. Retriever

3. 후보 문서 20개

4. Reranker

5. 최종 문서 3개

6. LLM
Retriever는 검색 속도를 담당하고, Reranker는 최종 검색 결과의 정확도를 높이는 역할을 합니다.
Retriever & Reranker의 장단점
장점
Retriever를 사용하면 많은 문서에서 관련된 후보를 빠르게 검색할 수 있습니다.
Reranker는 검색된 후보를 질문과 함께 자세히 분석하여 문서의 순서를 개선할 수 있습니다.
질문과 관련성이 낮은 문서가 LLM에 전달되는 것을 줄이는 데 도움이 됩니다.
검색 속도가 빠른 Retriever와 비교적 정확한 Reranker를 함께 사용하여 속도와 검색 품질을 모두 고려할 수 있습니다.
단점
Reranker는 질문과 각 문서 후보를 하나씩 함께 처리해야 합니다.
따라서 Reranker에 전달하는 후보 문서가 많아지면 연산량과 응답 시간이 증가합니다.
또한 Reranker는 Retriever가 검색한 문서만 다시 정렬할 수 있습니다.
Retriever가 필요한 문서를 검색하지 못함

        ↓

Reranker의 후보에도 포함되지 않음

        ↓

Reranker가 복구할 수 없음
따라서 최종 검색 품질을 높이려면 Retriever가 필요한 문서를 후보에 포함하는 것이 먼저 중요합니다.
요약
이번 글에서는 Retriever와 Reranker에 대해 알아보았습니다.
핵심 내용을 정리하면 다음과 같습니다.
-
Retriever는 사용자의 질문과 관련된 문서 후보를 검색합니다.
-
Dense Retriever는 질문과 문서를 Vector로 변환하여 유사한 문서를 찾습니다.
-
Bi-Encoder는 질문과 문서를 독립적으로 처리하여 많은 문서를 빠르게 검색할 수 있습니다.
-
Reranker는 Retriever가 검색한 문서를 다시 평가하고 관련성이 높은 순서로 정렬합니다.
-
Cross-Encoder는 질문과 문서를 함께 처리하여 관련성 점수를 계산합니다.
-
Retriever는 후보를 빠르게 찾고, Reranker는 검색 결과의 품질을 높입니다.
-
Reranker는 Retriever가 검색하지 못한 문서를 새롭게 찾을 수 없습니다.
다음 글에서는 Keyword Search와 Vector Search를 함께 사용하는 Hybrid Search에 대해 알아보겠습니다.
Hybrid Search는 단어의 정확한 일치를 잘 찾는 Keyword Search와 문장의 의미를 기준으로 검색하는 Vector Search를 결합하는 방법입니다.
부족한 글 읽어주셔서 감사합니다.
틀린 내용이나 피드백은 댓글로 남겨주시면 감사하겠습니다.
감사합니다.