좋은 아침입니다.
Advanced RAG는 Query를 수정하거나 검색 결과를 가공하는 방법을 추가하여 RAG의 검색 품질을 높였습니다.
하지만 대부분의 과정은 개발자가 미리 정한 순서에 따라 동작합니다.
이번 글에서는 LLM이 상황을 판단하여 검색 여부와 사용할 도구, 다음 행동을 결정하는 Agentic RAG에 대해 알아보겠습니다.
Agentic RAG
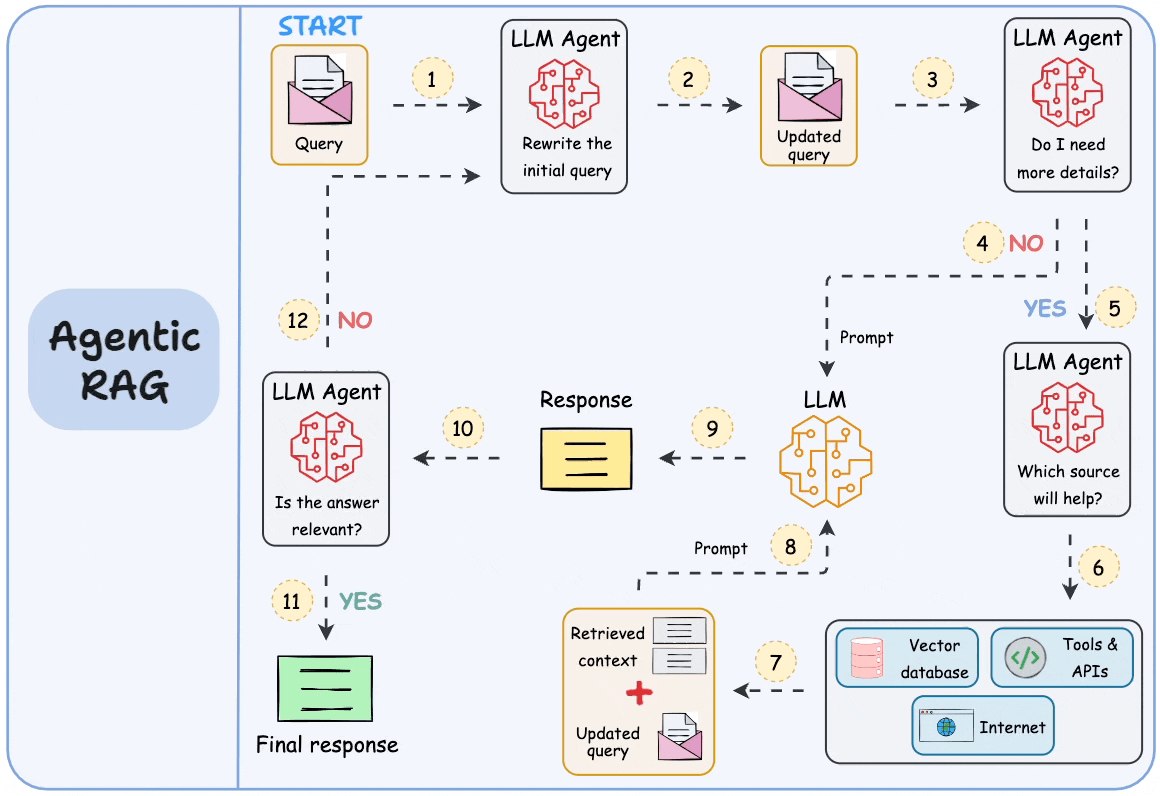
Agentic RAG는 RAG에 AI Agent의 개념을 결합한 방식입니다.
기존처럼 항상 정해진 순서로 검색하고 답변을 생성하는 것이 아니라, LLM이 현재 상황을 판단하여 필요한 행동을 선택합니다.
사용자 질문

↓

Agent가 상황 판단

↓

검색이 필요한가?
어떤 검색 도구를 사용할까?
검색 결과가 충분한가?
추가 검색이 필요한가?

↓

답변 생성
여기서 Agent는 LLM을 중심으로 현재 상태를 판단하고 사용할 도구와 다음 행동을 결정하는 역할을 합니다.
Agentic RAG의 핵심은 검색이 하나의 고정된 단계가 아니라 Agent가 선택할 수 있는 행동이 된다는 것입니다.
검색 여부 판단
모든 질문에 외부 검색이 필요한 것은 아닙니다.
예를 들어 다음과 같은 질문이 있다고 가정하겠습니다.
"Python에서 List와 Tuple의 차이가 뭐야?"모델이 이미 충분히 알고 있는 내용이라면 바로 답변을 생성할 수 있습니다.
반대로 다음과 같은 질문은 외부 정보가 필요할 수 있습니다.
"우리 회사의 올해 연차 규정이 어떻게 변경됐어?"Agent는 질문을 확인한 뒤 검색이 필요한지 판단할 수 있습니다.
사용자 질문

 ↓

검색 필요 여부 판단 :
  - 필요 없음 -> 바로 답변
  - 필요함 -> 문서 검색
Self-RAG에서는 모든 질문에서 무조건 문서를 검색하는 대신 필요한 경우에 검색을 수행하고, 검색된 정보와 생성된 답변을 스스로 평가하는 방식을 제안했습니다.
Tool 선택
Agentic RAG에서는 하나의 검색 방법만 사용할 필요가 없습니다.
Agent에게 여러 Tool을 제공하고 질문에 따라 적절한 Tool을 선택하도록 할 수 있습니다.
사용 가능한 Tool :
- Vector Database
- Keyword Search
- Web Search
- SQL Database
- API
예를 들어 다음과 같이 동작할 수 있습니다.
"사내 연차 규정을 알려줘"
→ Vector Database 검색


"오늘 환율을 알려줘"
→ 외부 API 사용


"사용자 ID가 10인 회원의 주문을 알려줘"
→ SQL Database 조회
질문의 종류에 따라 서로 다른 데이터 소스를 사용할 수 있다는 것이 Agentic RAG의 특징입니다.
Agent Framework에서는 이러한 모델과 Tool을 연결하여 여러 단계의 작업 흐름을 구성할 수 있습니다. 예를 들어 LangGraph는 상태를 유지하면서 Agent의 여러 행동을 연결할 수 있는 오케스트레이션 구조를 제공합니다.
반복 검색
한 번의 검색으로 필요한 정보를 얻지 못할 수도 있습니다.
기본적인 RAG에서는 검색된 문서를 그대로 사용하여 답변을 생성하는 경우가 많습니다.
Agentic RAG에서는 검색 결과가 부족하다고 판단하면 다시 검색할 수 있습니다.
1. 질문 분석

2. 문서 검색

3. 검색 결과 확인

4. 정보가 부족한지 판단

5. Query 수정

6. 다시 검색

7. 충분한 정보가 모이면 답변 생성
예를 들어 다음 질문을 살펴보겠습니다.
"2025년과 2026년 연차 규정에서
달라진 부분을 알려줘."
Agent는 먼저 2025년 규정을 검색할 수 있습니다.
이후 2026년 규정이 필요하다고 판단하면 추가 검색을 수행합니다.
2025년 연차 규정 검색

        ↓

추가 정보 필요

        ↓

2026년 연차 규정 검색

        ↓

두 문서 비교

        ↓

답변 생성
따라서 하나의 복잡한 질문을 여러 단계로 나누어 필요한 정보를 차례대로 수집할 수 있습니다.
검색 결과 평가
검색된 문서라고 해서 항상 질문에 도움이 되는 것은 아닙니다.
Agent는 검색된 문서가 실제로 질문과 관련되어 있는지 평가할 수 있습니다.
검색된 문서

 ↓

관련성 평가
 - 충분함 -> 답변 생성
 - 부족함 -> 다시 검색
예를 들어 질문과 관계없는 문서가 검색되었다면 Query를 수정하거나 다른 검색 도구를 사용할 수 있습니다.
CRAG는 검색된 문서의 품질을 평가한 뒤 결과가 충분하지 않을 경우 다른 검색 행동을 수행하도록 설계되었습니다.
이처럼 Agentic RAG에서는 검색 자체뿐만 아니라 검색 결과가 답변에 사용할 만큼 좋은지 판단하는 과정도 중요합니다.
Agentic RAG의 동작 방식

Agentic RAG는 하나의 고정된 구조를 가지는 것은 아닙니다.
예를 들어 다음과 같이 구성할 수 있습니다.
1. 사용자 질문 입력

2. Agent가 질문 분석

3. 검색 필요 여부 판단

4. 필요한 Tool 선택

5. 문서 검색

6. 검색 결과 평가

7. 정보가 부족하면 Query 수정 후 다시 검색

8. 충분한 정보를 확보하면 답변 생성
중요한 점은 각 단계가 반드시 한 번씩 실행되는 것이 아니라는 점입니다.
상황에 따라 일부 단계를 건너뛰거나 같은 단계를 여러 번 반복할 수 있습니다.
질문

 ↓

판단

 ↓

검색

 ↓

평가
 │
 ├── 부족함 → 다시 검색
 │
 └── 충분함 → 답변 생성
이러한 구조를 통해 질문에 따라 동적으로 RAG Pipeline을 구성할 수 있습니다.
Agentic RAG의 장단점
장점
Agent가 검색이 필요한지 판단하기 때문에 불필요한 검색을 줄일 수 있습니다.
질문에 따라 Vector Database, Web Search와 API 등 여러 Tool을 선택하여 사용할 수 있습니다.
검색 결과가 부족하면 Query를 수정하거나 추가 검색을 수행할 수 있습니다.
복잡한 질문을 여러 단계로 나누어 처리할 수 있기 때문에 단순한 RAG보다 유연한 Pipeline을 구성할 수 있습니다.
단점
Agent가 여러 번 판단하고 검색하기 때문에 일반적인 RAG보다 구조가 복잡합니다.
검색과 LLM 호출이 반복되면 응답 시간과 비용이 증가할 수 있습니다.
Agent가 잘못된 Tool을 선택하거나 불필요한 검색을 반복할 수도 있습니다.
따라서 Agent에게 어떤 Tool을 제공하고 어떤 기준으로 행동하도록 할 것인지 설계하는 것이 중요합니다.
요약
이번 글에서는 Agentic RAG에 대해 알아보았습니다.
핵심 내용을 정리하면 다음과 같습니다.
-
Agentic RAG는 RAG에 AI Agent를 결합한 방식입니다.
-
Agent는 상황에 따라 검색이 필요한지 판단하고, 필요한 Tool을 선택합니다.
-
검색 결과가 부족하면 Query를 수정하여 다시 검색할 수 있습니다.
-
검색 결과를 평가하며 검색과 판단 과정을 반복할 수 있습니다.
-
복잡한 질문에 유연하게 대응할 수 있지만, 비용과 응답 시간이 증가할 수 있습니다.
이번 글을 마지막으로 RAG 시리즈를 마무리하겠습니다.
지금까지 RAG의 기본 구조부터 Embedding, Similarity Search, Chunking, Vector Database, Retriever와 Reranker, Hybrid Search, Advanced RAG와 Agentic RAG까지 알아보았습니다.
다음글에는 무엇을 적을지 고민이네요. 아마도 복습할겸 전반적인 흐름을 한 번 정리하고.... 요즘 재밌어보이는 diffusion LLM 도 글을 적어보고 싶네요