해당 게시글은 LG Aimers Phase1의 수업 내용을 정리한 글로, 모든 내용의 출처는 https://www.lgaimers.ai/ 입니다.
순환신경망 기반의 시계열 데이터 회귀
-
Data의 순서에 따른 특징
-
순서가 없을 경우 : Non-Sequential Data
- 시간 정보를 포함하지 않고 생성되는 데이터 (N(관측치 수)*D(변수의 개수))
- 구조

-
순서가 있을 경우 : Sequential Data
-
시간 정보 포함하여 생성되는 데이터 (NT(측정 시점 수)D) ~ tensor
-
관측치 하나에 대해 하나의 행렬 나오게 됨
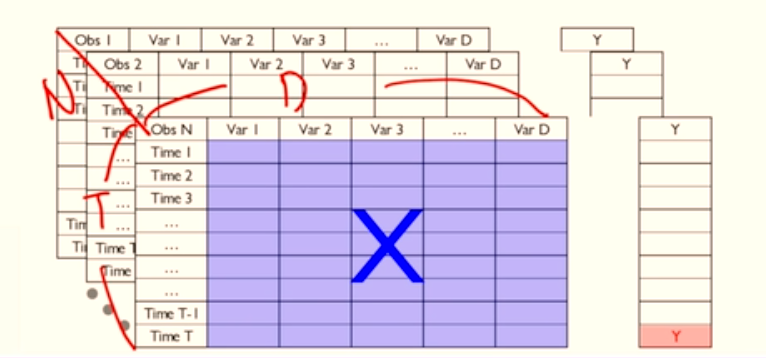
-
구조
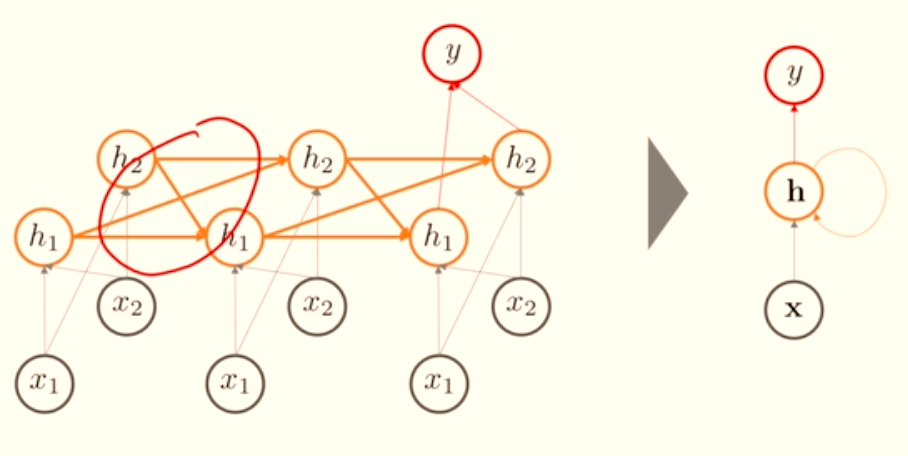
- h 자체에서 순환하는 구조 발생
- 자기자신을 참조로 하는 구조 ~ 순환 신경망
-
-
-
vanilla RNN 구조에서의 정보 흐름
-
forward path

-
backpropagation
-
목적 : 실제로 얼마나 틀렸는지를 확인하여 역방향으로 어떻게 해야 현재 입력-출력쌍을 잘 맞추는 가중치 행렬을 구하기
-
편미분을 통해 gradient를 구해야 함 ~ 역방향으로 진행 ~ chain 규칙

-
문제되는 부분임
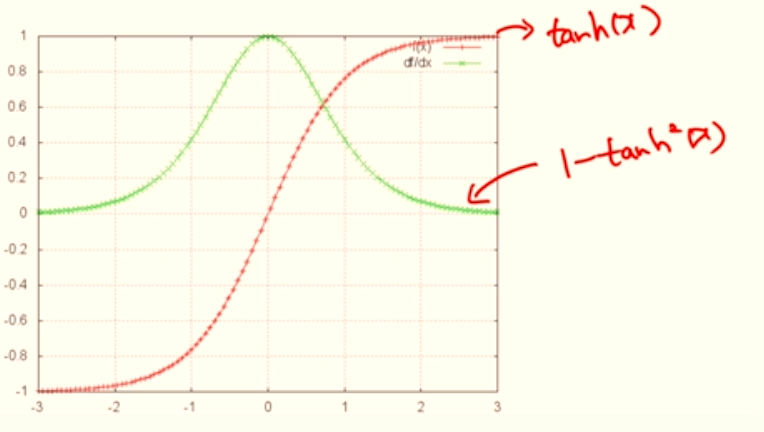
→ 가 특정 범위를 벗어나게 되면 0이 됨
→ 누적해서 쌓아온 정보가 0이 되어버림 ~ gradient vanishing
→ 이를 해결하기 위한 방법 : LSTM
-
-
LSTM (Long Short-Term Memory)
-
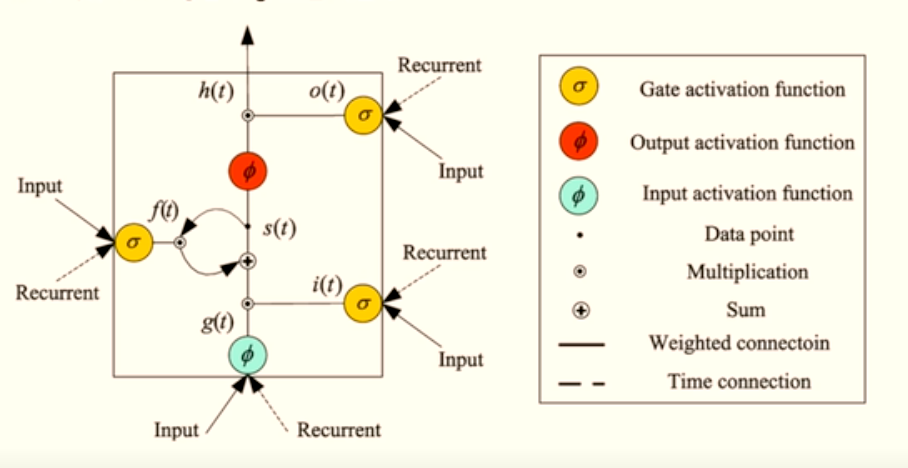
1. 지금까지의 cell state에 저장된 정보 중 얼만큼을 망각할 것인지 결정 : forget gate
1. Forget Gate : 이전 단계의 hidden state와 현 단계의 입력으로부터 0 ~ 1 사이의 값 출력
2. Sigmoid 함수 활용하여 0~1 사이의 값 반환
2. 새로운 정보를 얼마만큼 cell state에 저장할 것인지 결정 : Input Gate
1. Tanh layer를 사용해 새로운 cell state 후보 생성
2. 시점별로 Data에 따라 adaptive하게 보존 정도 정해짐
3. 예전 cell state를 새로운 cell state로 업데이트
1. 예전 cell state를 얼마나 망각할 것인가를 계산한 Forget Gate 결과값과 곱함
2. 새로운 cell state 후보와 얼마나 보존할 것인가를 계산한 Input Gate 결과값을 곱함
3. 두 값을 더하여 새로운 cell state로 결정
4. 출력값을 결정 : Output Gate
1. 이전 hidden state 값과 현재의 입력값을 이용하여 output gate 값 산출
2. ouptut gate 값과 현재 cell state 값을 결합하여 현재의 hidden state 값을 계산
2. GRU
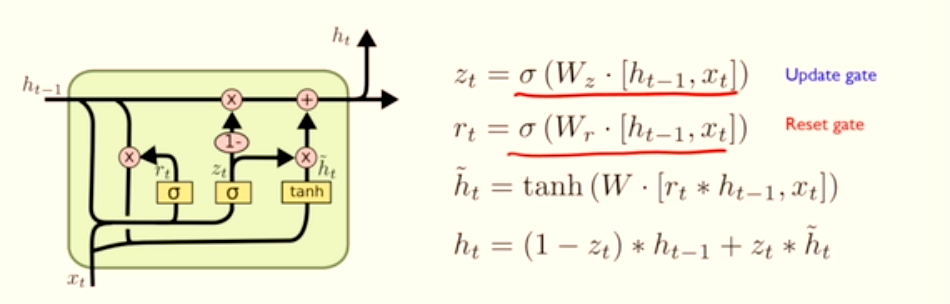
1. LSTM보다 조금 더 단순한 구조
2. 경험에 따르면, LSTM과 GRU의 성능이 크게 차이나지 않음 ~ GRU 적용을 먼저 진행한 뒤 LSTM 적용
3. 별도의 cell state존재하지 않음
4. update gate = forget gate + input gate : 현재 정보를 얼마나 많이 반영
5. reset gate : 과거의 정보를 얼마나 반영
3. Bi-directional RNN
1. 데이터를 가지고 있다 : 과거와 미래의 정보 모두를 가지고 있다
2. 시간의 역방향으로 처리할 수 있음 ~ 대표적 사례 : 번역
3. 순방향 + 역방향 정보 처리 모두 진행
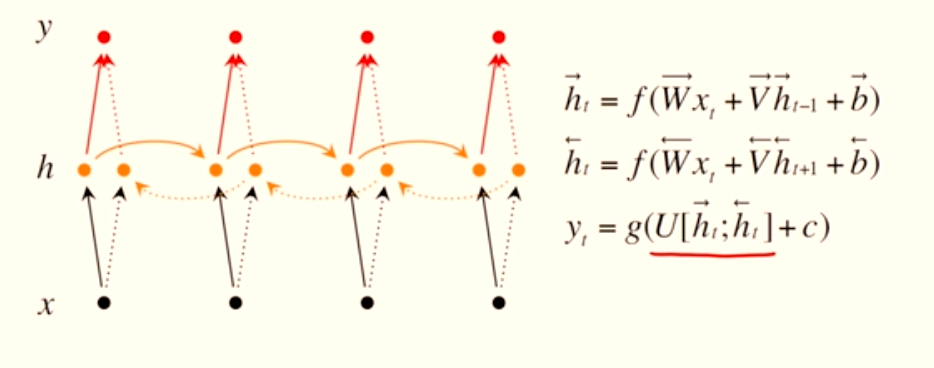
→ 순방향과 역방향 hidden state를 concat하여 활용
-
Attention
-
성능이 매우 향상됨
-
예측에 있어 몇번째 시점이 가장 중요하게 역할을 했는지 답변 가능

→ 각 시점 중 2번째, 3번째가 가장 큰 영향을 미치고 있다고 해석 가능
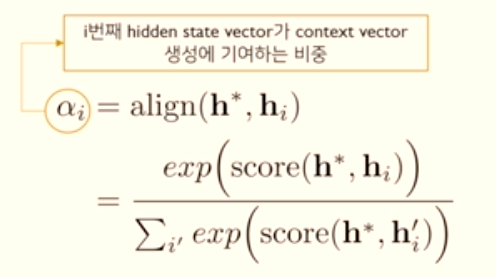
→ context vector
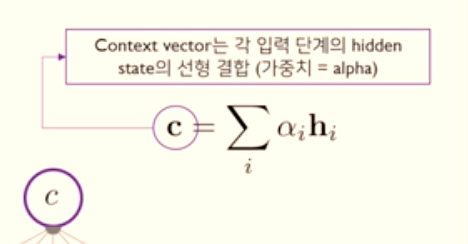
-
-
수업 요약

합성곱 기반의 시계열 데이터 회귀
-
CNN 설명
- 이미지 픽셀 하나하나를 입력데이터로 간주할 경우
- Input layer와 첫번째 hidden state 사이에 너무 많은 가중치 발생
- 합성곱 신경망
- 합성곱 연산을 통해 이미지로부터 필요한 특질을 스스로 학습할 수 있는 능력을 갖춘 심층 신경망 구조
- 이미지 데이터의 특성
- 인접 픽셀 간 높은 상관관계
- 이미지의 부분적 특성은 고정된 위치에 등장하지 않음 (사진을 찍은 거리에 따라 다양한 위치에서 등장 가능) - feture invariance
- 합성곱 연산
- spatially-local correlation 고려하기 위한 sparse connection 이용
- Invariant feature를 추출하기 위해 shared weight 개념 이용
- Filter, Kernel
- 개수, 크기에 대한 사용자 설정 필요
- Stride

- Activation
- convolution을 통해 학습된 값들의 비선형 변환 수행
- 대부분 ReLU를 사용
- 0보다 작으면 0, 나머지는 그대로
- 사람의 감각 기관은 정보를 받거나(양수) 받지 않거나(0) 이기 때문에
- Pooling
- Max pooling : 이미지에서 주로 활용
- Avarage pooling
- 시계열 데이터에서는 domain knowledge에 따라
- 특정 시점이 가장 큰 영향을 미친다 : Max pooling
- 전체 시점이 모두 영향을 미친다 : Avarage pooling
- Flatten
- 3차원의 tensor → 1차원의 vector
- 마지막에 이미지의 종류를 분류해야 하기 때문에
- 이미지 픽셀 하나하나를 입력데이터로 간주할 경우
-
주요 구조
-
AlexNet
-
구조

→ 초반에는 넓게, 느슨하게 (큰 filter, 큰 stride) / 막판에는 좁게, 촘촘하게 (작은 filter, 작은 stride)
→ 224*224 이미지 입력으로 활용
-
-
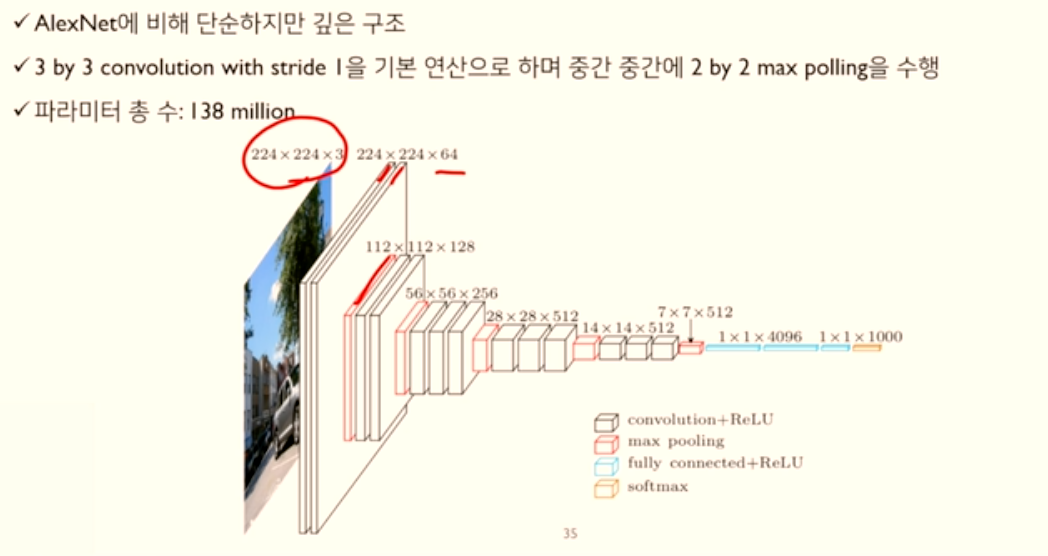
VGGNet
- AlexNet에 비해 단순하지만 깊은 구조
- 33 convolution with stride 1을 기본 연산으로 하며 중간에 22 max pooling 수행
-
-
Time-Series Data에 대한 합성곱 적용
-
가정
- 모든 변수는 동일한 주기로 수집되고 있음
-
종류
- 분류
- 회귀
- 예측
- 이상탐지
-
이미지와의 차이점
-
시계열 데이터는 변수들 사이에 spatial correlation이 존재하지 않음
-
시간축으로 움직이는 conv는 의미 있으나 변수축으로 움직이는 conv는 의미 없음
-
시간에 따른 관련성은 있을 수 있으나
-
변수 간에 관계는 없음
-
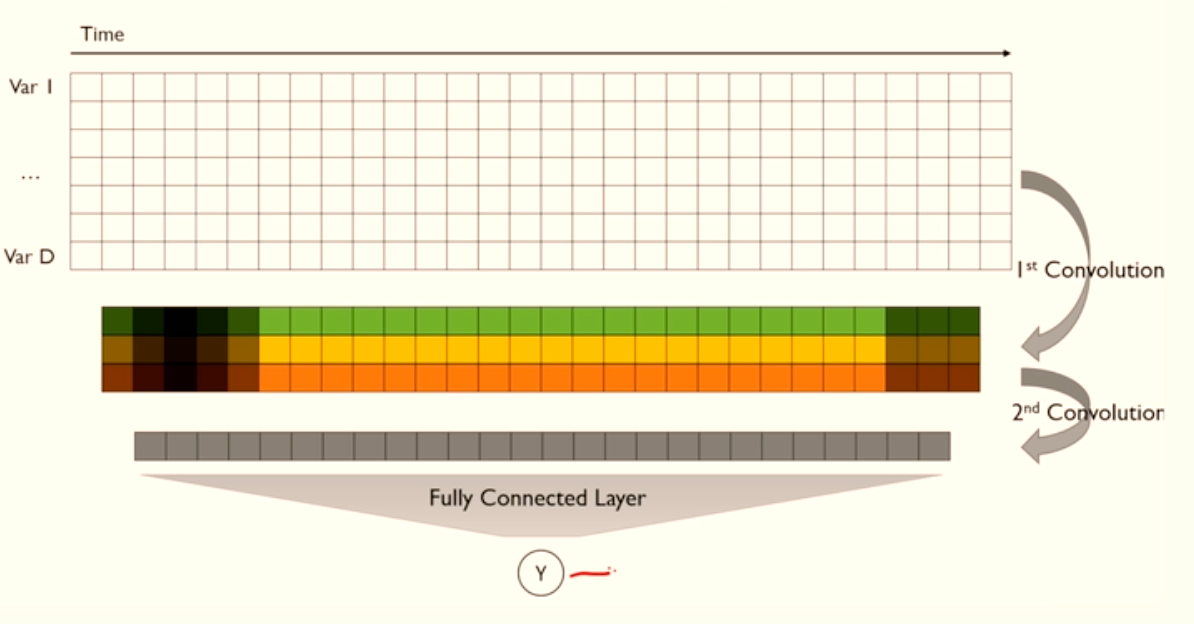
1-D conv는 모든 변수를 한번에 고려하여 시간축에 대해서만 conv 수행
→ 직사각형 형태의 filter 활용

-
2-d conv는 시간과 변수 두 축을 모두 conv 연산을 통해 탐색하는 방식
- 사용하지 않음 (변수 간 spatial correlation 없기 때문에)
-
-
-
CNN을 time-series에 적용하는 방식
-
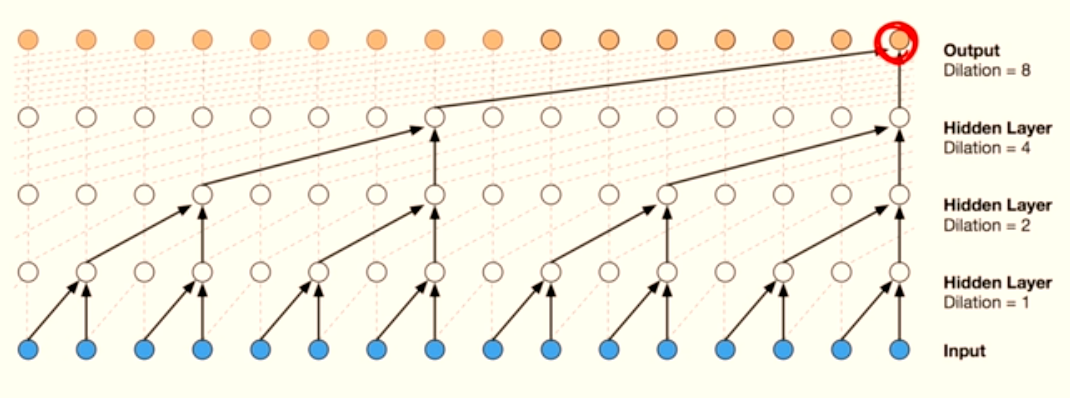
Dilated Convolution
- 보다 긴 길이의 시계열 데이터를 효율적으로 처리하기 위한 방식
- Standard Conv는 항상 인접한, 연속된 시점의 데이터에 대한 합성곱 연산 수행
- 합성곱 연산을 띄엄띄엄 진행하게 된다면 더욱 긴 길이의 시계열 데이터 효율적으로 처리 가능
-
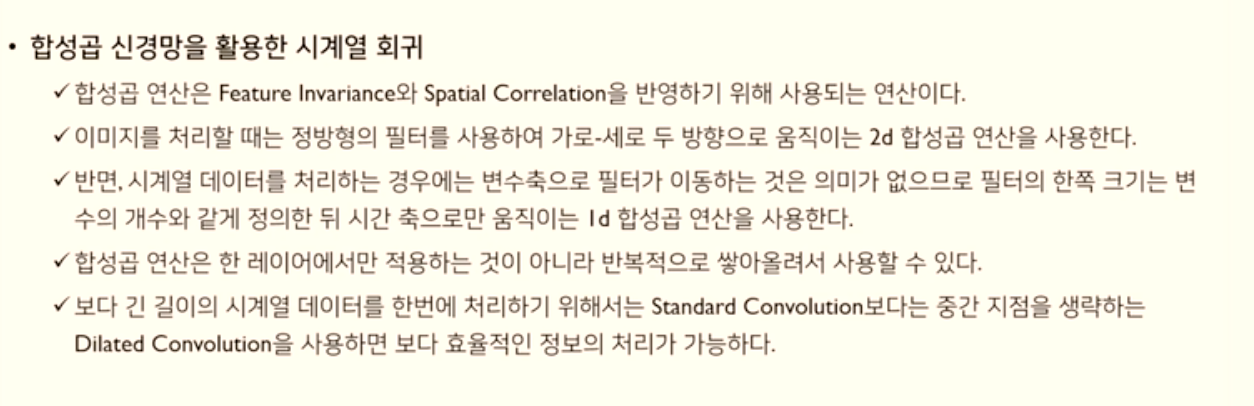
요약
-
트랜스포머 기반의 시계열 데이터 회귀
-
Time-Series Transformer : 시계열 데이터를 다루기 위한 special한 Transformer 구조
-
언어 모델 : 특정한 언어에서 특정 문장, 단어의 나열이 얼마나 자연스러운지 확률을 계산하는 모델
-
인코딩
-
입력 : word embedding
-
positional encoding
- 단어를 순차적으로 받지 않기에 입력 시퀀스에서 단어들 간의 위치 관계를 표현해 줄 필요가 있음
-
multi-head attention
-
입력된 문서 안에서 단어들이 어떠한 연관관계를 가지고 있는지 해석하는 방법
-
self-attention
-
입력 시퀀스의 다른 위치의 단어를 둘러보며 특정 위치의 단어를 더 잘 설명할 수 있게 함
-
순서
- 입력 벡터에 대한 Query, Key, Value 벡터 생성
- 현재 표현하고자 하는 단어(Q)에 대해 어떤 단어들을 고려해야하는지(K)를 알려주는 score 산출
- Q와 K 곱한 뒤 소프트맥스 함수 취해서 score 계산
- 학습 과정에서 안정성을 구하기 위해 차원의 제곱근으로 나눠줌
- 이 과정을 통해 gradient 전파가 보다 안정적으로 진행됨
- softmax 함수를 통해 해당 단어에 대한 점수 계산
- 구한 점수(확률값)과 해당 단어의 Key 값을 곱함
- 산출된 모든 값들을 더해서 출력으로 반환

- 최종적으로 encoder의 출력 나오게 됨
-
-
multi-head attention
- 굉장히 복잡한 문장일 경우 하나의 단어만 참조하는 것이 아니라 여러 부분을 참조할 수 있음
- 한 Query 토큰에 대해 다양한 관점으로 표현할 수 있는 능력 제공
- 어텐션 결과물은 concat 후 가중치 행렬과의 연산을 통해 원래 입력차원과 동일한 출력 반환
-
residual connection + layer normalization
-
feed-forward
- attention으로 만들어진 z를 비선형 변환을 통해 학습 진행
- 같은 encoder 블록끼리는 같은 가중치를 사용한다.
- 병렬적으로 진행됨
- 서로 다른 encoder 블록끼리는 서로 다른 가중치를 사용한다.
-
-
-
디코딩
- Masked multi-head attention
- 디코딩하는 과정에서는 현재 시점 이후의 정보를 미리 보면 안됨
- 디코딩 단계에서의 self-attention은 Query 토큰보다 뒤에 위치한 토큰들에 대한 정보는 가용하지 않다고 가정하고 해당 부분을 전부 masking 처리
- 병렬처리 가능
- 행렬연산 중 대각행렬 윗분에 대해서는 -무한대 값을 입력하여 score가 0으로 가도록
- 디코딩하는 과정에서는 현재 시점 이후의 정보를 미리 보면 안됨
- 마지막 layer
- 가용한 모든 단어들에 대해 log probability를 산출하여 가장 확률이 높은 단어를 반환
- softmax
- Masked multi-head attention
-
시계열 데이터에 대한 Transformer 적용
-
Time-Series Transformer (TST) : 다변량 시계열 데이터에 최초로 적용한 논문
- Encoder 구조만 활용
- pre-training을 위해 연속적인 길이의 input masking 사용
- layer norm 대신 batch norm 사용
- finetuning 단계에서 구조를 어떻게 설계하느냐에 따라 다양한 task에 적용 가능
-
입력 데이터 변환
- 원본 입력 데이터 X는 m개의 변수와 w개의 time window length를 가짐
- 사전학습
- 일부를 masking하여 transformer input이 되는 d차원으로 변환 (d<m)
- 변환 파라미터 또한 학습
- masking하는 이유
- 사전학습 목적 : masking 부분을 정확하게 예측하는 것으로 설계됨
- 이때, 각 cell에 대한 masking 여부를 독립적으로 결정하게 된다면 ~ trivial solution으로도 문제를 잘 맞추는 상황이 발행 (주기가 짧은 데이터 일수록 문제 심각)
- trivial solution : 바로 이전, 이후 시점의 데이터를 그대로 사용 혹은 평균값 사용
- 일정 길이 이상을 masking하도록 masking의 길이가 평균 lm이 되는 기하분포를 따르도록 markov chain 적용하여 masking 여부 적용
- 모든 변수에 대해 동일한 시점을 masking하는 것보다 변수별 독립적으로 masking segment를 결정하는 것이 실험적으로 더욱 우수한 성능 보임
- 일부를 masking하여 transformer input이 되는 d차원으로 변환 (d<m)
- position encoding
- 차원축소 후 position encoding 관련 matrix를 활용하여 실제 matrix 생성

- 차원축소 후 position encoding 관련 matrix를 활용하여 실제 matrix 생성
- 이후 과정은 transformer 과정과 동일
- 인코더 개수 축소 : 6 → 3
- normalzation 변화 : layer → batch
- 이상치가 매우 많이 존재할 수 있음
- 관측치의 길이 변화가 nlp의 문장 길이 차이에 비해 적음
- 파인튜닝
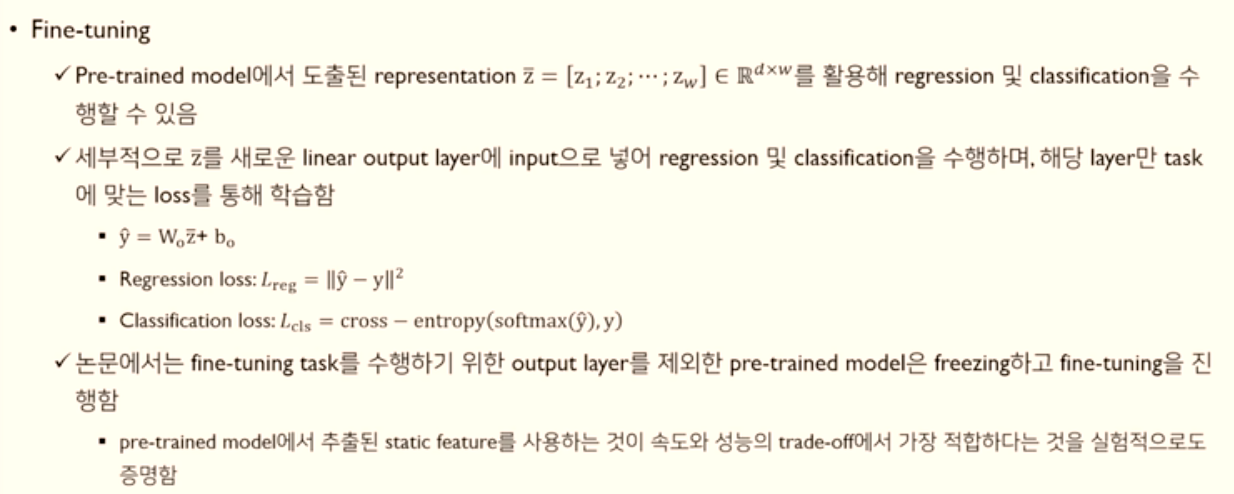
- masking 과정 없이 d차원으로 변환
- 변환 파라미터 또한 학습
- 전체 sequence에 대해 각각의 시점별로 데이터가 들어올 것이기 때문에 concat한 뒤 가장 마지막 단에 FFN 레이어를 달아 y가 무엇인지 예측하는 finetuning 단계를 거치게 됨
- 특이점
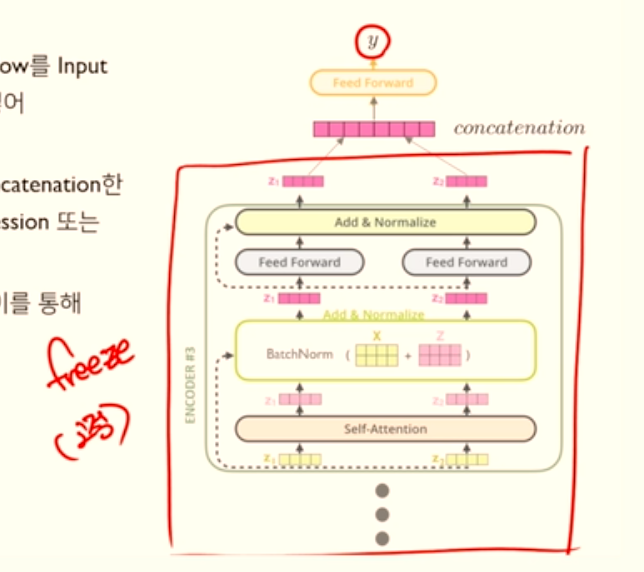 → 네모 안의 부분은 사전학습 이후 freeze하여 update하지 않음 → 마지막 FFN 레이어만 학습을 통해 update
- masking 과정 없이 d차원으로 변환
- 기타 사항
- labeled data 개수와 성능의 관계
- 사전학습을 하지 않은 경우와 한 경우 모두 labeled data의 개수가 많을수록 성능 향상됨
- 그러나 그 향상폭에 있어 사전학습 한 경우 월등함
- unlabeled data 개수와 성능의 관계
- labeled data의 개수가 고정되었을 때, unlabeled data 개수가 많을수록 성능이 향상됨
- labeled data 개수와 성능의 관계
-
-
요약

개발자로서 배울 점이 많은 글이었습니다. 감사합니다.