퍼셉트론(Perceptron)
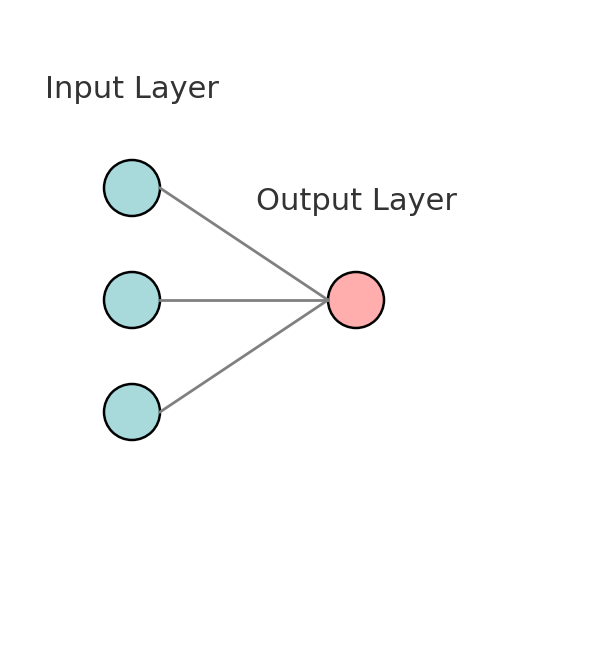
퍼셉트론은 다수의 입력 신호를 받아 하나의 출력 신호를 내는 구조다.
즉, 입력 → 연산(가중치, 편향, 활성화 함수) → 출력 시스템이라고 할 수 있다.
신호가 흐를 때는 1, 신호가 흐르지 않을 때는 0으로 간주한다.
가중치와 편향
퍼셉트론의 수식은 다음과 같다.
- : 입력 값
- : 가중치 (weight)
- : 편향 (bias)
- : 활성화 함수 (activation function)
즉, 입력과 가중치의 가중합(weighted sum) 에 편향을 더하고,
그 결과를 활성화 함수에 통과시켜 출력 를 얻는다.
퍼셉트론의 한계
퍼셉트론이 Unit Step Function을 활성화 함수로 사용할 경우,
선형적으로 구분 가능한 문제만 풀 수 있다.
예: AND, OR 게이트는 가능하지만 XOR 문제는 풀 수 없다.
다층 퍼셉트론 (Multi-Layer Perceptron, MLP)
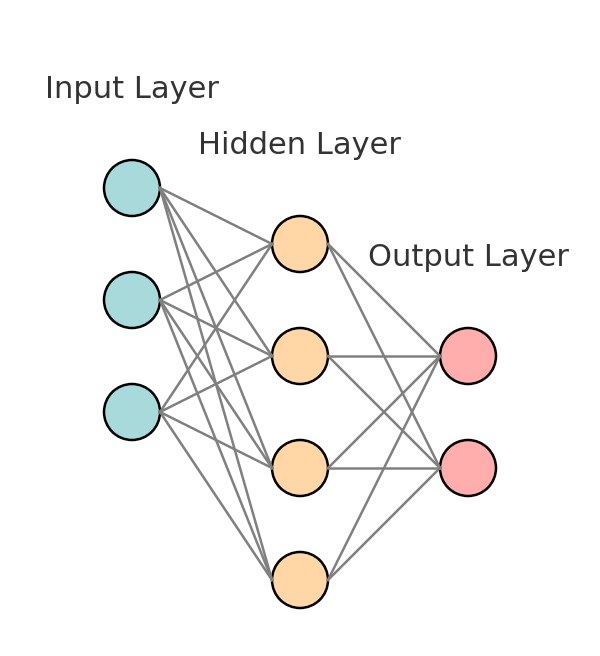
퍼셉트론을 여러 층으로 쌓으면 다층 퍼셉트론(MLP) 이 된다.
MLP는 행렬 곱 → 편향 더하기 → 활성화 함수 적용의 반복이다.
수식으로 표현하면,
...
- : 번째 층의 가중치 행렬
- : 번째 층의 편향 벡터
- : 활성화 함수 (ReLU, Sigmoid, Tanh 등)
- : 번째 은닉층(hidden layer)의 출력
왜 비선형 활성화 함수가 필요한가?
만약 모든 층에서 가 선형 함수라면?
이를 정리하면 결국 하나의 선형 변환이 된다.
즉, 선형 활성화 함수만 쓰면 아무리 층을 깊게 쌓아도 결국은 FC Layer 한 층과 동일한 표현력밖에 얻지 못한다.
따라서 비선형 활성화 함수(non-linear activation) 가 꼭 필요하다.
- Sigmoid, Tanh, ReLU 같은 함수들이 이를 가능하게 해준다.
- 선형 → 비선형 → 선형 → 비선형 … 구조를 쌓으면
훨씬 복잡하고 다양한 함수를 근사할 수 있다.
즉
- 퍼셉트론:
- 퍼셉트론을 여러 층으로 쌓으면 MLP
- 비선형 활성화 함수를 넣어야만 깊은 신경망의 표현력이 살아난다
Data Scientist, interested in CV, NLP