
📌 이 문서는 확률 이론에 기반한 머신러닝 분류 알고리즘인 나이브 베이즈(Naive Bayes)에 대해
강의를 들으며 따로 정리한 내용입니다. 개념이 간단한데도 실제로 성능이 좋아서 흥미로웠고,
특히 확률 기반으로 분류를 생각한다는 점이 직관적으로 와닿았다.
Naive Bayes (나이브 베이즈) 알고리즘 정리
1. 기본 개념: 확률로 분류하는 모델
나이브 베이즈는 확률 이론, 특히 베이즈 정리에 기반해서
각 클래스에 대한 확률을 계산하고, 가장 확률이 높은 클래스로 분류하는 알고리즘입니다.
처음엔 "왜 이름이 '나이브'야?" 싶었는데,
모든 feature들이 서로 독립이라고 가정(naive assumption)하는 단순한 구조 때문이더라구요.
2. 조건부 확률이란?
이 부분이 처음엔 좀 헷갈렸는데,
정리하자면 "A가 일어난 걸 알고 있을 때 B가 일어날 확률"을 의미합니다.
P(A | B) = P(A ∩ B) / P(B)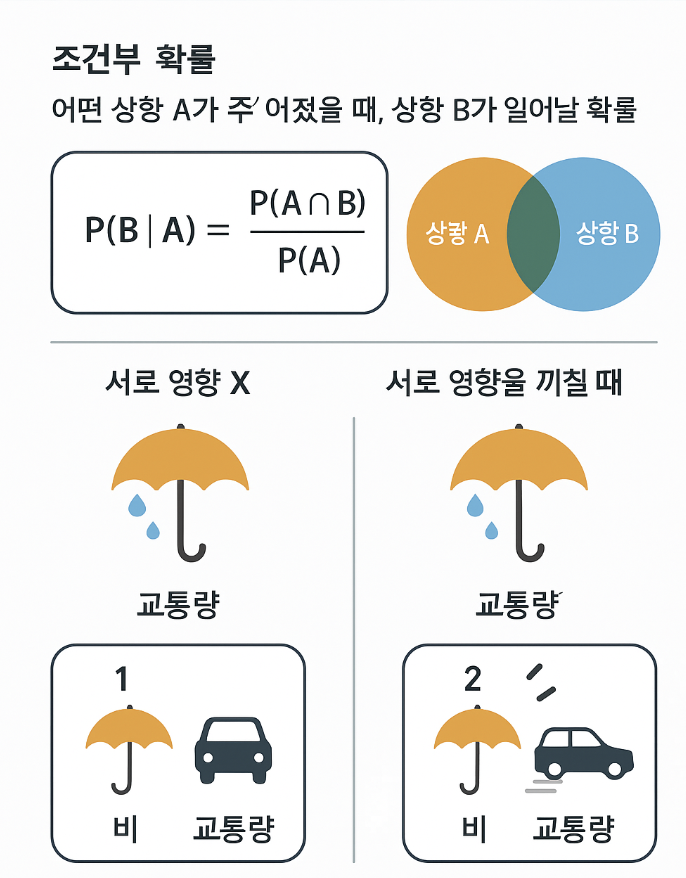
예시)
"비가 오는 날, 우산을 들고 나올 확률"
→ 우산과 비의 관계를 확률로 표현하는 방식
3. 베이즈 정리 수식
이건 나이브 베이즈의 핵심 공식:
P(C | X) = (P(X | C) * P(C)) / P(X)| 항목 | 의미 |
|---|---|
| P(C | X) |
| P(X | C) |
| P(C) | C가 나올 확률 (사전 확률) |
| P(X) | X가 나올 전체 확률 (정규화 상수) |
→ 결국, 입력 X가 들어왔을 때 어떤 클래스가 더 그럴듯한가를 계산하는 구조입니다.
4. 시각적으로 이해한 포인트
- 전체 확률 공간 중에서 내가 관측한 정보(X)를 기준으로
클래스 C의 확률을 재계산하는 구조 - 실제로는 P(X)는 모든 클래스에 공통이므로 계산에서 생략되는 경우가 많음
5. '나이브'한 가정이란?
- 나이브 베이즈는 모든 Feature가 서로 독립이라고 가정합니다.
- 현실에선 당연히 그렇지 않지만,
이 가정 덕분에 계산이 엄청 단순해지고 빠름
예시:
스팸메일 분류에서 단어들이 서로 독립이라고 가정
6. Gaussian Naive Bayes 실습 예제
from sklearn.naive_bayes import GaussianNB
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score

X, y = load_iris(return_X_y=True)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)

model = GaussianNB()
model.fit(X_train, y_train)

y_pred = model.predict(X_test)
print("정확도:", accuracy_score(y_test, y_pred))
→ 연속형 데이터(정규분포 가정)에 적합
→ 정말 빠르고 간단하게 분류됨
7. 다양한 나이브 베이즈 종류
| 모델 | 특징 | 사용 예시 |
|---|---|---|
| GaussianNB | 연속형 변수, 정규분포 가정 | 센서 데이터, 수치 예측 |
| MultinomialNB | 단어 개수 기반 | 뉴스 분류, BoW 모델 |
| BernoulliNB | 이진 특성 | 스팸 여부, 클릭 여부 등 |
8. 장단점 요약
장점
- 계산이 매우 빠름 (선형 복잡도)
- 적은 데이터로도 잘 작동
- 텍스트 기반 문제에 강함 (MultinomialNB 등)
단점
- Feature 간 독립 가정은 현실에서 잘 안 맞을 수 있음
- 연속형 데이터는 정규분포를 따르지 않으면 성능 하락
9. 내가 정리하면서 느낀 점
- 나이브베이즈는 딥하게 수식 전개는 안 해도
확률적 사고를 직관적으로 이해하는 데 엄청 좋은 예제였다. - 베이즈 정리는 관측 데이터를 통해 기존 지식을 갱신하는 방식이고,
이걸 코드로 바로 구현해볼 수 있어서 재미있었다. - 텍스트 데이터처럼 고차원, 희소 데이터에서도 빠르게 잘 작동하는 게 인상적
- 독립 가정이 성립하지 않아도 성능이 꽤 괜찮다는 점도 의외였음
기록과 회고를 통해 성장하는 데이터, AI 엔지니어 지망생입니다.