인덱스란?
인덱스는 데이터베이스에서 레코드를 조회할 때 빠르게 조회하기 위한 일정의 이정표이다.
여기까지가 흔히 알고 있는 인덱스의 정의다. 그럼 직접 수치적으로 확인해보자.
- 해당 글에서는 분량 상 인덱스 구조에 대해서는 자세히 설명하지 않는다. 인덱스의 구조는 추후 다른 글에서 다루도록 하겠다.
테스트 환경
- MySQL 8.0 (InnoDB)
실험을 위해 더미 유저 데이터를 10만 건 넣어놓았다.
- 이름, 나이, 이메일
실험 1) 인덱스 유무의 차이
가장 먼저 단순 인덱스 유무의 차이에 대해 알아보겠다.
이 실험에서는 email 컬럼에만 인덱스를 걸었다고 가정하겠다. 사람마다 이메일이 다를 확률이 매우 커 그만큼 카디널리티가 높기 때문이다. 카디널리티를 직접 확인할 수도 있다.
다음의 쿼리를 통해 테이블에 걸린 인덱스 정보를 확인할 수 있다.
SHOW INDEX FROM users;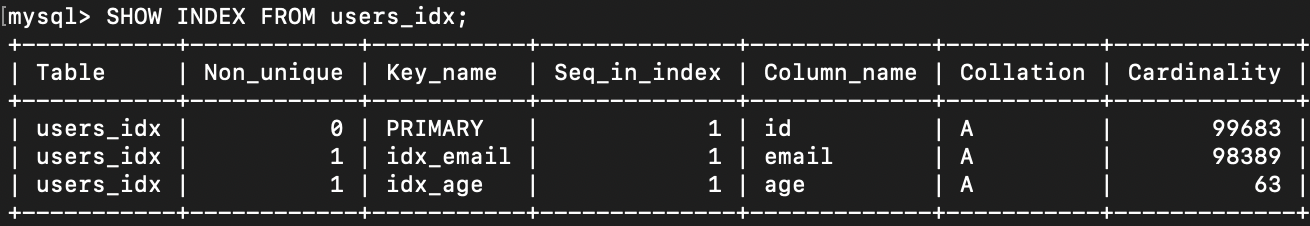
조회 결과를 보면 유니크 여부부터 카디널리티를 확인할 수 있고, email이 카디널리티가 가장 높은 것을 확인할 수 있다.
이제 EXPLAIN을 통해 실행 계획을 알아보겠다.
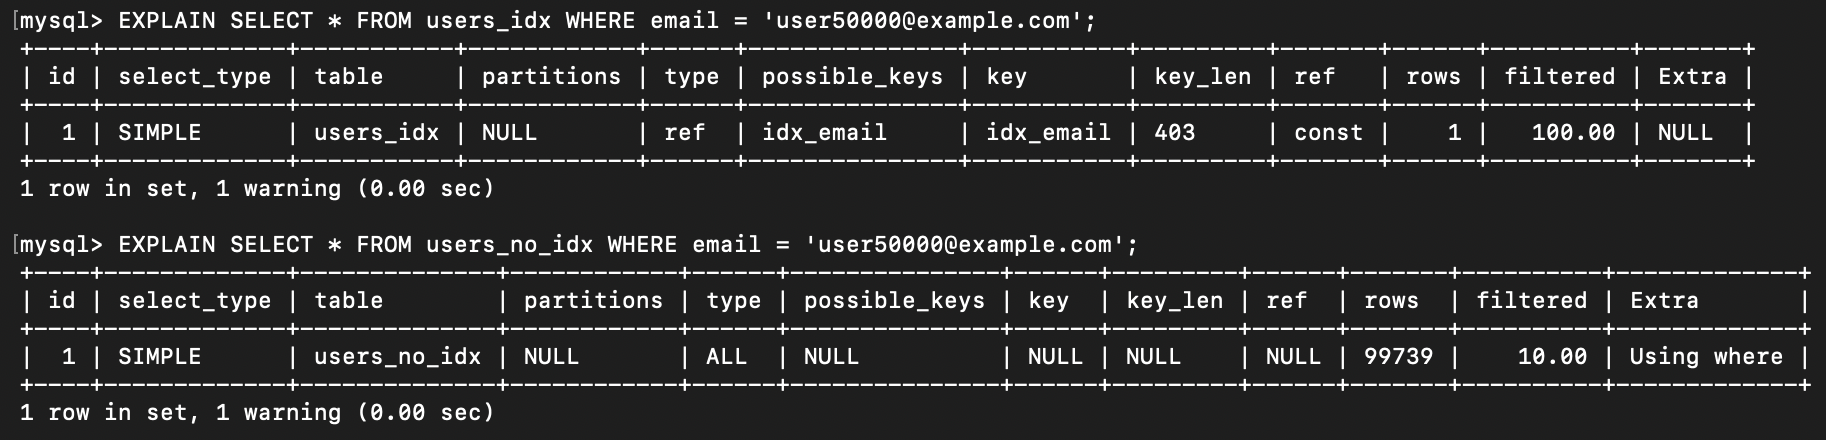
결과 분석
위의 결과에서 중점적으로 봐야 할것은 type이다. EXPLAIN의 type은 옵티마이저의 테이블 접근 방식을 의미한다.
- system: 테이블에 레코드 한건 존재 시
- const: PK/Unique 단건 조회
- eq_ref: 조인 단건 조회
- ref: 일반 인덱스 스캔
- range: 범위 스캔
- index: 인덱스 전체 스캔
- ALL: 풀 테이블 스캔
인덱스가 걸려 있는 테이블은 ref 접근을 하고, 없는 테이블은 ALL 접근을 한 것을 확인할 수 있다. 추가적으로 rows를 보면 인덱스를 활용하지 않는 조회는 거의 모든 행을 조회한 것을 볼 수 있다.
근데 왜 단건 조회했는데 const가 아닐까? => 결과는 단건이지만, const 접근 PK 또는 Unique에만 걸린다. email 인덱스에 유니크 제약이 없기 때문에 옵티마이저는 중복을 배제할 수 없기 때문이다.
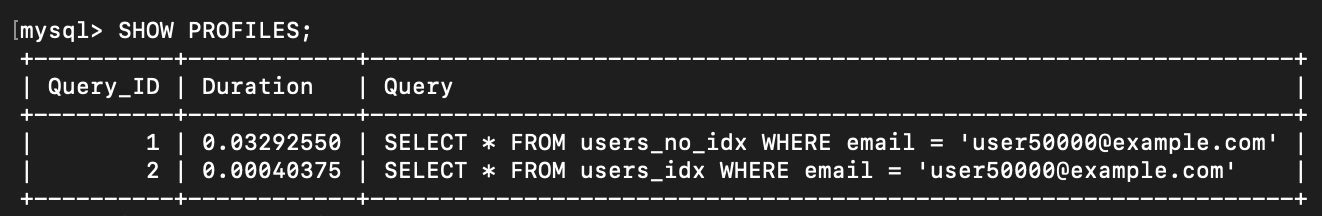
인덱스가 없으면 테이블을 처음부터 읽기 때문에 이러한 실행 시간 차이가 생기게 된다. (검색하고자 하는 레코드에 대한 정보가 없기 때문에, 무작정 뒤지는 것이다.)
이렇게 좋으면 왜 모든 컬럼에 인덱스를 걸지 않을까?
실험 2) 인덱스가 독이 되는 상황
인덱스가 독이 되는 상황은 두 가지 상황이 있다.
- 대량의 쓰기 작업
- 카디널리티가 낮은 인덱스
쓰기 작업
옵티마이저가 인덱스를 참조하려면 결국 인덱스를 저장하는 곳이 필요하다. MySQL에서는 별도의 B+Tree를 통해 인덱스를 저장한다. 쓰기 작업 시 인덱스 B-Tree도 같이 수정하는 작업이 동반되는 것이다.
-- 인덱스 0개
SET @start = NOW(6);
CALL insert_no_idx(100000);
SET @end = NOW(6);
SELECT TIMESTAMPDIFF(MICROSECOND, @start, @end) / 1000 AS no_idx_ms;

-- 인덱스 5개
SET @start = NOW(6);
CALL insert_heavy_idx(100000);
SET @end = NOW(6);
SELECT TIMESTAMPDIFF(MICROSECOND, @start, @end) / 1000 AS idx_5_ms;
타임 스탬프를 찍어 인덱스가 5개인 테이블과 없는 테이블의 insert 성능을 비교해보았다. 결과는 다음과 같았다.
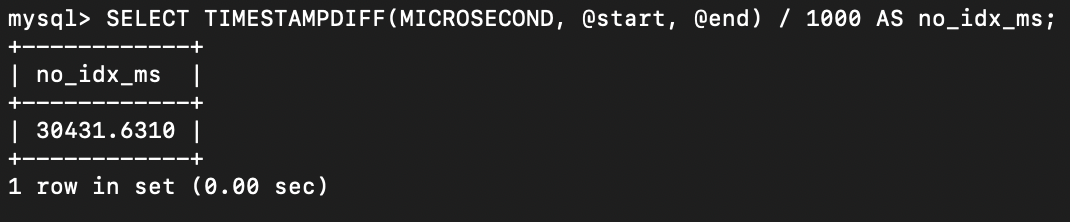
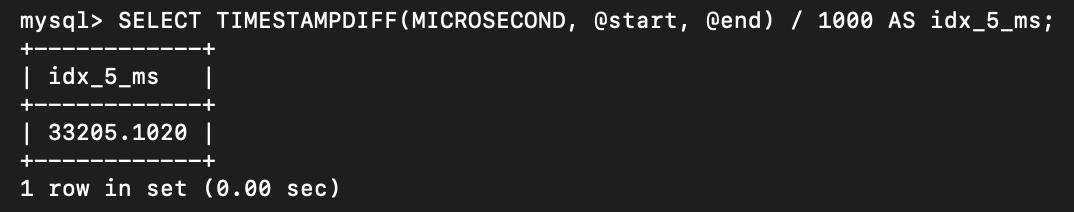
MySQL이 세컨더리 인덱스의 B+Tree를 갱신하는 비용으로 약 10%가량 차이가 난다.
카디널리티가 낮은 인덱스
카디널리티가 낮은 인덱스에서는 왜 인덱스가 좋지 않을까?
카디널리티가 낮은 age 인덱스를 통해 범위 스캔을 해보았다.
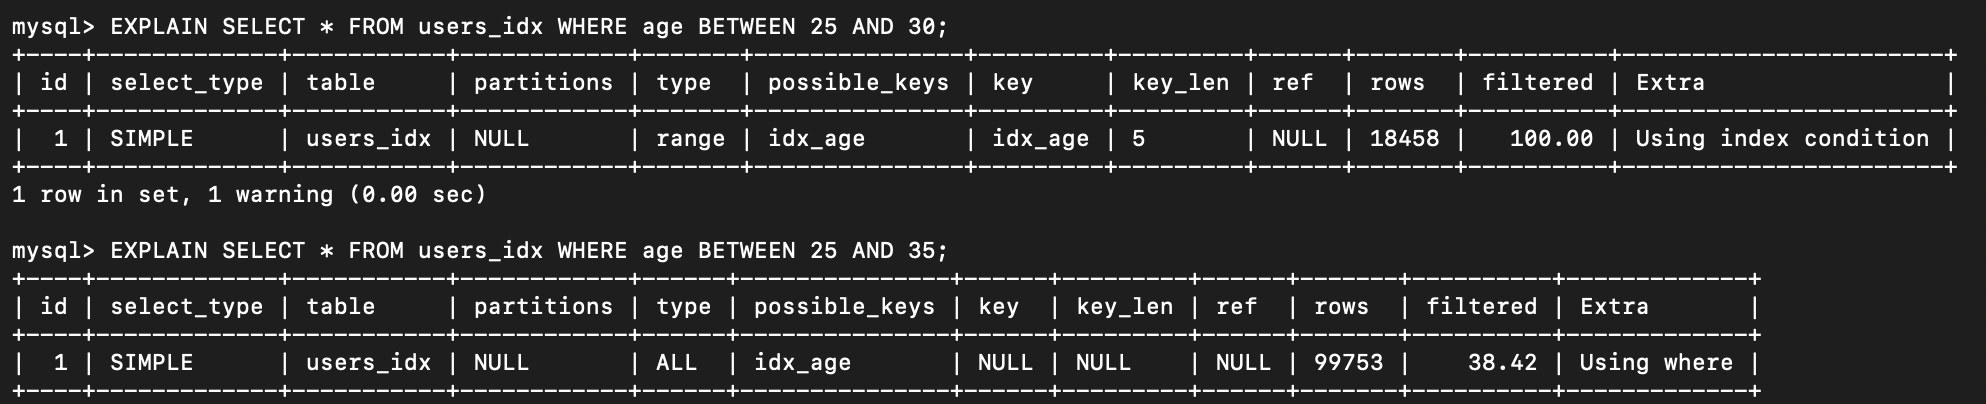
실행 계획을 보면 범위가 넓어질수록 테이블 접근 방식이 range -> ALL로 바뀌는 것을 볼 수 있다. 인덱스를 걸었는데 왜 풀 테이블 스캔이 일어날까?
그 이유는 인덱스를 찾고 테이블에 접근하는 방식에 있다. 먼저, 세컨더리 인덱스의 리프 노드에서 레코드의 인덱스와 PK 쌍을 찾고, 다시 클러스터드 인덱스에서 해당하는 레코드를 찾아야 한다. 하지만, 클러스터트 인덱스는 PK를 기준으로 정렬되어 있기 때문에 레코드를 찾는 과정에서 랜덤 I/O가 발생한다.
옵티마이저는 이러한 비용보다 차라리 풀 테이블 스캔이 더 낫다고 판단하기 때문에 풀 테이블 스캔(순차 I/O)을 하게 된다. 보통 조회되는 레코드가 전체의 20% ~ 30%를 넘어가면 풀 테이블 스캔을 한다.
만약, 많은 레코드를 조회해야 하는 쿼리가 빈번한 환경이라면 읽기 성능은 그대로지만, 쓰기 성능만 늘어나는 안타까운 상황이 발생하게 된다.
실험 3) Redis와의 비교
단순 응답 속도가 느리다고 Redis를 통해 캐싱하는 경우가 많다. 실제로 효과가 있는지 같은 데이터(10만건)를 Redis에 넣고 직접 비교해보았다,
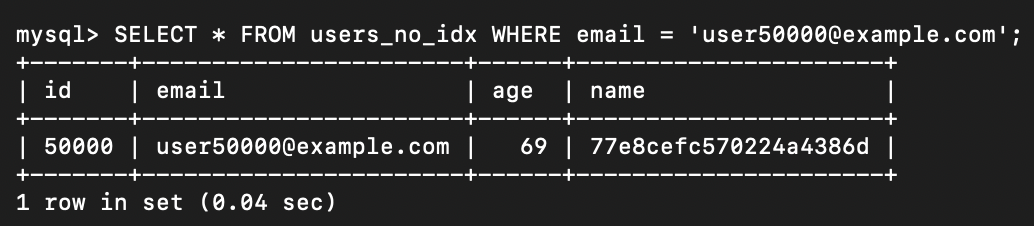
인덱스 없음
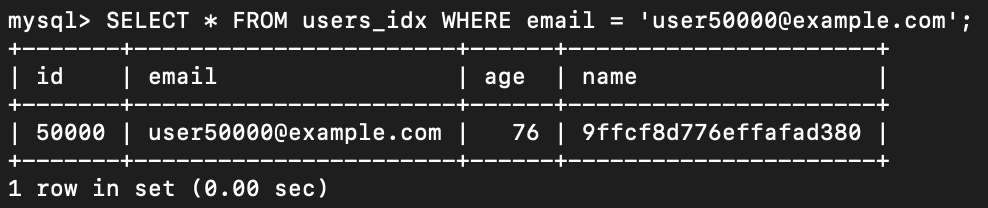
인덱스 적용
아래는 Redis GET 벤치마크 결과다.
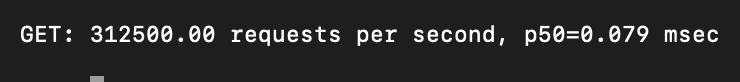
Redis
절대적인 수치는 차이가 나지만, 과연 사용자 경험에 있어서 차이가 있을까라는 의문이 든다. Redis는 매우 값비싼 자원이다. 비용뿐만 아니라 운영적인 측면에서도 복잡도가 매우 증가한다.
그렇다고 Redis가 필요하지 않다는 것은 아니다. 트래픽이 증가해 동시 요청이 DBCP 사이즈를 넘어가면 나머지 요청은 커넥션을 얻을 때까지 대기한다. 요청이 계속 쌓이면 커넥션 풀이 고갈되고, 결국 서비스 전체가 멈출 수 있다.
여기서 Redis를 캐시로 활용하면, DB 커넥션을 점유하지 않으니 커넥션 풀에 여유가 생기고, 정작 DB를 거쳐야 하는 쓰기나 복잡한 쿼리에 커넥션을 확보할 수 있다.
마무리
아래처럼 정리할 수 있을 것 같다.
데이터 조회 패턴 파악
│
├─ Key-Value 단건 조회가 대부분인가?
│   ├─ YES → 응답 지연 요구치가 1ms 이하인가?
│   │         ├─ YES → Redis 도입 검토
│   │         └─ NO  → DB 인덱스로 충분
│   └─ NO (범위, JOIN, 집계) → DB 인덱스
│
├─ 쓰기 비중이 높은가? (50% 이상)
│   ├─ YES → 인덱스 최소화, 꼭 필요한 것만
│   └─ NO  → 읽기 패턴에 맞는 인덱스 설계
│
└─ 데이터가 메모리에 올릴 수 있는 크기인가?
    ├─ YES → Redis 캐시 레이어 고려
    └─ NO  → DB 인덱스 + 쿼리 최적화
인덱스의 구조에 대한 자세한 내용은 다음 포스팅에서 다루겠다.
