network layer
라우터에서 하는 역할은 1) forwarding 과 2) routing 이 있다.
1) forwarding
packet의 header(목적지 주소)를 보고 forwading-table을 찾아 원하는 포트로 보내는 작업이다.
2) routing
forwarding table을 만들어주는 알고리즘이다.
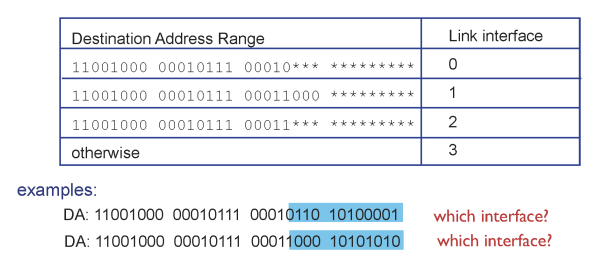
실제로는 주소 범위로 a번부터 b번까지는 c번으로 가게끔 forwarding table을 관리해준다.
longest prefix matching
packet이 들어왔는데 packet을 보고 얼만큼까지 동일한 숫자를 가지고 있느냐에 따라 matching이 된다. 만약 동일한 link가 여러개 있다면 그중 가장 길게 매칭되는 entry와 forwarding 하게 된다.
IP datagram format
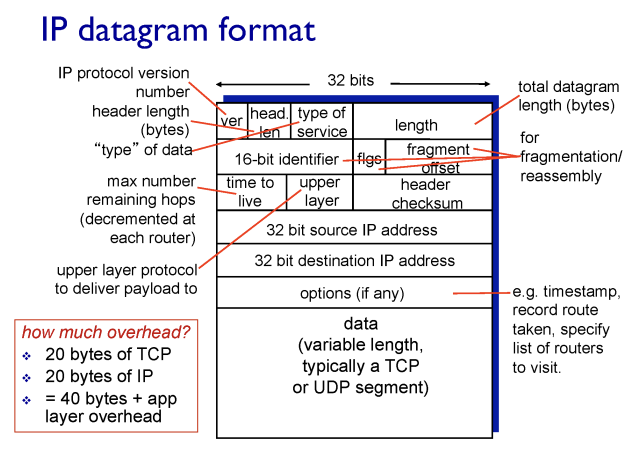
1) data: TCP, UDP segment 부분에 들어갈 데이터 부분
2) ip protocol version : 현재 버전은 4버전이다.
3) source IP address: msg를 생성하는 사람의 주소
4) destination IP address: 받는 사람의 주소
5) checksum
6) time to live: 처음 주어진 숫자가 라우터를 지날때마다 -1씩 감소함
사용하는 이유: 라우팅 table이나 forwarding table이 잘못됐을때 ttl 이 없다면 무한으로 돌고 있을것이다. 이를 한정된 시간내에 돌아가도록 하기 위해 TTL field가 존재한다.
7) upper layer: data 부분에 들어가는 부분이 TCP/UDP인지 알려주는 부분
그중 IP address에 대해서 살펴보자.
IP address(IPv4)
TCP 를 이루는건 segment이고 header(20byte) + data로 구성된다. 여기서 data는 ip를 이루는 packet으로 구성되고 header(20byte) + data(20byte)로 구성된다. 실제 인터넷상에서는 TCP packet으로 이뤄져 있고 실제 데이터에 40byte의 header field를 지니므로 그만큼의 오버헤드를 지닌다고 표현한다.
인터넷의 상당수의 packet은 대부분 40byte인데 그 대부분은 file ACK를 담은 packet들이다.
IP주소란?
- 32 bit 주소 체계를 가진다. (= 2^32개의 IP주소를 가질 수 있다.)
- 읽기 좋게 8 bit씩 끊어서 10진수로 바꿔서 표현한 것을 IP주소라고 한다.
- 최대 0~(2^8-1)로 255가 최대이다.
- host에 있는 네트워크 인터페이스를 지칭하는 주소이다.
(=> network interface card가 여러개면 ip주소도 여러개를 가진다. 이러한 특수한 컴퓨터의 예시로 라우터가 있다.)
보통 다음과 같은 방식으로 ip주소를 배정한다.
그 중 ip주소를 배정하는 방법에 대해서 알아보자.
scalability challenge
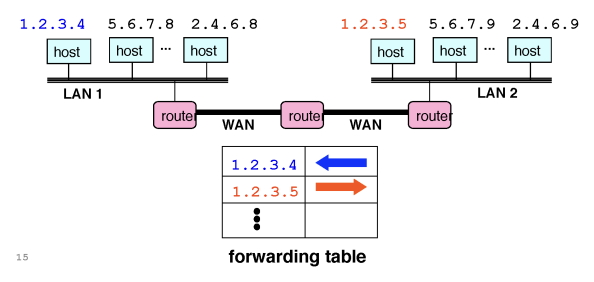
모든 호스트가 임의로 주소를 가지는 방식으로 가장 단순한 방식이다.
단점)
- router안에 있는 entry개수가 많아짐에 따라 forwarding table개수가 많아진다.
- table 개수가 많아짐에 따라 검색이 어려워진다.
hierarchical addressing
현재 사용하고 있는 ip주소 배정법은 계층화가 되어있다.
앞부분은 network id, 뒷부분은 network안에서 지칭하는 host id를 가리킨다.
즉, 같은 network에 해당하는 host들은 동일한 network id를 가지게 된다.
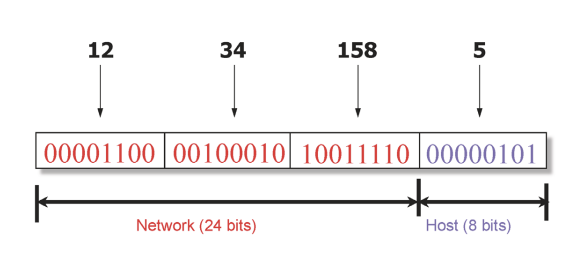
12.34.158.5/24
=> network id에 해당하는 ip주소의 bit 수를 '/'이후에 나타낸다. 위에선 network id가 24bit임을 알 수 있다.
=> prefix = network id = subnet id
ip 주소와 24bit subnet mask
위에서는 사람이 이해하기 쉽게 표현한 방법이고 기계가 알기 쉽게 bitmap로 표현한 방식을 subnet mask라고 한다.
ip주소와 subnet mask는 항상 같이 다니는데 그 이유는 어디까지가 network id인지 표시해야하기 때문이다.
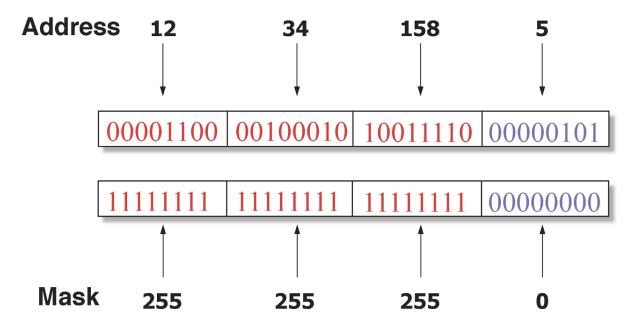
위 그림에서는 256개 = 2^8 개의 네트워크 id를 지원해준다는 것을 알 수 있다.
(= 네트워크의 크기가 256개의 id 를 지원해준다.)
scalability improved
동일 네트워크상에 속한 host들은 동일한 prefix의 ip address 를 가진다.
장점)
- forwarding table이 단순해진다.
- 특정 network에 새로운 host를 추가하면 forwarding table과 관계없이 ip주소를 부여할 수 있다. (이유: 동일 prefix 만 가져오면 되므로)
ex) 5.6.7.0/24 가 있다고 해보자.
subnet mask: 24이므로 ip 주소의 첫 24bit가 네트워크의 주소를 가리키게 된다. 이때 동일 네트워크 상에 있는 host 들은 동일 prefix를 지니게 되는데 얘가 바로 5.6.7을 의미한다.
classful addressing
과거에는 어떻게 ip 주소를 배정했을까?
인터넷은 네트워크의 집합이고 각 네트워크는 자기자신만의 prefix를 가져야한다. 그리고 prefix의 크기가 다를 것인데 이를 class로 나눠서 분류하였다.
예를 들어 다음과 같은 class에 subnet mask가 있다고 해보자.
class A /8 class B /16 class C /24
class A의 경우, 2^24 (32-8=24)개의 host를 보유하고 2^8 개의 기관을 가질 수 있다.
class B의 경우, 2^16 개의 host를 보유하고 2^16 개의 기관을 가질 수 있다.
class C의 경우, 2^8 개의 host를 보유하고 2^24 개의 기관을 가질 수 있다.
class A는 host를 많이 가질 수 있으나 기관수가 너무 적어서 이미 적은 기관이 모두 선점하고 대신 너무 많은 수의 host를 낭비하게 된다. 반대로 class C는 기관이 많아지나 한 기관당 할당되는 host의 개수가 제한적이다.
class 도메인이 유연하지 않아 이를 해결할 방법으로 'classless inter-comain routing'기법이 나타났다.
CIDR (Classless Inter-Domain routing)
class를 없앰으로써 8bit단위가 아닌 자유롭게 prefix를 지정할 수 있게 되었다.
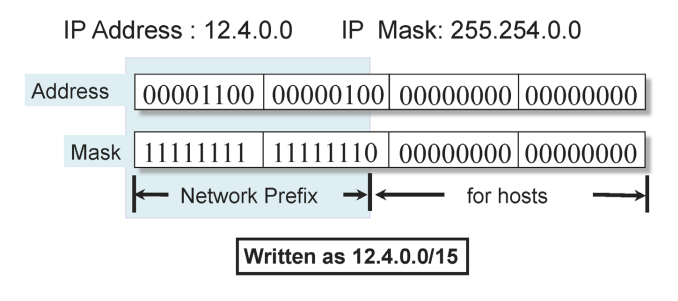
위와 같이 15bit로 네트워크 크기에 맞춰 prefix를 지정하게 되었다.
따라서 위의 class 예시에서 /24 -> /22로 prefix를 자유롭게 바꾸면서 2^10개의 host를 보유할 수 있다.
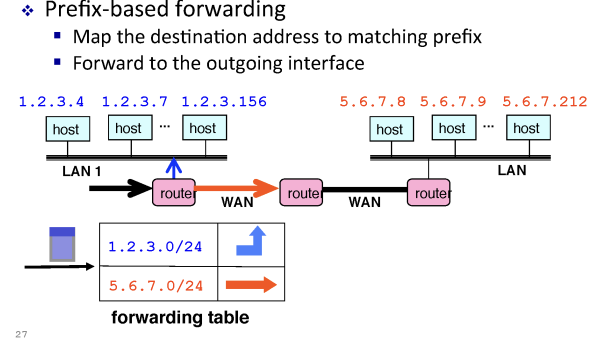
class를 router forwarding entry에 넣어 매칭된 것을 찾아서 router forwarding이 가능하다.
longest prefix match forwarding
라우터에 있는 forwarding table의 예시이다.
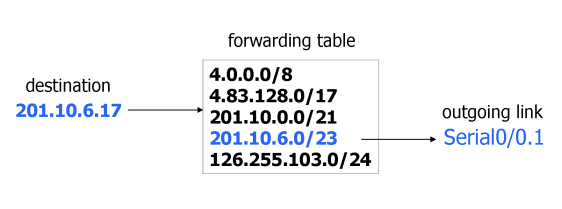
그러면 destination에 있는 ip주소와 forwarding table을 보면서 매칭되는 주소를 알아보자.
1) destination
201.10.00000110 | => prefix
2) forwarding table의 3번째
201.10.00000 | 000.~ => prefix (21bit이므로 8+8+5 즉 5개의 비트가 뒤에 붙는다.)
3) forwarding table의 4번째
102.10.0000011 | 0.~ => prefix (23bit이므로 8+8+7 즉 7개의 비트가 뒤에 붙는다.
이때 2)와 3) 모두가 매칭된다면 라우터는 prefix가 가장 크게 매칭된 ip로 매칭시킨다.
그렇다면 forwarding table은 어떻게 구성될 것인가? -> 나중에 배우게 될 router algorithm
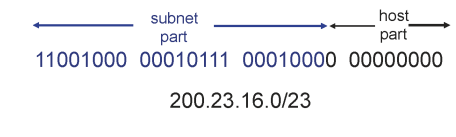
위와 같은 상황이면 24+8 = 23+9 이므로 2^9개의 host가 주어지게 된다.
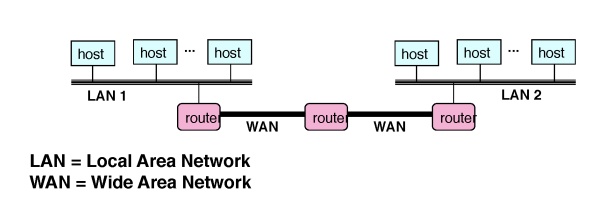
subnets
정의)
- 동일한 subnet id = prefix 를 가진 device의 집합
- 라우터를 거치지 않고 접근이 가능한 host들의 집합
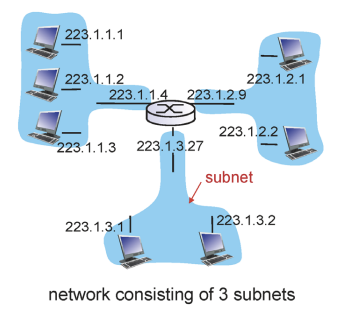
위의 그림에서
1) 라우터에 인퍼테이스 3개 (ip주소가 3개이므로)
2) 라우터의 ip주소의 prefix는 다르다. (/24라고 가정할때)
즉, 라우터는 여러개의 subnet에 속한 교집합이다.
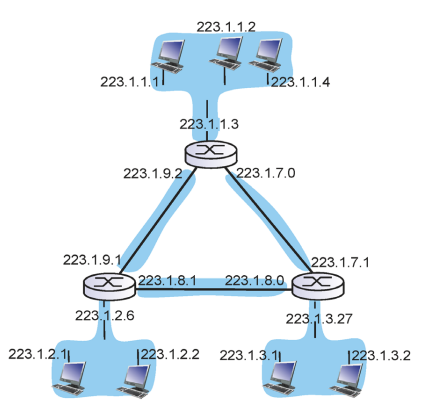
위 그림에서는 총 6개의 subnet을 가진다.
(/24라고 가정하면 서로 다른 prefix들의 개수를 확인하면 된다.)
각 라우터는 3개의 network에 걸쳐있는거라고 볼 수 있다.
history
IPv4 (70년대)
- 현재 사용하는 ip 주소는 32 bit 주소체계를 가진다.
- 이론상으로는 인터넷에서 2^32 (약 40억) 개의 host를 지원함을 의미한다.
- 그러나 90년대 초반 인터넷이 상업화되면서 주소공간의 고갈이 기정사실이 됐다.
(문제점: 1) 주소공간 부족 2) 보안상의 문제)
IPv6 (1996)
- 128 bit의 주소체계를 가진다.
- 이론상으로는 2^128 개의 host를 가진다.
IPv4 (현재)
why?
- 주소공간자체는 여전히 부족하지만 '무언가'를 공유함으로써 주소공간을 가진다.
-> 이러한 트릭을 network address translation (NAT) 라고 부른다.
NAT 소개
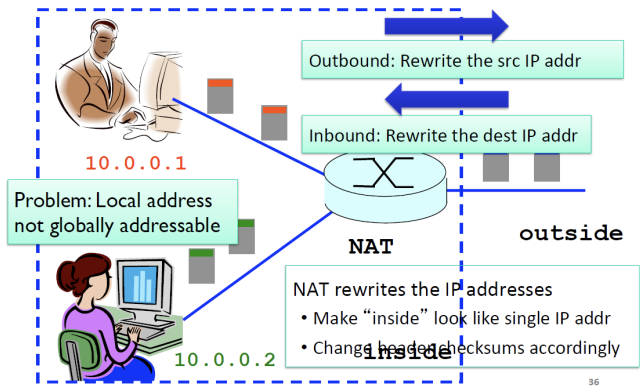
네트워크 내부에서만 유일한 ip 주소를 사용하지만 다른 네트워크에서는 해당 ip를 사용할 수 있다.
그러나 이 ip주소를 가진 packet을 네트워크 외부로 유출시키면 안된다. (해당 ip주소가 현재 network 바깥에서 유일한 ip주소가 아니기 때문에)
이때 NAT에서 공용인 '138.76.29.7' 의 ip 주소로 바꿔서 밖으로 내보낸다.
다시 목적지 ip주소를 찾아 되돌아올댄 NAT에서 변환작업을 거쳐 올바른 ip주소로 전달된다.
내부 LAN-> 외부 WAN
바깥으로 내보낼때는 '138.76.29.7'에 포트번호도 기존의 80에서 5001로 바꿔줘야 한다.
외부 -> 내부
NAT translation table에서 포트번호를 보고 매칭되게 된다.
layer디자인이 망가지게된 문제점 : 내부 => 외부!
ip packet: [ 헤더 | 데이터 ]
1) source IP주소 -> packet의 header 부분
2) 포트 번호 -> TCP 데이터 부분
라우터는 network device라서 network layer ip주소의 header만 봐야 하는데 header의 소스주소도 바꾸고 data부분의 포트번호를 바꾸게 된것!
ip주소는 host 인터페이스를 찾아갈때 port번호는 process를 찾아갈때 사용한다.
그러나 NAT에서는 host를 찾는데 port 번호를 사용하여 process를 찾을때 사용할 수 없게 된다.
그러면 NAT 내부에 있는 네트워크에서는 서버를 운영할 수가 없게 된다.
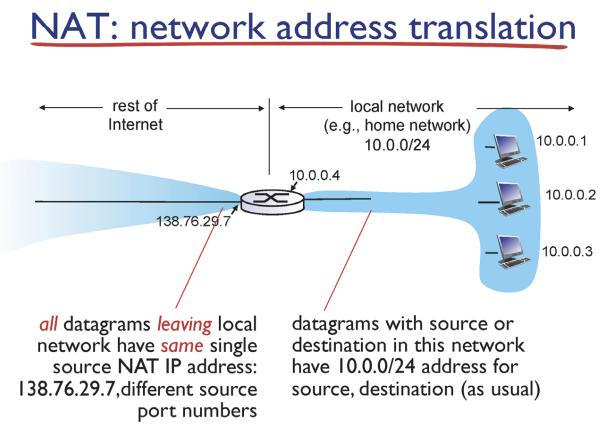
따라서 NAT가 하나의 IPv4를 유지할 수 있게하는 trick이면서 layer를 망치는 버전이므로 이를 고쳐야한다. 이를 해결할 옵션 중에 IPv6으로 갈지 새로운 방향으로 갈지 논쟁중이다.
DHCP (Dynamic host configutration protocol)
한 사람이 인터넷을 하기 위해 필요한 정보는 1) IP주소 2) subnet mask 3) router 4) DNS 정보이다.
1) IP주소
2) subnet mask
3) router
정보를 바깥으로 packet으로 전달할때 필요한 라우터 주소 (forwarding router 주소) 를 의미한다.
4) DNS
local name server의 ip 주소를 의미한다.
예시로 네이버에 정보를 물어볼때 네이버의 도메인을 보고 ip주소를 알아내는데 필요하다.
위 네가지 정보를 동적으로 알려주는 것을 DHCP라고 한다.
(어디로 이동하던지간에 host를 동적으로 알려주는게 중요하다.)
DHCP 개념
고정 IP를 사용하는 경우에는 DHCP가 필요하지 않다.
예를 들어 A대학교에서 고정된 IP주소를 모든 학생에게 부여한다고 하자. 그렇다면 전체 학생수만큼의 고정 IP주소가 필요하므로 굉장히 손해가 크다.
그러나 DHCP를 사용하면 active한 학생 수만큼만 필요하기 때문에 유연하게 IP주소를 부여할 수 있다. 예를들어 학생이 IP주소가 필요하다고 요청을 하면 제한기간을 두고 IP주소를 빌려주고 제한 기간이 지나면 IP주소를 다시 회수하는 방식이다.
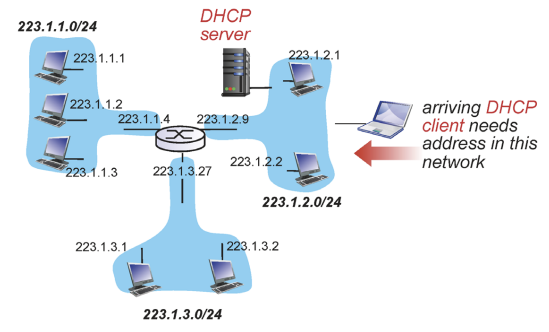
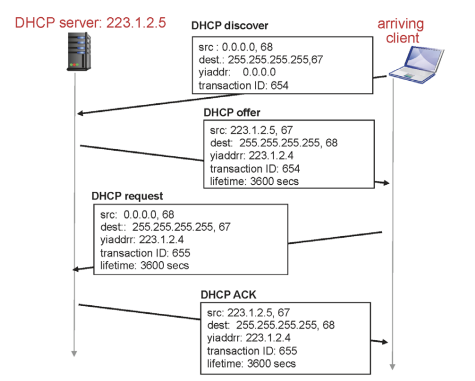
DHCP client-server 시나리오
client A가 있다고 하자.
1)
src: 무명, 68번에 client로 돌리고 있다.
dest: broad cast = 1으로써 동일한 서브넷에 있는 모든 host가 DHCP server msg받게 되고 67번에서 돌아가고 있다.
transaction ID: A만 선택한 ID
2)
모든 host가 받되 DHCP server만 67번 포트로 listen 하고 반응하게 된다.
offer msg: server 자신
dest: broad cast로 모든 host가 받되 1)만 유의미하게 받게 된다.
lifetime: 3600초 동안 사용할 수 있다.
3)
offer를 수락한다는 의미로 request를 보낸다.
src: 아직 무명 (ip주소가 확정되지 않았기 때문에)
transaction: request의 의미로 (기존 transactionID + 1) = 655로 보낸다.
4)
client A는 offer 에서 받게된 IP주소, subnet mask, router, DNS 정보를 사용하게 된다.
왜 굳이 3)과 4)가 필요한가?
어떤 경우는 DHCP가 여러개 있을 수도 있는데 이때 offer를 여러개 받게 되면 원하는 offer에 대해서 알리기 위해 필요하다.
[참고]라우터는 다음의 프로세스가 있다.
1. forwarding
2. name server : application layer
3. DHCP : application layer
4. routing : network layer
5. firewall
실제로 생각해보면 통신사에서 지급하는 공유기는 IP주소를 지급하는 것과 같고 가정에서는 한 IP주소를 공유하여 사용하는 것이다. 동일한 네트워크를 가지므로 같은 prefix를 가지지만 다른 IP주소를 갖는다. 다만 바깥으로 정보가 보일때는 동일한 IP주소로 내보내진다.
IP datagram format - identifier, offset에 대해
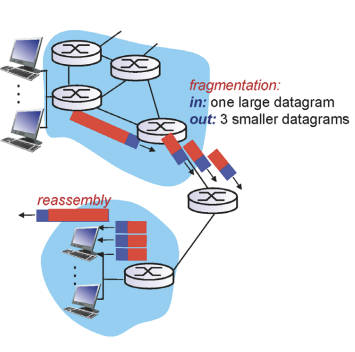
각 링크별로 보낼 수 있는 데이터 unit의 maximum transform unit (MTU)가 있다.
처리할 수 있는 MTU보다 더큰 사이즈의 데이터가 오면 해당 데이터를 3개의 독립적인 size의 frame으로 바뀌고 나중에 다시 하나의 packet으로 합쳐진다.
example
4000byte의 packet이고 MTU가 1500bytes인 링크를 맞닦드렸다.
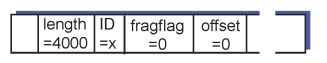
[헤더=20byte | 데이터] 이고 1500이므로 서로다른 3개의 fragment으로 분리된다.
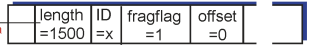
ID는 동일하게 x이고 뒤에 이어지는 fragment가 있으므로 fragflag는 1이다. offset은 fragment가 시작하는 부분이고 해당 fragment는 초기단계이므로 0이다.
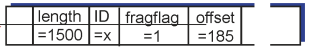
ID=x로 동일하고 이어지는 fragment때문에 fragflag=1 이다. 그리고 header에 20byte이므로 1500-20=1480 byte만큼의 데이터가 있고 8로 나눠 offset=185로 185에서 시작한다.
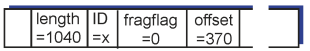
ID=x로 동일하고 더이상 fragment가 없으므로 fragflag=0 이다. 그리고 1040-20=1020 이므로 1020/8 =125 만큼을 4000-1040=2960 2960/8=370이 offset이 된다.
ICMP (internet control message protocol)
사용자 데이터가 아니라 네트워크상에서의 여러 증상 (control msg를 보내기 위한)를 알기 위한 프로트콜
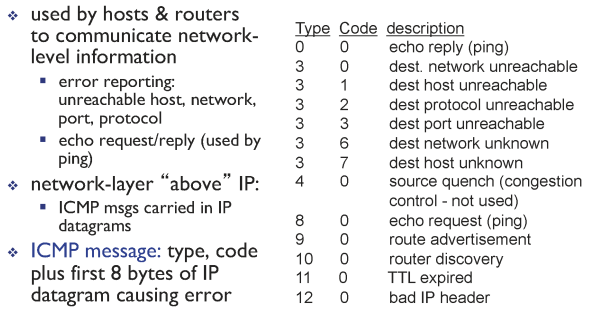
header에 type, data 부분에 code를 넣어 전달한다.
IPv6
장점)
- 헤더부분이 단순하다.
- address가 128bit로 구성된다.
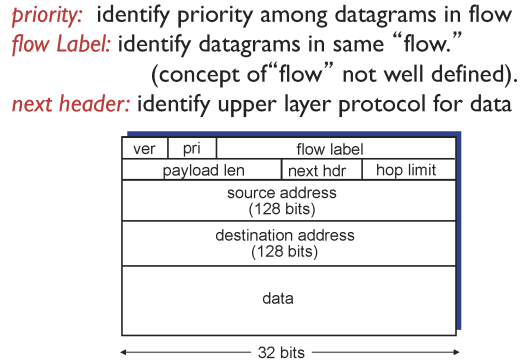
tunneling
새로운 버전의 헤더를 받으면 과거의 형태의 packet format으로 바꾸는 것이 필요하다.
C와 D는 IPv6를 이해하지 못하지만 B와 E가 IPv6가 이해할 수 있기 때문에 가능하다.
forwarding table - routing 알고리즘
forwarding table look up에 지나지 않는다.
(longest prefix)
그리고 이 table은 routing 알고리즘에 의해 저장하게 된다. 이제부터는 router를 그래프로 본다.
routing
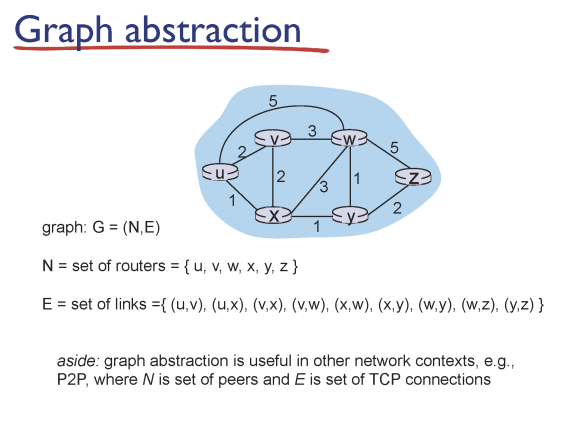
노드: 라우터
노드 사이의 link: communication link
링크사이에 존재하는 value: communication cost
목표) 목적지까지 cost가 최소인 경로를 찾는 알고리즘
첫번째 방법 - link state
네트워크 상황이 이미 전제로 있는 경우
1. link state인 이유
모든 노드들이 전체 네트워크에 자신의 link 정보를 broadcast를 해야한다.
2. 다익스트라 알고리즘
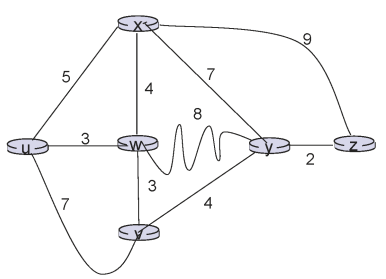
궁극적인 목표) source router의 forwarding table의 entry를 채우는 것이다.
각 노드들이 잠재적인 destination router이기 때문에 각 노드들의 notation으로 채운다.
C(x,y) : 노드 x에서 노드 y로 가는 링크 비용
D(v) : source 에서 dest.v로 가는 link의 현재 비용
p(v) : source에서 dest.v로 갈때 이전 노드
N' : 최소 비용인 경로를 확실하게 알고 있는 경우의 노드집합
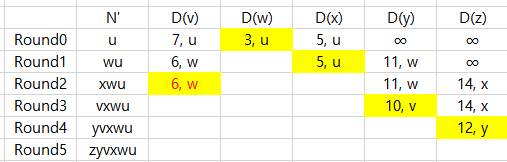
빨간 글씨는 update 되지 않고 기존의 값을 그대로 전승한 값이다.
그럼 source=u 인 것을 기점으로 forwarding table을 구성하면 다음과 같다.
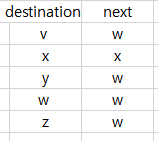
3. 다익스트라 알고리즘
link cost = traffic 양이라고 할때
traffic이 진동하는 것처럼 그 최적의 방안은 계속 바뀔 것이다.
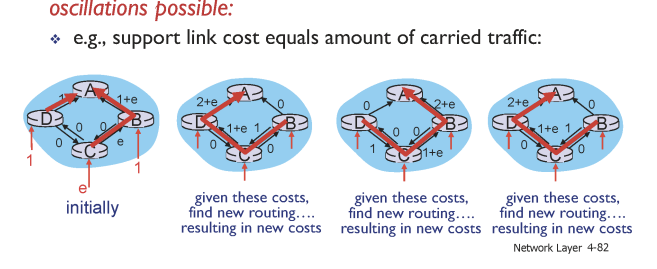
broadcast의 범위는 하나의 네트워크내부의 전체이다. 따라서 link state 알고리즘의 범위는 하나의 도메인에 적용되는 하나의 네트워크 내부라고 할 수 있겠다. 그러나 네트워크와 네크워크 사이의 알고리즘은 따로 존재한다.
두번째 방법 - distance vector
이웃한 라우터의 정보만 알고 있는 경우
직접적으로 연결된 라우터의 정보만 알기때문에 굉장히 직관적이지 않다. (분산처리 시스템)
dx(y) : source x에서부터 y로의 최소 비용 경로
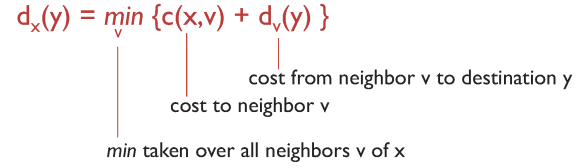
C(x,v)는 이미 알고 있는 값이다.
식에서 dv(y)에 대한 부분은 계속 재귀하면서 결과가 나온다.
자기자신의 distance vector가 변경되면 이웃노드에게 반드시 전달한다. 만약 update되지 않으면 가만히 있으면 된다.
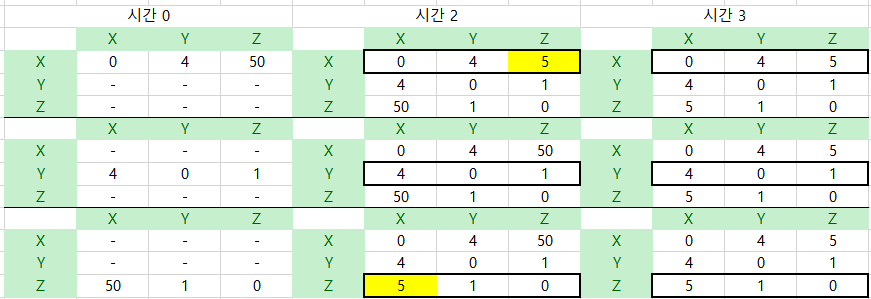
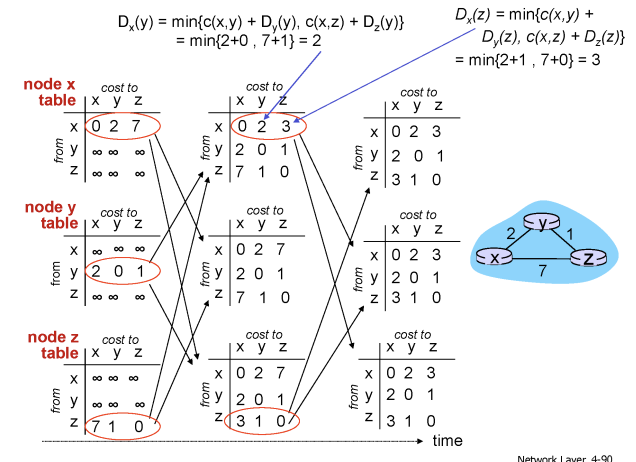
- 이웃으로부터 받은 데이터와 비교한 후 변한 값이 있으면 update하고 변하지 않았으면 그대로 둔다.
- 시간3에서 x, y, z의 distance vector가 변하지 않으므로 안정화된 상태이다.
그러나 stablize가 된 후에 어떤 변화가 발생한 경우에는 어떻게 되는가?
(다음의 딜레마는 reversive 한 상태가 존재하는 경우 나타난다. )
- link cost가 긍정적으로 변하면 (숫자 감소) 몇 번의 round 후 안정화된다. 그리고 변한 부분에 관여한 노드만 확인한다.
다만 긍정적이지 않은 경우는 전체 노드에 대해서 계속 update가 필요하다. 큰 값으로 수렴될때까지 ping-pong 하면서 증가하게 된다.
-> 이러한 상황을 count-to-infinity 라고 부른다.
-> 그리고 이를 해결할 방법중 하나로 poisoned reverse가 있다.
네트워크에서 타네트워크로 움직이는데 거쳐가는데 필요한 라우팅은 다음과 같다.
AS (Autonomous system)
하나의 라우터에서 자치적인 시스템 (하나의 네트워크를 가진 기관)
- intra AS
- 자치 시스템 내부에서의 동작하는 라우팅- 목적: 최단 경로
- Inter AS
- 자치 시스템 위에서 동작하는 라우팅- 목적: 불분명, policy-based
RIP
intra AS
OSPF
intra AS
BGP
inter AS
AS란?
모든 AS는 각자 고유의 AS 번호(=ASN)를 가지고 있다.
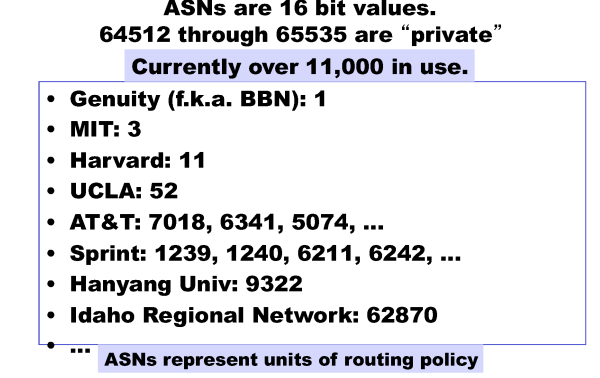
이로써 network 개수가 6만개 이상임을 예상할 수 있다.
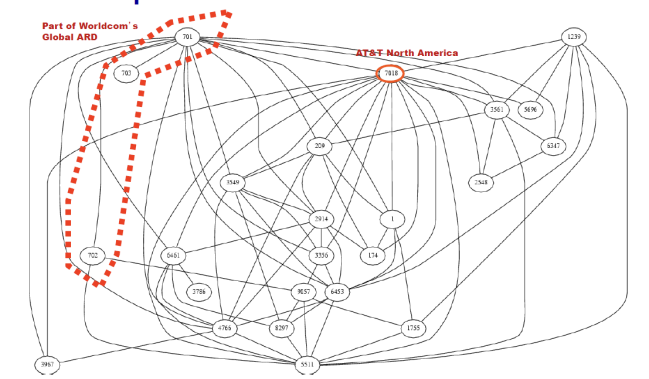
inter AS routing 의 그래프가 될 수 있다.
AS끼리도 위상이 다르다.
그리고 AS를 운용하는 데에는 돈이 필요하다.
1. customer-provider
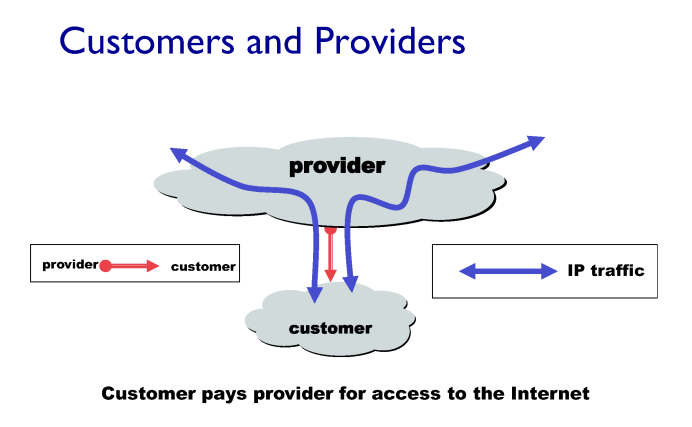
따라서 AS 사이에는 provider (인터넷 연결 제공자)와 customer가 있다.
2. peering
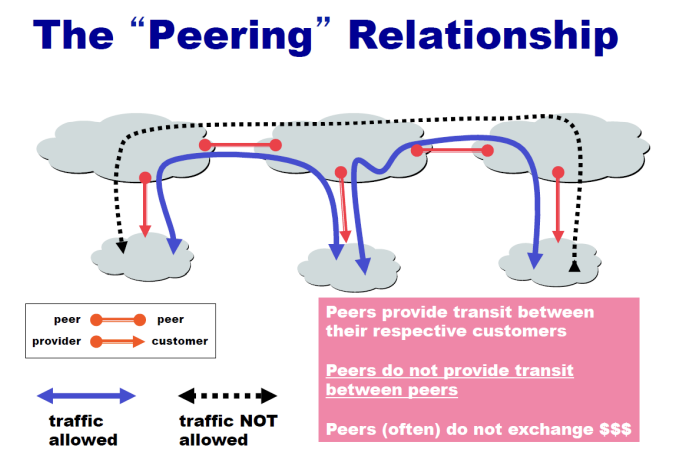
어떤 AS와 있냐에 따라 상대적인 관계가 된다.
파란색과 같은 트래픽이 이루어질 수 있고 검정색 트래픽은 허용되지 않는다.
BGP-4
BGP는 border gateway protocol로 AS의 경계들에 있는 프로토콜이다.
AS간의 정책에 따라 좌우된다. (policy-based)
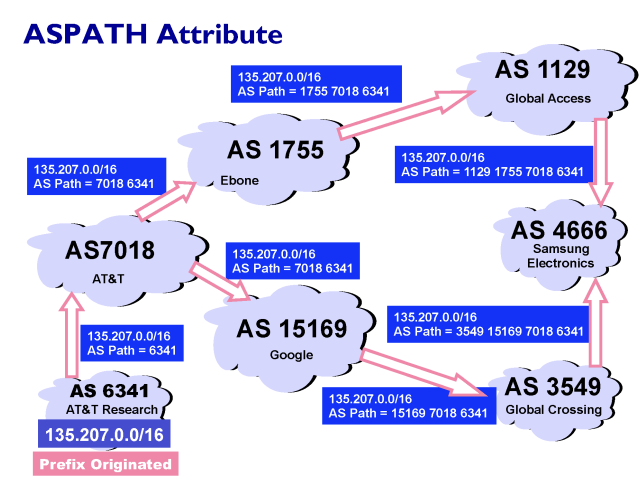
AS는 구름으로, 숫자는 ASN을 의미한다.
6341이라는 AS가 자신의 prefix를 광고하는 상황이다.
각각의 AS는 prefix로 표현할 수 있다.
AS path: 자기자신의 AS 번호가 포함되어 있고 AS가 지날수록 지난 AS의 ASN도 추가된다.
삼성입장에서는 두가지 방향으로 AS path를 받게되고 원하는 방향의 옵션으로 선택할 수 있다.
customer > peer > provider : 기왕이면 돈이 되는 방향으로 선태하는 것이 좋다.
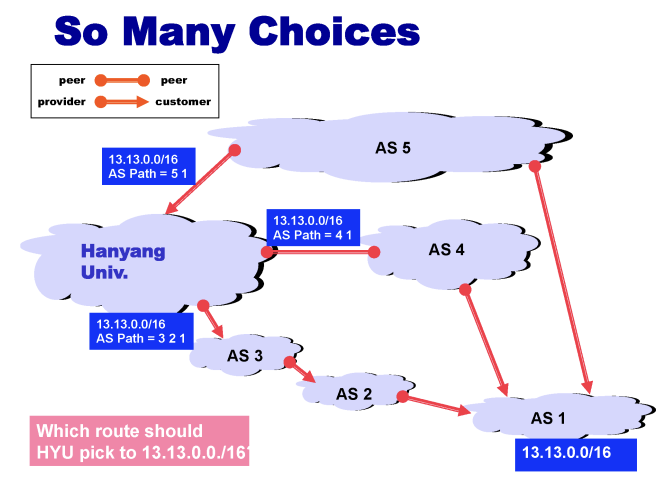
AS1에 대한 advertise가 3경로로 들어온다.
한양대 입장에서는 AS3 -> AS2 -> AS1 를 선택하게 된다.
그 이유는 본인이 제일 갑이 될 수 있는 위치로 선택하게 되어 최단경로와는 무관하다.